Meta ขายพลังประมวลผล Palantir ด่าเสียงแข็ง Zhipu กลายเป็นดาวเด่นแห่งซิลิคอนแวลลีย์ เรื่องราวของ AI Capex กำลังจะเปลี่ยนวิธีการเล่าใหม่
เขียนโดย: เสียง Beatz
ตลาด AI ปรับฐานรุนแรงอีกครั้ง คราวนี้เพราะ Meta บอกว่าอาจจะนำกำลังประมวลผล AI ที่มีเกินออกมาขาย
ถ้าข่าวนี้เกิดขึ้นเมื่อสามปีก่อน คงไม่มีใครแปลกใจ คลาวด์คอมพิวติ้งเป็นธุรกิจที่แบ่งเซิร์ฟเวอร์ออกเป็นชิ้นเล็กแล้วขายให้คนอื่นอยู่แล้ว Amazon, Microsoft, Google ทำแบบนี้มาหลายปี CoreWeave, Nebius และผู้ให้บริการคลาวด์รายใหม่ก็เดินตามเส้นทางนี้ โดยใช้ชิปของ NVIDIA เป็นหลักประกันสินเชื่อ แล้วนำเงินกู้ไปซื้อชิปเพิ่ม
แต่พอเป็น Meta กลับกลายเป็นเรื่องที่แตกต่าง
Meta ในอดีตไม่ได้มองกำลังประมวลผลแบบนี้ มันซื้อชิป สร้างดาต้าเซ็นเตอร์ แย่งชิงไฟฟ้าและที่ดิน เพื่อโมเดลของตัวเอง เพื่อระบบโฆษณา เพื่อระบบแนะนำ และเพื่อ superintelligence ที่ Zuckerberg พูดถึงว่ากำลังใกล้เข้ามาเรื่อยๆ มันไม่ใช่ผู้ให้บริการคลาวด์ มันไม่ได้หารายได้จากการให้เช่าเครื่องจักรให้คนอื่น
บริษัทที่เคยบอกว่าต้องการเครื่องจักรให้มากที่สุด เพราะอนาคตจะกลืนกินมันทั้งหมด ตอนนี้กลับบอกว่าถ้าเครื่องจักรเหล่านี้ยังใช้ไม่หมด ก็สามารถขายให้คนอื่นได้
นี่ไม่ได้บ่งชี้โดยตรงว่ากำลังประมวลผลล้นเกิน แต่ก็ไม่สามารถมองข้ามไปได้ง่ายๆ
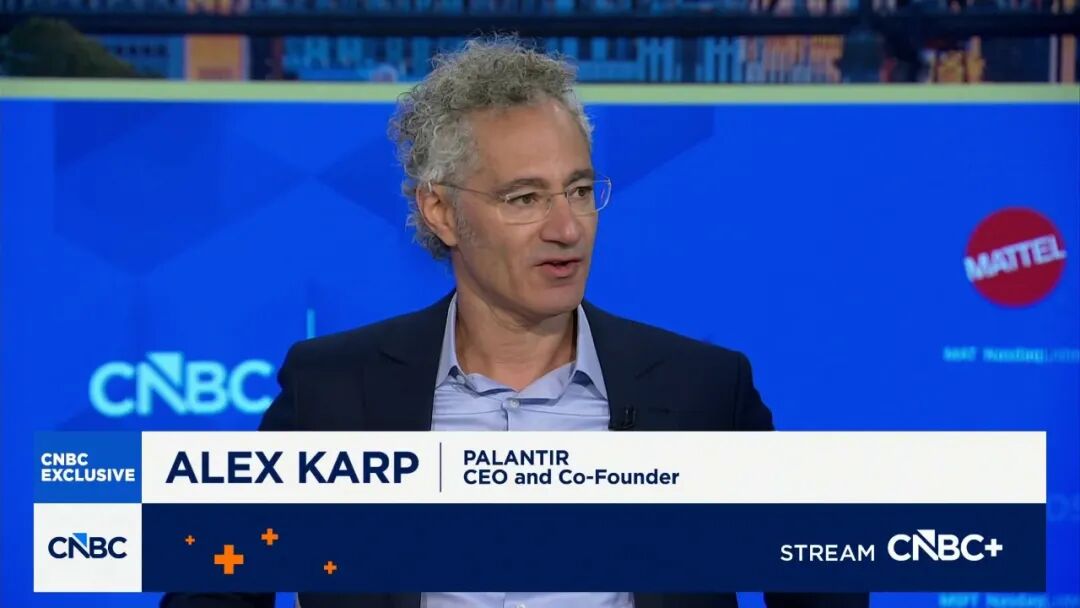
ในวันที่ตลาดหุ้นร่วงหนัก Alex Karp ซีอีโอของ Palantir ปรากฏตัวในรายการสัมภาษณ์ของ CNBC และด่าทอหน้ากล้องเกือบยี่สิบนาที
เดิมทีเขามาพูดถึงความร่วมมือใหม่ระหว่าง Palantir และ NVIDIA แต่ไม่นานก็เปลี่ยนไปพูดถึงรูปแบบการคิดค่าบริการ token ของ OpenAI และ Anthropic เขาบอกว่าซีอีโอหลายคนบ่นกับเขาเป็นการส่วนตัวว่าการนำ AI มาใช้ในองค์กรตอนนี้คือ "การจ่ายเงินเพื่อ token ที่ไม่สร้างมูลค่าใดๆ และยังต้องส่งข้อมูลของตัวเองให้ด้วย" เขายังเรียกบิลค่าใช้จ่ายโมเดลที่แพงขึ้นเรื่อยๆ ว่าเป็นภาษีความมั่งคั่งที่กดทับองค์กร
สองปีที่ผ่านมา ทุกคนคุยกันว่าใครกล้าใช้เงิน ใครใช้เร็ว ใครสามารถสร้างดาต้าเซ็นเตอร์ได้ก่อน ตอนนี้ปัญหาค่อยๆ เปลี่ยนไป เมื่อซื้อเครื่องจักรมาแล้ว ใครจะสามารถทำให้มันทำงานเต็มประสิทธิภาพได้ตลอดเวลา
แนวคิดของ Meta ยังไม่กลายเป็นธุรกิจอย่างเป็นทางการ ในรายงานสาธารณะ มีทิศทางภายในที่เรียกว่า Meta Compute ซึ่งอาจขายกำลังประมวลผลดิบ หรืออาจเหมือน Amazon Bedrock ที่นำโมเดลต่างๆ มาวางบนโครงสร้างพื้นฐานของตัวเองแล้วขายให้นักพัฒนา ก่อนหน้านี้ Zuckerberg เคยพูดในที่ประชุมผู้ถือหุ้นว่าบริษัทภายนอกเกือบทุกสัปดาห์มาถามว่าสามารถซื้อบริการ API หรือซื้อกำลังประมวลผลบางส่วนได้หรือไม่ และยินดีจ่ายในราคาที่สูงกว่าต้นทุนของ Meta
เขาก็เสริมอีกประโยคหนึ่งว่า พวกเขายังไม่ได้ทำแบบนั้น เพราะ Meta คิดว่าตัวเองยังใช้พลังประมวลผลเหล่านี้ได้อยู่
ถ้ายังใช้ได้ การให้เช่าก็เป็นแค่ทางเลือก ถ้าใช้ไม่ได้ การให้เช่าก็คือยาแก้ปวดสำหรับงบดุล
จุดที่ตัดสินยากที่สุดก็อยู่ตรงนี้ Meta อาจแค่เปิดช่องว่างในจังหวะการสร้างโครงสร้างพื้นฐาน แล้วนำทรัพยากรที่ว่างชั่วคราวออกมาขาย หรือมันอาจกำลังบอกนักลงทุนว่ารายจ่าย AI ระดับแสนล้านดอลลาร์ไม่สามารถพึ่งพา superintelligence ในอนาคตอันไกลได้ตลอดไป ต้องหาเส้นทางรายได้ที่ใกล้กว่านี้ก่อน
ทั้งสองคำอธิบายนี้ก็เป็นไปได้
ความต้องการไม่ได้หายไป แค่เริ่มคัดเลือกคน
Capex คือแกนหลักของเรื่องเล่า AI ไม่มีอะไรสำคัญไปกว่านี้ เหมือนกับการปล่อยเงินในปี 2021 ที่ Capex คาดว่าจะเติบโตต่อเนื่อง เงินถูกปล่อยออกมาเรื่อยๆ ทุกสาขาที่ตลาดเก็งกำไรถึงจะขึ้นพร้อมกัน พอเห็น Meta เตรียมขายพลังประมวลผล หลายคนก็คิดทันทีว่า AI capex กำลังจะพัง บริษัทใหญ่ยอมรับแล้วว่าซื้อมากเกินไป งานเลี้ยงของเซมิคอนดักเตอร์กำลังจะจบ
พูดแบบนั้นมันง่ายเกินไป
ข้อมูลสาธารณะยังไม่สนับสนุนข้อสรุปที่ชัดเจนขนาดนั้น รายได้ของ AWS ในไตรมาสแรกเพิ่มขึ้น 28% ถึง 37.6 พันล้านดอลลาร์ ซึ่งเป็นการเติบโตเร็วที่หาได้ยากในช่วงไม่กี่ปีนี้ Google Cloud ในไตรมาสแรกโตแรงกว่า รายได้ถึง 20 พันล้านดอลลาร์ Microsoft Azure ก็ยังวิ่งด้วยความเร็วประมาณ 40%
Amazon ยังบอกว่ารายจ่ายด้านทุนปีนี้อาจถึง 200 พันล้านดอลลาร์ Alphabet ปรับเพิ่มแนวโน้มรายจ่ายด้านทุนปี 2026 เป็น 180-190 พันล้านดอลลาร์ Meta เองก็เพิ่มรายจ่ายด้านทุนทั้งปีเป็น 125-145 พันล้านดอลลาร์
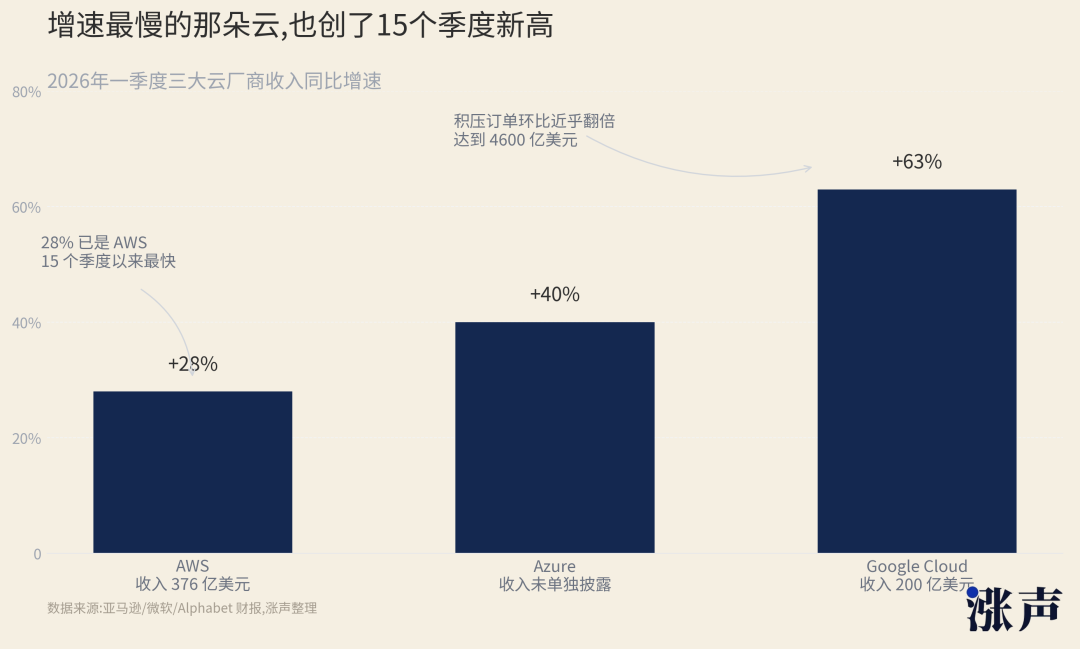
ตัวเลขเหล่านี้ไม่เหมือนกับความต้องการที่พังทลาย
มันเหมือนการแยกทางมากกว่า
สถานการณ์ของผู้ให้บริการคลาวด์แตกต่างจากผู้ผลิตโมเดล ผู้ให้บริการคลาวด์ขายถนน ตราบใดที่ยังมีคนวิ่งบนถนน ไม่ว่ารถจะสร้างโดยใคร พวกเขาก็เก็บเงินได้ OpenAI, Anthropic, ลูกค้าองค์กร, ลูกค้าภาครัฐ, สตาร์ทอัพ สุดท้ายแล้วทั้งหมดต้องลงจอดที่ศูนย์ข้อมูลบางแห่ง ชิปบางชนิด เครือข่ายบางเส้น และสัญญาไฟฟ้าบางฉบับ
ดังนั้นคลาวด์ยักษ์ใหญ่สามรายจึงยังแข็งแกร่งได้
AWS ถึงกับขึ้นราคาบริการ AI คลาวด์ตัวหนึ่งในช่วงปลายเดือนมิถุนายน ซึ่งเป็นบริการที่ให้ลูกค้าล็อค GPU ล่วงหน้า AWS ปรับราคาบริการนี้ขึ้นอีกประมาณ 20% ตั้งแต่เดือนกรกฎาคม ในเดือนมกราคมก็ปรับไปแล้วครั้งหนึ่งประมาณ 15% นี่ไม่ใช่การกระทำที่เกิดขึ้นเมื่ออุปสงค์อ่อนแอ
เมื่อของขาดแคลน ผู้ขายก็ขึ้นราคา
แต่บริษัทโมเดล AI ไม่ได้สบายแบบนั้นเสมอไป
สินทรัพย์ของบริษัทโมเดลต้องคัดเลือกอย่างพิถีพิถันกว่า พลังประมวลผลไม่ได้วางไว้แล้วสร้างรายได้ทันที มันต้องถูกเติมเต็มด้วยโมเดลที่ฉลาดกว่า ผู้ใช้ที่ใช้งานบ่อยกว่า และเวิร์กโฟลว์องค์กรที่แพงกว่า เฉพาะเมื่อโมเดลดีพอ ผู้ใช้ถึงจะยอมทนต่อการต่อคิว การจำกัดโควตา การขึ้นราคา และระดับการสมัครสมาชิกที่ซับซ้อนขึ้นเรื่อยๆ
นี่คือเหตุผลที่ Anthropic ถูกมองว่าเป็นบริษัทอีกประเภทหนึ่งในตลาด ไม่ใช่เพราะมันถูก แต่เพราะผู้ใช้ยอมมอบงานที่มีต้นทุนสูงให้มัน เขียนโค้ด แก้ระบบ รันงานยาว เชื่อมต่อเวิร์กโฟลว์องค์กร เมื่องานเหล่านี้เข้าสู่สภาพแวดล้อมการผลิตจริง โทเค็นที่ใช้จะมากกว่าการพูดคุยทั่วไปมาก
ปัญหาของโมเดลที่แข็งแกร่งคือเครื่องจักรไม่พอ
ปัญหาของโมเดลที่อ่อนแอคือไม่มีใครสนใจเครื่องจักร
ปัญหาทั้งสองนี้เรียกว่าพลังประมวลผล แต่มันไม่ใช่สิ่งเดียวกัน
สายงานของ xAI ก็มีกลิ่นเดียวกัน Grok ยังไม่มีจิตสำนึกองค์กรที่ชัดเจนเหมือนโมเดลที่แข็งแกร่งที่สุด แต่พลังประมวลผลส่วนหนึ่งในระบบของ Musk สามารถไหลไปยัง Anthropic ได้ การกระทำนี้เย็นชากว่าคำพูดใดๆ เครื่องจักรไม่รู้จักผู้ก่อตั้ง มันรู้จักแค่ใครที่ทำให้มันทำงานเต็มประสิทธิภาพ
ความสัมพันธ์ระหว่าง Google และ Meta ก็แสดงให้เห็นว่าเรื่องนี้ไม่ง่ายนัก ในเดือนมิถุนายนมีข่าวว่า Google จำกัดการใช้ Gemini ของ Meta เพราะ Meta ต้องการซื้อพลังประมวลผลเกินกว่าที่ Google จะจัดหาได้ และยังส่งผลกระทบต่อโปรเจกต์ AI ภายในของ Meta บริษัทหนึ่งกำลังคิดจะขายพลังประมวลผล ขณะที่ในบางงานกลับซื้อความสามารถของโมเดลระดับหัวกะทิไม่พอ
นี่ไม่ใช่ส่วนเกินในความหมายดั้งเดิม
นี่คือความไม่สมดุล เพราะบิลเริ่มชัดเจนขึ้น
ผู้ให้บริการคลาวด์สามารถขึ้นราคาต่อไปได้ เพราะพวกเขาขายความแน่นอน ลูกค้าต้องการ GPU ที่จะได้รับในช่วงเวลาหนึ่ง ศูนย์ข้อมูลที่เสถียร และโครงสร้างพื้นฐานที่ไม่พังกลางดึก
แต่เมื่อลูกค้าองค์กรได้พลังประมวลผลแล้ว ปัญหายังไม่จบ
พวกเขายังต้องส่งบิลนี้ให้ CFO CFO จะไม่ถามว่าคุณใช้โทเค็นไปเท่าไหร่ เขาจะถามว่าโทเค็นเหล่านี้ช่วยบริษัทประหยัดเงินเท่าไหร่ ทำเงินเพิ่มเท่าไหร่ และลดข้อผิดพลาดไปเท่าไหร่
เมื่อถึงมือองค์กร โทเค็นกลายเป็นมิเตอร์ไฟฟ้า
นี่คือการกลับมาที่บทสัมภาษณ์ของ Karp ในตอนต้น
เขามองว่าสิ่งที่บริษัท AI หลายแห่งขายให้องค์กรธุรกิจนั้นเป็นการขายเกินจริง วันก่อนขึ้นรายการ Palantir เพิ่งโพสต์แถลงการณ์เก้าข้อบน X เกี่ยวกับสิ่งที่เรียกว่า "อธิปไตยทาง AI" ซึ่งเจาะจงถึงโมเดลแบบ tokenmaxxing คำนี้แปลยาก ถ้าแปลตรงตัวก็ฟังดูไม่ดี แต่ความหมายไม่ได้ซับซ้อน คือการเอาปริมาณการใช้ token มาเป็นตัววัดความก้าวหน้า เอาการเผาเงินมาเป็นการใช้งาน และเอาใบแจ้งหนี้มาเป็นผลผลิต
Karp ดันห้องปฏิบัติการ前沿อย่าง OpenAI และ Anthropic ขึ้นมาบนโต๊ะ ความหมายของเขาไม่ใช่ว่าองค์กรไม่ควรใช้โมเดลที่ทรงพลังที่สุด แต่คือองค์กรไม่ควรมอบข้อมูล กระบวนการ และการตัดสินใจทางธุรกิจทั้งหมดให้กับใคร แล้วจ่ายบิลที่ใหญ่ขึ้นเรื่อยๆ ตามปริมาณการใช้งาน
สิ่งที่ Palantir ต้องการขายคือสิ่งอื่น ไม่ใช่กล่องแชททั่วไป ไม่ใช่ API เดียว แต่เป็นการนำข้อมูล การอนุมัติ สิทธิ์ กฎการดำเนินงาน และ AI มาอยู่ในระบบธุรกิจชุดเดียวกัน สิ่งที่ลูกค้าจ่ายเงินซื้อไม่ใช่ "ใช้ AI กี่ครั้ง" แต่คือสายการผลิต กระบวนการบริหารความเสี่ยง หรือภารกิจของรัฐ某项นั้นถูกปรับเปลี่ยนจริงหรือไม่
คนที่ดูแลเงินจริงในองค์กรเริ่มตื่นตัวแล้ว
UBS เพิ่งพูดคุยกับผู้บริหาร IT ระดับสูงขององค์กร และทิศทางหนึ่งก็ชัดเจน หลายองค์กรไม่ได้เลิกใช้ AI แต่กำลังใส่เบรกในการใช้จ่ายด้าน AI ประมาณ 60% ของบริษัทที่ตอบแบบสำรวจกำลังกดดันค่าใช้จ่าย token และเพิ่มรั้วป้องกันการใช้งาน โดยเฉพาะบริษัทที่ผ่านช่วงทดลองและเริ่มนำ AI เข้าสู่กระบวนการทำงานประจำวัน
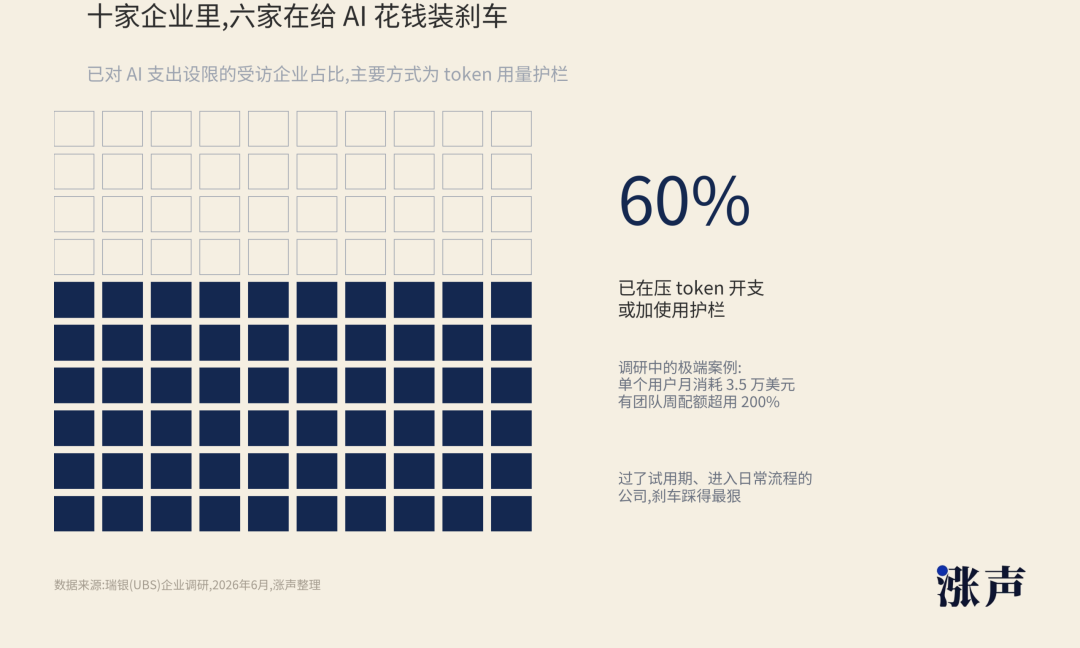
นี่เป็นการพลิกกลับที่น่าสนใจเช่นกัน
หลังจาก AI เปลี่ยนจากของเล่นเป็นเครื่องมือ การใช้เงินกลับยากขึ้น ในช่วงของเล่น เจ้าของบริษัทยินดีจัดงบประมาณ เพราะทุกคนกลัวตกขบวน ในช่วงเครื่องมือ CFO จะถามว่ามันช่วยประหยัดเวลาทำงานให้ใคร ช่วยขายสินค้าเพิ่มให้ใคร หรือช่วยลดความเสี่ยงให้ใคร
ในตารางนี้ token ไม่เหมือนรายได้
มันเหมือนมิเตอร์ไฟฟ้ามากกว่า
แน่นอน คุณบอกได้ว่ามิเตอร์หมุนเร็วแสดงว่าโรงงานกำลังเดินเครื่อง หรือบอกได้ว่ามิเตอร์หมุนเร็วเกินไปแต่ผลผลิตไม่เพิ่ม แสดงว่าเครื่องจักรมีปัญหา
AI agent ขยายปัญหานี้ให้ใหญ่ขึ้น งานวิจัย Codex ของ OpenAI ร่วมกับมหาวิทยาลัยหลายแห่งมีข้อมูลที่น่าตกใจ ในช่วงครึ่งแรกของปี 2026 ผู้ใช้ที่ใช้งาน Codex อย่าง活跃เพิ่มขึ้นกว่าห้าเท่า token เอาต์พุตของบางตำแหน่งภายใน OpenAI ก็พุ่งสูงขึ้นอย่างมาก ตำแหน่งกฎหมายมี token เอาต์พุตเฉลี่ยต่อเดือนสูงกว่าเดือนพฤศจิกายน 2025 ถึง 13 เท่า ส่วนตำแหน่งวิจัยสูงกว่า 50 เท่า
งานวิจัยอีกชิ้นหนึ่งพูดถึงเรื่องนี้อย่างชัดเจนยิ่งขึ้น งาน coding แบบ agentic ใช้ token มากกว่าการแชทโค้ดและการใช้เหตุผลเกี่ยวกับโค้ดทั่วไปถึง 1,000 เท่า สำหรับงานเดียวกัน ปริมาณ token ที่ใช้ในแต่ละรอบการทำงานอาจแตกต่างกันถึง 30 เท่า
นี่คือรากฐานของปัญหาการขาดแคลนพลังคำนวณในปัจจุบัน
ไม่ใช่เพราะผู้คนถาม chatbot มากขึ้น
แต่เป็นเพราะซอฟต์แวร์เริ่มกลายเป็นกลุ่มคนงานขนาดเล็กที่อ่านไฟล์ซ้ำแล้วซ้ำเล่า รันคำสั่ง แก้โค้ด ล้มเหลว เริ่มใหม่ ล้มเหลวอีก แล้วเริ่มใหม่อีกครั้ง พวกเขาไม่มีเวลาพักกลางวัน แต่ทุกย่างก้าวก็กิน token
เมื่อ token กลายเป็นมิเตอร์ไฟฟ้า ใครที่มีโรงไฟฟ้า คนนั้นก็มีอำนาจ แต่ใครที่สิ้นเปลืองไฟฟ้า คนนั้นก็จะถูกสอบสวนก่อน
เมื่อบิลหนาขึ้น โมเดลราคาถูกก็มีที่ทาง
เมื่อ CFO เริ่มมองมิเตอร์ไฟฟ้านี้ ขั้นตอนต่อไปแทบไม่ต้องให้ใครสอน
เขาจะถามว่างานไหนต้องใช้โมเดลที่แข็งแกร่งที่สุด และงานไหนใช้แค่โมเดลที่พอเพียงก็ได้
ในเวลานี้ โมเดลโอเพนซอร์สอย่าง GLM, Kimi, DeepSeek, Qwen ไม่ใช่แค่ข่าวเทคโนโลยีอีกต่อไป พวกมันกลายเป็นเครื่องมือต่อรองราคาบนโต๊ะจัดซื้อขององค์กร
แม้แต่มาร์ก อันเดรสเซน จาก a16z กองทุนร่วมทุนชั้นนำในซิลิคอนแวลลีย์ ก็กล่าวว่าผู้ประกอบการ AI หลายคนมองว่า GLM-5.2 ของ Zhipu เป็นหนึ่งในโมเดลจีนรุ่นแรกที่สามารถเทียบเคียงหรือแม้กระทั่งเหนือกว่าโมเดลชั้นนำของสหรัฐฯ ในงานส่วนใหญ่ การตัดสินนี้ยังไม่ใช่คำตัดสินสุดท้าย แต่มันทำให้องค์กรมีข้ออ้างเพิ่มขึ้น
Coinbase ให้ตัวอย่างที่ชัดเจนยิ่งขึ้น Brian Armstrong กล่าวว่าบริษัทเปลี่ยนโมเดล AI เริ่มต้นไปใช้โมเดลโอเพนซอร์สอย่าง GLM 5.2, Kimi 2.7 จากนั้นจับคู่กับการกำหนดเส้นทางโมเดล การแคช และการย่อบริบท ปริมาณการใช้ Token ยังคงเติบโตแบบทวีคูณ แต่ค่าใช้จ่ายด้าน AI กลับลดลงเกือบครึ่งหนึ่ง
พลังของคำพูดนี้อยู่ที่องค์กรสามารถแยกซื้อความสามารถของโมเดลได้เป็นครั้งแรก
งานที่ยากที่สุด ยังคงมอบให้กับโมเดลที่แพงที่สุด ส่วนงานสรุปทั่วไป บริการลูกค้า การดึงข้อมูล โค้ดเทมเพลต และการตอบคำถามฐานความรู้ภายใน ให้กับโมเดลราคาถูกและการปรับใช้ในพื้นที่
โมเดลโอเพนซอร์สไม่จำเป็นต้องชนะทุกสนามรบ
มันแค่ต้องทำให้ฝ่ายจัดซื้อเชื่อว่า ไม่ใช่ทุกหน่วยไฟฟ้าที่ต้องจ่ายในราคาบ้านหรู
ถึงจุดนี้ การที่ Meta ขายพลังคำนวณก็ไม่ใช่ข่าวเดี่ยวอีกต่อไป
มันเป็นเรื่องเดียวกันกับที่ Palantir ด่า token และ Coinbase เปิดเผยโมเดลโอเพนซอร์ส: ห่วงโซ่การใช้จ่ายของ AI เริ่มถูกแยกออกจากกัน ต้นน้ำขายความแน่นอน กลางน้ำขายผลลัพธ์ ปลายน้ำกดราคาต่อหน่วย แต่ละชั้นยังคงเติบโต แต่แต่ละชั้นก็เริ่มถูกตั้งคำถามว่าเงินที่ใช้ไปคุ้มค่าหรือไม่
สิ่งที่ยากที่สุดไม่ใช่การซื้อเครื่องจักร แต่คือการทำให้เครื่องจักรมีงานทำตลอดเวลา
ในช่วงสองปีที่ผ่านมา เรื่องที่เล่าได้ง่ายที่สุดในวงการ AI คือทรัพยากรไม่เพียงพอ
GPU ไม่พอ ไฟฟ้าไม่พอ ศูนย์ข้อมูลไม่พอ วิศวกรไม่พอ คลาวด์ที่รันโมเดลได้ก็ไม่พอ เรื่องนี้ราบรื่นเกินไป เมื่อของไม่พอ ทุกคนจะพุ่งไปข้างหน้าโดยสัญชาตญาณ ก่อนอื่นต้องจองตำแหน่ง เซ็นสัญญาไฟฟ้า ซื้อชิป ตั้งเครื่องจักรก่อน
ตอนแย่งทรัพยากร คนมักไม่คิดคำนวณละเอียด
เพราะต้นทุนของการช้ากว่าดูเหมือนจะใหญ่กว่า
แต่ข่าวของ Meta ดันปัญหาอีกอย่างออกมา หลังจากซื้อเครื่องจักรกลับมา มันไม่ได้กลายเป็นธุรกิจที่ดีโดยอัตโนมัติเพราะมันแพง มันต้องมีงานทำทุกวัน มีลูกค้าที่จ่ายเงิน มีโมเดลที่รันมันเต็มที่ มีแอปพลิเคชันที่เปลี่ยนต้นทุนเป็นรายได้
นี่คืออัตราการใช้งาน
คำว่าอัตราการใช้งานฟังดูเย็นชา แต่จริงๆ แล้วมันโหดร้าย มันไม่ได้ถามว่าคุณมีอนาคตหรือไม่ แต่ถามว่าวันนี้เครื่องของคุณเริ่มทำงานหรือยัง มันไม่สนใจสิ่งที่คุณพูดในงานแถลงข่าว หรือว่าคุณซื้อ GPU ที่แพงที่สุดหรือไม่ มันดูแค่อย่างเดียว: เงินนี้กลายเป็นกระแสเงินสดต่อเนื่องหรือไม่
ผู้ให้บริการคลาวด์ตอบคำถามนี้ได้ค่อนข้างง่าย เพราะพวกเขาขายโครงสร้างพื้นฐานอยู่แล้ว AWS, Google Cloud, Azure ขายถนน ไฟฟ้า และห้องเซิร์ฟเวอร์ ลูกค้าต้องการฝึกโมเดล รันอินเฟอเรนซ์ โฮสต์แอปพลิเคชัน สุดท้ายก็ต้องลงบนคลาวด์ใดคลาวด์หนึ่ง
ดังนั้นพวกเขายังแข็งแกร่งได้
บริษัทที่มีโมเดลแข็งแกร่งก็มีคำตอบของตัวเอง ถ้าโมเดลแข็งแกร่งพอ ผู้ใช้ยอมรอคิว องค์กรยอมเชื่อมต่อ นักพัฒนายอมปรับเวิร์กโฟลว์ตามมัน พลังประมวลผลก็ไม่ใช่สต็อก แต่เป็นคอขวด ยิ่งมีเครื่องจักรมาก มันก็ยิ่งรันได้คล่อง
ที่ยากที่สุดคือชั้นกลาง
พวกมันมีเครื่องจักร มีเรื่องเล่า มีทีมโมเดล และมีงบประมาณใหญ่ แต่โมเดลไม่ได้ไปถึงจุดสูงสุด ผลิตภัณฑ์ไม่ได้กลายเป็นนิสัยประจำวัน และนักพัฒนาก็ไม่ยอมปรับเวิร์กโฟลว์ตามมัน สำหรับบริษัทประเภทนี้ พลังประมวลผลเปลี่ยนจากอาวุธเป็นสต็อกได้ เพียงแค่การเปิดตัวโมเดลล้มเหลวครั้งเดียว หรือผู้ใช้ย้ายออกครั้งเดียว
สต็อกอาจไม่ได้ไร้ประโยชน์
แต่สินค้าคงคลังต้องลดราคา ต้องปล่อยเช่า และต้องหาการใช้งานใหม่
นี่คือสิ่งที่ Meta ขายพลังประมวลผลทำให้เห็นเด่นชัด มันไม่ได้พิสูจน์ว่า Meta ล้มเหลว หรือความต้องการ AI หายไป มันแค่ทำให้ตลาดเห็นเป็นครั้งแรกว่า โครงสร้างพื้นฐาน AI ก็เจอปัญหาเดียวกับโรงงานทั่วไป
สร้างโรงงานเสร็จแล้ว คำสั่งซื้ออยู่ไหน
พลังประมวลผลไม่ได้หายไป แค่เริ่มแบ่งชั้น
ดังนั้น วิธีที่ดีที่สุดในการเข้าใจเรื่องนี้ไม่ใช่ "พลังประมวลผลล้นเกิน"
คำนี้หยาบเกินไป
คำพูดที่แม่นยำกว่าคือ พลังประมวลผลเริ่มแบ่งชั้น
ชั้นบนสุด ยังคงตึงตัว โมเดลที่แข็งแกร่งที่สุด คลาวด์ที่ดีที่สุด คลัสเตอร์ GPU ที่เสถียรที่สุด ยังมีคนแย่งกัน บริการของ AWS สามารถขึ้นราคาได้ เพราะความแน่นอนมีราคาในตัว ลูกค้าไม่ได้แค่ซื้อ GPU แต่ซื้อความมั่นใจว่าเครื่องจะใช้งานได้ในวันใดวันหนึ่ง ชั่วโมงใดชั่วโมงหนึ่ง หรือชุดเครื่องใดชุดหนึ่ง
ชั้นกลาง เริ่มอึดอัด มันอาจไม่แย่ แต่ไม่หายากพอ มันรันโมเดลได้ ทำ inference ได้ และขายให้ลูกค้าภายนอกได้ แต่ลูกค้าจะเปรียบเทียบ ต่อรองราคา และถามว่าทำไมไม่ใช้โมเดลที่ถูกกว่า ทำไมไม่ใช้คลาวด์ของคนอื่น และทำไมชุดเครื่องนี้ถึงคุ้มราคานี้
ชั้นล่างสุด จะถูกบีบอัดทีละนิดโดยโมเดลโอเพนซอร์สและการปรับต้นทุนให้เหมาะสม บริษัทจะไม่เรียกใช้โมเดลที่แพงที่สุดสำหรับงานทั่วไปตลอดเวลา พวกเขาจะทำ routing ทำ caching บีบ context และแยกโมเดลเป็นระดับต่างๆ
ความต้องการเติบโตขึ้นแล้ว
เด็กใช้เงินไม่ดูบิล ผู้ใหญ่ดู เมื่อ AI เข้าสู่องค์กร ก็จะผ่านกระบวนการนี้เช่นกัน ในช่วงทดลอง ทุกคนกลัวพลาดโอกาส ในช่วงขยายขนาด ทุกคนเริ่มคิดบัญชี
เมื่อคิดบัญชีแล้ว ห่วงโซ่อุตสาหกรรมจะไม่เป็นระเบียบเหมือนช่วงแรกอีกต่อไป
บางคนยังขึ้นราคาต่อ เพราะเขาขายความแน่นอนที่ไม่มีใครแทนที่ได้ บางคนเปลี่ยนมาขายผลลัพธ์ เพราะลูกค้าไม่อยากจ่ายเพื่อการบริโภคเพียงอย่างเดียว บางคนถูกบังคับให้ลดราคา เพราะมีทางเลือกที่พอใช้ได้ปรากฏขึ้น บางคนปล่อยเครื่องให้เช่า เพราะปล่อยให้เครื่องว่างดูแย่กว่าปล่อยเช่าราคาถูก
สิ่งเหล่านี้เกิดขึ้นพร้อมกัน ทำให้อุตสาหกรรมดูขัดแย้ง
ด้านหนึ่งคือพลังประมวลผลขาดแคลน
อีกด้านคือพลังประมวลผลถูกปล่อยเช่า
ด้านหนึ่งคือการบริโภค token พุ่งสูง
อีกด้านคือบริษัทกดค่าใช้จ่าย AI ลง
ด้านหนึ่ง โมเดลระดับท็อปยิ่งแข็งแกร่งขึ้นเรื่อยๆ
อีกด้านหนึ่ง โมเดลโอเพนซอร์สยิ่งถูกลงเรื่อยๆ
ทั้งสองอย่างไม่ได้ขัดแย้งกัน มันแค่บอกว่า AI ได้เปลี่ยนจากเรื่องของปริมาณรวม มาเป็นเรื่องของโครงสร้างแล้ว
เรื่องราวของทางรถไฟเก่าจะถูกเล่าอีกครั้ง
ในฟองสบู่ทางรถไฟในศตวรรษที่ 19 ทางรถไฟไม่ได้เป็นของปลอม
เมื่อรางถูกวางลง สินค้าก็เคลื่อนย้ายได้จริง เมืองก็เติบโตขึ้นจริง เวลาก็สั้นลงจริง เครือข่ายธุรกิจที่มีค่าที่สุดหลายแห่งในภายหลัง ก็เติบโตอยู่ข้างรางเหล่านั้น
แต่นั่นไม่ได้ขัดขวางคนสร้างทางรถไฟหลายคนในยุคนั้นจากการขาดทุน
พวกเขาไม่ได้แพ้เพราะทิศทาง พวกเขาแพ้เพราะสร้างเร็วเกินไป สร้างมากเกินไป สร้างไปในที่ที่ไม่มีผู้โดยสารหรือสินค้า หรือกู้เงินแพงเกินไปมาสร้างเส้นทางที่ใช้เวลานานเกินไปกว่าจะคืนทุน
เส้นใยแก้วนำแสงในฟองสบู่อินเทอร์เน็ตก็เหมือนกัน เส้นใยไม่ได้ผิด มันคือสิ่งที่ยกโลกทั้งใบขึ้นมาในภายหลัง สิ่งที่ผิดคือสมุดบัญชีชุดนั้น ที่ยัดเยียดความต้องการในอีกหลายสิบปีข้างหน้าเข้าไปในรายจ่ายด้านทุนเพียงไม่กี่ปี
ศูนย์ข้อมูล AI อาจจะทิ้งสิ่งที่มีประโยชน์ไว้มากมาย GPU จะเสื่อมราคา สัญญาไฟฟ้าจะต่ออายุ ศูนย์ข้อมูลจะเปลี่ยนอุปกรณ์ ซอฟต์แวร์จะกินพลังประมวลผลมากขึ้นเรื่อยๆ การใช้ token ที่ดูเกินจริงในวันนี้ อีกไม่กี่ปีอาจจะธรรมดาเหมือนปริมาณการรับชมวิดีโอความละเอียดสูง
แต่สินทรัพย์มีอารมณ์ของมันเอง
มันไม่สนใจว่าคุณเชื่อในอนาคตหรือไม่ มันแค่สนใจว่ามีคนมาใช้มันทุกวันหรือเปล่า
สัญญาณที่ Meta ขายพลังประมวลผล อยู่ตรงจุดนี้
มันไม่ใช่จุดจบของ AI ไม่ใช่จุดจบของเซมิคอนดักเตอร์ มันเหมือนกับตอนที่เรื่องเล่าเกี่ยวกับรายจ่ายด้านทุนเดินทางมาถึงช่วงกลาง มีคนเปิดประตูให้คนข้างนอกเห็นว่ามีเครื่องจักรอยู่ในคลังเท่าไหร่
เครื่องจักรบางตัวจะถูกกินโดยโมเดลระดับท็อป
เครื่องจักรบางตัวจะถูกเช่าโดยลูกค้าคลาวด์
เครื่องจักรบางตัวจะถูกลงในสงครามราคา
และเครื่องจักรบางตัว จะรอคอยแอปพลิเคชันที่ยังไม่เกิดขึ้นอย่างเงียบๆ
สองปีที่ผ่านมา ตลาดเต็มใจเชื่อว่าเครื่องจักรทั้งหมดจะได้เจอชะตาของมันในที่สุด ตอนนี้มันเริ่มถามว่า ใครจะได้เจอก่อน ใครจะไม่ได้เจอ และใครที่ได้เจอก็ยังทำเงินไม่พอ
เมื่อคำถามนี้เกิดขึ้น เรื่องราวของ AI ก็เปลี่ยนไป
มันไม่ได้เป็นของคนที่ซื้อเครื่องได้เร็วที่สุดอีกต่อไปแล้ว
มันเป็นของคนที่ทำให้เครื่องหมุนต่อไปได้ตลอดเวลา
ลิงก์ต้นฉบับ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง