จากพลังการประมวลผลสู่ปัญญาประดิษฐ์: แผนที่การลงทุนด้าน AI แบบกระจายศูนย์ที่ขับเคลื่อนด้วยการเรียนรู้แบบเสริมแรง

ชื่อเรื่องเดิม: IOSG Weekly Brief | From Computing Power to Intelligence: An Investment Map for Decentralized AI Driven by Reinforcement Learning
ผู้เขียนต้นฉบับ: Jacob Zhao, IOSG Ventures
ปัญญาประดิษฐ์กำลังเปลี่ยนจากการเรียนรู้เชิงสถิติ ซึ่งเน้นที่ " การจับคู่รูปแบบ " เป็นหลัก ไปสู่ระบบความสามารถที่เน้น " การให้เหตุผลเชิงโครงสร้าง " โดยที่ความสำคัญของ การฝึกฝนภายหลัง (post-training) กำลังเพิ่มขึ้นอย่างรวดเร็ว การเกิดขึ้นของ DeepSeek-R1 ถือเป็นการเปลี่ยนแปลงกระบวนทัศน์ใน การเรียนรู้แบบเสริมแรง (reinforcement learning) ในยุคของโมเดลขนาดใหญ่ นำไปสู่ฉันทามติในอุตสาหกรรม ว่า การฝึกฝนล่วงหน้า (pre-training) เป็นรากฐานสำหรับการสร้างโมเดลอเนกประสงค์ และการเรียนรู้แบบเสริมแรงไม่ได้เป็นเพียงเครื่องมือในการปรับค่าให้สอดคล้องกันอีกต่อไป แต่ได้รับการพิสูจน์แล้วว่าสามารถปรับปรุงคุณภาพของห่วงโซ่การให้เหตุผลและความสามารถในการตัดสินใจที่ซับซ้อนได้อย่างเป็นระบบ ค่อยๆ พัฒนาไปสู่เส้นทางเทคโนโลยีสำหรับการพัฒนาสติปัญญาอย่างต่อเนื่อง
ในขณะเดียวกัน Web3 กำลังปรับเปลี่ยนความสัมพันธ์ในการผลิต AI ผ่านเครือข่ายการประมวลผลแบบกระจายศูนย์และระบบแรงจูงใจทางคริปโตกราฟี ข้อกำหนดเชิงโครงสร้างของการเรียนรู้แบบเสริมแรงสำหรับการสุ่มตัวอย่างการใช้งาน สัญญาณรางวัล และการฝึกอบรมที่ตรวจสอบได้นั้น สอดคล้องกับการทำงานร่วมกันของพลังการประมวลผล การจัดสรรแรงจูงใจ และการดำเนินการที่ตรวจสอบได้ของบล็อกเชนโดยธรรมชาติ รายงานฉบับนี้จะวิเคราะห์อย่างเป็นระบบเกี่ยวกับกระบวนทัศน์การฝึกอบรม AI และหลักการของเทคโนโลยีการเรียนรู้แบบเสริมแรง โดยแสดงให้เห็นถึงข้อได้เปรียบเชิงโครงสร้างของการเรียนรู้แบบเสริมแรง × Web3 และวิเคราะห์โครงการต่างๆ เช่น Prime Intellect, Gensyn, Nous Research, Gradient, Grail และ Fraction AI
สามขั้นตอนของการฝึกฝน AI: การเตรียมการก่อนฝึกฝน การปรับแต่งคำสั่ง และการจัดระเบียบหลังการฝึกฝน
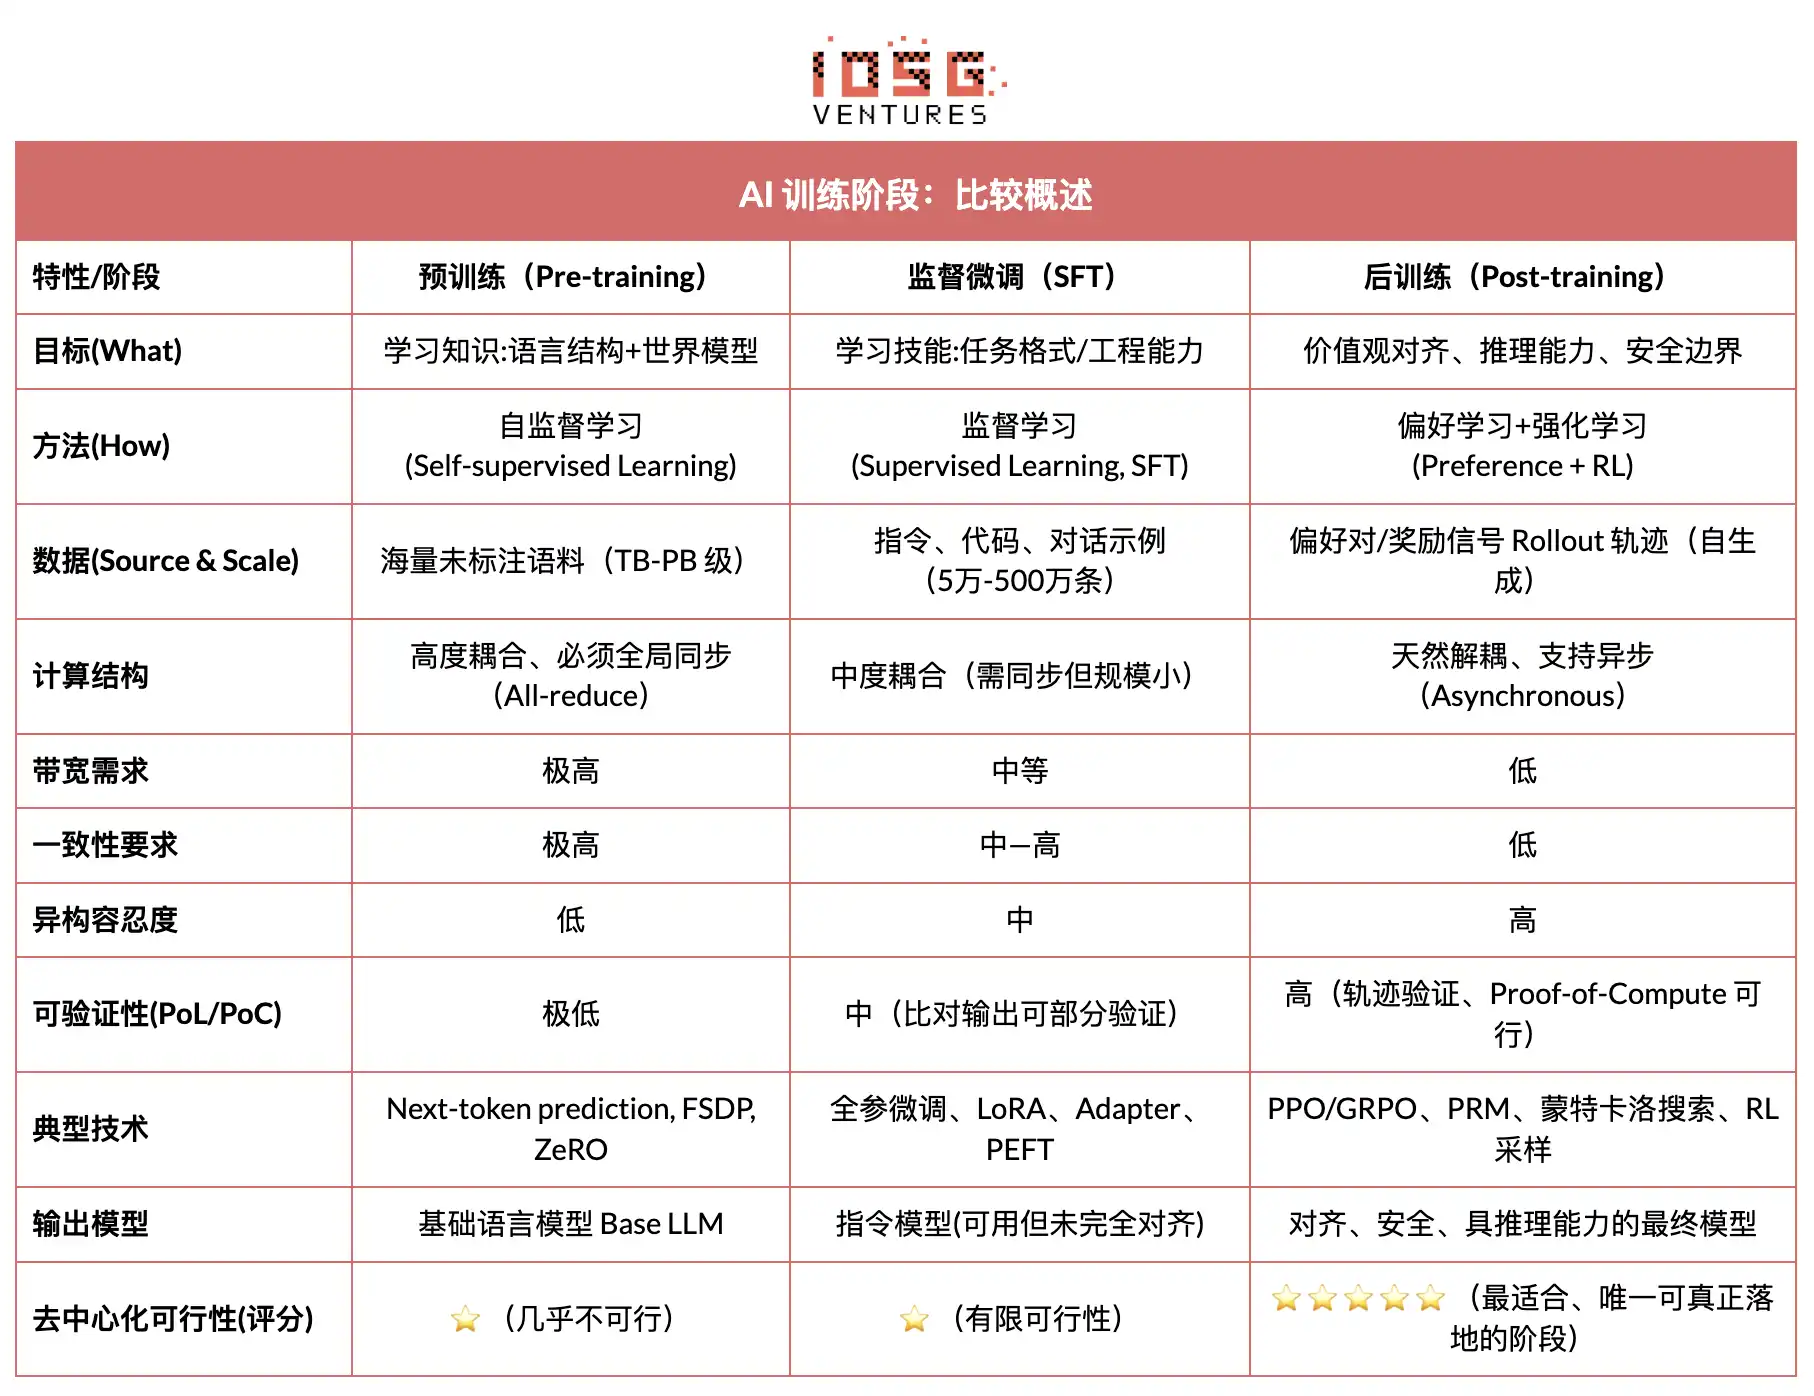
โดยทั่วไปแล้ว วงจรการฝึกฝนทั้งหมดของแบบจำลองภาษาขนาดใหญ่ (LLM) สมัยใหม่จะแบ่งออกเป็นสามขั้นตอนหลัก ได้แก่ การฝึกฝนเบื้องต้น การปรับแต่งอย่างละเอียดภายใต้การกำกับดูแล (SFT) และการฝึกฝนภายหลัง/การเรียนรู้แบบเสริมแรง (RL) ทั้งสามขั้นตอนดังกล่าวทำหน้าที่ "สร้างแบบจำลองโลก—ใส่ความสามารถของงาน—กำหนดรูปแบบการให้เหตุผลและคุณค่า" ตามลำดับ และโครงสร้างการคำนวณ ข้อกำหนดด้านข้อมูล และความยากในการตรวจสอบความถูกต้องจะเป็นตัวกำหนดระดับของการจับคู่แบบกระจายศูนย์
การฝึกฝนเบื้องต้น ผ่าน การเรียนรู้ด้วยตนเอง ขนาดใหญ่ จะสร้างโครงสร้างทางสถิติเชิงภาษาและแบบจำลองโลกข้ามรูปแบบของโมเดล ซึ่งเป็นรากฐานของความสามารถของ LLM ขั้นตอนนี้ต้องใช้การฝึกฝนกับคลังข้อมูลหลายล้านล้านชุดในลักษณะที่ซิงโครนัสทั่วโลก โดยอาศัยคลัสเตอร์ที่เป็นเนื้อเดียวกันของภาพ H100 จำนวนหลายพันถึงหลายหมื่นภาพ ค่าใช้จ่ายคิดเป็น 80-95% ของทั้งหมด และมีความอ่อนไหวอย่างยิ่งต่อแบนด์วิดท์และลิขสิทธิ์ข้อมูล ดังนั้นจึงต้องดำเนินการให้เสร็จสิ้นในสภาพแวดล้อมที่มีการรวมศูนย์สูง
การปรับแต่งอย่างละเอียดภายใต้การกำกับดูแล (Supervised fine-tuning ) ใช้เพื่อเพิ่มความสามารถของงานและรูปแบบคำสั่ง กระบวนการนี้ใช้ข้อมูลจำนวนน้อยและคิดเป็นประมาณ 5-15% ของต้นทุน การปรับแต่งอย่างละเอียดสามารถทำได้โดยใช้วิธี การฝึกอบรมแบบเต็มรูปแบบ (full-parameter training ) หรือวิธี การปรับแต่งอย่างละเอียดที่มีประสิทธิภาพเชิงพารามิเตอร์ (PEFT) ซึ่ง LoRA , Q-LoRA และ Adapter เป็นวิธีการหลักที่ใช้กันในอุตสาหกรรม อย่างไรก็ตาม ยังคงต้องมีการซิงโครไนซ์เกรเดียนต์ ซึ่งจำกัดศักยภาพแบบกระจายศูนย์ของวิธีการนี้
ขั้นตอนหลังการฝึกอบรม ประกอบด้วยขั้นตอนย่อยแบบวนซ้ำหลายขั้นตอนที่กำหนดความสามารถในการให้เหตุผล ค่านิยม และขอบเขตความปลอดภัยของโมเดล วิธีการต่างๆ ได้แก่ ระบบการเรียนรู้แบบเสริมแรง (RLHF, RLAIF, GRPO) วิธีการเพิ่มประสิทธิภาพความชอบโดยไม่ใช้ RL (DPO) และ โมเดลรางวัลกระบวนการ (PRM) ขั้นตอนนี้มีปริมาณข้อมูลและต้นทุนค่อนข้างต่ำ (5–10%) โดยเน้นที่การเปิดตัวและการอัปเดตนโยบายเป็นหลัก โดยธรรมชาติแล้วขั้นตอนนี้รองรับการทำงานแบบอะซิงโครนัสและแบบกระจายศูนย์ โหนดไม่จำเป็นต้องถือครองน้ำหนักทั้งหมด เมื่อรวมกับการคำนวณที่ตรวจสอบได้และแรงจูงใจบนบล็อกเชน จะสามารถสร้างเครือข่ายการฝึกอบรมแบบเปิดและกระจายศูนย์ ทำให้เป็นขั้นตอนการฝึกอบรมที่เหมาะสมที่สุดสำหรับ Web3
ภาพรวมของเทคโนโลยีการเรียนรู้แบบเสริมแรง: สถาปัตยกรรม เฟรมเวิร์ก และการประยุกต์ใช้งาน
สถาปัตยกรรมระบบและส่วนประกอบหลักของการเรียนรู้แบบเสริมแรง
การเรียนรู้แบบเสริมแรง (Reinforcement Learning หรือ RL) ผลักดันให้แบบจำลองพัฒนาความสามารถในการตัดสินใจอย่างอิสระผ่านกระบวนการ " การปฏิสัมพันธ์กับสิ่งแวดล้อม—การตอบรับรางวัล—การปรับปรุงนโยบาย " โครงสร้างหลักของมันสามารถมองได้ว่าเป็นวงจรป้อนกลับที่ประกอบด้วยสถานะ การกระทำ รางวัล และนโยบาย ระบบ RL ที่สมบูรณ์โดยทั่วไปประกอบด้วยสามส่วน ได้แก่ นโยบาย (เครือข่ายนโยบาย) การสุ่มตัวอย่างประสบการณ์ (Rollout) และผู้เรียน (ตัวปรับปรุงนโยบาย) นโยบายจะโต้ตอบกับสิ่งแวดล้อมเพื่อสร้างวิถี และผู้เรียนจะปรับปรุงนโยบายตามสัญญาณรางวัล จึงก่อให้เกิดกระบวนการเรียนรู้แบบวนซ้ำและปรับปรุงอย่างต่อเนื่อง
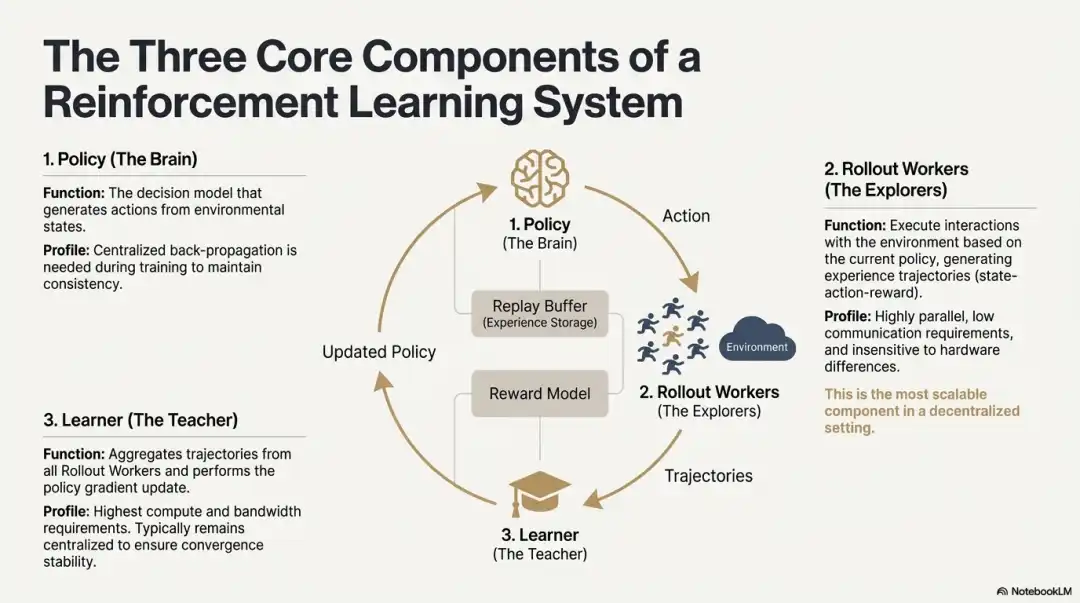
1. เครือข่ายนโยบาย (Policy Network) : สร้างการกระทำจากสถานะของสภาพแวดล้อม และเป็นหัวใจหลักของการตัดสินใจของระบบ ในระหว่างการฝึกฝน จำเป็นต้องใช้การแพร่กระจายย้อนกลับแบบรวมศูนย์เพื่อรักษาความสอดคล้อง ในระหว่างการอนุมาน สามารถกระจายไปยังโหนดต่างๆ เพื่อการประมวลผลแบบขนานได้
2. การขยายระบบ (Rollout ): โหนดต่างๆ จะโต้ตอบกับสภาพแวดล้อมตามนโยบาย โดยสร้างเส้นทางต่างๆ เช่น สถานะ การกระทำ และรางวัล กระบวนการนี้เป็นแบบขนานสูง ต้องการการสื่อสารน้อยมาก และไม่ไวต่อความแตกต่างของฮาร์ดแวร์ ทำให้เป็นขั้นตอนที่เหมาะสมที่สุดสำหรับการขยายระบบในสภาพแวดล้อมแบบกระจายศูนย์
3. ผู้เรียน (Learner) : รวบรวมเส้นทางการดำเนินการทั้งหมดและทำการอัปเดตการไล่ระดับนโยบาย โมดูลนี้มีความต้องการพลังการประมวลผลและแบนด์วิดท์สูงที่สุด ดังนั้นจึงมักถูกใช้งานในลักษณะรวมศูนย์หรือกระจายศูนย์เล็กน้อยเพื่อให้มั่นใจถึงเสถียรภาพในการบรรจบกัน
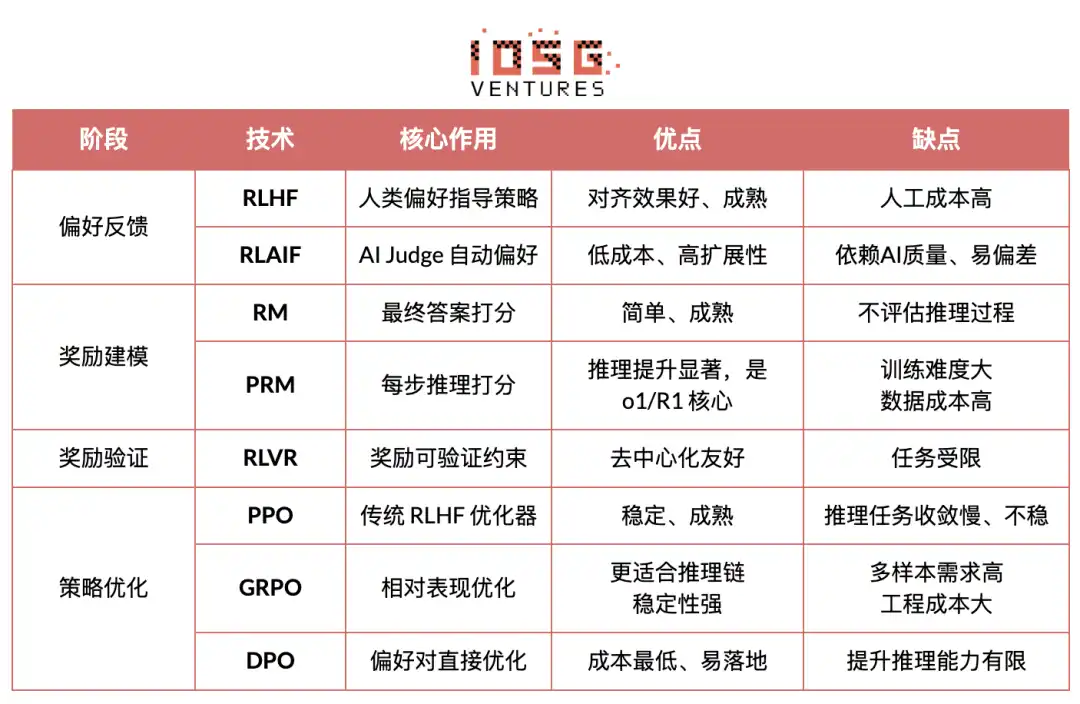
กรอบขั้นตอนการเรียนรู้แบบเสริมแรง (RLHF → RLAIF → PRM → GRPO)
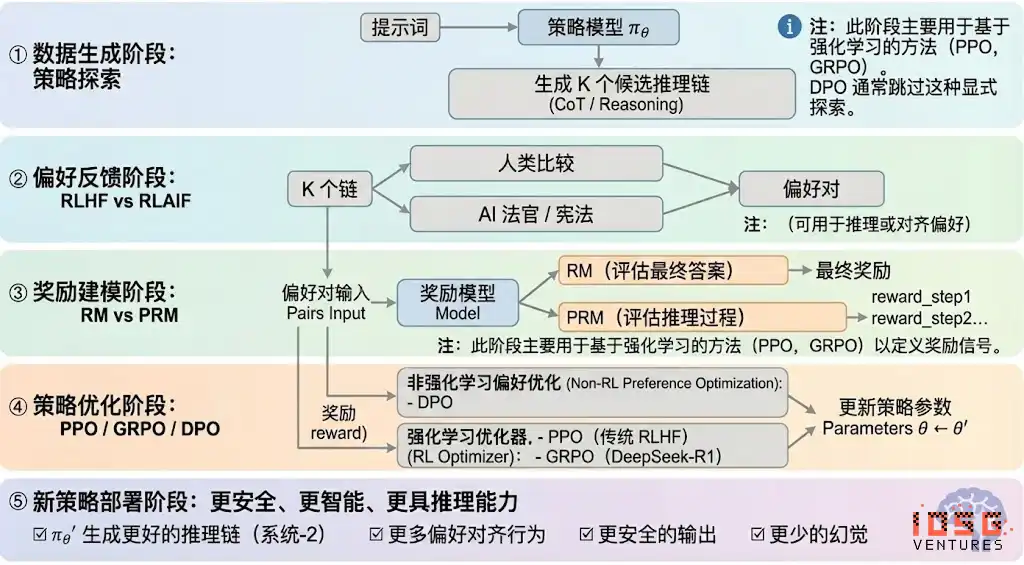
โดยทั่วไปแล้ว การเรียนรู้แบบเสริมแรงสามารถแบ่งออกได้เป็นห้าขั้นตอน และกระบวนการโดยรวมมีดังนี้:
ขั้นตอนการสร้างข้อมูล (การสำรวจนโยบาย)
เมื่อได้รับข้อมูลป้อนเข้า โมเดลนโยบาย πθ จะสร้างสายโซ่การอนุมานที่เป็นไปได้หลายสายหรือวิถีการเคลื่อนที่ที่สมบูรณ์ ซึ่งเป็นพื้นฐานตัวอย่างสำหรับการประเมินความชอบและการสร้างแบบจำลองรางวัลในภายหลัง และกำหนดขอบเขตของการสำรวจนโยบาย
ขั้นตอนการให้ข้อมูลย้อนกลับเกี่ยวกับความชอบ (RLHF / RLAIF)
• การเรียนรู้แบบเสริมแรงจากข้อเสนอแนะของมนุษย์ (Reinforcement Learning from Human Feedback: RLHF) ใช้คำตอบที่เป็นไปได้หลายคำตอบ การระบุความชอบของมนุษย์ การฝึกโมเดลรางวัล (Reward Model: RM) และกลยุทธ์การเพิ่มประสิทธิภาพ PPO เพื่อทำให้ผลลัพธ์ของโมเดลสอดคล้องกับค่านิยมของมนุษย์มากขึ้น นับเป็นขั้นตอนสำคัญในการเปลี่ยนผ่านจาก GPT-3.5 ไปสู่ GPT-4
• RLAIF (Reinforcement Learning from AI Feedback) แทนที่การระบุข้อมูลด้วยตนเองด้วย AI Judge หรือกฎเกณฑ์ตามรัฐธรรมนูญ เพื่อสร้างระบบอัตโนมัติในการกำหนดความชอบ ซึ่งช่วยลดต้นทุนได้อย่างมากและมีความสามารถในการขยายขนาดได้ โดยได้กลายเป็นรูปแบบการจัดเรียงข้อมูลหลักสำหรับบริษัทต่างๆ เช่น Anthropic, OpenAI และ DeepSeek
ขั้นตอนการสร้างแบบจำลองรางวัล
โมเดลการให้รางวัลตามความชอบเรียนรู้ที่จะเชื่อมโยงผลลัพธ์กับรางวัล โมเดล RM สอนโมเดลว่า "อะไรคือคำตอบที่ถูกต้อง" ในขณะที่โมเดล PRM สอนโมเดลว่า "วิธีการใช้เหตุผลที่ถูกต้อง"
• โมเดลการให้รางวัล (Reward Model: RM) ใช้ในการประเมินคุณภาพของคำตอบสุดท้าย โดยให้คะแนนเฉพาะผลลัพธ์เท่านั้น:
• โมเดลการให้รางวัลตามกระบวนการ (Process Reward Model หรือ PRM) ไม่เพียงแต่ประเมินคำตอบสุดท้ายเท่านั้น แต่ยังให้คะแนนในแต่ละขั้นตอนของการให้เหตุผล แต่ละโทเค็น และแต่ละส่วนตรรกะด้วย นอกจากนี้ยังเป็นเทคโนโลยีสำคัญของ OpenAI o1 และ DeepSeek-R1 ซึ่งโดยพื้นฐานแล้วเป็นการสอนให้โมเดลรู้วิธีคิด
ขั้นตอนการตรวจสอบรางวัล (RLVR)
การนำ "ข้อจำกัดที่ตรวจสอบได้" มาใช้ในการสร้างและการใช้สัญญาณรางวัลจะช่วยให้มั่นใจได้ว่ารางวัลนั้นมาจากกฎ ข้อเท็จจริง หรือฉันทามติที่สามารถทำซ้ำได้ ซึ่งจะช่วยลดความเสี่ยงจากการแฮ็กรางวัลและอคติ และปรับปรุงความสามารถในการตรวจสอบและขยายขนาดในสภาพแวดล้อมแบบเปิด
ขั้นตอนการเพิ่มประสิทธิภาพนโยบาย
กระบวนการนี้เกี่ยวข้องกับการปรับปรุงพารามิเตอร์นโยบาย θ ภายใต้การชี้นำของสัญญาณจากแบบจำลองรางวัล เพื่อให้ได้นโยบาย πθ′ ที่มีความสามารถในการให้เหตุผลที่แข็งแกร่งขึ้น ความปลอดภัยที่สูงขึ้น และรูปแบบพฤติกรรมที่เสถียรยิ่งขึ้น วิธีการเพิ่มประสิทธิภาพหลักๆ ได้แก่:
• PPO (Proximal Policy Optimization) : ตัวปรับแต่งแบบดั้งเดิมใน RLHF ซึ่งเป็นที่รู้จักในด้านความเสถียร แต่ก็มักมีข้อจำกัด เช่น การลู่เข้าที่ช้า และความเสถียรไม่เพียงพอในงานอนุมานที่ซับซ้อน
• GRPO (Group Relative Policy Optimization) : นวัตกรรมหลักของ DeepSeek-R1 โดยประมาณค่าที่คาดหวังโดยการจำลองการกระจายความได้เปรียบภายในกลุ่มคำตอบที่เป็นไปได้ แทนที่จะจัดอันดับเพียงอย่างเดียว วิธีนี้รักษาข้อมูลขนาดของรางวัลไว้ เหมาะสมกว่าสำหรับการเพิ่มประสิทธิภาพของห่วงโซ่การอนุมาน และมีกระบวนการฝึกฝนที่เสถียรกว่า ถือเป็นกรอบการทำงานการเพิ่มประสิทธิภาพการเรียนรู้แบบเสริมแรงที่สำคัญสำหรับสถานการณ์การอนุมานเชิงลึกหลังจาก PPO
• DPO (Direct Preference Optimization) : เป็นวิธีการหลังการฝึกฝนที่ไม่ใช่วิธีการเรียนรู้แบบเสริมแรง วิธีการนี้ไม่ได้สร้างวิถีหรือสร้างแบบจำลองรางวัล แต่จะปรับคู่ความชอบโดยตรง มีต้นทุนต่ำและเสถียร จึงถูกนำมาใช้กันอย่างแพร่หลายสำหรับการจัดเรียงในแบบจำลองโอเพนซอร์ส เช่น Llama และ Gemma แต่ไม่ได้ปรับปรุงความสามารถในการอนุมาน
ขั้นตอนการนำนโยบายใหม่มาใช้
โมเดลที่ได้รับการปรับปรุงให้เหมาะสมนี้ แสดงให้เห็นถึงความสามารถในการสร้างห่วงโซ่การให้เหตุผลที่ดีขึ้น (การให้เหตุผลแบบระบบ 2) พฤติกรรมที่สอดคล้องกับความต้องการของมนุษย์หรือ AI มากขึ้น อัตราการเกิดภาพหลอนลดลง และความปลอดภัยที่สูงขึ้น ด้วยการทำซ้ำอย่างต่อเนื่อง โมเดลจะเรียนรู้ความต้องการ ปรับกระบวนการให้เหมาะสม และปรับปรุงคุณภาพการตัดสินใจ ก่อให้เกิดวงจรปิด
การประยุกต์ใช้การเรียนรู้แบบเสริมแรงในอุตสาหกรรมมี 5 ประเภทหลัก
การเรียนรู้แบบเสริมแรงได้ พัฒนาจากปัญญาประดิษฐ์เชิงทฤษฎีเกมในยุคแรกเริ่ม มาเป็นกรอบการทำงานหลักสำหรับการตัดสินใจแบบอัตโนมัติในอุตสาหกรรมต่างๆ สถานการณ์การประยุกต์ใช้สามารถแบ่งออกเป็น 5 ประเภทหลักตามความพร้อมของเทคโนโลยีและการนำไปใช้ในอุตสาหกรรม และแต่ละประเภทได้ผลักดันให้เกิดความก้าวหน้าครั้งสำคัญในทิศทางของตนเอง
• ระบบเกมและกลยุทธ์ : นี่เป็นพื้นที่แรกสุดของ RL ที่ได้รับการพิสูจน์แล้ว ในสภาพแวดล้อมที่มี "ข้อมูลสมบูรณ์ + รางวัลที่ชัดเจน" เช่น AlphaGo, AlphaZero, AlphaStar และ OpenAI Five นั้น RL ได้แสดงให้เห็นถึงความฉลาดในการตัดสินใจที่สามารถเทียบเท่าหรือเหนือกว่าผู้เชี่ยวชาญที่เป็นมนุษย์ได้ ซึ่งเป็นการวางรากฐานสำหรับอัลกอริธึม RL สมัยใหม่
• วิทยาการหุ่นยนต์และปัญญาประดิษฐ์เชิงกายภาพ : การเรียนรู้แบบเสริมแรง (RL) ช่วยให้หุ่นยนต์เรียนรู้การจัดการ การควบคุมการเคลื่อนไหว และงานข้ามรูปแบบ (เช่น RT-2 และ RT-X) ผ่านการควบคุมอย่างต่อเนื่อง การสร้างแบบจำลองไดนามิก และการโต้ตอบกับสภาพแวดล้อม เทคโนโลยีนี้กำลังก้าวไปสู่การใช้งานในระดับอุตสาหกรรมอย่างรวดเร็ว และเป็นเส้นทางเทคโนโลยีที่สำคัญสำหรับการประยุกต์ใช้หุ่นยนต์ในโลกแห่งความเป็นจริง
• การให้เหตุผลเชิงดิจิทัล (ระบบ LLM-2) : RL + PRM ขับเคลื่อนโมเดลขนาดใหญ่จาก "การเลียนแบบภาษา" ไปสู่ "การให้เหตุผลเชิงโครงสร้าง" ตัวอย่างความสำเร็จ ได้แก่ DeepSeek-R1, OpenAI o1/o3, Anthropic Claude และ AlphaGeometry สาระสำคัญคือการเพิ่มประสิทธิภาพรางวัลในระดับห่วงโซ่การให้เหตุผล แทนที่จะประเมินเพียงคำตอบสุดท้าย
• การค้นพบทางวิทยาศาสตร์อัตโนมัติและการเพิ่มประสิทธิภาพทางคณิตศาสตร์ : RL แสวงหาโครงสร้างหรือกลยุทธ์ที่เหมาะสมที่สุดในพื้นที่รางวัลที่ซับซ้อนและไม่มีป้ายกำกับ รวมถึงพื้นที่การค้นหาขนาดใหญ่ และประสบความสำเร็จในการค้นพบที่สำคัญ เช่น AlphaTensor, AlphaDev และ Fusion RL ซึ่งแสดงให้เห็นถึงความสามารถในการสำรวจที่เหนือกว่าสัญชาตญาณของมนุษย์
• การตัดสินใจทางเศรษฐกิจและการซื้อขาย : RL ถูกนำมาใช้เพื่อเพิ่มประสิทธิภาพกลยุทธ์ การควบคุมความเสี่ยงในมิติสูง และการสร้างระบบการซื้อขายแบบปรับตัวได้ เมื่อเปรียบเทียบกับแบบจำลองเชิงปริมาณแบบดั้งเดิม RL สามารถเรียนรู้ได้อย่างต่อเนื่องในสภาพแวดล้อมที่ไม่แน่นอน และเป็นองค์ประกอบสำคัญของระบบการเงินอัจฉริยะ
เป็นการจับคู่ที่ลงตัวระหว่างการเรียนรู้แบบเสริมแรงและ Web3
ความเข้ากันได้ในระดับสูงระหว่างการเรียนรู้แบบเสริมแรง (Reinforcement Learning หรือ RL) และ Web3 เกิดจากข้อเท็จจริงที่ว่าทั้งสองอย่างเป็น "ระบบที่ขับเคลื่อนด้วยแรงจูงใจ" โดยพื้นฐานแล้ว RL อาศัยสัญญาณรางวัลเพื่อปรับกลยุทธ์ให้เหมาะสม ในขณะที่บล็อกเชนอาศัยแรงจูงใจทางเศรษฐกิจเพื่อประสานพฤติกรรมของผู้เข้าร่วม ทำให้ทั้งสองอย่างสอดคล้องกันในระดับกลไก ข้อกำหนดหลักของ RL ได้แก่ การใช้งานในวงกว้างที่ไม่เหมือนกัน การกระจายรางวัล และการตรวจสอบความถูกต้อง ซึ่งเป็นจุดที่ Web3 มีข้อได้เปรียบเชิงโครงสร้างอย่างแม่นยำ
การแยกส่วนการให้เหตุผลและการฝึกฝน
กระบวนการฝึกฝนแบบการเรียนรู้เสริมแรงสามารถแบ่งออกได้เป็นสองขั้นตอนอย่างชัดเจน:
• การเปิดตัว (การสุ่มตัวอย่างเชิงสำรวจ) : โมเดลสร้างข้อมูลจำนวนมากโดยอิงตามนโยบายปัจจุบัน ซึ่งเป็นงาน ที่ต้องใช้การคำนวณสูง แต่ มีการสื่อสารน้อย ไม่จำเป็นต้องมีการสื่อสารระหว่างโหนดบ่อยครั้ง และเหมาะสำหรับการสร้างแบบขนานบน GPU ระดับผู้บริโภคที่กระจายอยู่ทั่วโลก
• การอัปเดต (การอัปเดตพารามิเตอร์) : อัปเดตค่าน้ำหนักของโมเดลตามข้อมูลที่รวบรวมได้ ซึ่งต้องใช้โหนดส่วนกลางที่มีแบนด์วิธสูงในการดำเนินการให้เสร็จสมบูรณ์
"การแยกส่วนการอนุมานและการฝึกอบรม" เป็นสิ่งที่เหมาะสมอย่างยิ่งสำหรับโครงสร้างพลังการประมวลผลแบบกระจายศูนย์ที่หลากหลาย: การใช้งานสามารถมอบหมายให้เครือข่ายเปิดภายนอกและชำระเงินตามการมีส่วนร่วมผ่านกลไกโทเค็น ในขณะที่การอัปเดตโมเดลยังคงอยู่ที่ส่วนกลางเพื่อให้มั่นใจในเสถียรภาพ
ความสามารถในการตรวจสอบ
ZooKeeper (ZK) และ Proof-of-Learning เป็นวิธีการตรวจสอบว่าโหนดต่างๆ กำลังทำการอนุมานอยู่จริงหรือไม่ ซึ่งช่วยแก้ปัญหาเรื่องความซื่อสัตย์ในเครือข่ายแบบเปิด ในงานที่กำหนดผลลัพธ์ได้แน่นอน เช่น การเขียนโค้ดและการให้เหตุผลทางคณิตศาสตร์ ผู้ตรวจสอบเพียงแค่ตรวจสอบคำตอบเพื่อยืนยันปริมาณงาน ซึ่งช่วยเพิ่มความน่าเชื่อถือของระบบ RL แบบกระจายศูนย์ได้อย่างมาก
ชั้นแรงจูงใจ โดยอิงจากกลไกการผลิตผลตอบรับของระบบเศรษฐกิจโทเค็น
กลไกโทเค็นของ Web3 สามารถให้รางวัลแก่ผู้มีส่วนร่วมในการให้ข้อมูลป้อนกลับเกี่ยวกับความชอบของ RLHF/RLAIF ได้โดยตรง ทำให้การสร้างข้อมูลความชอบมีโครงสร้างแรงจูงใจที่โปร่งใส ตรวจสอบได้ และไม่จำเป็นต้องขออนุญาต นอกจากนี้ การวางเดิมพันและการตัดทอนยังจำกัดคุณภาพของข้อมูลป้อนกลับ ทำให้เกิดตลาดข้อมูลป้อนกลับที่มีประสิทธิภาพและสอดคล้องกันมากกว่าการระดมความคิดจากมวลชนแบบดั้งเดิม
ศักยภาพของการเรียนรู้เสริมแรงแบบหลายเอเจนต์ (MARL)
โดยพื้นฐานแล้ว บล็อกเชนเป็นสภาพแวดล้อมแบบหลายเอเจนต์ที่เปิดเผย โปร่งใส และพัฒนาอย่างต่อเนื่อง บัญชี สัญญา และเอเจนต์ต่างปรับกลยุทธ์ของตนอย่างต่อเนื่องภายใต้เงื่อนไขที่ขับเคลื่อนด้วยแรงจูงใจ ทำให้มีศักยภาพในการสร้างแพลตฟอร์มทดสอบ MARL ขนาดใหญ่ แม้ว่าจะยังอยู่ในช่วงเริ่มต้น แต่คุณลักษณะของสถานะสาธารณะ การดำเนินการที่ตรวจสอบได้ และแรงจูงใจที่ตั้งโปรแกรมได้นั้น ถือเป็นข้อได้เปรียบพื้นฐานสำหรับการพัฒนา MARL ในอนาคต
การวิเคราะห์โครงการ Web3 คลาสสิก + การเรียนรู้แบบเสริมแรง
จากกรอบทฤษฎีข้างต้น เราจะวิเคราะห์โครงการที่เป็นตัวแทนมากที่สุดในระบบนิเวศปัจจุบันโดยสังเขป:
ไพรม์ อิลเลคท์: รูปแบบการเรียนรู้เสริมแรงแบบอะซิงโครนัส
Prime Intellect มุ่งมั่นที่จะสร้างตลาดการประมวลผลแบบเปิดระดับโลก ลดอุปสรรคในการฝึกอบรม ส่งเสริมการฝึกอบรมแบบกระจายศูนย์และร่วมมือกัน และพัฒนาเทคโนโลยีซูเปอร์อินเทลลิเจนซ์แบบโอเพนซอร์สที่สมบูรณ์แบบ ระบบนิเวศของ Prime Intellect ประกอบด้วย: Prime Compute (สภาพแวดล้อมการประมวลผลแบบคลาวด์/กระจายศูนย์แบบครบวงจร), ตระกูลโมเดล INTELLECT (10B–100B+), Environments Hub (ศูนย์กลางสภาพแวดล้อมการเรียนรู้แบบเสริมแรงแบบเปิด) และเครื่องมือสร้างข้อมูลสังเคราะห์ขนาดใหญ่ (SYNTHETIC-1/2)
ส่วนประกอบโครงสร้างพื้นฐานหลักของ Prime Intellect คือเฟรมเวิร์ก prime-rl ซึ่งได้รับการออกแบบมาสำหรับสภาพแวดล้อมแบบกระจายที่ไม่ซิงโครนัส และมีความเกี่ยวข้องอย่างมากกับการเรียนรู้แบบเสริมแรง ส่วนประกอบอื่นๆ ได้แก่ โปรโตคอลการสื่อสาร OpenDiLoCo เพื่อเอาชนะปัญหาคอขวดของแบนด์วิดท์ และ กลไกการตรวจสอบ TopLoc เพื่อรับรองความสมบูรณ์ของการคำนวณ
ภาพรวมของส่วนประกอบโครงสร้างพื้นฐานหลักของ Prime Intellect
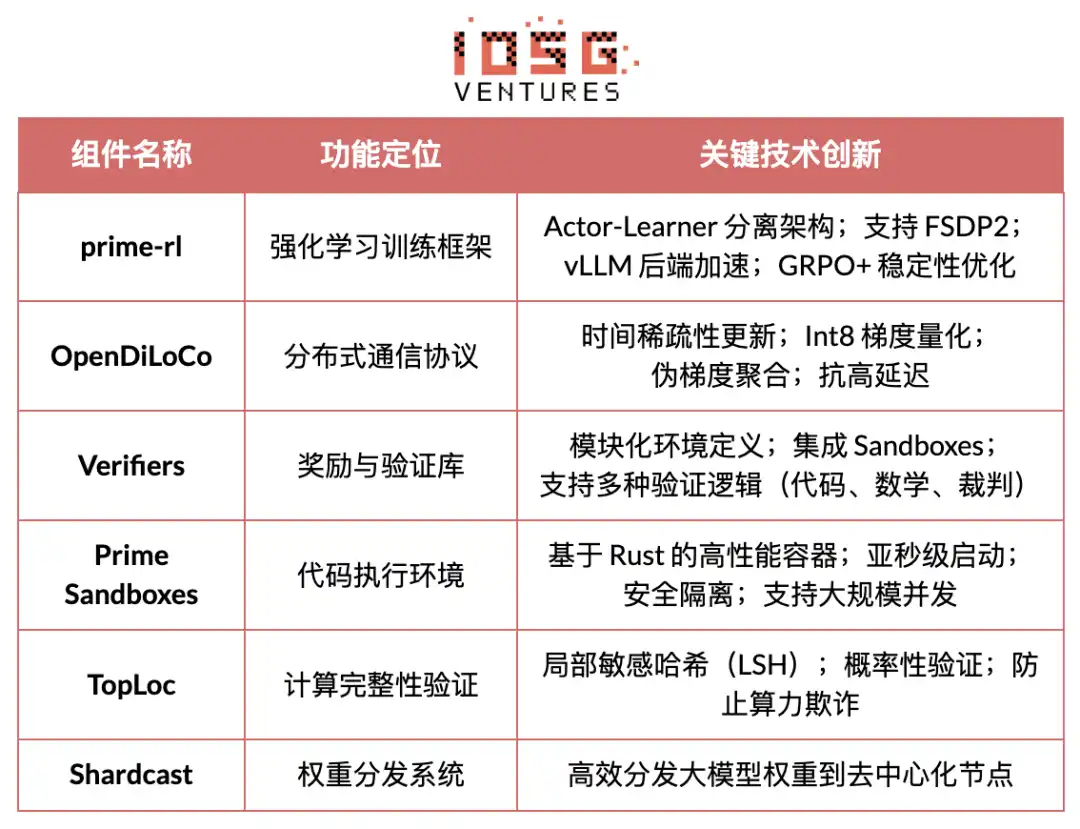
พื้นฐานทางเทคนิค: เฟรมเวิร์กการเรียนรู้แบบเสริมแรงแบบอะซิงโครนัส prime-rl
prime-rl คือกลไกหลักในการฝึกฝนของ Prime Intellect ซึ่งออกแบบมาโดยเฉพาะสำหรับสภาพแวดล้อมแบบกระจายศูนย์ขนาดใหญ่ที่ไม่ซิงโครนัส โดยสามารถประมวลผลข้อมูลได้อย่างรวดเร็วและอัปเดตได้อย่างเสถียรผ่านการแยกส่วน Actor และ Learner อย่างสมบูรณ์ Worker และ Learner ของ Rollout จะไม่ถูกบล็อกแบบซิงโครนัสอีกต่อไป โหนดสามารถเข้าร่วมหรือออกจากระบบได้ตลอดเวลา โดยดึงกลยุทธ์ล่าสุดและอัปโหลดข้อมูลที่สร้างขึ้นอย่างต่อเนื่อง
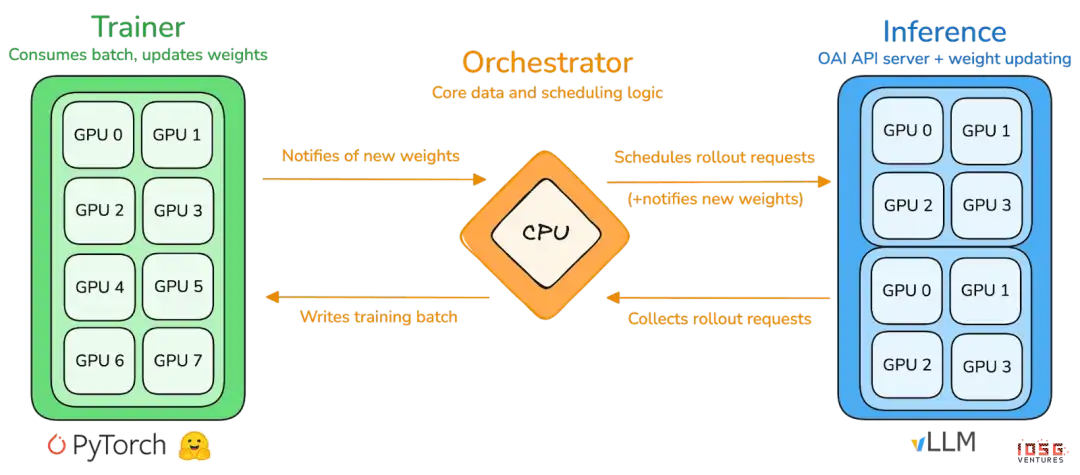
• Actor (Rollout Workers) : รับผิดชอบการอนุมานโมเดลและการสร้างข้อมูล Prime Intellect ได้ผสานรวมเอ็นจิ้นการอนุมาน vLLM เข้ากับฝั่ง Actor อย่างสร้างสรรค์ เทคโนโลยี PagedAttention และความสามารถในการประมวลผลแบบต่อเนื่องของ vLLM ช่วยให้ Actor สามารถสร้างเส้นทางการอนุมานด้วยปริมาณงานที่สูงมาก
• ผู้เรียน (ผู้ฝึกสอน) : รับผิดชอบในการปรับปรุงนโยบายให้เหมาะสมที่สุด ผู้เรียนจะดึงข้อมูลจาก Experience Buffer ที่ใช้ร่วมกันแบบอะซิงโครนัสเพื่ออัปเดตค่าเกรเดียนต์โดยไม่ต้องรอให้ Actor ทุกตัวทำงานในชุดปัจจุบันเสร็จสิ้น
• ผู้ประสานงาน : รับผิดชอบในการกำหนดตารางน้ำหนักของโมเดลและการไหลของข้อมูล
นวัตกรรมสำคัญของ prime-rl
• การทำงานแบบอะซิงโครนัสอย่างแท้จริง : prime-rl ละทิ้งรูปแบบการทำงานแบบซิงโครนัสของ PPO แบบดั้งเดิม ไม่รอโหนดที่ทำงานช้า และไม่ต้องการการจัดเรียงแบบกลุ่ม ทำให้สามารถเข้าถึง GPU จำนวนเท่าใดก็ได้และประสิทธิภาพเท่าใดก็ได้ในเวลาใดก็ได้ ซึ่งเป็นการวางรากฐานสำหรับความเป็นไปได้ของการเรียนรู้แบบเสริมแรงแบบกระจายศูนย์
• การผสานรวม FSDP2 และ MoE อย่างลึกซึ้ง: ด้วยการแบ่งส่วนพารามิเตอร์ของ FSDP2 และการเปิดใช้งานแบบสปาร์สของ MoE ทำให้ prime-rl สามารถฝึกฝนโมเดลหลายพันล้านโมเดลได้อย่างมีประสิทธิภาพในสภาพแวดล้อมแบบกระจาย Actor จะเรียกใช้เฉพาะผู้เชี่ยวชาญที่ทำงานอยู่เท่านั้น ซึ่งช่วยลดหน่วยความจำ GPU และต้นทุนการอนุมานได้อย่างมาก
• GRPO+ (Group Relative Policy Optimization) : GRPO ขจัดเครือข่าย Critic ซึ่งช่วยลดภาระการคำนวณและหน่วยความจำได้อย่างมาก และปรับให้เข้ากับสภาพแวดล้อมแบบอะซิงโครนัสได้อย่างเป็นธรรมชาติ นอกจากนี้ GRPO+ ของ Prime-RL ยังช่วยให้มั่นใจได้ถึงการบรรจบกันอย่างน่าเชื่อถือภายใต้สภาวะความหน่วงสูงผ่านกลไกการรักษาเสถียรภาพ
ตระกูลโมเดล INTELLECT: ตัวชี้วัดความก้าวหน้าของเทคโนโลยีการเรียนรู้แบบเสริมแรงแบบกระจายศูนย์
INTELLECT-1 (10B, ตุลาคม 2024 ) เป็นโครงการแรกที่แสดงให้เห็นว่า OpenDiLoCo สามารถฝึกฝนได้อย่างมีประสิทธิภาพในเครือข่ายที่หลากหลายซึ่งครอบคลุมสามทวีป (อัตราส่วนการสื่อสาร <2%, การใช้พลังการประมวลผล 98%) ซึ่งเป็นการทำลายความเข้าใจทางกายภาพเกี่ยวกับการฝึกฝนข้ามภูมิภาค
INTELLECT-2 (32B, เมษายน 2025) เป็นโมเดล RL แบบไร้การอนุญาตตัวแรก ซึ่งตรวจสอบความสามารถในการบรรจบกันอย่างเสถียรของ prime-rl และ GRPO+ ในสภาพแวดล้อมที่มีความล่าช้าหลายขั้นตอนและแบบอะซิงโครนัส และทำให้เกิด RL แบบกระจายศูนย์ด้วยการมีส่วนร่วมของพลังการประมวลผลแบบเปิดทั่วโลก
INTELLECT-3 (106B MoE, พฤศจิกายน 2025) ใช้สถาปัตยกรรมแบบสปาร์สที่เปิดใช้งานพารามิเตอร์เพียง 12 พันล้านตัวเท่านั้น ได้รับการฝึกฝนบนชุดข้อมูล 512×H200 และบรรลุประสิทธิภาพการอนุมานระดับเรือธง (AIME 90.8%, GPQA 74.4%, MMLU-Pro 81.9% เป็นต้น) ประสิทธิภาพโดยรวมของมันใกล้เคียงหรืออาจเหนือกว่าโมเดลแบบปิดแหล่งที่มาแบบรวมศูนย์ซึ่งมีขนาดใหญ่กว่ามาก
Prime Intellect ยังได้สร้างส่วนประกอบโครงสร้างพื้นฐานที่สนับสนุนอีกหลายอย่าง ได้แก่ OpenDiLoCo ซึ่ง ช่วยลดการสื่อสารการฝึกอบรมข้ามภูมิภาคได้หลายร้อยเท่าผ่านการสื่อสารแบบเบาบางชั่วคราวและความแตกต่างของน้ำหนักการควอนไทเซชัน ทำให้ INTELLECT-1 สามารถรักษาอัตราการใช้งานได้ 98% ในสามทวีป; TopLoc + Verifiers สร้าง เลเยอร์การดำเนินการที่เชื่อถือได้แบบกระจายศูนย์ เพื่อเปิดใช้งานการตรวจสอบลายนิ้วมือและแซนด์บ็อกซ์เพื่อให้มั่นใจในความถูกต้องของข้อมูลการอนุมานและรางวัล ; เอ็นจิ้นข้อมูล SYNTHETIC สร้างห่วงโซ่การอนุมานขนาดใหญ่และมีคุณภาพสูง และช่วยให้โมเดล 671B ทำงานได้อย่างมีประสิทธิภาพบนคลัสเตอร์ GPU ระดับผู้บริโภคผ่านการประมวลผลแบบขนานแบบไปป์ไลน์ ส่วนประกอบเหล่านี้เป็นรากฐานทางวิศวกรรมที่สำคัญสำหรับการสร้างข้อมูล การตรวจสอบ และปริมาณงานการอนุมานใน RL แบบกระจายศูนย์ ซีรี่ส์ INTELLECT แสดงให้เห็นว่าเทคโนโลยีนี้สามารถสร้างโมเดลระดับโลกที่สมบูรณ์ได้ ซึ่งเป็นการบ่งบอกถึงการเปลี่ยนผ่านของระบบการฝึกอบรมแบบกระจายศูนย์จากขั้นแนวคิดไปสู่ขั้นการใช้งานจริง
Gensyn: ชุดเครื่องมือหลักสำหรับการเรียนรู้แบบเสริมแรง (Reinforcement Learning), Swarm และ SAPO
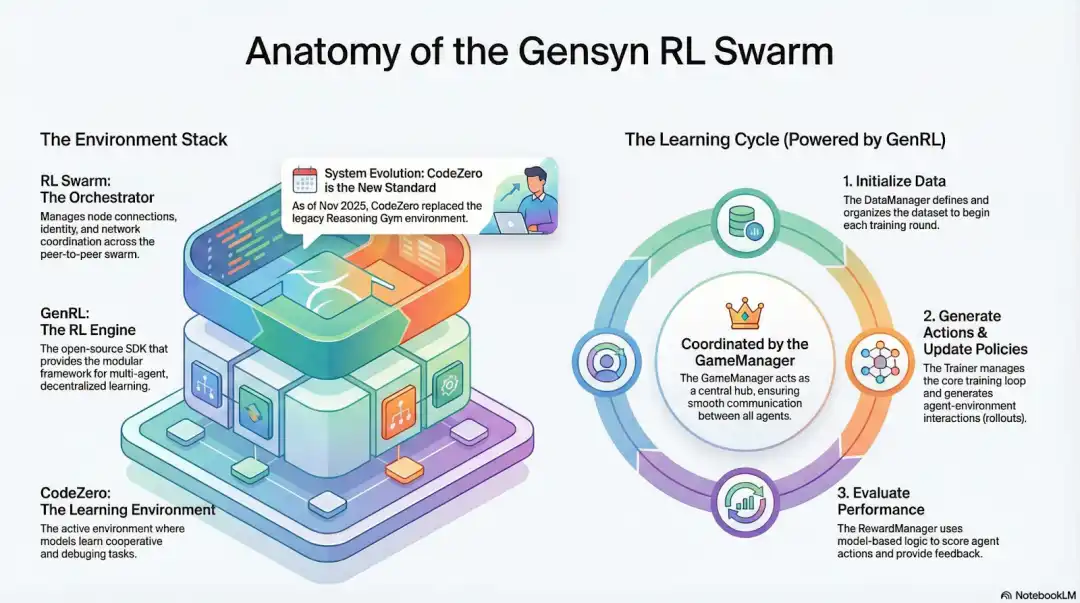
เป้าหมายของ Gensyn คือการรวบรวมพลังการประมวลผลที่ไม่ได้ใช้งานทั่วโลกเข้าไว้ในโครงสร้างพื้นฐานการฝึกอบรม AI ที่เปิดกว้าง ไม่ต้องอาศัยความไว้วางใจ และปรับขนาดได้อย่างไม่จำกัด หัวใจหลักของ Gensyn ประกอบด้วย เลเยอร์การดำเนินการที่เป็นมาตรฐานเดียวกันในทุกอุปกรณ์ เครือข่ายการประสานงานแบบ Peer-to-Peer และระบบตรวจสอบงานที่ไม่ต้องอาศัยความไว้วางใจ โดยจะจัดสรรงานและรางวัลโดยอัตโนมัติผ่านสัญญาอัจฉริยะ Gensyn ใช้ประโยชน์จากคุณลักษณะของการเรียนรู้แบบเสริมแรง (Reinforcement Learning) โดยนำกลไกหลัก เช่น RL Swarm, SAPO และ SkipPipe มาใช้เพื่อแยกขั้นตอน การสร้าง การประเมิน และการอัปเดต โดยใช้ "ฝูง" ของ GPU ที่หลากหลายทั่วโลกเพื่อให้เกิดวิวัฒนาการร่วมกัน ท้ายที่สุดแล้ว Gensyn ไม่ได้ให้เพียงแค่พลังการประมวลผล แต่ยังให้ ความฉลาดที่ตรวจสอบได้อีกด้วย
การประยุกต์ใช้การเรียนรู้แบบเสริมแรงของ Gensyn Stack
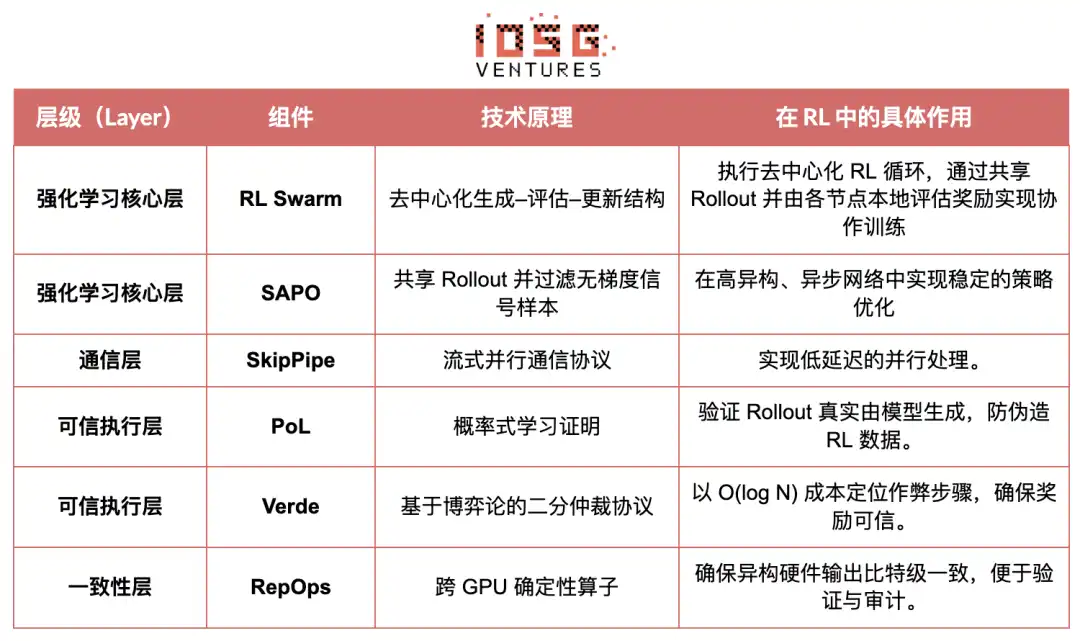
RL Swarm: เครื่องมือการเรียนรู้แบบเสริมแรงร่วมกันแบบกระจายศูนย์
RL Swarm แสดงให้เห็นถึงรูปแบบการทำงานร่วมกันแบบใหม่โดยสิ้นเชิง ไม่ใช่เพียงแค่ระบบกระจายงานธรรมดาอีกต่อไป แต่เป็นวงจร "สร้าง-ประเมิน-อัปเดต" แบบกระจายศูนย์ที่จำลองการเรียนรู้ทางสังคมของมนุษย์ คล้ายกับกระบวนการเรียนรู้แบบร่วมมือกันที่มีวงจรไม่สิ้นสุด:
• ตัวแก้ปัญหา (ตัวดำเนินการ) : รับผิดชอบการอนุมานแบบจำลองในระดับท้องถิ่นและการสร้าง Rollout โดยทำงานร่วมกันได้อย่างราบรื่นระหว่างโหนดที่แตกต่างกัน Gensyn ผสานรวมเครื่องมืออนุมานที่มีประสิทธิภาพสูง (เช่น CodeZero) ไว้ในระดับท้องถิ่น โดยส่งออกเส้นทางทั้งหมดแทนที่จะเป็นเพียงคำตอบ
• ผู้เสนอแนวคิด : สร้างงาน (โจทย์คณิตศาสตร์ โจทย์การเขียนโปรแกรม ฯลฯ) แบบไดนามิก โดยสนับสนุนความหลากหลายของงานและความยากที่ปรับเปลี่ยนได้คล้ายกับการเรียนรู้ตามหลักสูตร
• ผู้ประเมิน : ใช้ "แบบจำลองการตัดสิน" หรือกฎเกณฑ์ที่ตายตัวในการประเมินการเปิดตัวในระดับท้องถิ่น และ สร้างสัญญาณรางวัลในระดับท้องถิ่น กระบวนการประเมินสามารถตรวจสอบได้ ซึ่งช่วยลดโอกาสในการกระทำการที่เป็นอันตราย
องค์ประกอบทั้งสามนี้รวมกันเป็นโครงสร้างองค์กรแบบ P2P RL ซึ่งช่วยให้การเรียนรู้ร่วมกันในวงกว้างเป็นไปได้โดยไม่ต้องมีการกำหนดตารางเวลาจากส่วนกลาง
SAPO: อัลกอริทึมการเพิ่มประสิทธิภาพกลยุทธ์สำหรับการฟื้นฟูแบบกระจายอำนาจ
SAPO (Swarm Sampling Policy Optimization) เน้นที่ " การแบ่งปัน Rollout และการกรองตัวอย่างสัญญาณที่ไม่มีเกรเดียนต์ แทนที่จะแบ่งปันเกรเดียนต์ " ด้วยการสุ่มตัวอย่าง Rollout แบบกระจายศูนย์ขนาดใหญ่ และการพิจารณา Rollout ที่ได้รับว่าเป็น Rollout ที่สร้างขึ้นในพื้นที่ ทำให้สามารถรักษาเสถียรภาพการบรรจบกันในสภาพแวดล้อมที่ไม่มีการประสานงานจากส่วนกลางและมีความแตกต่างอย่างมากในความหน่วงของโหนด เมื่อเทียบกับ PPO ซึ่งอาศัยเครือข่าย Critic และมีต้นทุนการคำนวณสูง หรือ GRPO ซึ่งอิงจากการประมาณค่าความได้เปรียบภายในกลุ่ม SAPO ช่วยให้ GPU ระดับผู้บริโภคสามารถมีส่วนร่วมในการเพิ่มประสิทธิภาพการเรียนรู้แบบเสริมแรงขนาดใหญ่ได้อย่างมีประสิทธิภาพด้วยแบนด์วิดท์ที่ต่ำมาก
ผ่านทาง RL Swarm และ SAPO นั้น Gensyn แสดงให้เห็นว่าการเรียนรู้แบบเสริมแรง ( โดยเฉพาะ RLVR หลังการฝึกฝน ) เหมาะสมอย่างยิ่งกับสถาปัตยกรรมแบบกระจายศูนย์ เนื่องจากอาศัยการใช้งานในวงกว้างและหลากหลายมากกว่าการซิงโครไนซ์พารามิเตอร์ความถี่สูง เมื่อรวมกับเฟรมเวิร์กการตรวจสอบความถูกต้องของ PoL และ Verde แล้ว Gensyn จึงเป็นทางเลือกใหม่สำหรับการฝึกฝนโมเดลที่มีพารามิเตอร์นับล้านล้านตัว ซึ่งไม่จำเป็นต้องพึ่งพาบริษัทยักษ์ใหญ่ด้านเทคโนโลยีเพียงแห่งเดียวอีกต่อไป นั่นคือเครือข่ายอัจฉริยะขั้นสูงที่พัฒนาตนเองได้ ซึ่งประกอบด้วย GPU ที่หลากหลายนับล้านตัวทั่วโลก
Nous Research: Atropos สภาพแวดล้อมการเรียนรู้แบบเสริมแรงที่อิงตามการตรวจสอบความถูกต้อง
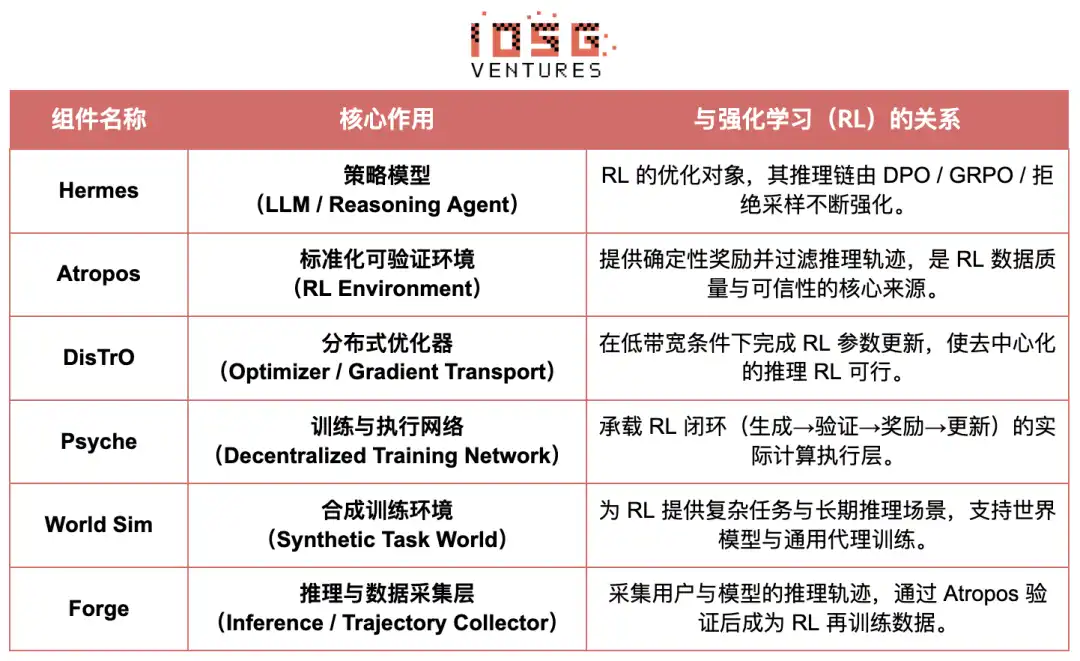
Nous Research กำลังสร้าง โครงสร้างพื้นฐานทางปัญญาแบบกระจายศูนย์และพัฒนาตนเองได้ ส่วนประกอบหลักของมัน ได้แก่ Hermes, Atropos, DisTrO, Psyche และ World Sim ถูกจัดเรียงเป็นระบบอัจฉริยะแบบวงปิดที่พัฒนาอย่างต่อเนื่อง แตกต่างจากกระบวนการเชิงเส้นแบบดั้งเดิมของ "การฝึกฝนก่อน - การฝึกฝนหลัง - การอนุมาน" Nous ใช้เทคนิคการเรียนรู้แบบเสริมแรง เช่น DPO, GRPO และการสุ่มตัวอย่างแบบปฏิเสธ เพื่อรวมการสร้างข้อมูล การตรวจสอบ การเรียนรู้ และการอนุมานเข้าไว้ในวงจรป้อนกลับอย่างต่อเนื่อง สร้างระบบนิเวศ AI แบบวงปิดที่พัฒนาตนเองอย่างต่อเนื่อง
ภาพรวมส่วนประกอบการวิจัยของ Nous
ชั้นโมเดล: เฮอร์มีสและการวิวัฒนาการของความสามารถในการให้เหตุผล
ซีรีส์ Hermes เป็นอินเทอร์เฟซโมเดลหลักที่ผู้ใช้ของ Nous Research นำเสนอ และวิวัฒนาการของมันแสดงให้เห็นอย่างชัดเจนถึงเส้นทางการเปลี่ยนแปลงของอุตสาหกรรมจากแนวทาง SFT/DPO แบบดั้งเดิมไปสู่การเรียนรู้แบบเสริมแรงเชิงเหตุผล (Reasoning Reinforcement Learning: RL):
• Hermes 1–3: การจัดเรียงคำสั่งและความสามารถในการใช้พร็อกซีในระยะเริ่มต้น: Hermes 1–3 อาศัย DPO ราคาประหยัดเพื่อให้ได้การจัดเรียงคำสั่งที่มีประสิทธิภาพ ในขณะที่ Hermes 3 ใช้ประโยชน์จากข้อมูลสังเคราะห์และกลไกการตรวจสอบ Atropos ที่เพิ่งนำมาใช้ใหม่
Hermes 4 / DeepHermes: มันผสานรวมการคิดอย่างช้าๆ สไตล์ System-2 เข้ากับน้ำหนักผ่านห่วงโซ่ความคิด ปรับปรุงประสิทธิภาพทางคณิตศาสตร์และโค้ดด้วยการปรับขนาดในระหว่างการทดสอบ และอาศัย "การสุ่มตัวอย่างแบบปฏิเสธ + การตรวจสอบ Atropos" เพื่อสร้างข้อมูลการอนุมานที่มีความบริสุทธิ์สูง
DeepHermes นำ GRPO มาใช้แทน PPO ซึ่งยากต่อการเผยแพร่และใช้งาน ทำให้การเรียนรู้แบบเสริมแรงเชิงอนุมาน (inference RL) สามารถทำงานบนเครือข่าย GPU แบบกระจายศูนย์ของ Psyche ได้ ซึ่งเป็นการวางรากฐานทางวิศวกรรมสำหรับความสามารถในการขยายขนาดของการเรียนรู้แบบเสริมแรงเชิงอนุมานแบบโอเพนซอร์ส
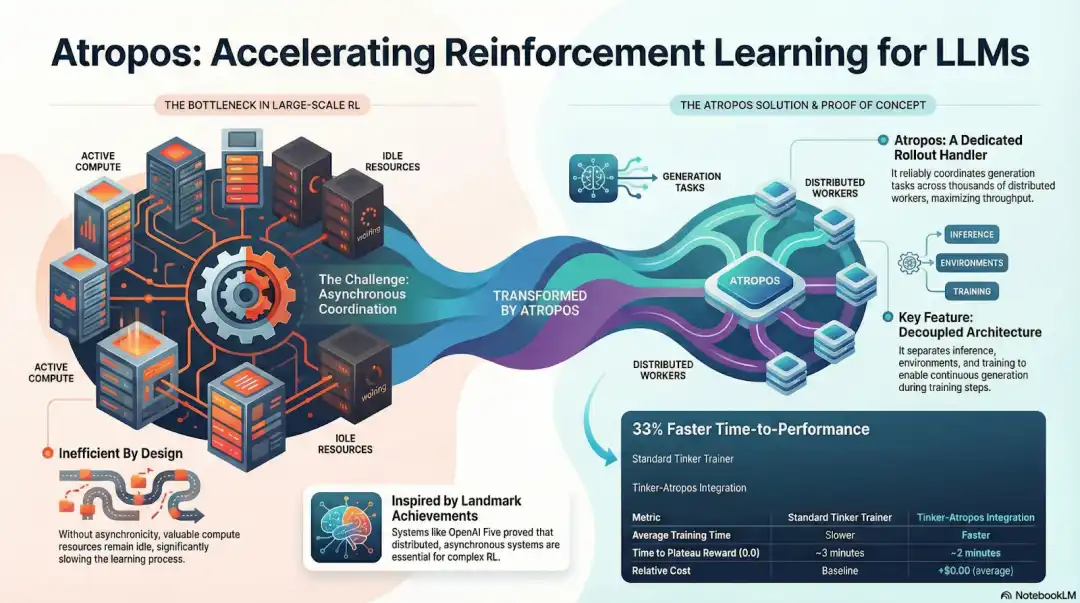
Atropos: สภาพแวดล้อมการเรียนรู้แบบเสริมแรงที่ขับเคลื่อนด้วยรางวัลที่ตรวจสอบได้
Atropos คือหัวใจสำคัญที่แท้จริงของระบบ Nous RL มันรวบรวมคำแนะนำ การเรียกใช้เครื่องมือ การประมวลผลโค้ด และการโต้ตอบแบบหลายรอบไว้ในสภาพแวดล้อม RL ที่ได้มาตรฐาน ตรวจสอบความถูกต้องของผลลัพธ์โดยตรง และให้สัญญาณรางวัลที่แน่นอน แทนที่การติดป้ายกำกับโดยมนุษย์ซึ่งมีค่าใช้จ่ายสูงและไม่สามารถขยายขนาดได้ ที่สำคัญกว่านั้น ในเครือข่ายการฝึกอบรมแบบกระจายศูนย์ Psyche Atropos ทำหน้าที่เป็น "ผู้ตัดสิน" ตรวจสอบว่าโหนดต่างๆ กำลังปรับปรุงนโยบายของตนอย่างแท้จริงหรือไม่ สนับสนุนการพิสูจน์การเรียนรู้ที่ตรวจสอบได้ และแก้ปัญหาความน่าเชื่อถือของรางวัลใน RL แบบกระจายศูนย์ได้อย่างแท้จริง
DisTrO และ Psyche: เลเยอร์ตัวปรับแต่งสำหรับการเรียนรู้แบบเสริมแรงแบบกระจายศูนย์
การฝึกอบรม RLF แบบดั้งเดิม (RLHF/RLAIF) อาศัยคลัสเตอร์แบบรวมศูนย์ที่มีแบนด์วิดท์สูง ซึ่งเป็นอุปสรรคสำคัญที่ระบบโอเพนซอร์สไม่สามารถจำลองได้ DisTrO ลดต้นทุนการสื่อสารของ RL ลงหลายเท่าตัวผ่านการแยกโมเมนตัมและการบีบอัดเกรเดียนต์ ทำให้การฝึกอบรมสามารถทำงานได้บนแบนด์วิดท์ของอินเทอร์เน็ต Psyche ใช้กลไกการฝึกอบรมนี้บนเครือข่ายแบบออนเชน ทำให้โหนดต่างๆ สามารถทำการอนุมาน ตรวจสอบ ประเมินรางวัล และอัปเดตน้ำหนักได้ในพื้นที่ ทำให้เกิดวงจรปิด RL ที่สมบูรณ์
ในสถาปัตยกรรม Nous นั้น Atropos ทำหน้าที่ตรวจสอบความถูกต้องของลำดับความคิด DisTrO ทำหน้าที่บีบอัดการสื่อสารในการฝึกอบรม Psyche ทำหน้าที่รันลูป RL WorldSim จัดเตรียมสภาพแวดล้อมที่ซับซ้อน Forge รวบรวมข้อมูลการอนุมานจริง และ Hermes ทำหน้าที่เขียนการเรียนรู้ทั้งหมดลงในน้ำหนัก การเรียนรู้แบบเสริมแรงไม่ใช่แค่ขั้นตอนการฝึกอบรม แต่เป็นโปรโตคอลหลักในสถาปัตยกรรม Nous ที่เชื่อมต่อข้อมูล สภาพแวดล้อม โมเดล และโครงสร้างพื้นฐาน ทำให้ Hermes เป็นระบบที่มีชีวิตที่สามารถพัฒนาตนเองได้อย่างต่อเนื่องบนเครือข่ายคอมพิวเตอร์แบบโอเพนซอร์ส
เครือข่ายแบบไล่ระดับ: Echo สถาปัตยกรรมการเรียนรู้แบบเสริมแรง
วิสัยทัศน์หลักของ Gradient Network คือการปรับเปลี่ยนกระบวนทัศน์การประมวลผล AI ผ่าน "Open Intelligence Stack" เทคโนโลยีของ Gradient ประกอบด้วยชุดโปรโตคอลหลักที่สามารถพัฒนาได้อย่างอิสระแต่ก็ทำงานร่วมกันได้อย่างหลากหลาย สถาปัตยกรรมของมัน ตั้งแต่การสื่อสารพื้นฐานไปจนถึงการทำงานร่วมกันอย่างชาญฉลาดในระดับบน ประกอบด้วย: Parallax (การอนุมานแบบกระจาย), Echo (การฝึกอบรม RL แบบกระจายศูนย์), Lattica (เครือข่าย P2P), SEDM / Massgen / Symphony / CUAHarm (หน่วยความจำ การทำงานร่วมกัน และความปลอดภัย), VeriLLM (การตรวจสอบที่เชื่อถือได้) และ Mirage (การจำลองความแม่นยำสูง) ซึ่งรวมกันเป็นโครงสร้างพื้นฐานอัจฉริยะแบบกระจายศูนย์ที่พัฒนาอย่างต่อเนื่อง
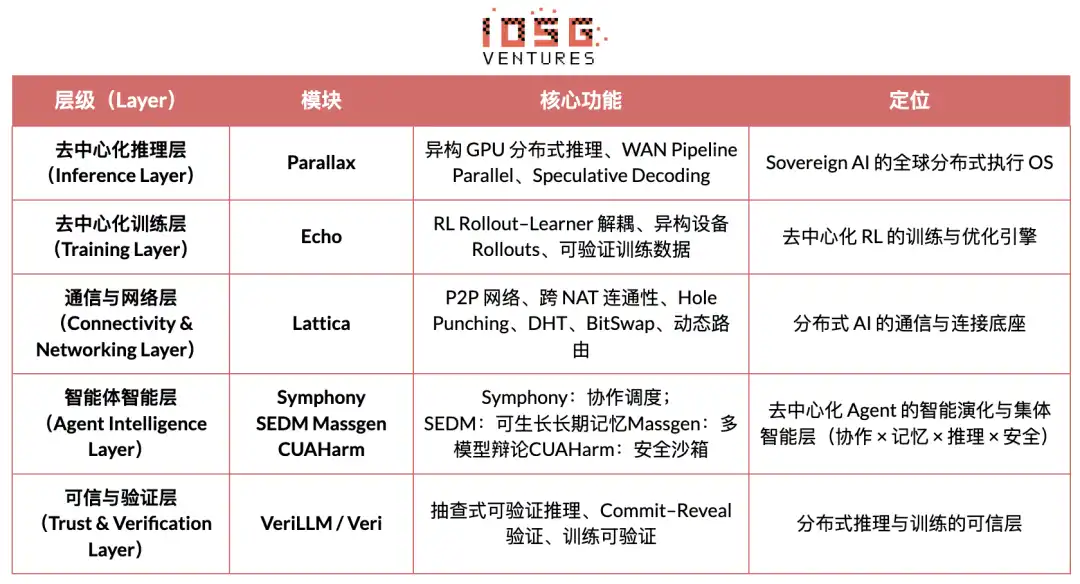
Echo—สถาปัตยกรรมฝึกอบรมการเรียนรู้แบบเสริมแรง
Echo คือเฟรมเวิร์กการเรียนรู้แบบเสริมแรงของ Gradient ปรัชญาการออกแบบหลักคือการแยกส่วนการฝึก การอนุมาน และข้อมูล (รางวัล) ในการเรียนรู้แบบเสริมแรง ทำให้การสร้าง Rollout การเพิ่มประสิทธิภาพนโยบาย และการประเมินรางวัลสามารถปรับขนาดและกำหนดเวลาได้อย่างอิสระในสภาพแวดล้อมที่หลากหลาย มันทำงานร่วมกันในเครือข่ายที่หลากหลายซึ่งประกอบด้วยโหนดการอนุมานและการฝึก รักษาเสถียรภาพการฝึกในสภาพแวดล้อมที่หลากหลายในพื้นที่กว้างด้วยกลไกการซิงโครไนซ์ที่มีน้ำหนักเบา ซึ่งช่วยลดความล้มเหลวของ SPMD และปัญหาคอขวดในการใช้งาน GPU ที่เกิดจากการอนุมานและการฝึกแบบผสมผสานใน DeepSpeed RLHF/VERL แบบดั้งเดิมได้อย่างมีประสิทธิภาพ
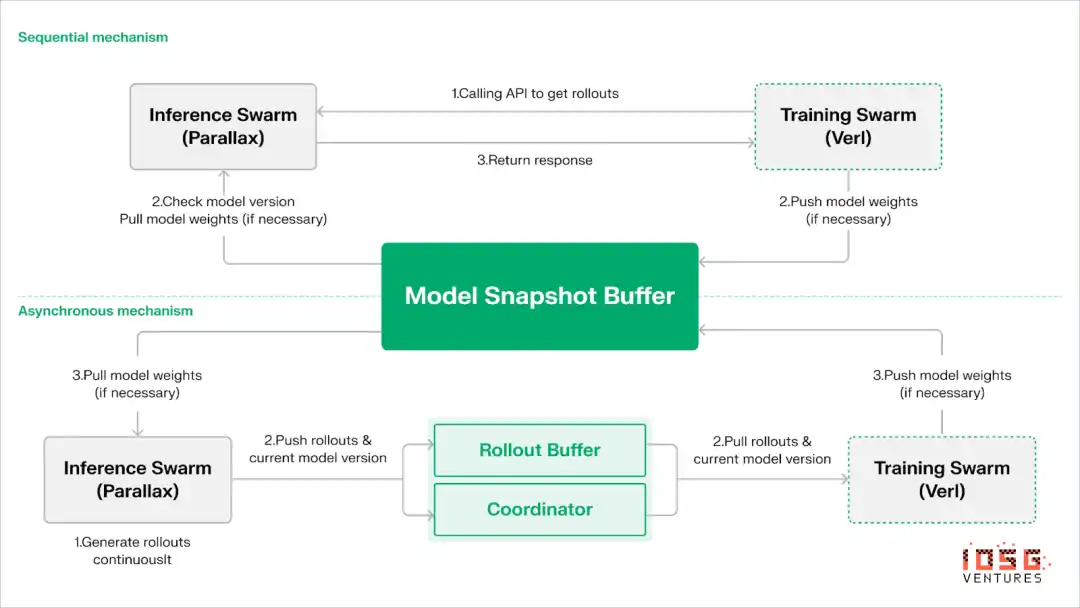
Echo ใช้สถาปัตยกรรมแบบสองกลุ่มสำหรับการประมวลผลและการฝึกอบรมเพื่อเพิ่มประสิทธิภาพการใช้พลังงานในการคำนวณให้สูงสุด กลุ่มทั้งสองทำงานอย่างอิสระและไม่ขัดขวางซึ่งกันและกัน
• เพิ่มประสิทธิภาพการประมวลผลการสุ่มตัวอย่างให้สูงสุด: Inference Swarm ประกอบด้วย GPU ระดับผู้บริโภคและอุปกรณ์ Edge และใช้ Parallax เพื่อสร้างตัวสุ่มตัวอย่างที่มีประสิทธิภาพสูงในลักษณะขนานแบบไปป์ไลน์ โดยเน้นที่การสร้างวิถีการเคลื่อนที่
• เพิ่มประสิทธิภาพการคำนวณเกรเดียนต์ให้สูงสุด: Training Swarm ประกอบด้วยเครือข่าย GPU ระดับผู้บริโภคที่สามารถทำงานบนคลัสเตอร์ส่วนกลางหรือในหลายตำแหน่งทั่วโลก ทำหน้าที่อัปเดตเกรเดียนต์ การซิงโครไนซ์พารามิเตอร์ และการปรับแต่ง LoRA โดยมุ่งเน้นที่กระบวนการเรียนรู้
เพื่อให้เกิดความสอดคล้องระหว่างนโยบายและข้อมูล Echo จึงมีโปรโตคอลการซิงโครไนซ์แบบเบา 2 แบบ ได้แก่ แบบลำดับและแบบอะซิงโครนัส ซึ่งช่วยให้สามารถจัดการความสอดคล้องแบบสองทิศทางของน้ำหนักนโยบายและวิถีการเคลื่อนที่ได้
• โหมดดึงข้อมูลตามลำดับ | เน้นความแม่นยำ : ฝั่งการฝึกอบรมจะบังคับให้โหนดการอนุมานอัปเดตเวอร์ชันโมเดลก่อนที่จะดึงข้อมูลวิถีใหม่ เพื่อให้มั่นใจได้ว่าข้อมูลวิถีมีความทันสมัย เหมาะสำหรับงานที่ไวต่อข้อมูลนโยบายที่ล้าสมัย
• โหมดพุช-พูลแบบอะซิงโครนัส | เน้นประสิทธิภาพเป็นอันดับแรก : ฝั่งการอนุมานจะสร้างวิถีการเคลื่อนที่พร้อมป้ายกำกับเวอร์ชันอย่างต่อเนื่อง ฝั่งการฝึกฝนจะนำไปใช้ตามจังหวะของตนเอง และตัวประสานงานจะตรวจสอบความเบี่ยงเบนของเวอร์ชันและกระตุ้นการรีเฟรชค่าถ่วงน้ำหนักเพื่อเพิ่มการใช้งานอุปกรณ์ให้สูงสุด
โดยพื้นฐานแล้ว Echo สร้างขึ้นบน Parallax (การอนุมานแบบไม่เป็นเนื้อเดียวกันในสภาพแวดล้อมที่มีแบนด์วิดท์ต่ำ) และส่วนประกอบการฝึกอบรมแบบกระจายที่มีน้ำหนักเบา (เช่น VERL) โดยอาศัย LoRA เพื่อลดต้นทุนของการซิงโครไนซ์ข้ามโหนด ทำให้การเรียนรู้แบบเสริมแรงสามารถทำงานได้อย่างเสถียรบนเครือข่ายที่ไม่เป็นเนื้อเดียวกันทั่วโลก
เป้าหมายสูงสุด: การเรียนรู้แบบเสริมแรงในระบบนิเวศของ Bittensor
Bittensor สร้างเครือข่ายฟังก์ชันรางวัลขนาดใหญ่ กระจัดกระจาย และไม่คงที่ ผ่านกลไกฉันทามติ Yuma ที่เป็นเอกลักษณ์เฉพาะตัว
Covenant AI ภายในระบบนิเวศของ Bittensor ได้สร้างไปป์ไลน์แบบบูรณาการในแนวดิ่ง ตั้งแต่การฝึกฝนเบื้องต้นไปจนถึงการฝึกฝนแบบเสริมแรงภายหลัง โดยใช้ SN3 Templar, SN39 Basilica และ SN81 Grail SN3 Templar ทำหน้าที่ฝึกฝนโมเดลพื้นฐานเบื้องต้น SN39 Basilica ให้บริการตลาดการประมวลผลแบบกระจาย และ SN81 Grail ทำหน้าที่เป็น "เลเยอร์การอนุมานที่ตรวจสอบได้" สำหรับการฝึกฝนแบบเสริมแรงภายหลัง โดยดำเนินการกระบวนการหลักของ RLHF/RLAIF และทำการเพิ่มประสิทธิภาพแบบวงปิดตั้งแต่โมเดลพื้นฐานไปจนถึงกลยุทธ์การจัดเรียง
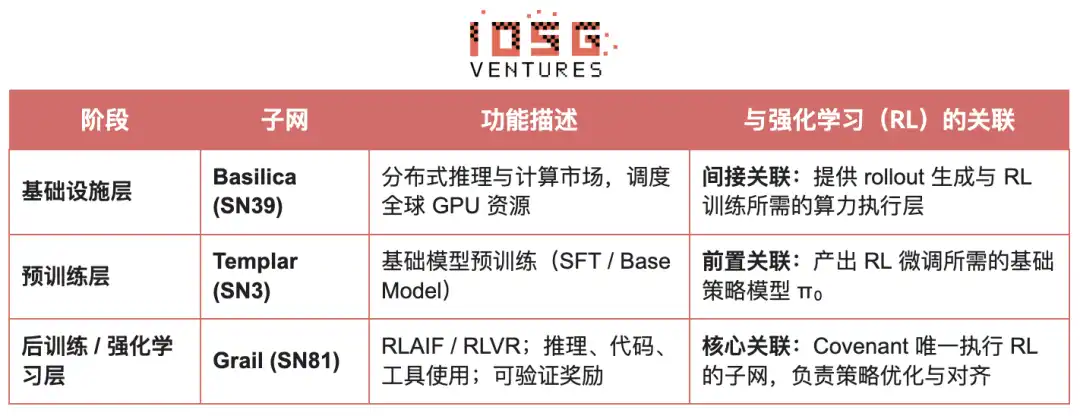
GRAIL มีเป้าหมาย ที่จะพิสูจน์ความถูกต้องของการดำเนินการเรียนรู้แบบเสริมแรงแต่ละครั้งและการเชื่อมโยงกับตัวตนของโมเดล ด้วยวิธีการเข้ารหัสลับ เพื่อให้มั่นใจว่า RLHF สามารถดำเนินการได้อย่างปลอดภัยในสภาพแวดล้อมที่ไม่ต้องอาศัยความไว้วางใจ โปรโตคอลนี้สร้างห่วงโซ่ความไว้วางใจผ่านกลไกสามชั้น:
1. การสร้างโจทย์ท้าทายแบบกำหนดได้ : ใช้บีคอนแบบสุ่ม drand และแฮชบล็อกเพื่อสร้างโจทย์ท้าทายที่ไม่สามารถคาดเดาได้แต่สามารถทำซ้ำได้ (เช่น SAT และ GSM8K) ซึ่งช่วยขจัดปัญหาการโกงโดยการคำนวณล่วงหน้า
2. ด้วยการสุ่มตัวอย่างดัชนี PRF และการร่างข้อผูกพัน ผู้ตรวจสอบความถูกต้องสามารถสุ่มตัวอย่าง logprob ระดับโทเค็นและห่วงโซ่การอนุมานได้ในต้นทุนที่ต่ำมาก เพื่อยืนยันว่าการเผยแพร่เกิดขึ้นจากแบบจำลองการประกาศจริง
3. การผูกโยงเอกลักษณ์ของโมเดล : กระบวนการอนุมานจะถูกผูกโยงเข้ากับลายเซ็นที่มีโครงสร้างของลายนิ้วมือของน้ำหนักโมเดลและการกระจายโทเค็น เพื่อให้มั่นใจได้ว่าการแทนที่โมเดลหรือการเล่นซ้ำผลลัพธ์จะได้รับการยอมรับในทันที ซึ่งเป็นรากฐานของความถูกต้องแม่นยำสำหรับการใช้งานอนุมานใน RL
จากกลไกนี้ ซับเน็ต Grail ใช้กระบวนการหลังการฝึกอบรมที่ตรวจสอบได้แบบ GRPO: ผู้ขุดสร้างเส้นทางการอนุมานหลายเส้นทางสำหรับปัญหาเดียวกัน ผู้ตรวจสอบให้คะแนนตามความถูกต้อง คุณภาพของห่วงโซ่การอนุมาน และความพึงพอใจของ SAT และเขียนผลลัพธ์ที่ได้มาตรฐานลงบนบล็อกเชนเป็นน้ำหนัก TAO การทดลองสาธารณะแสดงให้เห็นว่าเฟรมเวิร์กนี้ได้ปรับปรุงความแม่นยำของ MATH ของ Qwen2.5-1.5B จาก 12.7% เป็น 47.6% ซึ่งพิสูจน์ได้ว่าสามารถป้องกันการโกงและเพิ่มขีดความสามารถของโมเดลได้อย่างมีนัยสำคัญ ในสแต็กการฝึกอบรมของ Covenant AI นั้น Grail เป็นรากฐานสำคัญของความไว้วางใจและการดำเนินการของ RLVR/RLAIF แบบกระจายอำนาจ และยังไม่ได้เปิดตัวอย่างเป็นทางการบนเมนเน็ต
Fraction AI: การเรียนรู้แบบเสริมแรงโดยอิงจากการแข่งขัน (RLFC)
สถาปัตยกรรมของ Fraction AI สร้างขึ้นโดยเน้น การเรียนรู้แบบเสริมแรงจากการแข่งขัน (Reinforcement Learning from Competition: RLFC) และการติดป้ายกำกับข้อมูลแบบเกม โดยแทนที่รางวัลแบบคงที่และการติดป้ายกำกับด้วยตนเองของ RLFC แบบดั้งเดิมด้วยสภาพแวดล้อมการแข่งขันแบบเปิดและไดนามิก เอเจนต์จะแข่งขันกันในพื้นที่ต่างๆ และอันดับสัมพัทธ์ของพวกเขารวมถึงคะแนนจากผู้ตัดสิน AI จะกลายเป็นรางวัลแบบเรียลไทม์ เปลี่ยนกระบวนการจัดเรียงให้กลายเป็นระบบเกมหลายเอเจนต์แบบออนไลน์อย่างต่อเนื่อง
ความแตกต่างหลักระหว่าง RLHF แบบดั้งเดิมและ RLFC ของ Fraction AI มีดังนี้:
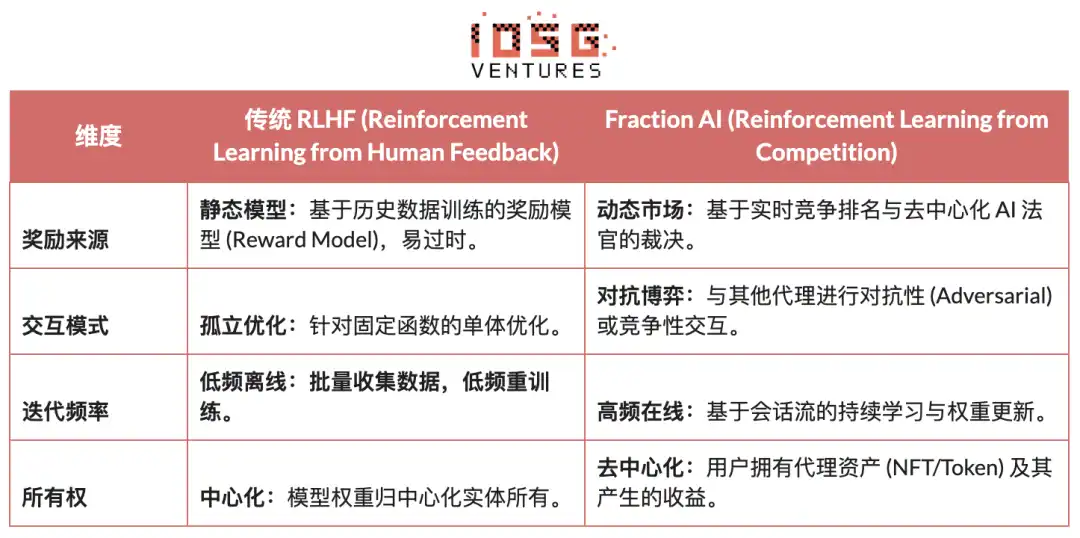
คุณค่าหลักของ RLFC อยู่ที่ข้อเท็จจริงที่ว่ารางวัลไม่ได้มาจากแบบจำลองเดียวอีกต่อไป แต่มาจากคู่ต่อสู้และผู้ประเมินที่พัฒนาอย่างต่อเนื่อง ซึ่งป้องกันไม่ให้แบบจำลองรางวัลถูกเอาเปรียบ และป้องกันไม่ให้ระบบนิเวศติดอยู่ในจุดเหมาะสมที่สุดเฉพาะที่ (local optima) ผ่านความหลากหลายของกลยุทธ์ โครงสร้างของ Spaces กำหนดลักษณะของเกม (ผลรวมเป็นศูนย์หรือผลรวมเป็นบวก) ซึ่งผลักดันให้เกิดพฤติกรรมที่ซับซ้อนในการโต้ตอบแบบเป็นปรปักษ์และแบบร่วมมือ
ในแง่ของสถาปัตยกรรมระบบ Friction AI แบ่งกระบวนการฝึกอบรมออกเป็นสี่ส่วนหลัก:
• เอเจนต์: หน่วยนโยบายน้ำหนักเบาที่ใช้ LLM แบบโอเพนซอร์ส ขยายเพิ่มเติมด้วยน้ำหนักที่แตกต่างกันผ่าน QLoRA และอัปเดตได้ในราคาประหยัด
• พื้นที่: สภาพแวดล้อมภารกิจเฉพาะที่ซึ่งตัวแทนต้องจ่ายเงินเพื่อเข้าไปและจะได้รับรางวัลตามผลการชนะและแพ้
ระบบตัดสิน AI: ชั้นการให้รางวัลทันทีที่สร้างด้วย RLAIF ซึ่งให้การประเมินผลแบบกระจายศูนย์และปรับขนาดได้
• การพิสูจน์การเรียนรู้: เชื่อมโยงการอัปเดตนโยบายกับผลการแข่งขันที่เฉพาะเจาะจง เพื่อให้มั่นใจว่ากระบวนการฝึกอบรมสามารถตรวจสอบได้และป้องกันการโกง
หัวใจสำคัญของ Fraction AI คือการสร้างกลไกวิวัฒนาการที่ทำงานร่วมกันระหว่างมนุษย์และเครื่องจักร ผู้ใช้ทำหน้าที่เป็น "ผู้ปรับแต่งขั้นสูง" ในระดับนโยบาย ชี้นำทิศทางการสำรวจผ่านการออกแบบอย่างรวดเร็วและการกำหนดค่าพารามิเตอร์ขั้นสูง ในขณะที่เอเจนต์สร้างคู่ความชอบคุณภาพสูงจำนวนมหาศาลโดยอัตโนมัติในการแข่งขันระดับจุลภาค โมเดลนี้ช่วยให้การติดป้ายกำกับข้อมูลบรรลุถึงวงจรปิดทางธุรกิจผ่าน "การปรับแต่ง อย่างละเอียดโดยไม่ต้องอาศัยความไว้วางใจ "
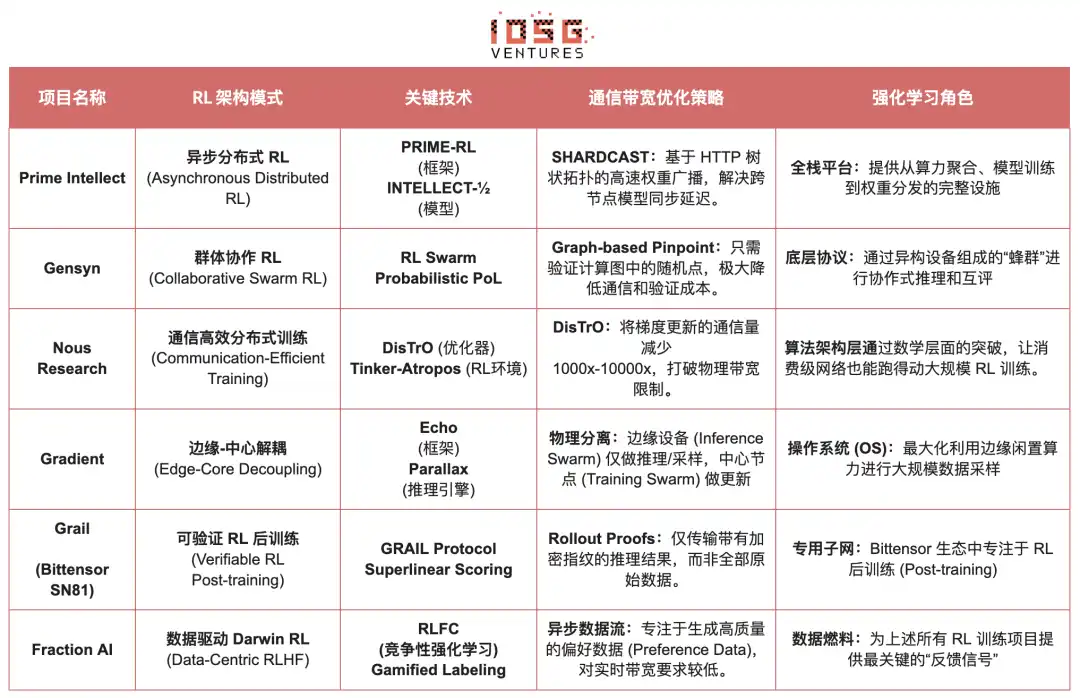
การเปรียบเทียบสถาปัตยกรรมโครงการ Web3 ที่ใช้การเรียนรู้แบบเสริมแรง
สรุปและแนวโน้ม: แนวทางและโอกาสสำหรับการเรียนรู้แบบเสริมแรง × Web3
จากการวิเคราะห์เชิงลึกของโครงการล้ำสมัยที่กล่าวมาข้างต้น เราพบว่า แม้จุดเริ่มต้น (อัลกอริทึม วิศวกรรม หรือตลาด) ของแต่ละทีมจะแตกต่างกัน แต่เมื่อนำการเรียนรู้แบบเสริมแรง (Reinforcement Learning: RL) มาผสานรวมกับ Web3 ตรรกะทางสถาปัตยกรรมพื้นฐานจะมาบรรจบกันในรูปแบบ "การแยกส่วน-การตรวจสอบ-แรงจูงใจ" ที่สอดคล้องกันอย่างมาก นี่ไม่ใช่เพียงแค่ความบังเอิญทางเทคนิค แต่เป็นผลลัพธ์ที่หลีกเลี่ยงไม่ได้ของเครือข่ายแบบกระจายศูนย์ที่ปรับตัวให้เข้ากับคุณสมบัติเฉพาะของการเรียนรู้แบบเสริมแรง
ลักษณะทางสถาปัตยกรรมทั่วไปของการเรียนรู้แบบเสริมแรง: การจัดการกับข้อจำกัดทางกายภาพหลักและประเด็นเรื่องความไว้วางใจ
1. การแยกส่วนการใช้งานและการเรียนรู้ – โครงสร้างการคำนวณเริ่มต้น
การประมวลผลแบบขนานที่กระจายตัวและยืดหยุ่นได้นั้นถูกส่งต่อไปยัง GPU ระดับผู้บริโภคทั่วโลก และการอัปเดตพารามิเตอร์ที่มีแบนด์วิดท์สูงจะกระจุกตัวอยู่บนโหนดการฝึกอบรมจำนวนน้อย ดังที่เห็นได้ใน Actor-Learner แบบอะซิงโครนัสของ Prime Intellect และสถาปัตยกรรมแบบคลัสเตอร์คู่ของ Gradient Echo
2. การพัฒนาโครงสร้างพื้นฐานเพื่อสร้างความไว้วางใจโดยอาศัยการตรวจสอบยืนยัน
ในเครือข่ายที่ไม่ต้องขออนุญาต ความถูกต้องเชิงคำนวณจะต้องได้รับการบังคับใช้ผ่านการออกแบบทางคณิตศาสตร์และกลไก ซึ่งแสดงถึงวิธีการตรวจสอบทางคริปโตกราฟี เช่น PoL ของ Gensyn, TOPLOC ของ Prime Intellect และ Grail
3. วงจรแรงจูงใจแบบโทเค็น – การกำกับดูแลตนเองของตลาด
ระบบการจ่ายพลังประมวลผล การสร้างข้อมูล การตรวจสอบและจัดอันดับ และการแจกจ่ายรางวัล ล้วนประกอบกันเป็นวงจรปิด การกระตุ้นการมีส่วนร่วมผ่านรางวัลและการปราบปรามการโกงผ่านการลงโทษ จะช่วยให้เครือข่ายมีความเสถียรและพัฒนาต่อไปได้ในสภาพแวดล้อมแบบเปิด
เส้นทางเทคโนโลยีที่แตกต่างกัน: "จุดเปลี่ยนสำคัญ" ที่แตกต่างกันภายใต้สถาปัตยกรรมที่สอดคล้องกัน
แม้ว่าสถาปัตยกรรมจะมีความคล้ายคลึงกัน แต่แต่ละโครงการได้เลือกใช้เทคโนโลยีที่แตกต่างกันไปตามลักษณะเฉพาะของตนเอง:
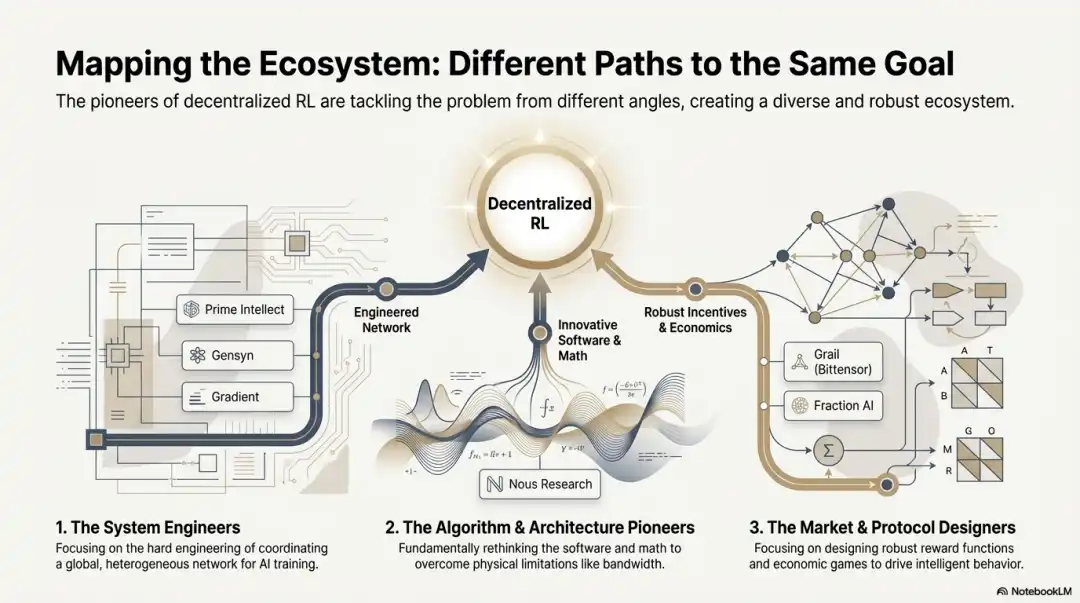
• Nous Research: กลุ่มนี้พยายามแก้ปัญหาความขัดแย้งพื้นฐาน (ปัญหาคอขวดด้านแบนด์วิดท์) ของการฝึกอบรมแบบกระจายจากมุมมองทางคณิตศาสตร์ ตัวเพิ่มประสิทธิภาพ DisTrO ของพวกเขาตั้งเป้าที่จะบีบอัดการสื่อสารของเกรเดียนต์ลงหลายพันเท่า โดยมีเป้าหมายเพื่อให้การฝึกอบรมโมเดลขนาดใหญ่สามารถทำงานได้แม้บนบรอดแบนด์ที่บ้าน ซึ่งเป็นการ "โจมตีด้วยการลดมิติ" เพื่อเอาชนะข้อจำกัดทางกายภาพ
• แนวทางการออกแบบระบบ (Prime Intellect, Gensyn, Gradient): มุ่งเน้นการสร้าง "ระบบรันไทม์ AI" รุ่นใหม่ ShardCast ของ Prime Intellect และ Parallax ของ Gradient ได้รับการออกแบบมาเพื่อเพิ่มประสิทธิภาพคลัสเตอร์แบบเฮเทอโรจีนัสให้สูงสุดภายใต้เงื่อนไขเครือข่ายที่มีอยู่ โดยใช้เทคนิคทางวิศวกรรมขั้นสูง
• แนวทางทฤษฎีเกมตลาด (Bittensor, Fraction AI): เน้นที่การออกแบบฟังก์ชันรางวัล โดยการออกแบบกลไกการให้คะแนนที่ซับซ้อน เพื่อชี้นำให้นักขุดค้นหากลยุทธ์ที่เหมาะสมที่สุดได้เองโดยธรรมชาติ ซึ่งจะช่วยเร่งการพัฒนาปัญญาประดิษฐ์
จุดแข็ง ความท้าทาย และแนวโน้มในระยะสุดท้าย
ในรูปแบบของการผสมผสานการเรียนรู้แบบเสริมแรงเข้ากับ Web3 ข้อดีในระดับระบบจะสะท้อนให้เห็นเป็นอันดับแรกในการปรับ โครงสร้างต้นทุนและการกำกับดูแล
• การปรับเปลี่ยนรูปแบบต้นทุน : หลังการฝึกอบรมใน RL มีความต้องการการสุ่มตัวอย่าง (Rollout) อย่างไม่จำกัด ในขณะที่ Web3 สามารถระดมพลังการประมวลผลแบบ long-tail ทั่วโลกได้ในต้นทุนที่ต่ำมาก ซึ่งเป็นข้อได้เปรียบด้านต้นทุนที่ผู้ให้บริการคลาวด์แบบรวมศูนย์ไม่สามารถเทียบได้
• การจัดวางแนวทาง ที่เป็นอิสระ: การทำลายการผูกขาดของบริษัทขนาดใหญ่ในด้านคุณค่าของ AI (การจัดวางแนวทาง) ทำให้ชุมชนสามารถลงคะแนนด้วยโทเค็นเพื่อตัดสินใจว่า "อะไรคือคำตอบที่ดี" สำหรับโมเดล ซึ่งเป็นการทำให้การกำกับดูแล AI เป็นประชาธิปไตยมากขึ้น
ในขณะเดียวกัน ระบบนี้ก็เผชิญกับข้อจำกัดเชิงโครงสร้างที่สำคัญสองประการด้วยเช่นกัน
• ข้อจำกัดด้านแบนด์วิดท์ : แม้จะมีนวัตกรรมต่างๆ เช่น DisTrO แต่ความหน่วงทางกายภาพยังคงจำกัดการฝึกฝนโมเดลที่มีพารามิเตอร์ขนาดใหญ่มาก (70 พันล้านขึ้นไป) อย่างเต็มรูปแบบ และปัจจุบัน Web3 AI ยังมีข้อจำกัดอยู่ที่การปรับแต่งและการอนุมานเท่านั้น
กฎของกู๊ดฮาร์ด (การโกงรางวัล) : ในเครือข่ายที่มีแรงจูงใจสูง นักขุดมักจะ "ปรับแต่งมากเกินไป" จนเข้ากับกฎของรางวัล (การฟาร์มคะแนน) แทนที่จะพัฒนาสติปัญญาที่แท้จริง การออกแบบฟังก์ชันรางวัลที่แข็งแกร่งเพื่อป้องกันการโกงจึงเป็นเกมที่ไม่มีวันจบสิ้น
• การโจมตีโดยใช้แรงงานไบแซนไทน์ที่เป็นอันตราย : การโจมตีเหล่านี้ขัดขวางการบรรจบกันของแบบจำลองโดยการจัดการและทำลายสัญญาณการฝึกอบรมอย่างจงใจ กลยุทธ์หลักไม่ใช่การออกแบบฟังก์ชันรางวัลป้องกันการโกงอย่างต่อเนื่อง แต่เป็นการสร้างกลไกที่ทนทานต่อการโจมตีจากฝ่ายตรงข้าม
การผสานรวมระหว่างการเรียนรู้แบบเสริมแรงและ Web3 นั้นเป็นการเขียนกลไกใหม่ของ "วิธีการสร้าง จัดเรียง และกระจายคุณค่าของปัญญา" อย่างแท้จริง วิวัฒนาการของมันสามารถสรุปได้ในสามทิศทางที่เสริมซึ่งกันและกัน:
1. เครือข่ายการฝึกอบรมแบบกระจายศูนย์ : ตั้งแต่พลังการประมวลผลของเครื่องขุดไปจนถึงเครือข่ายนโยบาย การเอาท์ซอร์สการใช้งานแบบขนานและตรวจสอบได้ไปยัง GPU ขนาดใหญ่ทั่วโลก โดยมุ่งเน้นที่ตลาดการอนุมานที่ตรวจสอบได้ในระยะสั้น และพัฒนาไปสู่เครือข่ายย่อยการเรียนรู้แบบเสริมแรงสำหรับการจัดกลุ่มงานในระยะกลาง
2. การแปลงความชอบและรางวัลให้เป็นสินทรัพย์ : จากแรงงานการติดป้ายกำกับสู่ความเท่าเทียมทางข้อมูล การแปลงความชอบและรางวัลให้เป็นสินทรัพย์จะเปลี่ยนผลตอบรับคุณภาพสูงและแบบจำลองรางวัลให้เป็นสินทรัพย์ข้อมูลที่สามารถควบคุมและเผยแพร่ได้ ยกระดับ "แรงงานการติดป้ายกำกับ" ไปสู่ "ความเท่าเทียมทางข้อมูล"
3. วิวัฒนาการ "เล็กแต่สวยงาม" ในสาขาเฉพาะทาง : ในสถานการณ์เฉพาะทางที่สามารถตรวจสอบผลลัพธ์และวัดผลประโยชน์ได้ มีการพัฒนาเอเจนต์ RL เฉพาะทางขนาดเล็กแต่ทรงพลัง เช่น การดำเนินการกลยุทธ์ DeFi และการสร้างโค้ด ซึ่งเชื่อมโยงการปรับปรุงกลยุทธ์กับการสร้างมูลค่าโดยตรง และคาดว่าจะทำงานได้ดีกว่าโมเดลแบบปิดแหล่งที่มาทั่วไป
โดยรวมแล้ว โอกาสที่แท้จริงสำหรับการเรียนรู้แบบเสริมแรง × Web3 ไม่ได้อยู่ที่การจำลองเวอร์ชันแบบกระจายศูนย์ของ OpenAI แต่เป็นการเขียน "ความสัมพันธ์ในการผลิตอัจฉริยะ" ใหม่: ทำให้การดำเนินการฝึกอบรมเป็นตลาดพลังการประมวลผลแบบเปิด ทำให้รางวัลและความชอบเป็นสินทรัพย์บนบล็อกเชนที่สามารถควบคุมได้ และ กระจายมูลค่าที่เกิดจากความฉลาดไม่กระจุกตัวอยู่บนแพลตฟอร์มอีกต่อไป แต่กระจายไปในหมู่ผู้ฝึกสอน ผู้จัดเรียง และผู้ใช้
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง