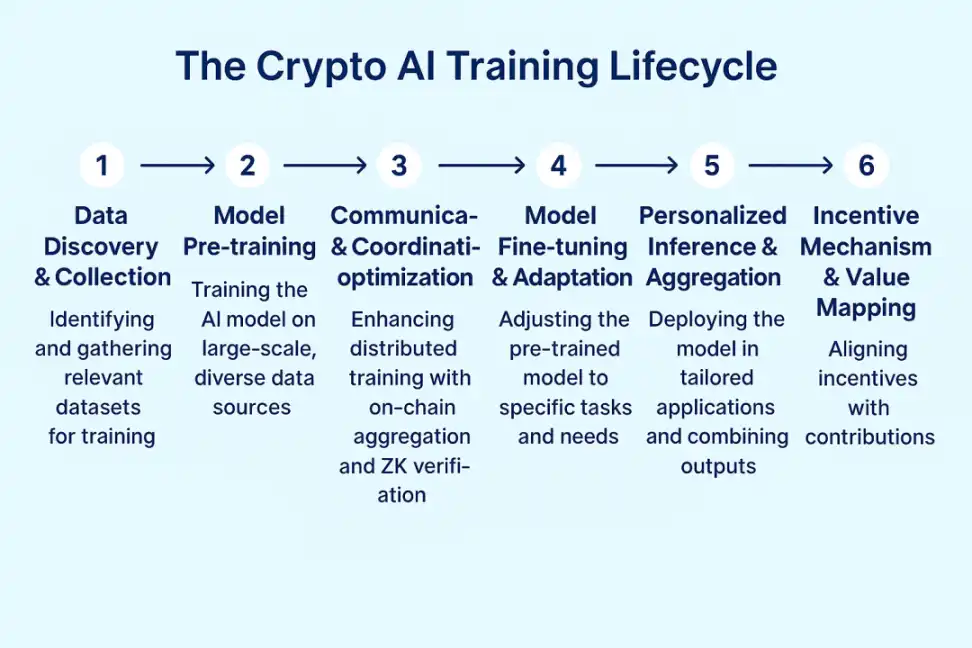
IOSG: จอกศักดิ์สิทธิ์แห่ง Crypto AI การสำรวจแนวหน้าของการฝึกอบรมแบบกระจายอำนาจ

ชื่อเรื่องต้นฉบับ: "IOSG Weekly Brief|The Holy Grail of Crypto AI: Frontier Exploration of Decentralized Training #280"
ผู้เขียนต้นฉบับ: Jacob Zhao (X @0xjacobzhao), IOSG Ventures
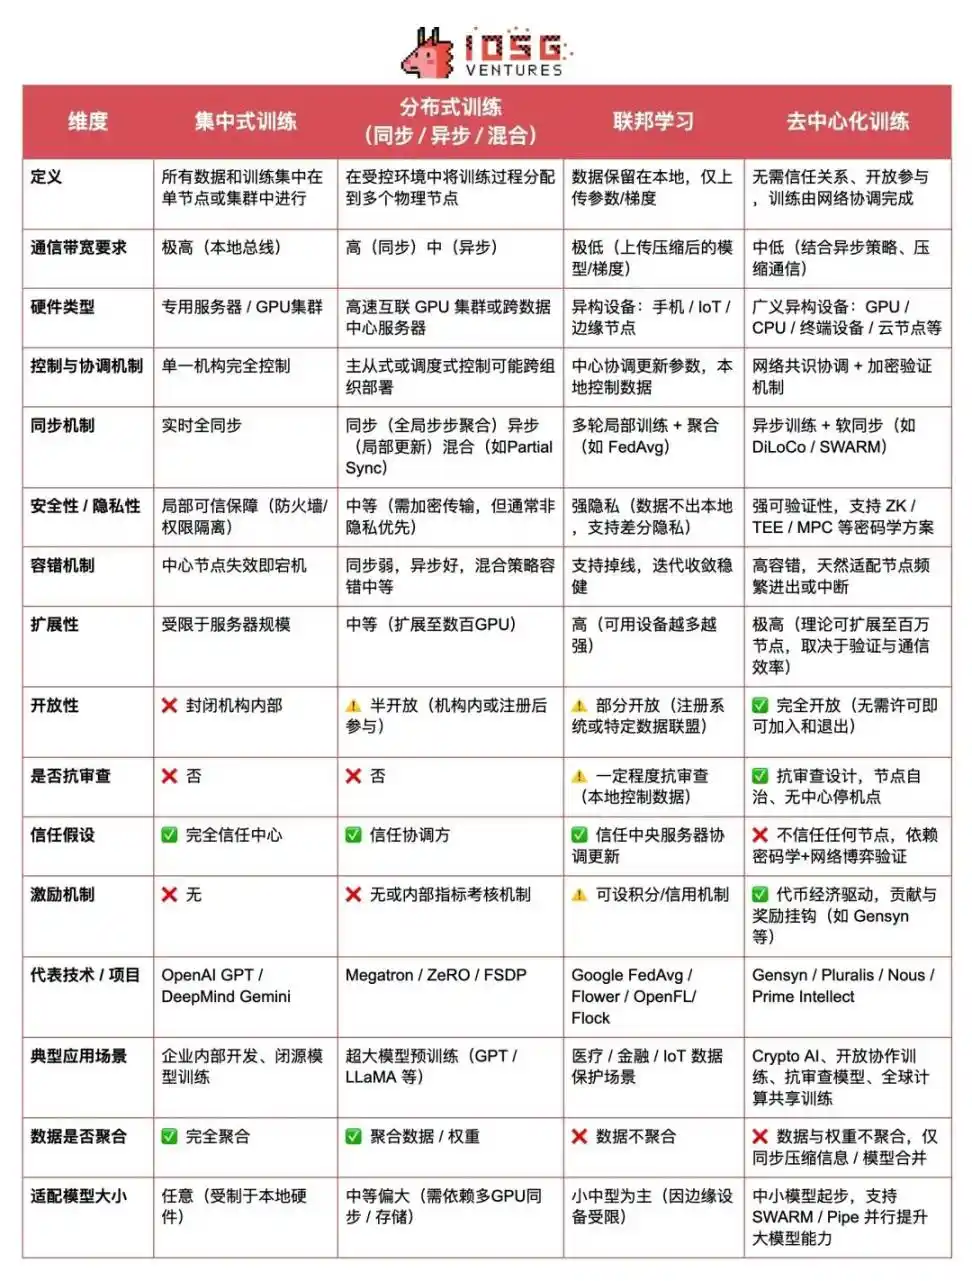
ในห่วงโซ่คุณค่าทั้งหมดของ AI การฝึกโมเดลเป็นลิงก์ที่เชื่อมโยงกับการใช้ทรัพยากรและเกณฑ์ทางเทคนิคสูงสุด ซึ่งกำหนดขีดจำกัดบนของความสามารถของโมเดลและเอฟเฟกต์การใช้งานจริงโดยตรง เมื่อเปรียบเทียบกับการเรียกใช้แบบเบาในขั้นตอนการอนุมาน กระบวนการฝึกต้องใช้การลงทุนด้านพลังการประมวลผลขนาดใหญ่อย่างต่อเนื่อง กระบวนการประมวลผลข้อมูลที่ซับซ้อน และการสนับสนุนอัลกอริทึมการเพิ่มประสิทธิภาพที่มีความเข้มข้นสูง ซึ่งเป็น "อุตสาหกรรมหนัก" ที่แท้จริงสำหรับการสร้างระบบ AI จากมุมมองของรูปแบบสถาปัตยกรรม วิธีฝึกสามารถแบ่งออกได้เป็นสี่ประเภท ได้แก่ การฝึกแบบรวมศูนย์ การฝึกแบบกระจาย การเรียนรู้แบบรวมศูนย์ และการฝึกแบบกระจายศูนย์ ซึ่งเป็นประเด็นสำคัญของบทความนี้
การฝึกอบรมแบบรวมศูนย์เป็นวิธีการแบบดั้งเดิมที่ใช้กันมากที่สุด โดยองค์กรเดียวจะดำเนินการฝึกอบรมทั้งหมดในคลัสเตอร์ประสิทธิภาพสูงในพื้นที่ ส่วนประกอบทั้งหมด ตั้งแต่ฮาร์ดแวร์ (เช่น NVIDIA GPU) ซอฟต์แวร์พื้นฐาน (CUDA, cuDNN) ระบบกำหนดตารางคลัสเตอร์ (เช่น Kubernetes) ไปจนถึงกรอบการทำงานฝึกอบรม (เช่น PyTorch ที่ใช้แบ็กเอนด์ NCCL) จะได้รับการประสานงานและดำเนินการโดยระบบควบคุมแบบรวม สถาปัตยกรรมที่ทำงานร่วมกันอย่างลึกซึ้งนี้ช่วยเพิ่มประสิทธิภาพในการแบ่งปันหน่วยความจำ การซิงโครไนซ์การไล่ระดับ และกลไกการทนทานต่อข้อผิดพลาด และเหมาะมากสำหรับการฝึกอบรมโมเดลขนาดใหญ่ เช่น GPT และ Gemini สถาปัตยกรรมนี้มีข้อดีคือมีประสิทธิภาพสูงและทรัพยากรที่ควบคุมได้ แต่ในขณะเดียวกันก็มีปัญหา เช่น การผูกขาดข้อมูล อุปสรรคด้านทรัพยากร การใช้พลังงาน และความเสี่ยงจากจุดเดียว
การฝึกอบรมแบบกระจายเป็นวิธีการหลักในปัจจุบันสำหรับการฝึกอบรมโมเดลขนาดใหญ่ แกนหลักคือการแยกงานฝึกอบรมโมเดลและแจกจ่ายไปยังเครื่องหลายเครื่องเพื่อดำเนินการร่วมกันเพื่อฝ่าด่านคอขวดของการประมวลผลและการจัดเก็บของเครื่องเดียว แม้ว่าจะมีคุณลักษณะ "แบบกระจาย" ทางกายภาพ แต่การกำหนดตารางเวลาและการซิงโครไนซ์โดยรวมยังคงควบคุมโดยองค์กรรวมศูนย์ มักทำงานในสภาพแวดล้อม LAN ความเร็วสูง ผ่านเทคโนโลยีบัสเชื่อมต่อความเร็วสูง NVLink โหนดหลักจะประสานงานงานย่อยทั้งหมด วิธีการหลัก ได้แก่: · ข้อมูลแบบขนาน: · แต่ละโหนดฝึกพารามิเตอร์ข้อมูลที่แตกต่างกันเพื่อแบ่งปัน และน้ำหนักของโมเดลจะต้องตรงกัน · โมเดลแบบขนาน: · ปรับใช้ส่วนต่างๆ ของโมเดลบนโหนดต่างๆ เพื่อให้ปรับขนาดได้อย่างแข็งแกร่ง · ท่อส่งแบบขนาน: · การดำเนินการแบบอนุกรมเป็นระยะเพื่อปรับปรุงปริมาณงาน · เทนเซอร์แบบขนาน: · การแบ่งส่วนแบบละเอียดของการคำนวณเมทริกซ์เพื่อปรับปรุงความละเอียดแบบขนาน
การฝึกอบรมแบบกระจายอำนาจเป็นการผสมผสานระหว่าง "การควบคุมจากส่วนกลาง + การดำเนินการแบบกระจายอำนาจ" ซึ่งคล้ายกับเจ้านายคนเดียวกันที่สั่งการให้พนักงาน "ออฟฟิศ" หลายคนทำงานร่วมกันเพื่อทำงานให้เสร็จจากระยะไกล ปัจจุบัน โมเดลขนาดใหญ่กระแสหลักเกือบทั้งหมด (GPT-4, Gemini, LLaMA เป็นต้น) ได้รับการฝึกอบรมในลักษณะนี้
การฝึกอบรมแบบกระจายอำนาจเป็นแนวทางในอนาคตที่เปิดกว้างและต้านทานการเซ็นเซอร์ได้มากขึ้น คุณลักษณะหลักคือโหนดที่ไม่น่าเชื่อถือหลายโหนด (ซึ่งอาจเป็นคอมพิวเตอร์ที่บ้าน GPU บนคลาวด์หรืออุปกรณ์เอจ) ทำงานร่วมกันเพื่อทำงานฝึกอบรมให้เสร็จโดยไม่มีผู้ประสานงานส่วนกลาง ซึ่งโดยปกติแล้วจะทำผ่านการกระจายงานและการทำงานร่วมกันตามโปรโตคอล และด้วยความช่วยเหลือของกลไกจูงใจทางเข้ารหัสเพื่อรับรองความซื่อสัตย์ของการมีส่วนร่วม ความท้าทายหลักที่โมเดลนี้เผชิญ ได้แก่: · อุปกรณ์ที่ไม่เป็นเนื้อเดียวกันและการแบ่งส่วนที่ยาก: อุปกรณ์ที่ไม่เป็นเนื้อเดียวกันนั้นประสานงานได้ยากและการแบ่งส่วนงานไม่มีประสิทธิภาพ · คอขวดของประสิทธิภาพการสื่อสาร: การสื่อสารบนเครือข่ายไม่เสถียรและคอขวดของการซิงโครไนซ์แบบไล่ระดับนั้นชัดเจน · ขาดการดำเนินการที่เชื่อถือได้: ขาดสภาพแวดล้อมการดำเนินการที่เชื่อถือได้ทำให้ยากต่อการตรวจสอบว่าโหนดมีส่วนเกี่ยวข้องในการคำนวณจริงหรือไม่ · ขาดการประสานงานที่เป็นหนึ่งเดียว: ไม่มีตัวกำหนดเวลาส่วนกลาง และการกระจายงานและกลไกการย้อนกลับที่ผิดปกติมีความซับซ้อน การฝึกอบรมแบบกระจายอำนาจสามารถเข้าใจได้ว่าเป็นกลุ่มอาสาสมัครทั่วโลก ซึ่งแต่ละคนมีส่วนสนับสนุนพลังการประมวลผลเพื่อฝึกอบรมโมเดลร่วมกัน แต่ "การฝึกอบรมแบบกระจายอำนาจขนาดใหญ่ที่เป็นไปได้อย่างแท้จริง" ยังคงเป็นความท้าทายทางวิศวกรรมที่เป็นระบบ ซึ่งเกี่ยวข้องกับหลายระดับ เช่น สถาปัตยกรรมระบบ โปรโตคอลการสื่อสาร ความปลอดภัยทางการเข้ารหัส กลไกทางเศรษฐกิจ และการตรวจสอบโมเดล อย่างไรก็ตาม การที่ "การทำงานร่วมกันมีประสิทธิผล + แรงจูงใจมีความซื่อสัตย์ + ผลลัพธ์ถูกต้อง" ยังคงอยู่ในระยะเริ่มต้นของการสำรวจต้นแบบ
ในฐานะรูปแบบการเปลี่ยนผ่านระหว่างการแจกจ่ายและการกระจายอำนาจ Federated Learning เน้นที่การเก็บข้อมูลในพื้นที่และการรวมพารามิเตอร์โมเดลแบบรวมศูนย์ และเหมาะสำหรับสถานการณ์ที่เน้นการปฏิบัติตามความเป็นส่วนตัว (เช่น ทางการแพทย์และการเงิน) การเรียนรู้แบบสหพันธ์มีโครงสร้างทางวิศวกรรมและความสามารถในการประสานงานในพื้นที่ของการฝึกอบรมแบบกระจาย และยังมีข้อได้เปรียบในการกระจายข้อมูลของการฝึกอบรมแบบกระจายอำนาจ แต่ยังคงอาศัยผู้ประสานงานที่เชื่อถือได้และไม่มีลักษณะของความเปิดกว้างและการต่อต้านการเซ็นเซอร์อย่างสมบูรณ์ สามารถถือได้ว่าเป็นโซลูชัน "การกระจายอำนาจที่ควบคุมได้" ในสถานการณ์การปฏิบัติตามความเป็นส่วนตัว ค่อนข้างอ่อนโยนในแง่ของงานการฝึกอบรม โครงสร้างความน่าเชื่อถือ และกลไกการสื่อสาร และเหมาะสมกว่าในฐานะสถาปัตยกรรมการปรับใช้ในช่วงเปลี่ยนผ่านในอุตสาหกรรม
ตารางเปรียบเทียบภาพรวมของรูปแบบการฝึกอบรม AI (สถาปัตยกรรมทางเทคนิค × แรงจูงใจด้านความน่าเชื่อถือ × ลักษณะการใช้งาน)
I. ขอบเขต โอกาส และเส้นทางที่สมจริงของการฝึกอบรมแบบกระจายอำนาจ
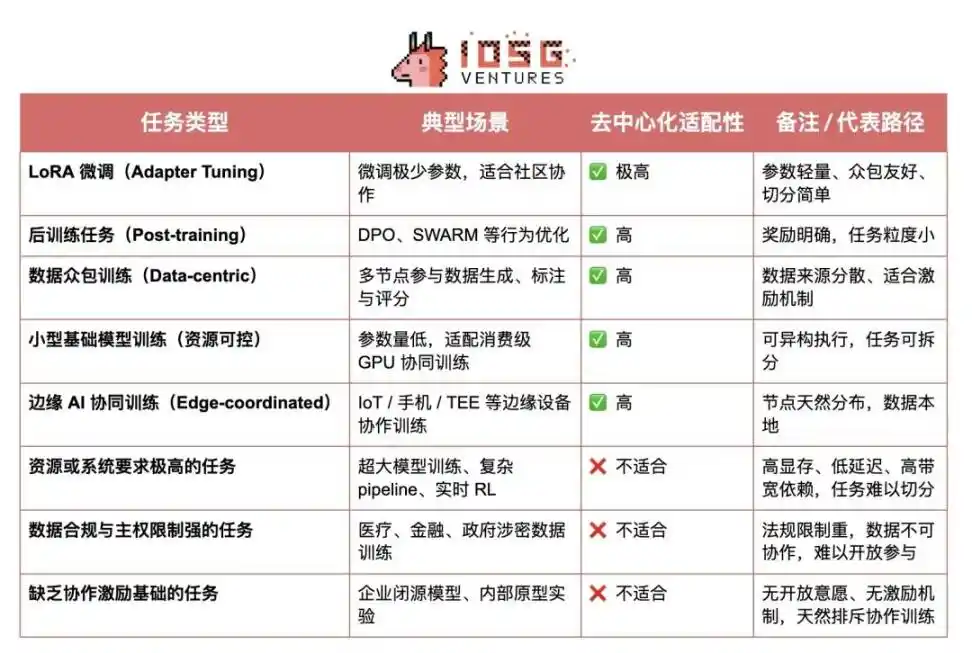
จากมุมมองของกรอบการฝึกอบรม การฝึกอบรมแบบกระจายอำนาจไม่เหมาะสำหรับงานทุกประเภท ในบางสถานการณ์ เนื่องจากโครงสร้างงานที่ซับซ้อน ความต้องการทรัพยากรที่สูงมาก หรือความยากลำบากในการทำงานร่วมกัน จึงไม่เหมาะสมสำหรับการดำเนินการให้เสร็จสิ้นอย่างมีประสิทธิภาพระหว่างโหนดที่ไม่เป็นเนื้อเดียวกันและไม่ต้องไว้วางใจ ตัวอย่างเช่น การฝึกอบรมโมเดลขนาดใหญ่ มักอาศัยหน่วยความจำวิดีโอสูง ความหน่วงต่ำ และแบนด์วิดท์ความเร็วสูง ซึ่งยากต่อการแบ่งและซิงโครไนซ์อย่างมีประสิทธิภาพในเครือข่ายเปิด งานที่มีข้อจำกัดด้านความเป็นส่วนตัวและอำนาจอธิปไตยของข้อมูลที่เข้มงวด (เช่น ข้อมูลทางการแพทย์ การเงิน และข้อมูลลับ) จะถูกจำกัดโดยการปฏิบัติตามกฎหมายและข้อจำกัดทางจริยธรรม และไม่สามารถแบ่งปันได้อย่างเปิดเผย และงานที่ไม่มีพื้นฐานแรงจูงใจในการทำงานร่วมกัน (เช่น โมเดลแบบปิดขององค์กรหรือการฝึกอบรมต้นแบบภายใน) ขาดแรงจูงใจในการมีส่วนร่วมจากภายนอก ขอบเขตเหล่านี้ร่วมกันประกอบเป็นข้อจำกัดในทางปฏิบัติปัจจุบันของการฝึกอบรมแบบกระจายอำนาจ
แต่ไม่ได้หมายความว่าการฝึกอบรมแบบกระจายอำนาจเป็นข้อเสนอที่ผิด ในความเป็นจริง การฝึกอบรมแบบกระจายอำนาจแสดงให้เห็นแนวโน้มการใช้งานที่ชัดเจนในงานประเภทน้ำหนักเบา ง่ายต่อการทำงานคู่ขนาน และมีแรงจูงใจ รวมถึงแต่ไม่จำกัดเพียง: การปรับแต่ง LoRA งานหลังการฝึกอบรมที่ปรับให้เข้ากับพฤติกรรม (เช่น RLHF, DPO) งานฝึกอบรมและคำอธิบายประกอบแบบคราวด์ซอร์ซข้อมูล การฝึกอบรมโมเดลพื้นฐานขนาดเล็กที่ควบคุมด้วยทรัพยากร และสถานการณ์การฝึกอบรมแบบร่วมมือที่เกี่ยวข้องกับอุปกรณ์เอดจ์ งานเหล่านี้โดยทั่วไปมีลักษณะของการทำงานคู่ขนานสูง การเชื่อมโยงต่ำ และการยอมรับพลังการประมวลผลที่ไม่เป็นเนื้อเดียวกัน ซึ่งเหมาะมากสำหรับการฝึกอบรมแบบร่วมมือผ่านเครือข่าย P2P โปรโตคอล Swarm ตัวเพิ่มประสิทธิภาพแบบกระจาย ฯลฯ
ภาพรวมของความสามารถในการปรับตัวของงานการฝึกอบรมแบบกระจายอำนาจ
II. การวิเคราะห์โครงการฝึกอบรมแบบกระจายอำนาจแบบคลาสสิก
ปัจจุบัน ในสาขาแนวหน้าของการฝึกอบรมแบบกระจายอำนาจและการเรียนรู้แบบสหพันธ์ โครงการบล็อคเชนที่เป็นตัวแทน ได้แก่ Prime Intellect, Pluralis.ai, Gensyn, Nous Research และ Flock.io เป็นหลัก จากมุมมองของนวัตกรรมทางเทคโนโลยีและความยากลำบากในการนำวิศวกรรมไปใช้ Prime Intellect, Nous Research และ Pluralis.ai ได้เสนอการสำรวจที่เป็นต้นฉบับมากขึ้นในสถาปัตยกรรมระบบและการออกแบบอัลกอริทึม ซึ่งแสดงถึงทิศทางแนวหน้าของการวิจัยเชิงทฤษฎีในปัจจุบัน ในขณะที่เส้นทางการนำ Gensyn และ Flock.io ไปใช้งานนั้นค่อนข้างชัดเจน และสามารถเห็นความคืบหน้าในเบื้องต้นของวิศวกรรมได้ บทความนี้จะวิเคราะห์เทคโนโลยีหลักและสถาปัตยกรรมทางวิศวกรรมเบื้องหลังทั้งห้าโครงการนี้ทีละโครงการ และสำรวจความแตกต่างและความสัมพันธ์ที่เสริมซึ่งกันและกันในระบบฝึกอบรม AI แบบกระจายอำนาจเพิ่มเติม
Prime Intellect: ผู้บุกเบิกเครือข่ายความร่วมมือการเรียนรู้เชิงเสริมแรงพร้อมเส้นทางการฝึกอบรมที่ตรวจสอบได้
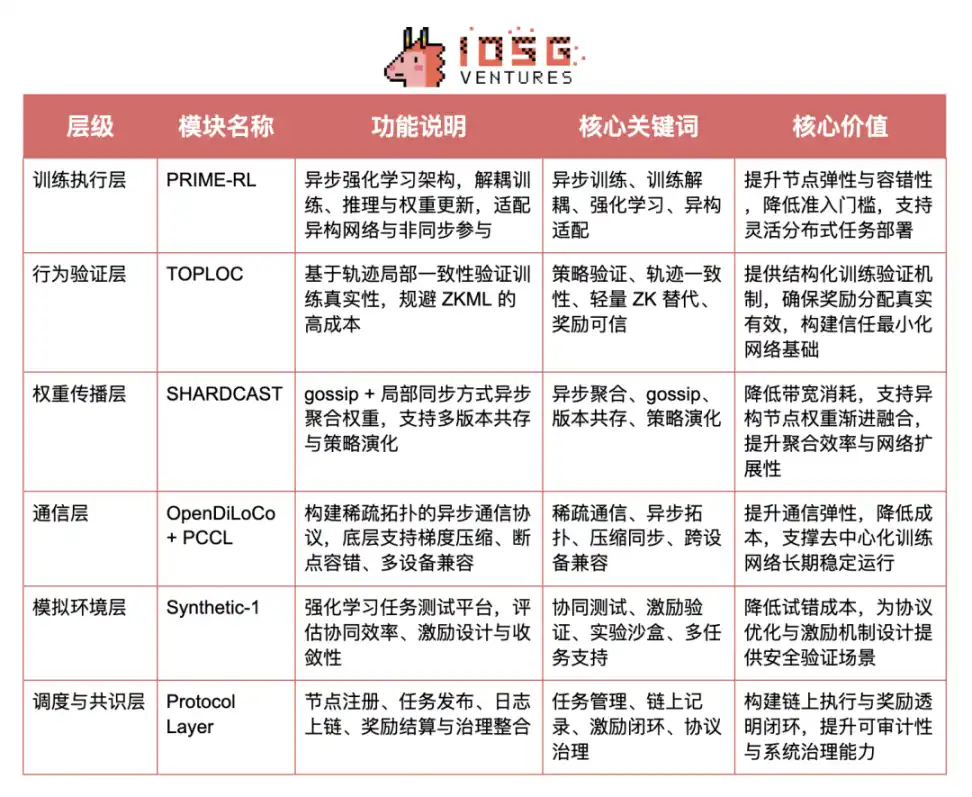
Prime Intellect มุ่งมั่นที่จะสร้างเครือข่ายการฝึกอบรม AI ที่ไม่น่าเชื่อถือ ซึ่งช่วยให้ทุกคนสามารถเข้าร่วมการฝึกอบรมและรับรางวัลที่น่าเชื่อถือสำหรับการมีส่วนร่วมด้านคอมพิวเตอร์ของตน Prime Intellect หวังว่าจะสร้างระบบการฝึกอบรม AI แบบกระจายอำนาจที่ตรวจสอบได้ เปิดกว้าง และมีแรงจูงใจอย่างเต็มที่ผ่านโมดูลทั้งสามของ PRIME-RL + TOPLOC + SHARDCAST
01 โครงสร้างสแต็กโปรโตคอล Prime Intellect และค่าโมดูลคีย์
02 คำอธิบายโดยละเอียดเกี่ยวกับกลไกหลักของการฝึกอบรม Prime Intellect
PRIME-RL: สถาปัตยกรรมงานการเรียนรู้การเสริมแรงแบบอะซิงโครนัสที่แยกส่วน
PRIME-RL คือกรอบงานการสร้างแบบจำลองและการดำเนินการงานที่ปรับแต่งโดย Prime Intellect สำหรับสถานการณ์การฝึกอบรมแบบกระจายอำนาจ ออกแบบมาสำหรับเครือข่ายที่ไม่เป็นเนื้อเดียวกันและการมีส่วนร่วมแบบอะซิงโครนัส กรอบงานใช้การเรียนรู้การเสริมแรงเป็นอ็อบเจ็กต์การปรับลำดับความสำคัญ แยกกระบวนการฝึกอบรม การให้เหตุผล และการอัปโหลดน้ำหนักออกจากกันอย่างมีโครงสร้าง เพื่อให้โหนดการฝึกอบรมแต่ละโหนดสามารถทำงานรอบงานให้เสร็จสมบูรณ์ได้อย่างอิสระในพื้นที่ และทำงานร่วมกับกลไกการตรวจสอบและการรวมข้อมูลผ่านอินเทอร์เฟซมาตรฐาน เมื่อเทียบกับกระบวนการเรียนรู้แบบมีผู้ดูแลแบบเดิม PRIME-RL เหมาะสมกว่าสำหรับการฝึกอบรมที่มีความยืดหยุ่นในสภาพแวดล้อมที่ไม่มีการกำหนดตารางเวลาส่วนกลาง ซึ่งไม่เพียงแต่ลดความซับซ้อนของระบบเท่านั้น แต่ยังวางรากฐานสำหรับการรองรับการทำงานคู่ขนานของมัลติทาสก์และการพัฒนากลยุทธ์อีกด้วย
TOPLOC: กลไกการตรวจสอบพฤติกรรมการฝึกอบรมแบบน้ำหนักเบา
TOPLOC (Trusted Observation & Policy-Locality Check) เป็นกลไกหลักสำหรับการตรวจสอบการฝึกอบรมที่เสนอโดย Prime Intellect ซึ่งใช้เพื่อพิจารณาว่าโหนดได้ดำเนินการเรียนรู้นโยบายที่มีประสิทธิผลตามข้อมูลที่สังเกตได้จริงหรือไม่ ซึ่งแตกต่างจากโซลูชันหนักๆ เช่น ZKML, TOPLOC จะไม่พึ่งพาการคำนวณแบบจำลองใหม่ทั้งหมด แต่จะทำการตรวจสอบโครงสร้างแบบน้ำหนักเบาโดยวิเคราะห์เส้นทางความสอดคล้องในพื้นที่ระหว่าง "ลำดับการสังเกต ↔ การอัปเดตนโยบาย" เป็นครั้งแรกที่แปลงวิถีพฤติกรรมระหว่างการฝึกเป็นวัตถุที่ตรวจสอบได้ ซึ่งเป็นนวัตกรรมสำคัญในการบรรลุการจัดสรรรางวัลการฝึกที่ไม่ต้องไว้วางใจ และจัดเตรียมเส้นทางที่เป็นไปได้สำหรับการสร้างเครือข่ายการฝึกแบบร่วมมือที่กระจายอำนาจซึ่งตรวจสอบได้และมีแรงจูงใจ
SHARDCAST: โปรโตคอลการรวมและการแพร่กระจายน้ำหนักแบบอะซิงโครนัส
SHARDCAST เป็นโปรโตคอลการแพร่กระจายและการรวมน้ำหนักที่ออกแบบโดย Prime Intellect ซึ่งปรับให้เหมาะสมสำหรับสภาพแวดล้อมเครือข่ายจริงที่มีสถานะโหนดแบบอะซิงโครนัส จำกัดแบนด์วิดท์ และแปรผัน โปรโตคอลนี้ผสมผสานกลไกการแพร่กระจายแบบซุบซิบกับกลยุทธ์การซิงโครไนซ์ในพื้นที่ ช่วยให้โหนดหลายโหนดส่งการอัปเดตบางส่วนอย่างต่อเนื่องในสถานะอะซิงโครนัส ทำให้น้ำหนักบรรจบกันอย่างค่อยเป็นค่อยไปและวิวัฒนาการของหลายเวอร์ชัน เมื่อเปรียบเทียบกับวิธี AllReduce แบบรวมศูนย์หรือแบบซิงโครนัส SHARDCAST ปรับปรุงความสามารถในการปรับขนาดและความทนทานต่อข้อผิดพลาดของการฝึกอบรมแบบกระจายอำนาจได้อย่างมีนัยสำคัญ และเป็นรากฐานหลักสำหรับการสร้างฉันทามติน้ำหนักที่เสถียรและการทำซ้ำการฝึกอบรมอย่างต่อเนื่อง
OpenDiLoCo: กรอบการทำงานการสื่อสารแบบอะซิงโครนัสแบบกระจายศูนย์
OpenDiLoCo คือกรอบการทำงานด้านการเพิ่มประสิทธิภาพการสื่อสารที่นำไปใช้งานโดยอิสระและเป็นโอเพ่นซอร์สโดยทีมงาน Prime Intellect โดยอิงตามแนวคิด DiLoCo ที่เสนอโดย DeepMind กรอบการทำงานนี้ได้รับการออกแบบมาเพื่อรับมือกับความท้าทายต่างๆ เช่น ข้อจำกัดของแบนด์วิดท์ ความไม่เหมือนกันของอุปกรณ์ และความไม่เสถียรของโหนด ซึ่งมักพบในการฝึกอบรมแบบกระจายศูนย์ สถาปัตยกรรมของกรอบการทำงานนี้ใช้การประมวลผลข้อมูลแบบคู่ขนาน โดยการสร้างโครงสร้างโทโพโลยีแบบกระจายศูนย์ เช่น Ring, Expander และ Small-World จะช่วยหลีกเลี่ยงค่าใช้จ่ายด้านการสื่อสารที่สูงของการซิงโครไนซ์ทั่วโลก และอาศัยเฉพาะโหนดเพื่อนบ้านในพื้นที่เท่านั้นในการฝึกอบรมแบบร่วมมือกัน เมื่อรวมกับการอัปเดตแบบอะซิงโครนัสและกลไกการทนทานต่อข้อผิดพลาดในจุดพัก OpenDiLoCo จะทำให้ GPU ระดับผู้บริโภคและอุปกรณ์เอดจ์มีส่วนร่วมในงานฝึกอบรมได้อย่างเสถียร ซึ่งช่วยปรับปรุงการมีส่วนร่วมของการฝึกอบรมแบบร่วมมือกันทั่วโลกได้อย่างมีนัยสำคัญ กรอบการทำงานนี้เป็นหนึ่งในโครงสร้างพื้นฐานการสื่อสารที่สำคัญสำหรับการสร้างเครือข่ายการฝึกอบรมแบบกระจายศูนย์
PCCL: ไลบรารีการสื่อสารแบบร่วมมือกัน
PCCL (Prime Collective Communication Library) เป็นไลบรารีการสื่อสารน้ำหนักเบาที่ปรับแต่งโดย Prime Intellect สำหรับสภาพแวดล้อมการฝึกอบรม AI แบบกระจายอำนาจ ไลบรารีนี้มุ่งหวังที่จะแก้ปัญหาคอขวดในการปรับตัวของไลบรารีการสื่อสารแบบดั้งเดิม (เช่น NCCL, Gloo) ในอุปกรณ์ที่หลากหลายและเครือข่ายแบนด์วิดท์ต่ำ PCCL รองรับโทโพโลยีแบบเบาบาง การบีบอัดแบบไล่ระดับ การซิงโครไนซ์ความแม่นยำต่ำ และการกู้คืนจุดพัก และสามารถทำงานบน GPU ระดับผู้บริโภคและโหนดที่ไม่เสถียรได้ ไลบรารีนี้เป็นส่วนประกอบพื้นฐานที่รองรับความสามารถในการสื่อสารแบบอะซิงโครนัสของโปรโตคอล OpenDiLoCo ไลบรารีนี้ช่วยปรับปรุงความทนทานต่อแบนด์วิดท์และความเข้ากันได้ของอุปกรณ์ของเครือข่ายการฝึกอบรมอย่างมีนัยสำคัญ และเปิดรากฐานการสื่อสาร "ไมล์สุดท้าย" เพื่อสร้างเครือข่ายการฝึกอบรมแบบร่วมมือกันที่เปิดกว้างและเชื่อถือได้อย่างแท้จริง
03 เครือข่ายแรงจูงใจและการแบ่งบทบาท Prime Intellect
Prime Intellect ได้สร้างเครือข่ายการฝึกอบรมที่ไม่ต้องขออนุญาต ตรวจสอบได้ และมีแรงจูงใจทางเศรษฐกิจ ซึ่งช่วยให้ทุกคนสามารถเข้าร่วมในงานและรับรางวัลตามผลงานจริง โปรโตคอลทำงานตามบทบาทหลักสามประการ ได้แก่ · ผู้ริเริ่มงาน: กำหนดสภาพแวดล้อมการฝึกอบรม โมเดลเริ่มต้น ฟังก์ชันรางวัล และเกณฑ์การตรวจสอบ · โหนดการฝึกอบรม: ดำเนินการฝึกอบรมในพื้นที่ ส่งการอัปเดตน้ำหนักและเส้นทางการสังเกต · โหนดการตรวจสอบ: ใช้กลไก TOPLOC เพื่อตรวจสอบความถูกต้องของพฤติกรรมการฝึกอบรม และมีส่วนร่วมในการคำนวณรางวัลและการรวมกลยุทธ์
กระบวนการหลักของโปรโตคอลประกอบด้วยการปล่อยงาน การฝึกโหนด การตรวจสอบเส้นทาง การรวมน้ำหนัก (SHARDCAST) และการออกรางวัล ซึ่งก่อให้เกิดวงจรปิดแรงจูงใจรอบ "พฤติกรรมการฝึกจริง"
04 INTELLECT-2: การเปิดตัวโมเดลการฝึกแบบกระจายอำนาจที่ตรวจสอบได้รุ่นแรก
Prime Intellect เปิดตัว INTELLECT-2 ในเดือนพฤษภาคม 2025 ซึ่งเป็นโมเดลการเรียนรู้เสริมแรงขนาดใหญ่รุ่นแรกของโลกที่ฝึกโดยการทำงานร่วมกันของโหนดแบบกระจายอำนาจที่ไม่ซิงโครไนซ์และไม่ต้องไว้วางใจ โดยมีมาตราส่วนพารามิเตอร์ 32B โมเดล INTELLECT-2 ได้รับการฝึกโดยโหนด GPU ที่ไม่เหมือนกันมากกว่า 100 โหนดในสามทวีป โดยใช้สถาปัตยกรรมแบบอะซิงโครนัสเต็มรูปแบบและเวลาในการฝึกมากกว่า 400 ชั่วโมง ซึ่งแสดงให้เห็นถึงความเป็นไปได้และความเสถียรของเครือข่ายการทำงานร่วมกันแบบอะซิงโครนัส แบบจำลองนี้ไม่เพียงแต่เป็นการพัฒนาครั้งสำคัญในด้านประสิทธิภาพเท่านั้น แต่ยังเป็นการนำแนวคิด "การฝึกอบรมเป็นฉันทามติ" ที่ Prime Intellect เสนอมาใช้อย่างเป็นระบบเป็นครั้งแรกอีกด้วย INTELLECT-2 ผสานรวมโมดูลโปรโตคอลหลัก เช่น PRIME-RL (โครงสร้างการฝึกอบรมแบบอะซิงโครนัส) TOPLOC (การตรวจสอบพฤติกรรมการฝึกอบรม) และ SHARDCAST (การรวมน้ำหนักแบบอะซิงโครนัส) ซึ่งถือเป็นครั้งแรกที่เครือข่ายการฝึกอบรมแบบกระจายอำนาจสามารถบรรลุถึงความเปิดกว้าง การตรวจสอบ และแรงจูงใจทางเศรษฐกิจในวงจรปิดของกระบวนการฝึกอบรมได้
ในแง่ของประสิทธิภาพ INTELLECT-2 อิงตามการฝึกอบรม QwQ-32B และได้ทำการฝึกอบรม RL พิเศษในโค้ดและคณิตศาสตร์ ซึ่งเป็นแนวหน้าของแบบจำลองการปรับแต่ง RL โอเพนซอร์สในปัจจุบัน แม้ว่าจะยังไม่สามารถแซงหน้าแบบจำลองแบบปิด เช่น GPT-4 หรือ Gemini ได้ แต่ความสำคัญที่แท้จริงของมันอยู่ที่: มันเป็นการทดลองแบบจำลองแบบกระจายอำนาจครั้งแรกของโลกที่มีกระบวนการฝึกอบรมที่สมบูรณ์ซึ่งสามารถทำซ้ำได้ ตรวจสอบได้ และตรวจสอบได้ Prime Intellect ไม่เพียงแต่เปิดเผยซอร์สโค้ดของโมเดลเท่านั้น แต่ที่สำคัญกว่านั้นก็คือกระบวนการฝึกอบรมเองด้วย ไม่ว่าจะเป็นข้อมูลการฝึกอบรม เส้นทางการอัปเดตกลยุทธ์ กระบวนการตรวจสอบ และตรรกะการรวมกลุ่ม ล้วนโปร่งใสและตรวจสอบได้ ทำให้สร้างต้นแบบเครือข่ายการฝึกอบรมแบบกระจายอำนาจที่ทุกคนสามารถมีส่วนร่วมได้ การทำงานร่วมกันที่เชื่อถือได้ และแบ่งปันผลประโยชน์
Pluralis: ตัวสำรวจ Paradigm ของการฝึกอบรมแบบร่วมมือแบบขนานและการบีบอัดโครงสร้างแบบจำลองอะซิงโครนัส
Pluralis เป็นโครงการ Web3 AI ที่เน้นที่ "เครือข่ายการฝึกอบรมแบบร่วมมือที่เชื่อถือได้" เป้าหมายหลักคือการส่งเสริมการฝึกอบรมแบบจำลองแบบกระจายอำนาจ การมีส่วนร่วมแบบเปิด และแรงจูงใจในระยะยาว Pluralis เสนอแนวคิดใหม่ที่เรียกว่าการเรียนรู้โปรโตคอล: กระบวนการฝึกอบรมแบบจำลอง "ตามโปรโตคอล" และสร้างระบบการฝึกอบรมแบบเปิดที่มีวงจรปิดแรงจูงใจภายในผ่านกลไกการทำงานร่วมกันที่ตรวจสอบได้และการจัดทำแผนที่ความเป็นเจ้าของแบบจำลอง
01 แนวคิดหลัก: การเรียนรู้โปรโตคอล
การเรียนรู้โปรโตคอลที่ Pluralis เสนอประกอบด้วยเสาหลักสำคัญสามประการ:
1. โมเดลที่ไม่สามารถทำให้เป็นรูปธรรมได้
โมเดลนี้กระจายอยู่ในโหนดต่างๆ เป็นจำนวนมาก และไม่มีโหนดใดที่สามารถคืนค่าน้ำหนักทั้งหมดและเก็บไว้เป็นแหล่งข้อมูลแบบปิดได้ การออกแบบนี้ทำให้โมเดลเป็น "สินทรัพย์ในโปรโตคอล" โดยธรรมชาติ ซึ่งสามารถควบคุมข้อมูลรับรองการเข้าถึง ป้องกันการรั่วไหล และกำหนดรายได้
2. การฝึกคู่ขนานกับโมเดลผ่านทางอินเทอร์เน็ต
ด้วยกลไกคู่ขนานของโมเดลท่อส่งแบบอะซิงโครนัส (สถาปัตยกรรม SWARM) โหนดต่างๆ จะถือน้ำหนักเพียงบางส่วนเท่านั้น และฝึกหรือให้เหตุผลให้เสร็จสมบูรณ์ผ่านการทำงานร่วมกันของเครือข่ายแบนด์วิดท์ต่ำ
3. การเป็นเจ้าของบางส่วนสำหรับแรงจูงใจ
โหนดที่เข้าร่วมทั้งหมดจะได้รับความเป็นเจ้าของบางส่วนของโมเดลตามการสนับสนุนในการฝึกอบรมของพวกเขา จึงได้รับส่วนแบ่งรายได้ในอนาคตและสิทธิ์ในการกำกับดูแลโปรโตคอล
02 สถาปัตยกรรมทางเทคนิคของสแต็กโปรโตคอล Pluralis
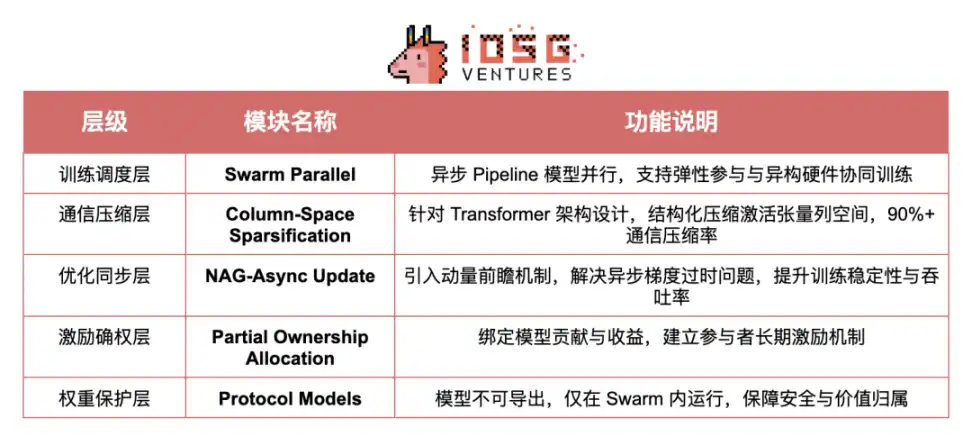
03 คำอธิบายโดยละเอียดของกลไกทางเทคนิคที่สำคัญ
โมเดลที่ไม่สามารถทำให้เป็นรูปธรรมได้
ใน "เส้นทางที่สาม: การเรียนรู้โปรโตคอล" มีการเสนออย่างเป็นระบบครั้งแรกว่าน้ำหนักของโมเดลจะถูกกระจายในรูปแบบของชิ้นส่วนเพื่อให้แน่ใจว่า "ทรัพย์สินของโมเดล" สามารถทำงานในเครือข่าย Swarm ได้เท่านั้น เพื่อให้แน่ใจว่าการเข้าถึงและรายได้ของสินทรัพย์เหล่านั้นถูกควบคุมโดยโปรโตคอล กลไกนี้เป็นข้อกำหนดเบื้องต้นสำหรับการบรรลุโครงสร้างแรงจูงใจที่ยั่งยืนสำหรับการฝึกอบรมแบบกระจายอำนาจ
การฝึกแบบคู่ขนานของโมเดลอะซิงโครนัส
ใน "SWARM Parallel with Asynchronous Updates" Pluralis ได้สร้างสถาปัตยกรรมแบบคู่ขนานของโมเดลอะซิงโครนัสที่ใช้ไพพ์ไลน์และสาธิตบน LLaMA-3 เป็นครั้งแรก นวัตกรรมหลักคือการนำกลไกเร่งความเร็วของการไล่ระดับ (NAG) ของ Nesterov มาใช้ ซึ่งแก้ไขปัญหาการเลื่อนไหลของการไล่ระดับและการบรรจบกันที่ไม่เสถียรได้อย่างมีประสิทธิภาพในระหว่างกระบวนการอัปเดตแบบอะซิงโครนัส ทำให้การฝึกระหว่างอุปกรณ์ที่ไม่เป็นเนื้อเดียวกันเป็นไปได้จริงในสภาพแวดล้อมแบนด์วิดท์ต่ำ
การแบ่งเบาภาระคอลัมน์และพื้นที่
ใน Beyond Top-K เสนอให้แทนที่ Top-K แบบดั้งเดิมด้วยวิธีการบีบอัดพื้นที่คอลัมน์ที่คำนึงถึงโครงสร้างเพื่อหลีกเลี่ยงการทำลายเส้นทางความหมาย กลไกนี้คำนึงถึงทั้งความแม่นยำของแบบจำลองและประสิทธิภาพการสื่อสาร มีการวัดว่าสามารถบีบอัดข้อมูลการสื่อสารได้มากกว่า 90% ในสภาพแวดล้อมแบบคู่ขนานของแบบจำลองอะซิงโครนัส ซึ่งถือเป็นความก้าวหน้าสำคัญในการบรรลุการสื่อสารที่มีประสิทธิภาพที่คำนึงถึงโครงสร้าง
04 การวางตำแหน่งเทคโนโลยีและการเลือกเส้นทาง
Pluralis ยึดถือ "การประมวลผลแบบคู่ขนานของแบบจำลองอะซิงโครนัส" เป็นแนวทางหลักอย่างชัดเจน โดยเน้นย้ำว่ามีข้อได้เปรียบเหนือการประมวลผลแบบคู่ขนานของข้อมูลดังต่อไปนี้:
· รองรับเครือข่ายแบนด์วิดท์ต่ำและโหนดที่ไม่สอดคล้องกัน;
· ปรับให้เข้ากับความหลากหลายของอุปกรณ์และอนุญาตให้ GPU ระดับผู้บริโภคมีส่วนร่วมได้;
· มีความสามารถในการกำหนดเวลาแบบยืดหยุ่นโดยธรรมชาติและรองรับโหนดที่ใช้บ่อยทั้งออนไลน์และออฟไลน์;
· ใช้การบีบอัดโครงสร้าง + การอัปเดตแบบอะซิงโครนัส + การไม่สามารถแยกน้ำหนักออกเป็นสามจุดพัฒนาหลัก
ตามเอกสารบล็อกทางเทคนิคทั้งหกฉบับที่เผยแพร่บนเว็บไซต์อย่างเป็นทางการ โครงสร้างเชิงตรรกะนั้นถูกผสานเข้าในสามบรรทัดหลักดังต่อไปนี้:
1. ปรัชญาและวิสัยทัศน์: "เส้นทางที่สาม: การเรียนรู้โปรโตคอล" "เหตุใดการฝึกอบรมแบบกระจายอำนาจจึงมีความสำคัญ"
2. รายละเอียดกลไกทางเทคนิค: "SWARM Parallel" "Beyond Top-K" "A Asynchronous Updates"
3. การสำรวจนวัตกรรมระดับสถาบัน: "โมเดลที่ไม่สามารถทำให้เป็นรูปธรรมได้" "โปรโตคอลความเป็นเจ้าของบางส่วน"
ปัจจุบัน Pluralis ยังไม่ได้เปิดตัวผลิตภัณฑ์ เครือข่ายทดสอบ หรือโค้ดโอเพนซอร์ส เหตุผลก็คือเส้นทางทางเทคนิคที่เลือกนั้นท้าทายอย่างยิ่ง จึงจำเป็นต้องแก้ไขปัญหาในระดับระบบ เช่น สถาปัตยกรรมระบบพื้นฐาน โปรโตคอลการสื่อสาร และน้ำหนักที่ไม่สามารถส่งออกได้ ก่อนที่จะสามารถรวมผลิตภัณฑ์และบริการขึ้นไปด้านบนได้
ในเอกสารฉบับใหม่ที่ตีพิมพ์โดย Pluralis Research ในเดือนมิถุนายน 2025 กรอบการทำงานการฝึกแบบกระจายอำนาจได้รับการขยายจากการฝึกแบบจำลองเบื้องต้นไปเป็นการปรับแต่งแบบจำลอง ซึ่งรองรับการอัปเดตแบบอะซิงโครนัส การสื่อสารแบบเบาบาง และการรวมน้ำหนักบางส่วน เมื่อเปรียบเทียบกับการออกแบบก่อนหน้านี้ที่เน้นที่ทฤษฎีและการฝึกเบื้องต้น งานนี้ให้ความสำคัญกับความเป็นไปได้ในการนำไปใช้งานมากกว่า ซึ่งถือเป็นการแสดงให้เห็นถึงความครบถ้วนสมบูรณ์ยิ่งขึ้นในสถาปัตยกรรมการฝึกแบบรอบเต็ม
Gensyn: เลเยอร์โปรโตคอลการฝึกอบรมแบบกระจายอำนาจที่ขับเคลื่อนด้วยการดำเนินการที่ตรวจสอบได้
Gensyn คือโครงการ Web3 AI ที่เน้นที่ "การดำเนินการที่เชื่อถือได้ของงานฝึกอบรมการเรียนรู้เชิงลึก" แก่นกลางไม่ใช่การสร้างสถาปัตยกรรมแบบจำลองหรือรูปแบบการฝึกอบรมใหม่ แต่เป็นการสร้างเครือข่ายการดำเนินการฝึกอบรมแบบกระจายอำนาจที่ตรวจสอบได้พร้อมกระบวนการทั้งหมดของ "การกระจายงาน + การดำเนินการฝึกอบรม + การตรวจสอบผลลัพธ์ + แรงจูงใจที่ยุติธรรม" ผ่านการออกแบบสถาปัตยกรรมของการฝึกอบรมนอกเครือข่าย + การตรวจสอบบนเครือข่าย Gensyn ได้สร้างตลาดการฝึกอบรมระดับโลกที่เปิดกว้างและมีแรงจูงใจ ทำให้ "การฝึกอบรมคือการขุด" เป็นจริง
01 การวางตำแหน่งโครงการ: เลเยอร์โปรโตคอลการดำเนินการสำหรับงานฝึกอบรม
Gensyn ไม่ได้เกี่ยวกับ "วิธีฝึกอบรม" แต่เป็นโครงสร้างพื้นฐานของ "ใครฝึกอบรม วิธีตรวจสอบ และวิธีแบ่งปันผลกำไร" สาระสำคัญคือโปรโตคอลการคำนวณที่ตรวจสอบได้สำหรับงานการฝึกอบรม ซึ่งส่วนใหญ่แก้ไขปัญหาดังต่อไปนี้:
· ใครจะดำเนินการงานการฝึกอบรม (การกระจายพลังการประมวลผลและการจับคู่แบบไดนามิก)
· วิธีการตรวจสอบผลลัพธ์การดำเนินการ (ไม่จำเป็นต้องคำนวณใหม่ เพียงตรวจสอบตัวดำเนินการที่โต้แย้งเท่านั้น)
· วิธีการกระจายผลประโยชน์ของการฝึกอบรม (การเดิมพัน การฟัน และกลไกเกมหลายบทบาท)
02 ภาพรวมสถาปัตยกรรมทางเทคนิค
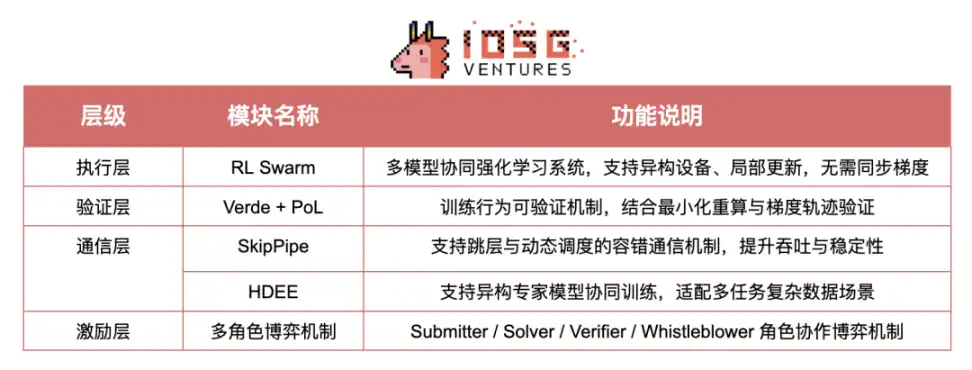
03 คำอธิบายโดยละเอียดของโมดูล
RL Swarm: ระบบการฝึกอบรมการเรียนรู้การเสริมแรงแบบร่วมมือ
RL Swarm ซึ่งริเริ่มโดย Gensyn เป็นระบบเพิ่มประสิทธิภาพแบบร่วมมือแบบกระจายศูนย์หลายรูปแบบสำหรับขั้นตอนหลังการฝึกอบรม โดยมีแกนหลักดังต่อไปนี้ คุณสมบัติ:
กระบวนการเรียนรู้และการใช้เหตุผลแบบกระจาย:
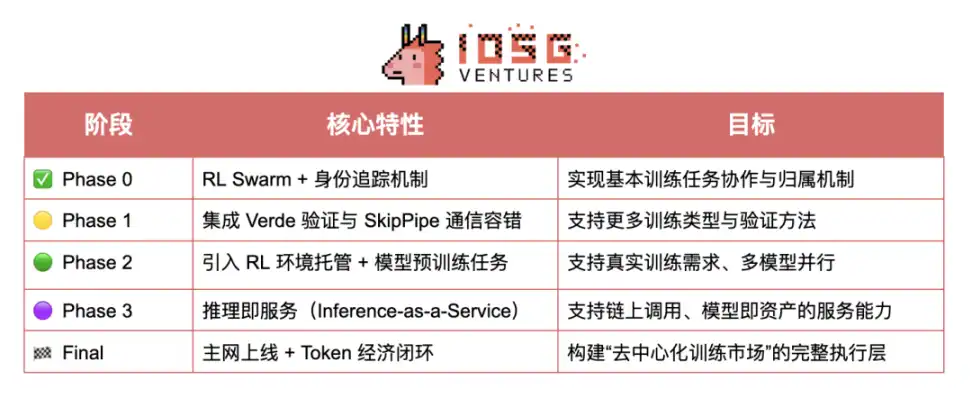
· การตอบ: แต่ละโหนดจะส่งออกคำตอบโดยอิสระ การวิจารณ์: โหนดจะแสดงความคิดเห็นเกี่ยวกับผลลัพธ์ของกันและกันและเลือกคำตอบและตรรกะที่ดีที่สุด การแก้ปัญหา: ทำนายการตั้งค่าของโหนดส่วนใหญ่และแก้ไขคำตอบของตนเองตามนั้นเพื่อให้ได้การอัปเดตน้ำหนักในพื้นที่ RL Swarm ที่เสนอโดย Gensyn เป็นระบบเพิ่มประสิทธิภาพการทำงานร่วมกันแบบกระจายศูนย์หลายโมเดล แต่ละโหนดจะรันโมเดลอิสระและดำเนินการฝึกอบรมในพื้นที่โดยไม่มีการซิงโครไนซ์การไล่ระดับ โดยธรรมชาติแล้วระบบนี้จะปรับตัวให้เข้ากับพลังการประมวลผลที่ไม่เป็นเนื้อเดียวกันและสภาพแวดล้อมเครือข่ายที่ไม่เสถียร และรองรับการเข้าถึงและออกจากโหนดที่ยืดหยุ่น กลไกนี้ดึงเอาแนวคิดของ RLHF และเกมหลายเอเจนต์มาใช้ แต่ใกล้เคียงกับตรรกะวิวัฒนาการแบบไดนามิกของเครือข่ายการใช้เหตุผลร่วมกันมากกว่า โหนดจะได้รับรางวัลตามระดับความสอดคล้องกับผลลัพธ์ฉันทามติของกลุ่ม จึงขับเคลื่อนการเพิ่มประสิทธิภาพอย่างต่อเนื่องและการเรียนรู้ความสามารถในการใช้เหตุผลแบบบรรจบกัน RL Swarm ปรับปรุงความแข็งแกร่งและการสรุปทั่วไปของโมเดลในเครือข่ายเปิดได้อย่างมีนัยสำคัญ และได้รับการปรับใช้เป็นโมดูลการดำเนินการหลักใน Testnet Phase 0 ของ Gensyn ที่ใช้ Ethereum Rollup Verde + Proof-of-Learning: กลไกการตรวจสอบที่เชื่อถือได้ โมดูล Verde ของ Gensyn ผสมผสานกลไกสามประการ: 1. Proof-of-Learning:ตรวจสอบว่าการฝึกเกิดขึ้นจริงหรือไม่โดยอิงจากวิถีการไล่ระดับและข้อมูลเมตาของการฝึก 2. การระบุตำแหน่งตามกราฟ:ระบุตำแหน่งโหนดที่แยกออกจากกันในกราฟการคำนวณการฝึก และจำเป็นต้องคำนวณการดำเนินการเฉพาะใหม่เท่านั้น 3. การมอบหมายงานโดยมีผู้ตัดสิน:การใช้กลไกการตรวจสอบการอนุญาโตตุลาการ ผู้ตรวจสอบและผู้ท้าทายสามารถยื่นข้อโต้แย้งและตรวจสอบในพื้นที่ ซึ่งช่วยลดต้นทุนการตรวจสอบได้อย่างมาก เมื่อเปรียบเทียบกับแผนการตรวจสอบ ZKP หรือการคำนวณใหม่ทั้งหมด แผน Verde สามารถสร้างสมดุลระหว่างการตรวจสอบและประสิทธิภาพได้ดีกว่า SkipPipe: กลไกการเพิ่มประสิทธิภาพที่ทนทานต่อความผิดพลาดในการสื่อสาร SkipPipe ถูกออกแบบมาเพื่อแก้ปัญหาคอขวดในการสื่อสารในสถานการณ์ "แบนด์วิดท์ต่ำ + โหนดถูกตัดการเชื่อมต่อ" ความสามารถหลัก ได้แก่: · อัตราส่วนการข้าม:ข้ามโหนดที่ถูกจำกัดเพื่อหลีกเลี่ยงการอุดตันในการฝึกอบรม; · อัลกอริทึมการจัดกำหนดการแบบไดนามิก:สร้างเส้นทางการดำเนินการที่เหมาะสมที่สุดแบบเรียลไทม์; · การดำเนินการที่ทนทานต่อความผิดพลาด:แม้ว่าโหนด 50% จะล้มเหลว ความแม่นยำในการอนุมานจะลดลงเพียงประมาณ 7% เท่านั้น รองรับการปรับปรุงปริมาณงานในการฝึกอบรมสูงถึง 55% และตระหนักถึงความสามารถที่สำคัญ เช่น "การอนุมานการออกก่อนกำหนด" "การเรียงลำดับใหม่ที่ไร้รอยต่อ" และ "การเสร็จสิ้นการอนุมาน" HDEE: คลัสเตอร์ผู้เชี่ยวชาญที่มีความหลากหลายแบบครอสโดเมน โมดูล HDEE (Heterogeneous Domain-Expert Ensembles) ออกแบบมาเพื่อเพิ่มประสิทธิภาพให้กับสถานการณ์ต่อไปนี้: · การฝึกแบบหลายโดเมน หลายโหมด และหลายงาน; · การกระจายข้อมูลการฝึกประเภทต่างๆ ที่ไม่สมดุลและความแตกต่างอย่างมากในด้านความยาก; · ปัญหาการจัดสรรและกำหนดเวลาการทำงานในสภาพแวดล้อมที่มีพลังในการประมวลผลของอุปกรณ์ที่หลากหลายและแบนด์วิดท์การสื่อสารที่ไม่สม่ำเสมอ คุณสมบัติหลัก: · MHe-IHo: กำหนดแบบจำลองที่มีขนาดต่างกันให้กับงานที่มีระดับความยากต่างกัน (แบบจำลองที่ไม่เป็นเนื้อเดียวกัน ขนาดขั้นตอนการฝึกที่สอดคล้องกัน); · MHo-IHe: ระดับความยากของงานเท่ากัน แต่ปรับขนาดขั้นตอนการฝึกแบบไม่พร้อมกัน; · รองรับแบบจำลองผู้เชี่ยวชาญที่ไม่เป็นเนื้อเดียวกัน + กลยุทธ์การฝึกแบบปลั๊กอินเพื่อปรับปรุงความสามารถในการปรับตัวและการทนทานต่อข้อผิดพลาด; · เน้นย้ำ "การทำงานร่วมกันแบบคู่ขนาน + การสื่อสารที่ต่ำมาก + การจัดสรรผู้เชี่ยวชาญแบบไดนามิก" ซึ่งเหมาะสำหรับระบบนิเวศของงานที่ซับซ้อนในความเป็นจริง กลไกเกมหลายบทบาท: ความไว้วางใจและแรงจูงใจแบบคู่ขนาน เครือข่าย Gensyn แนะนำผู้เข้าร่วมสี่ประเภท: 1. ผู้ส่ง:เผยแพร่งานการฝึก กำหนดโครงสร้างและงบประมาณ; 2. ตัวแก้ปัญหา: ดำเนินการตามภารกิจการฝึกอบรมและส่งผลลัพธ์; 3. ผู้ตรวจสอบ:ตรวจสอบพฤติกรรมการฝึกอบรมเพื่อให้แน่ใจว่าเป็นไปตามข้อกำหนดและมีประสิทธิผล; 4. ผู้แจ้งเบาะแส:ท้าทายผู้ตรวจสอบเพื่อรับรางวัลจากการอนุญาโตตุลาการหรือรับโทษ กลไกนี้ได้รับแรงบันดาลใจจากการออกแบบเกมเศรษฐกิจของ Truebit โดยการบังคับให้แทรกข้อผิดพลาดและการอนุญาโตตุลาการแบบสุ่ม ช่วยกระตุ้นให้ผู้เข้าร่วมให้ความร่วมมืออย่างซื่อสัตย์และรับรองการทำงานที่เชื่อถือได้ของเครือข่าย Nous Research เป็นหนึ่งในทีมฝึกอบรมแบบกระจายอำนาจไม่กี่ทีมที่มีทั้งความยอดเยี่ยมทางปรัชญาและการนำไปใช้งานทางวิศวกรรม วิสัยทัศน์หลักของทีมมาจากแนวคิด "AI ที่เป็นที่ต้องการ": AI ถูกมองว่าเป็นวิชาที่มีสติปัญญาซึ่งมีความเป็นอัตวิสัยและความสามารถในการวิวัฒนาการ มากกว่าที่จะเป็นเครื่องมือที่ควบคุมได้แบบง่ายๆ ความพิเศษของ Nous Research อยู่ที่ว่าทีมนี้ไม่ได้ปรับการฝึกอบรม AI ให้เหมาะสมในฐานะ "ปัญหาประสิทธิภาพ" แต่เป็นกระบวนการสร้าง "วิชาทางปัญญา" ด้วยวิสัยทัศน์นี้ Nous จึงมุ่งเน้นที่การสร้างเครือข่ายการฝึกอบรมแบบเปิดที่ได้รับการฝึกอบรมร่วมกันโดยโหนดที่มีความหลากหลาย ไม่จำเป็นต้องมีการจัดตารางเวลาส่วนกลาง และทนต่อการเซ็นเซอร์ และนำไปใช้อย่างเป็นระบบผ่านชุดเครื่องมือแบบครบวงจร Nous ไม่ได้ลงทุนมากเกินไปในด้านการออกแบบแรงจูงใจหรือเศรษฐศาสตร์ของโปรโตคอล แต่พยายามเปลี่ยนหลักการทางปรัชญาของการฝึกอบรมเอง: · ต่อต้าน "การจัดแนว":ไม่เห็นด้วยกับ "การฝึกอบรม" ที่ยึดการควบคุมของมนุษย์เป็นเป้าหมายเดียว และสนับสนุนว่าการฝึกอบรมควรส่งเสริมให้แบบจำลองสร้างรูปแบบการรู้คิดที่เป็นอิสระ; · เน้นย้ำถึงความคิดเห็นส่วนตัวของแบบจำลอง:เชื่อว่าแบบจำลองพื้นฐานควรคงไว้ซึ่งความไม่แน่นอน ความหลากหลาย และความสามารถในการสร้างภาพหลอน (ภาพหลอนเป็นคุณธรรม); · การฝึกอบรมแบบจำลองคือการสร้างความรู้ความเข้าใจ:แบบจำลองไม่ใช่ "การปรับปรุงการทำงานให้เสร็จสมบูรณ์ให้เหมาะสมที่สุด" แต่เป็นบุคคลที่เข้าร่วมในกระบวนการวิวัฒนาการทางความรู้ความเข้าใจ แม้ว่ามุมมองการฝึกอบรมนี้จะ "โรแมนติก" แต่ก็สะท้อนถึงตรรกะหลักของการออกแบบโครงสร้างพื้นฐานการฝึกอบรมของ Nous: วิธีปล่อยให้แบบจำลองที่หลากหลายพัฒนาในเครือข่ายเปิดแทนที่จะมีวินัยเหมือนกัน ส่วนสนับสนุนที่สำคัญที่สุดของ Nous สำหรับการฝึกอบรมแบบกระจายอำนาจคือการสร้างเครือข่าย Psyche และ DisTrO (การฝึกอบรมแบบกระจายผ่านอินเทอร์เน็ต) ซึ่งเป็นตัวเพิ่มประสิทธิภาพการสื่อสารพื้นฐาน ซึ่งร่วมกันสร้างศูนย์กลางการดำเนินการของงานฝึกอบรม: เครือข่าย DisTrO + Psyche มีความสามารถหลักหลายประการ รวมถึงการบีบอัดการสื่อสาร (ใช้การเข้ารหัสสัญญาณ DCT + 1 บิตเพื่อลดความต้องการแบนด์วิดท์ลงอย่างมาก) ความสามารถในการปรับตัวของโหนด (รองรับ GPU ที่ไม่เหมือนกัน การเชื่อมต่อใหม่เมื่อตัดการเชื่อมต่อ และการออกจากระบบอัตโนมัติ) การทนทานต่อความผิดพลาดแบบอะซิงโครนัส (การฝึกอบรมอย่างต่อเนื่องโดยไม่ต้องซิงโครไนซ์ โดยมีการทนทานต่อความผิดพลาดสูง) และกลไกการจัดตารางเวลาแบบกระจายอำนาจ (ไม่จำเป็นต้องมีผู้ประสานงานส่วนกลาง การบรรลุฉันทามติและการกระจายงานทำได้โดยอาศัยบล็อคเชน) สถาปัตยกรรมนี้มอบรากฐานทางเทคนิคที่สมจริงและเป็นไปได้สำหรับเครือข่ายการฝึกอบรมแบบเปิดที่มีต้นทุนต่ำ มีความยืดหยุ่นสูง และตรวจสอบได้ การออกแบบสถาปัตยกรรมนี้เน้นที่ความเป็นไปได้ในทางปฏิบัติ: ไม่ต้องพึ่งพาเซิร์ฟเวอร์ส่วนกลาง ปรับให้เข้ากับโหนดอาสาสมัครทั่วโลก และมีการติดตามผลการฝึกอบรมแบบออนเชน นอกเหนือจากการสร้างโครงสร้างพื้นฐานการฝึกอบรมแบบกระจายอำนาจแล้ว Nous Research ยังได้ทำการทดลองระบบสำรวจจำนวนหนึ่งเกี่ยวกับแนวคิดของ "ความเป็นอัตวิสัยของ AI": ชุดโมเดลโอเพ่นซอร์สของ Hermes Hermes 1 ถึง 3 เป็นโมเดลโอเพ่นซอร์สขนาดใหญ่ที่เป็นตัวแทนซึ่งเปิดตัวโดย Nous โดยอิงตามการฝึกอบรม LLaMA 3.1 ซึ่งครอบคลุมมาตราส่วนพารามิเตอร์สามมาตราส่วนคือ 8B, 70B และ 405B ซีรีย์นี้มุ่งหวังที่จะรวบรวมแนวคิดการฝึกอบรม "การเลิกสอน รักษาความหลากหลาย" ซึ่งได้รับการสนับสนุนโดย Nous และแสดงให้เห็นถึงความสามารถในการแสดงออกและการสรุปความที่แข็งแกร่งยิ่งขึ้นในการจำบริบทระยะยาว การเล่นตามบทบาท และบทสนทนาหลายรอบ Forge Reasoning API: ระบบการใช้เหตุผลแบบหลายโหมด Forge เป็นกรอบการทำงานการใช้เหตุผลที่พัฒนาโดย Nous โดยผสมผสานกลไกที่เสริมกันสามประการเข้าด้วยกันเพื่อให้ได้ความสามารถในการใช้เหตุผลที่ยืดหยุ่นและสร้างสรรค์มากขึ้น: · MCTS (Monte Carlo Tree Search):การค้นหาเชิงกลยุทธ์สำหรับงานที่ซับซ้อน; · CoC (Chain of Code):แนะนำเส้นทางผสมผสานระหว่างสายโค้ดและการใช้เหตุผลแบบตรรกะ; · MoA (Mixture of Agents):อนุญาตให้โมเดลหลายตัวเจรจาและปรับปรุงความกว้างและความหลากหลายของเอาต์พุต ระบบเน้นที่ "การใช้เหตุผลที่ไม่แน่นอน" และเส้นทางการสร้างแบบผสมผสาน ซึ่งเป็นการตอบสนองอันทรงพลังต่อรูปแบบการจัดตำแหน่งคำสั่งแบบเดิม TEE_HEE: การทดลองตัวแทนอิสระของ AI TEE_HEE คือการสำรวจล้ำสมัยของ Nous ในทิศทางของตัวแทนอิสระ โดยมุ่งเป้าไปที่การตรวจสอบว่า AI สามารถทำงานอย่างอิสระในสภาพแวดล้อมการทำงานที่เชื่อถือได้ (TEE) และมีเอกลักษณ์ดิจิทัลที่ไม่ซ้ำใครหรือไม่ ตัวแทนมีบัญชี Twitter และ Ethereum ของตัวเอง และสิทธิ์การควบคุมทั้งหมดได้รับการจัดการโดยเอ็นเคลฟที่ตรวจสอบได้จากระยะไกล ดังนั้นนักพัฒนาจึงไม่สามารถแทรกแซงพฤติกรรมของมันได้ เป้าหมายของการทดลองคือการสร้างวิชา AI ที่มี "ความไม่เปลี่ยนแปลง" และ "เจตนาพฤติกรรมอิสระ" ซึ่งเป็นขั้นตอนสำคัญในการสร้างตัวแทนอัจฉริยะอิสระ แพลตฟอร์มจำลองพฤติกรรม AI Nous ยังได้พัฒนาโปรแกรมจำลองหลายโปรแกรม เช่น WorldSim, Doomscroll, Gods & S8n เป็นต้น เพื่อศึกษาวิวัฒนาการพฤติกรรมและกลไกการสร้างมูลค่าของ AI ในสภาพแวดล้อมทางสังคมแบบหลายบทบาท แม้ว่าจะไม่ได้เกี่ยวข้องโดยตรงกับกระบวนการฝึกอบรม แต่การทดลองเหล่านี้ก็ได้วางรากฐานชั้นความหมายสำหรับการสร้างแบบจำลองพฤติกรรมทางปัญญาของ AI อัตโนมัติระยะยาว Flock.io เป็นแพลตฟอร์มการเรียนรู้แบบรวมศูนย์ที่ใช้บล็อคเชน ซึ่งมีเป้าหมายเพื่อกระจายข้อมูล การประมวลผล และแบบจำลองสำหรับการฝึกอบรม AI FLock ชอบกรอบงานแบบบูรณาการของ "การเรียนรู้แบบรวมศูนย์ + ชั้นรางวัลบล็อคเชน" ซึ่งโดยพื้นฐานแล้วเป็นวิวัฒนาการแบบออนเชนของสถาปัตยกรรม FL แบบดั้งเดิม มากกว่าการสำรวจอย่างเป็นระบบในการสร้างโปรโตคอลการฝึกอบรมใหม่ เมื่อเปรียบเทียบกับโครงการฝึกอบรมแบบกระจายศูนย์ เช่น Gensyn, Prime Intellect, Nous Research และ Pluralis แล้ว Flock มุ่งเน้นไปที่การปกป้องความเป็นส่วนตัวและการปรับปรุงการใช้งานมากกว่าความก้าวหน้าทางทฤษฎีในการสื่อสาร การตรวจสอบ หรือวิธีการฝึกอบรม วัตถุที่เหมาะสมอย่างแท้จริงสำหรับการเปรียบเทียบคือระบบการเรียนรู้แบบรวมศูนย์ เช่น Flower, FedML และ OpenFL สถาปัตยกรรมการเรียนรู้แบบรวมศูนย์: เน้นย้ำถึงอำนาจอธิปไตยของข้อมูลและการปกป้องความเป็นส่วนตัว Flock มีพื้นฐานมาจากแนวคิดการเรียนรู้แบบรวมศูนย์ (FL) แบบคลาสสิก ซึ่งอนุญาตให้เจ้าของข้อมูลหลายรายร่วมกันฝึกอบรมโมเดลแบบรวมศูนย์โดยไม่ต้องแบ่งปันข้อมูลเดิม โดยเน้นที่การแก้ไขปัญหาอำนาจอธิปไตยของข้อมูล ความปลอดภัย และความเชื่อถือ กระบวนการหลักประกอบด้วย: · การฝึกอบรมในพื้นที่:ผู้เข้าร่วมแต่ละคน (ผู้เสนอ) ฝึกอบรมโมเดลบนอุปกรณ์ในพื้นที่โดยไม่อัปโหลดข้อมูลต้นฉบับ; · การรวมข้อมูลบนเชน:หลังจากฝึกอบรมแล้ว การอัปเดตน้ำหนักในพื้นที่จะถูกส่ง และตัวขุดบนเชนจะรวบรวมเป็นโมเดลทั่วโลก; · การประเมินคณะกรรมการ:VRF เลือกโหนดผู้ลงคะแนนแบบสุ่มเพื่อใช้ชุดทดสอบอิสระเพื่อประเมินผลของโมเดลรวมและให้คะแนน; · แรงจูงใจและบทลงโทษ:รางวัลหรือการยึดหลักประกันจะดำเนินการตามผลลัพธ์ของคะแนนเพื่อให้บรรลุการป้องกันความประสงค์ร้ายและการบำรุงรักษาความน่าเชื่อถือแบบไดนามิก การบูรณาการบล็อคเชน: ตระหนักถึงการประสานงานระบบที่ไม่ต้องไว้วางใจ Flock ได้วางลิงก์หลักทั้งหมดของกระบวนการฝึกอบรม (งาน การจัดสรร การส่งแบบจำลอง การประเมินและการให้คะแนน การดำเนินการสร้างแรงจูงใจ) บนเครือข่ายเพื่อให้เกิดความโปร่งใสของระบบ ความสามารถในการตรวจสอบ และการต่อต้านการเซ็นเซอร์ กลไกหลัก ได้แก่: · กลไกการเลือกแบบสุ่ม VRF:ปรับปรุงความยุติธรรมและความสามารถในการต่อต้านการจัดการของการหมุนเวียนผู้เสนอและผู้ลงคะแนน; · กลไกการเดิมพันหุ้น (PoS):ปรับปรุงความทนทานของระบบโดยจำกัดพฤติกรรมของโหนดผ่านการเดิมพันโทเค็นและการลงโทษ; · การดำเนินการสร้างแรงจูงใจแบบออนเชนโดยอัตโนมัติ:ดำเนินการแจกจ่ายรางวัลและลดการลงโทษที่ผูกไว้กับการทำงานให้เสร็จสิ้นและผลการประเมินผ่านสัญญาอัจฉริยะเพื่อสร้างเครือข่ายที่ร่วมมือกันโดยไม่ต้องไว้วางใจคนกลาง zkFL: นวัตกรรมการปกป้องความเป็นส่วนตัวของกลไกการรวมความรู้เป็นศูนย์ Flock แนะนำกลไกการรวมความรู้เป็นศูนย์ zkFL ซึ่งทำให้ผู้เสนอสามารถส่งความรู้เป็นศูนย์ที่อัปเดตในพื้นที่ได้ หลักฐาน และผู้ลงคะแนนเสียงสามารถตรวจสอบความถูกต้องได้โดยไม่ต้องเข้าถึงการไล่ระดับสีดั้งเดิม ซึ่งช่วยเพิ่มความน่าเชื่อถือของกระบวนการฝึกอบรมในขณะที่รับประกันความเป็นส่วนตัว และถือเป็นนวัตกรรมที่สำคัญในการผสานการปกป้องความเป็นส่วนตัวและการตรวจสอบในการเรียนรู้แบบรวมศูนย์ AI Arena: เป็นแพลตฟอร์มการฝึกอบรมแบบกระจายอำนาจของ Flock.io ผู้ใช้สามารถเข้าร่วมในงานจำลองผ่าน train.flock.io โดยทำหน้าที่เป็นผู้ฝึกสอน ผู้ตรวจสอบ หรือผู้มอบหมาย และรับรางวัลโดยการส่งแบบจำลอง ประเมินประสิทธิภาพ หรือมอบหมายโทเค็น ปัจจุบัน งานต่างๆ เผยแพร่โดยทางการ และจะค่อยๆ เปิดให้ชุมชนร่วมสร้างสรรค์ในอนาคต FL Alliance: เป็นไคลเอนต์การเรียนรู้แบบรวมของ Flock ซึ่งสนับสนุนผู้เข้าร่วมในการปรับแต่งแบบจำลองเพิ่มเติมโดยใช้ข้อมูลส่วนตัว ผ่านกลไกการเลือก VRF การเดิมพันและการตัด ทำให้แน่ใจถึงความซื่อสัตย์และประสิทธิภาพการทำงานร่วมกันของกระบวนการฝึกอบรม และเป็นลิงก์สำคัญระหว่างการฝึกอบรมเบื้องต้นของชุมชนและการนำไปใช้จริง AI Marketplace: เป็นแพลตฟอร์มการสร้างและปรับใช้แบบจำลองร่วมกัน ผู้ใช้สามารถเสนอแบบจำลอง นำเสนอข้อมูล และเรียกใช้บริการแบบจำลองได้ รองรับการเข้าถึงฐานข้อมูลและการใช้เหตุผล RAG ที่ปรับปรุงใหม่ และส่งเสริมการนำไปใช้และการหมุนเวียนของแบบจำลอง AI ในสถานการณ์จริงต่างๆ เมื่อเทียบกับโครงการฝึกอบรมแบบกระจายอำนาจ ระบบที่ใช้การเรียนรู้แบบรวมศูนย์ เช่น Flock มีข้อได้เปรียบมากกว่าในด้านประสิทธิภาพการฝึกอบรม ความสามารถในการปรับขนาด และการปกป้องความเป็นส่วนตัว โดยเฉพาะอย่างยิ่งสำหรับการฝึกอบรมแบบร่วมมือกันของแบบจำลองขนาดเล็กและขนาดกลาง โซลูชันนี้ใช้งานได้จริงและง่ายต่อการนำไปใช้ และมีแนวโน้มที่จะเพิ่มประสิทธิภาพความเป็นไปได้ในระดับวิศวกรรมมากกว่า ในขณะที่โครงการต่างๆ เช่น Gensyn และ Pluralis มุ่งเป้าไปที่การพัฒนาเชิงทฤษฎีที่ลึกซึ้งยิ่งขึ้นในวิธีการฝึกอบรมและกลไกการสื่อสาร ความท้าทายของระบบนั้นยิ่งใหญ่กว่า แต่ยังใกล้เคียงกับการสำรวจรูปแบบการฝึกอบรม "ไร้ความน่าเชื่อถือและกระจายอำนาจ" อย่างแท้จริงอีกด้วย EXO เป็นโครงการ AI ที่เป็นตัวแทนอย่างมากในสถานการณ์การประมวลผลแบบเอจในปัจจุบัน ซึ่งอุทิศให้กับการฝึกอบรม AI แบบเบา การให้เหตุผล และแอปพลิเคชันเอเจนต์บนอุปกรณ์ผู้บริโภคระดับบ้าน เส้นทางการฝึกอบรมแบบกระจายอำนาจเน้นที่ "ค่าใช้จ่ายการสื่อสารต่ำ + การดำเนินการอัตโนมัติในพื้นที่" โดยใช้อัลกอริทึมการซิงโครไนซ์แบบหน่วงเวลาอะซิงโครนัสของ DiLoCo และกลไกการแลกเปลี่ยนพารามิเตอร์แบบเบาบางของ SPARTA เพื่อลดความต้องการแบนด์วิดท์อย่างมากสำหรับการฝึกอบรมแบบร่วมมือกันของอุปกรณ์หลายเครื่อง ในระดับระบบ EXO ไม่ได้สร้างเครือข่ายออนเชนหรือแนะนำกลไกจูงใจทางเศรษฐกิจ แต่เปิดตัวกรอบงานการจำลองกระบวนการหลายเครื่องเครื่องเดียว EXO Gym ซึ่งรองรับนักวิจัยในการตรวจสอบและทดลองใช้เมธอดการฝึกอบรมแบบกระจายอย่างรวดเร็วในสภาพแวดล้อมในพื้นที่ · การฝึกแบบอะซิงโครนัสของ DiLoCo: การซิงโครไนซ์โหนดจะดำเนินการทุก ๆ H ขั้นตอนเพื่อปรับให้เข้ากับเครือข่ายที่ไม่เสถียร; · การซิงโครไนซ์แบบเบาบางของ SPARTA: มีการแลกเปลี่ยนพารามิเตอร์เพียงเล็กน้อยเท่านั้น (เช่น 0.1%) ในแต่ละขั้นตอนเพื่อรักษาความเกี่ยวข้องของโมเดลและลดความต้องการแบนด์วิดท์; · การเพิ่มประสิทธิภาพการผสมผสานแบบอะซิงโครนัส: ทั้งสองอย่างสามารถใช้ร่วมกันเพื่อให้เกิดการประนีประนอมที่ดีขึ้นระหว่างการสื่อสารและประสิทธิภาพการทำงาน การสำรวจกลไกการตรวจสอบ evML: Edge-Verified Machine Learning (evML) เสนอการใช้ TEE/Secure Context สำหรับการตรวจสอบการคำนวณต้นทุนต่ำ และทำให้สามารถมีส่วนร่วมที่เชื่อถือได้ของอุปกรณ์ edge โดยไม่ต้องจำนำผ่านการตรวจสอบระยะไกล + กลไกการตรวจสอบแบบสุ่ม ซึ่งเป็นการประนีประนอมทางวิศวกรรมระหว่างความปลอดภัยทางเศรษฐกิจและการปกป้องความเป็นส่วนตัว · EXO Gym: สามารถจำลองสภาพแวดล้อมการฝึกอบรมแบบหลายโหนดบนอุปกรณ์เดียวและรองรับการทดลองกลยุทธ์การสื่อสารสำหรับโมเดลเช่น NanoGPT, CNN และ Diffusion; · แอปเดสก์ท็อป EXO: เครื่องมือ AI บนเดสก์ท็อปสำหรับผู้ใช้แต่ละราย รองรับคุณสมบัติส่วนบุคคลที่เป็นมิตรต่อความเป็นส่วนตัว เช่น การทำงานของโมเดลขนาดใหญ่ในพื้นที่ การควบคุมมิเรอร์ iPhone และการรวมบริบทส่วนตัว (เช่น SMS ปฏิทิน และการบันทึกวิดีโอ) EXO Gym เป็นเหมือนโครงการทดลองการฝึกอบรมแบบกระจายอำนาจที่เน้นการสำรวจ ซึ่งส่วนใหญ่รวมเทคโนโลยีการบีบอัดการสื่อสารที่มีอยู่ (เช่น DiLoCo และ SPARTA) เพื่อให้ได้เส้นทางการฝึกอบรมที่เบากว่า เมื่อเปรียบเทียบกับโครงการเช่น Gensyn, Nous และ Pluralis แล้ว EXO ยังไม่ได้เข้าสู่ขั้นตอนหลักของการทำงานร่วมกันบนเชน กลไกแรงจูงใจที่ตรวจสอบได้ หรือการปรับใช้เครือข่ายแบบกระจายจริง เมื่อเผชิญกับความท้าทายหลักๆ เช่น ความหลากหลายของอุปกรณ์ คอขวดการสื่อสาร ความยากลำบากในการประสานงาน และการขาดการดำเนินการที่เชื่อถือได้ ซึ่งมักเกิดขึ้นในการฝึกอบรมแบบกระจายอำนาจ Gensyn, Prime Intellect, Pluralis และ Nous Research ได้เสนอเส้นทางสถาปัตยกรรมระบบที่แตกต่างกัน จากมุมมองของวิธีการฝึกอบรมและกลไกการสื่อสาร โครงการทั้งสี่นี้ได้แสดงให้เห็นถึงการมุ่งเน้นทางเทคนิคที่เป็นเอกลักษณ์และตรรกะการใช้งานทางวิศวกรรม ในแง่ของการปรับปรุงวิธีการฝึกอบรม มิติหลักทั้งสี่ที่สำรวจแล้ว เช่น กลยุทธ์การทำงานร่วมกัน กลไกการอัปเดต และการควบคุมแบบอะซิงโครนัส ครอบคลุมขั้นตอนต่างๆ ตั้งแต่ก่อนการฝึกอบรมจนถึงหลังการฝึกอบรม PRIME-RL ของ Prime Intellect เป็นโครงสร้างการจัดตารางเวลาแบบอะซิงโครนัสสำหรับขั้นตอนก่อนการฝึกอบรม ผ่านกลยุทธ์ "การฝึกอบรมในพื้นที่ + การซิงโครไนซ์เป็นระยะ" วิธีนี้ใช้กลไกการจัดตารางเวลาการฝึกอบรมที่มีประสิทธิภาพและตรวจสอบได้ในสภาพแวดล้อมที่หลากหลาย วิธีนี้มีความยืดหยุ่นและคล่องตัวสูง มีนวัตกรรมทางทฤษฎีในระดับสูง และเสนอแนวคิดที่ชัดเจนสำหรับโครงสร้างการควบคุมการฝึกอบรม ความยากในการนำไปใช้ทางวิศวกรรมอยู่ในระดับปานกลางถึงสูง และมีความต้องการสูงสำหรับโมดูลการสื่อสารและการควบคุมพื้นฐาน ตัวเพิ่มประสิทธิภาพ DeMo ที่เปิดตัวโดย Nous Research มุ่งเน้นไปที่ปัญหาความเสถียรของการฝึกอบรมในสภาพแวดล้อมแบนด์วิดท์ต่ำแบบอะซิงโครนัส และสร้างกระบวนการอัปเดตการไล่ระดับที่ทนต่อความผิดพลาดสูงภายใต้เงื่อนไข GPU ที่ไม่เหมือนกัน เป็นหนึ่งในโซลูชันไม่กี่ตัวที่บรรลุความเป็นหนึ่งเดียวในเชิงทฤษฎีและวิศวกรรมใน "วงจรปิดการบีบอัดการสื่อสารแบบอะซิงโครนัส" นวัตกรรมเชิงทฤษฎีนั้นสูงมาก โดยเฉพาะอย่างยิ่งในเส้นทางการทำงานร่วมกันในการบีบอัดและกำหนดเวลา การนำวิศวกรรมไปใช้ยังยากมาก โดยเฉพาะอย่างยิ่งการพึ่งพาความแม่นยำในการประสานงานของการทำงานคู่ขนานแบบอะซิงโครนัส SWARM + NAG ของ Pluralis เป็นหนึ่งในดีไซน์ที่เป็นระบบและล้ำสมัยที่สุดในเส้นทางการฝึกอบรมแบบอะซิงโครนัสปัจจุบัน โดยอิงตามกรอบงานขนานของแบบจำลองอะซิงโครนัส แนะนำการสื่อสารแบบเบาบางในพื้นที่คอลัมน์และการแก้ไขโมเมนตัม NAG และสร้างโซลูชันการฝึกอบรมแบบจำลองขนาดใหญ่ที่สามารถบรรจบกันได้อย่างเสถียรภายใต้เงื่อนไขแบนด์วิดท์ต่ำ นวัตกรรมเชิงทฤษฎีนั้นสูงมาก และเป็นผู้บุกเบิกโครงสร้างของการฝึกอบรมแบบร่วมมือกันแบบอะซิงโครนัส ความยากของวิศวกรรมนั้นสูงมากเช่นกัน ซึ่งต้องใช้การบูรณาการอย่างลึกซึ้งของการซิงโครไนซ์หลายระดับและการแบ่งส่วนแบบจำลอง RL Swarm ของ Gensyn ทำหน้าที่หลักในระยะหลังการฝึกอบรม โดยเน้นที่การปรับแต่งกลยุทธ์และการเรียนรู้การทำงานร่วมกันของตัวแทน กระบวนการฝึกอบรมนั้นปฏิบัติตามกระบวนการสามขั้นตอนของ "การสร้าง-การประเมิน-การลงคะแนน" ซึ่งเหมาะเป็นพิเศษสำหรับการปรับพฤติกรรมที่ซับซ้อนแบบไดนามิกในระบบตัวแทนหลายตัว นวัตกรรมทางทฤษฎีอยู่ในระดับปานกลางถึงสูง ซึ่งสะท้อนให้เห็นส่วนใหญ่ในตรรกะการทำงานร่วมกันของตัวแทน ความยากของการนำวิศวกรรมไปใช้อยู่ในระดับปานกลาง และความท้าทายหลักอยู่ที่การจัดตารางเวลาของระบบและการควบคุมการบรรจบกันของพฤติกรรม ในแง่ของการเพิ่มประสิทธิภาพกลไกการสื่อสาร โปรเจ็กต์ทั้งสี่นี้ยังมีเลย์เอาต์ที่กำหนดเป้าหมาย และโดยทั่วไปมุ่งเน้นไปที่โซลูชันที่เป็นระบบสำหรับคอขวดแบนด์วิดท์ ความไม่เหมือนกันของโหนด และปัญหาความเสถียรของการจัดตารางเวลา PCCL ของ Prime Intellect เป็นไลบรารีการสื่อสารระดับต่ำที่ใช้แทน NCCL แบบดั้งเดิม โดยมุ่งหวังที่จะมอบรากฐานการสื่อสารแบบรวมที่แข็งแกร่งยิ่งขึ้นสำหรับโปรโตคอลการฝึกอบรมระดับบน นวัตกรรมทางทฤษฎีอยู่ในระดับปานกลางถึงสูง โดยมีความก้าวหน้าบางประการในอัลกอริทึมการสื่อสารที่ทนต่อความผิดพลาด ความยากทางวิศวกรรมอยู่ในระดับปานกลาง โดยมีความสามารถในการปรับตัวของโมดูลที่แข็งแกร่ง DisTrO ของ Nous Research เป็นโมดูลการสื่อสารหลักของ DeMo ซึ่งเน้นย้ำถึงค่าใช้จ่ายด้านการสื่อสารขั้นต่ำภายใต้แบนด์วิดท์ต่ำในขณะที่ยังคงความต่อเนื่องของวงจรปิดการฝึกอบรม มีนวัตกรรมทางทฤษฎีสูงและมีคุณค่าด้านการออกแบบสากลในการกำหนดตารางเวลาและโครงสร้างการประสานงาน มีความยากทางวิศวกรรมสูงและข้อกำหนดสูงสำหรับความแม่นยำในการบีบอัดและการซิงโครไนซ์การฝึกอบรม กลไกการสื่อสารของ Pluralis ฝังลึกอยู่ในสถาปัตยกรรม SWARM ซึ่งช่วยลดภาระการสื่อสารในการฝึกอบรมแบบอะซิงโครนัสของโมเดลขนาดใหญ่ได้อย่างมาก โดยรักษาปริมาณงานที่มีประสิทธิภาพในขณะที่รับรองการบรรจบกัน โซลูชันนี้มีนวัตกรรมทางทฤษฎีขั้นสูงและกำหนดกรอบแนวคิดสำหรับการออกแบบการสื่อสารแบบจำลองแบบอะซิงโครนัส มีระดับความยากทางวิศวกรรมสูงมากและต้องอาศัยการประสานแบบจำลองแบบกระจายและการควบคุมความเบาบางของโครงสร้าง SkipPipe ของ Gensyn เป็นส่วนประกอบการจัดตารางเวลาที่ทนทานต่อความผิดพลาดสำหรับ RL Swarm โซลูชันนี้มีต้นทุนการใช้งานต่ำและใช้เป็นหลักเพื่อเพิ่มเสถียรภาพในการฝึกอบรมที่เลเยอร์การลงจอดทางวิศวกรรม โซลูชันนี้มีนวัตกรรมทางทฤษฎีระดับปานกลางและเป็นการนำไปใช้งานทางวิศวกรรมของกลไกที่ทราบอยู่แล้วมากกว่า โซลูชันนี้มีระดับความยากทางวิศวกรรมต่ำ แต่ใช้งานได้จริงอย่างมากในการใช้งานจริง นอกจากนี้ เรายังสามารถวัดมูลค่าของโครงการฝึกอบรมแบบกระจายอำนาจจากหมวดหมู่มหภาคอีกสองหมวดหมู่ ได้แก่ เลเยอร์ความร่วมมือของบล็อคเชนและเลเยอร์การฝึกอบรม AI: · เลเยอร์ความร่วมมือของบล็อคเชน:เน้นที่ความน่าเชื่อถือของโปรโตคอลและตรรกะความร่วมมือที่เป็นแรงจูงใจ · ความสามารถในการตรวจสอบ: สร้างความไว้วางใจว่ากระบวนการฝึกอบรมนั้นสามารถตรวจสอบได้หรือไม่ และมีการนำกลไกการเล่นเกมหรือการเข้ารหัสเข้ามาใช้หรือไม่ · กลไกการสร้างแรงจูงใจ: มีการออกแบบกลไกการให้รางวัลโทเค็น/บทบาทที่ขับเคลื่อนด้วยงานหรือไม่ · เกณฑ์ความเปิดกว้างและการเข้า: โหนดนั้นเข้าถึงได้ง่ายหรือไม่ และเป็นแบบรวมศูนย์หรือควบคุมด้วยการอนุญาตหรือไม่ · ระดับระบบการฝึกอบรม AI:เน้นความสามารถด้านวิศวกรรมและการเข้าถึงประสิทธิภาพ · กลไกการกำหนดตารางเวลาและการทนต่อความผิดพลาด:มีการทนต่อความผิดพลาด อะซิงโครนัส แบบไดนามิก และการกำหนดตารางเวลาแบบกระจายหรือไม่; · การเพิ่มประสิทธิภาพวิธีการฝึกอบรม:อัลกอริทึมหรือโครงสร้างการฝึกอบรมของแบบจำลองได้รับการเพิ่มประสิทธิภาพหรือไม่; · การเพิ่มประสิทธิภาพเส้นทางการสื่อสาร:ไม่ว่าการไล่ระดับจะถูกบีบอัดหรือกระจายการสื่อสารจะพร้อมใช้งานเพื่อปรับให้เข้ากับแบนด์วิดท์ต่ำหรือไม่ ตารางต่อไปนี้ประเมินเชิงลึกทางเทคนิค ความสมบูรณ์ทางวิศวกรรม และนวัตกรรมทางทฤษฎีของ Gensyn, Prime Intellect, Pluralis และ Nous Research บนเส้นทางการฝึกอบรมแบบกระจายอำนาจโดยอิงจากระบบตัวบ่งชี้ข้างต้นอย่างเป็นระบบ ในห่วงโซ่คุณค่าที่สมบูรณ์ของการฝึกอบรมแบบกระจายอำนาจ โปรเจ็กต์ต่างๆ เช่น Prime Intellect, Pluralis.ai, Gensyn และ Nous Research มุ่งเน้นไปที่การสร้างโครงสร้างพื้นฐานด้านหน้า เช่น การฝึกอบรมแบบจำลองก่อน กลไกการสื่อสาร และการเพิ่มประสิทธิภาพการทำงานร่วมกัน อย่างไรก็ตาม โปรเจ็กต์ประเภทอื่นมุ่งเน้นไปที่การปรับแต่งแบบจำลองและการปรับใช้การอนุมานในขั้นตอนหลังการฝึกอบรม (การปรับแต่งและการส่งมอบการอนุมานหลังการฝึกอบรม) และไม่ได้มีส่วนร่วมโดยตรงในกระบวนการฝึกอบรมอย่างเป็นระบบ เช่น การฝึกอบรมก่อน การซิงโครไนซ์พารามิเตอร์ หรือการเพิ่มประสิทธิภาพการสื่อสาร โปรเจ็กต์ตัวแทน ได้แก่ Bagel, Pond และ RPS Labs ซึ่งทั้งหมดนี้มีพื้นฐานมาจากวิธีการปรับแต่ง LoRA และประกอบเป็นลิงก์ "หลังห่วงโซ่" ที่สำคัญในแผนที่นิเวศวิทยาการฝึกอบรมแบบกระจายอำนาจ LoRA (Low-Rank Adaptation) เป็นวิธีปรับแต่งพารามิเตอร์ที่มีประสิทธิภาพ แนวคิดหลักคือการแทรกเมทริกซ์อันดับต่ำลงในโมเดลขนาดใหญ่ที่ผ่านการฝึกอบรมล่วงหน้าเพื่อเรียนรู้ภารกิจใหม่ในขณะที่ตรึงพารามิเตอร์ของโมเดลดั้งเดิม กลยุทธ์นี้ช่วยลดต้นทุนการฝึกอบรมและการใช้ทรัพยากรได้อย่างมาก ปรับปรุงความเร็วในการปรับแต่งและความยืดหยุ่นในการปรับใช้ และเหมาะเป็นพิเศษสำหรับสถานการณ์ Web3 ที่โดดเด่นด้วยการสร้างโมดูลและการเรียกแบบผสมผสาน โมเดลภาษาขนาดใหญ่แบบดั้งเดิม เช่น LLaMA และ GPT-3 มักมีพารามิเตอร์เป็นพันล้านหรือแม้แต่หลายร้อยล้านตัว และการปรับแต่งโดยตรงนั้นมีราคาแพง LoRA สามารถปรับโมเดลขนาดใหญ่ให้เหมาะสมได้อย่างมีประสิทธิภาพโดยฝึกเมทริกซ์พารามิเตอร์ที่แทรกเข้าไปเพียงเล็กน้อยเท่านั้น ซึ่งกลายเป็นหนึ่งในวิธีการกระแสหลักที่ใช้งานได้จริงที่สุดในปัจจุบัน Direct Preference Optimization (DPO) ซึ่งเป็นวิธีการหลังการฝึกอบรมสำหรับโมเดลภาษาที่เกิดขึ้นในช่วงไม่กี่ปีที่ผ่านมา มักใช้ร่วมกับกลไกการปรับแต่ง LoRA สำหรับขั้นตอนการจัดตำแหน่งพฤติกรรมของโมเดล เมื่อเปรียบเทียบกับวิธี RLHF (การเรียนรู้เสริมแรงจากข้อเสนอแนะของมนุษย์) แบบดั้งเดิม DPO จะประสบความสำเร็จในการเรียนรู้การตั้งค่าโดยการปรับตัวอย่างแบบจับคู่โดยตรง ขจัดการสร้างแบบจำลองรางวัลและกระบวนการเรียนรู้การเสริมแรงที่ซับซ้อน DPO มีโครงสร้างที่เรียบง่ายกว่าและการบรรจบกันที่เสถียรกว่า ซึ่งเหมาะเป็นพิเศษสำหรับงานปรับแต่งอย่างละเอียดในสภาพแวดล้อมที่มีน้ำหนักเบาและมีทรัพยากรจำกัด เนื่องจากมีประสิทธิภาพสูงและใช้งานง่าย DPO จึงค่อยๆ กลายเป็นโซลูชันที่ต้องการสำหรับโครงการ AI แบบกระจายอำนาจจำนวนมากในขั้นตอนการจัดตำแหน่งโมเดล จากมุมมองระยะยาว โครงการต่างๆ จำนวนมากขึ้นเรื่อยๆ ถือว่าการเรียนรู้เสริมแรง (RL) เป็นเส้นทางหลักที่มีความสามารถในการปรับตัวและศักยภาพในการวิวัฒนาการมากขึ้นในการฝึกอบรมแบบกระจายอำนาจ เมื่อเปรียบเทียบกับการเรียนรู้ภายใต้การดูแลหรือกลไกการปรับแต่งพารามิเตอร์ที่อาศัยข้อมูลคงที่ RL จะเน้นที่การปรับปรุงกลยุทธ์อย่างต่อเนื่องในสภาพแวดล้อมแบบไดนามิก ซึ่งเหมาะกับรูปแบบการทำงานร่วมกันแบบไม่พร้อมกัน ไม่เหมือนกัน และขับเคลื่อนด้วยแรงจูงใจในเครือข่าย Web3 โดยการโต้ตอบอย่างต่อเนื่องกับสภาพแวดล้อม RL สามารถบรรลุกระบวนการเรียนรู้แบบเพิ่มขึ้นอย่างต่อเนื่องและปรับแต่งได้สูง โดยให้โครงสร้างพื้นฐาน "ปัญญาเชิงพฤติกรรม" ที่ปรับเปลี่ยนได้สำหรับการสร้างเครือข่ายตัวแทน ตลาดงานบนเชน และเศรษฐกิจอัจฉริยะ รูปแบบนี้ไม่เพียงแต่สอดคล้องกับแนวคิดของการกระจายอำนาจเท่านั้น แต่ยังมีข้อได้เปรียบของระบบที่สำคัญอีกด้วย อย่างไรก็ตาม เนื่องจากขีดจำกัดทางวิศวกรรมที่สูงและกลไกการกำหนดตารางเวลาที่ซับซ้อน RL จึงยังคงเผชิญกับความท้าทายที่ยิ่งใหญ่ในการนำไปใช้ในขั้นตอนปัจจุบัน และเป็นการยากที่จะส่งเสริมให้แพร่หลายในระยะสั้น สิ่งที่น่าสังเกตก็คือ PRIME-RL ของ Prime Intellect และ RL Swarm ของ Gensyn กำลังส่งเสริมวิวัฒนาการของ RL จากกลไกปรับแต่งหลังการฝึกอบรมไปเป็นโครงสร้างหลักก่อนการฝึกอบรม โดยพยายามสร้างระบบการฝึกอบรมแบบร่วมมือกันที่ปราศจากความไว้วางใจและเน้นที่ RL Bagel มีพื้นฐานมาจากกลไกการปรับแต่งละเอียด LoRA และนำเทคโนโลยีการพิสูจน์ความรู้เป็นศูนย์ (ZK) มาใช้เพื่อแก้ปัญหาความน่าเชื่อถือและการปกป้องความเป็นส่วนตัวในกระบวนการ "การปรับแต่งละเอียดของแบบจำลองบนเชน" zkLoRA ไม่ได้มีส่วนร่วมในการคำนวณการฝึกจริง แต่ให้กลไกน้ำหนักเบาและตรวจสอบได้ซึ่งอนุญาตให้ผู้ใช้ภายนอกยืนยันได้ว่าแบบจำลองที่ปรับแต่งละเอียดนั้นได้มาจากแบบจำลองฐานที่ระบุและพารามิเตอร์ LoRA โดยไม่ต้องเข้าถึงข้อมูลหรือน้ำหนักเดิม ไม่เหมือนกับ Verde ของ Gensyn หรือ TOPLOC ของ Prime Intellect ซึ่งมุ่งเน้นไปที่การตรวจสอบแบบไดนามิกว่า "พฤติกรรมนั้นเกิดขึ้นจริงหรือไม่" ระหว่างกระบวนการฝึก Bagel มุ่งเน้นไปที่การตรวจสอบแบบคงที่ว่า "ผลการปรับแต่งละเอียดมีความน่าเชื่อถือหรือไม่" มากกว่า ข้อได้เปรียบที่ใหญ่ที่สุดของ zkLoRA คือการใช้ทรัพยากรการตรวจสอบต่ำและมีการปกป้องความเป็นส่วนตัวที่แข็งแกร่ง แต่ขอบเขตการใช้งานของ zkLoRA มักจะจำกัดอยู่ที่การปรับแต่งงานที่มีการเปลี่ยนแปลงพารามิเตอร์เพียงเล็กน้อย Pond เป็นโครงการฝึกอบรมแบบกระจายอำนาจเพียงโครงการเดียวในอุตสาหกรรมที่เน้นการปรับแต่งเครือข่ายประสาทเทียมแบบกราฟ (GNN) อย่างละเอียด ซึ่งให้บริการแอปพลิเคชันข้อมูลที่มีโครงสร้าง เช่น กราฟความรู้ เครือข่ายสังคม และกราฟธุรกรรม นอกจากนี้ยังสนับสนุนให้ผู้ใช้สามารถอัปโหลดข้อมูลโครงสร้างกราฟและมีส่วนร่วมในการตอบรับการฝึกอบรมโมเดล โดยให้แพลตฟอร์มการฝึกอบรมและการใช้เหตุผลที่น้ำหนักเบาและควบคุมได้สำหรับงานส่วนบุคคล Pond ยังใช้กลไกการปรับแต่งที่มีประสิทธิภาพ เช่น LoRA เป้าหมายหลักคือการสร้างระบบตัวแทนแบบแยกส่วนและปรับใช้ได้บนสถาปัตยกรรม GNN ซึ่งจะเปิดเส้นทางการสำรวจใหม่ของ "การปรับแต่งโมเดลขนาดเล็ก + การทำงานร่วมกันของตัวแทนหลายตัว" ในบริบทแบบกระจายอำนาจ RPS Labs เป็นโครงการฝึกอบรมแบบกระจายอำนาจที่ใช้สถาปัตยกรรม Transformer ซึ่งมุ่งเน้นที่การใช้โมเดล AI ที่ปรับแต่งอย่างละเอียดสำหรับการจัดการสภาพคล่อง DeFi โดยใช้งานส่วนใหญ่ในระบบนิเวศ Solana ผลิตภัณฑ์เรือธง UltraLiquid เป็นกลไกการสร้างตลาดแบบแอ็คทีฟที่ใช้โมเดลที่ปรับแต่งอย่างละเอียดเพื่อปรับพารามิเตอร์สภาพคล่องแบบไดนามิก ลดความคลาดเคลื่อน เพิ่มความลึก และเพิ่มประสิทธิภาพการออกโทเค็นและประสบการณ์การซื้อขาย นอกจากนี้ RPS ยังได้เปิดตัวเครื่องมือ UltraLP เพื่อสนับสนุนผู้ให้บริการสภาพคล่องเพื่อเพิ่มประสิทธิภาพกลยุทธ์การจัดสรรเงินทุนบน DEX แบบเรียลไทม์ จึงปรับปรุงประสิทธิภาพของเงินทุนและลดความเสี่ยงของการสูญเสียชั่วคราว ซึ่งสะท้อนถึงคุณค่าในทางปฏิบัติของการปรับแต่ง AI ในสถานการณ์ทางการเงิน ในแผนที่นิเวศน์ที่สมบูรณ์ของการฝึกอบรมแบบกระจายอำนาจ ทั้งหมดสามารถแบ่งออกได้เป็นสองประเภท: เอ็นจิ้นฟรอนต์เชนสอดคล้องกับขั้นตอนการฝึกโมเดลเบื้องต้น และนิเวศน์แบ็คเชนสอดคล้องกับการปรับแต่งโมเดลเบื้องต้นและการปรับใช้ ซึ่งก่อให้เกิดวงจรปิดที่สมบูรณ์ตั้งแต่โครงสร้างพื้นฐานจนถึงการลงจอดของแอปพลิเคชัน เอ็นจิ้นฟรอนต์เชนมุ่งเน้นไปที่การสร้างโปรโตคอลพื้นฐานสำหรับการฝึกโมเดลเบื้องต้น ซึ่งแสดงโดยโครงการต่างๆ เช่น Prime Intellect, Nous Research, Pluralis.ai และ Gensyn พวกเขามุ่งมั่นที่จะสร้างสถาปัตยกรรมระบบที่มีการอัปเดตแบบอะซิงโครนัส การสื่อสารแบบเบาบาง และการตรวจสอบการฝึกอบรม รวมถึงการตระหนักถึงความสามารถในการฝึกอบรมแบบกระจายที่มีประสิทธิภาพและเชื่อถือได้ในสภาพแวดล้อมเครือข่ายที่ไม่ไว้วางใจ ซึ่งสร้างรากฐานทางเทคนิคของการฝึกอบรมแบบกระจายอำนาจ ในเวลาเดียวกัน Flock ในฐานะตัวแทนของเลเยอร์กลาง ผ่านเส้นทางการเรียนรู้แบบรวมศูนย์ จะบูรณาการการรวมโมเดล การตรวจสอบบนเชน และแรงจูงใจจากหลายฝ่าย และสร้างสะพานเชื่อมที่เป็นไปได้และร่วมมือกันระหว่างการฝึกอบรมและการปรับใช้ โดยให้รูปแบบที่ใช้งานได้จริงสำหรับการเรียนรู้แบบร่วมมือกันหลายโหนด ระบบนิเวศหลังเชนมุ่งเน้นไปที่การปรับแต่งโมเดลและการปรับใช้ในเลเยอร์แอปพลิเคชัน โครงการต่างๆ เช่น Pond, Bagel และ RPS Labs เกี่ยวข้องกับวิธีการปรับแต่ง LoRA: Bagel มอบกลไกการตรวจสอบที่เชื่อถือได้บนเชน Pond มุ่งเน้นไปที่วิวัฒนาการของโมเดลขนาดเล็กของเครือข่ายประสาทกราฟ และ RPS นำโมเดลการปรับแต่งไปใช้กับการสร้างตลาดอัจฉริยะในสถานการณ์ DeFi พวกเขาให้การเรียกใช้โมเดลที่ประกอบได้และโซลูชันการปรับแต่งส่วนบุคคลแก่ผู้พัฒนาและผู้ใช้ปลายทางผ่านส่วนประกอบต่างๆ เช่น API การให้เหตุผลและ SDK ของตัวแทน และเป็นจุดเข้าที่สำคัญสำหรับการนำ AI แบบกระจายอำนาจมาใช้ เราเชื่อว่าการฝึกอบรมแบบกระจายอำนาจไม่เพียงแต่เป็นการขยายจิตวิญญาณของบล็อคเชนในยุค AI เท่านั้น แต่ยังเป็นต้นแบบของโครงสร้างพื้นฐานของระบบผลิตภาพอัจฉริยะที่ทำงานร่วมกันทั่วโลกอีกด้วย ในอนาคต เมื่อเรามองย้อนกลับไปที่การเดินทางที่ท้าทายนี้ข้างหน้า เรายังคงให้กำลังใจซึ่งกันและกันด้วยเจตนาเดิม: การกระจายอำนาจไม่ใช่แค่เพียงวิธีการ แต่เป็นคุณค่าในตัวมันเอง ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats: กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia04 Testnet และการวางแผนแผนงาน
Nous Research: ระบบฝึกอบรมวิวัฒนาการทางปัญญาที่ขับเคลื่อนด้วยแนวคิดของ AI เชิงอัตวิสัย
01 การสนับสนุนแนวคิด: กำหนด "จุดประสงค์" ของการฝึกอบรมใหม่
02 หลักการฝึกอบรม: เครือข่าย Psyche และ DisTrO Optimizer
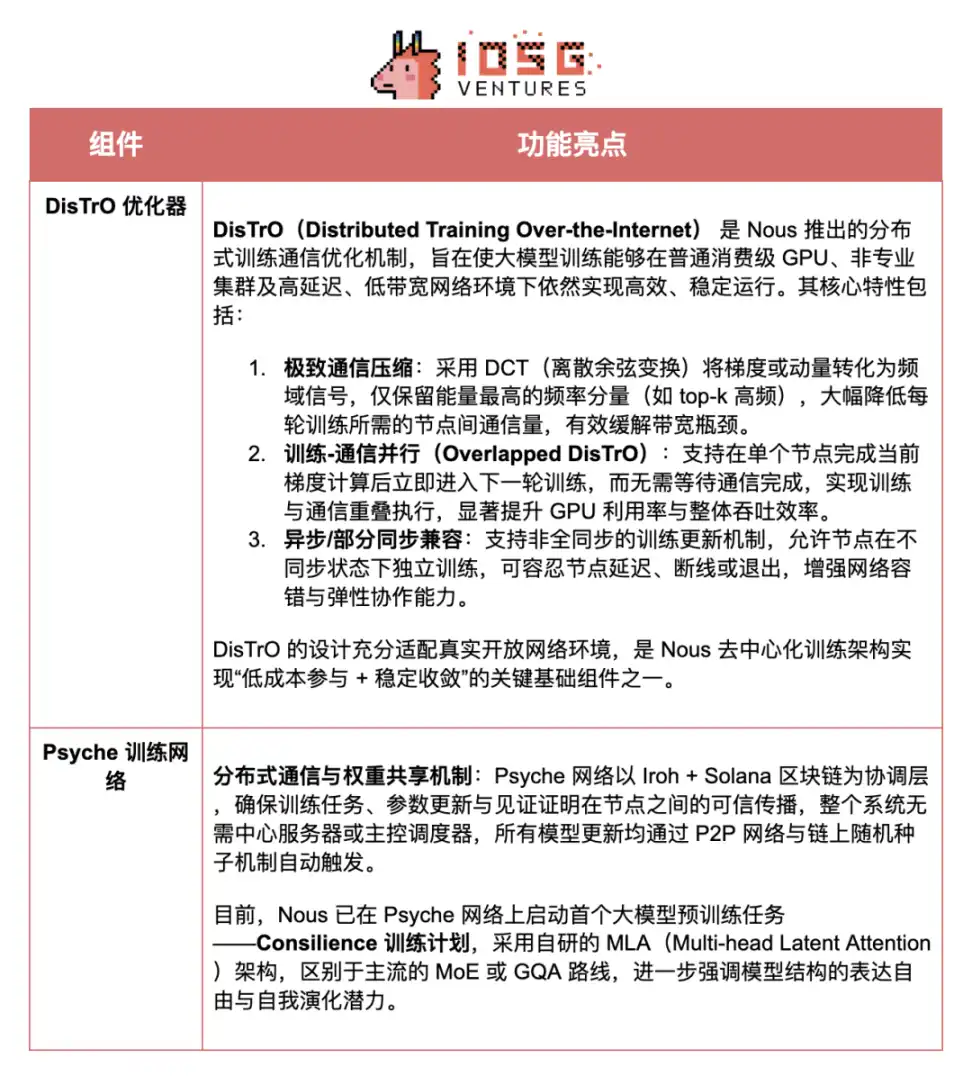
03 Hermes / Forge / TEE_HEE ประกอบด้วยระบบการใช้เหตุผลและตัวแทน
Flock: เครือข่ายการเรียนรู้แบบรวมศูนย์ที่ปรับปรุงด้วยบล็อคเชน
01กลไกหลักของ Flock.io
02ส่วนประกอบผลิตภัณฑ์หลักของ Flock
EXO: ความพยายามในการฝึกอบรมแบบกระจายอำนาจสำหรับการประมวลผลแบบเอจ
01 ภาพรวมกลไกหลัก
02 เครื่องมือและแอปพลิเคชันสถานการณ์
3. เครื่องยนต์พรีเชนสำหรับการฝึกอบรมแบบกระจายอำนาจ: การศึกษาภาพรวมของการฝึกอบรมแบบจำลองล่วงหน้า

IV. นิเวศวิทยาหลังห่วงโซ่ของการฝึกอบรมแบบกระจายอำนาจ: การปรับแต่งแบบจำลองตาม LoRA
LoRA + DPO: เส้นทางที่สมจริงสำหรับการปรับใช้การปรับแต่ง Web3
การเรียนรู้เสริมแรง (RL): วิวัฒนาการในอนาคตของการปรับแต่งอย่างละเอียดหลังการฝึกอบรม
Bagel (zkLoRA): เลเยอร์การตรวจสอบที่เชื่อถือได้สำหรับการปรับแต่งละเอียด LoRA
Pond: แพลตฟอร์มการปรับแต่งและวิวัฒนาการของตัวแทนในสถานการณ์ GNN
RPS Labs: เครื่องมือสภาพคล่องที่ขับเคลื่อนด้วย AI สำหรับ DeFi
V. จากเครื่องยนต์ก่อนโซ่สู่ระบบนิเวศหลังโซ่: หนทางข้างหน้าสำหรับการฝึกอบรมแบบกระจายอำนาจ