รายงานผู้ถือหุ้นล่าสุดของ Anthropic เปิดเผยโมเดลจีนที่ทำรายได้สูงสุดในตลาดองค์กร
ชื่อเรื่องต้นฉบับ: "รายงานล่าสุดของผู้ถือหุ้น Anthropic เผยโมเดลจีนที่ทำรายได้สูงสุดในตลาดองค์กร"
ผู้เขียนต้นฉบับ: 动察Beating
เมื่อวันที่ 3 พฤศจิกายน Menlo Ventures บริษัทร่วมทุนเก่าแก่แห่งซิลิคอนแวลลีย์ได้เผยแพร่ "รายงานสถานะ AI องค์กร" ประจำปีนี้
เพื่อให้เข้าใจว่าองค์กรต่างๆ ใช้จ่ายเงินไปเท่าไรในปีนี้ Menlo ได้มอบหมายให้ Morning Consult สอบถามผู้ตัดสินใจด้าน AI จากบริษัทอเมริกันเกือบ 400 แห่งในเดือนกันยายน ซึ่งผู้คนเหล่านี้ดูแลงบประมาณด้าน AI รวมกันกว่า 4 พันล้านดอลลาร์ ตามการประมาณการของ Menlo จนถึงเดือนกันยายนปีนี้ บริษัทอเมริกันใช้จ่ายเงินไปกับการติดตั้งใช้งาน AI ไปแล้วถึง 176.8 พันล้านดอลลาร์ ซึ่งเป็น 5.4 เท่าของ 33 พันล้านดอลลาร์เมื่อปีที่แล้ว
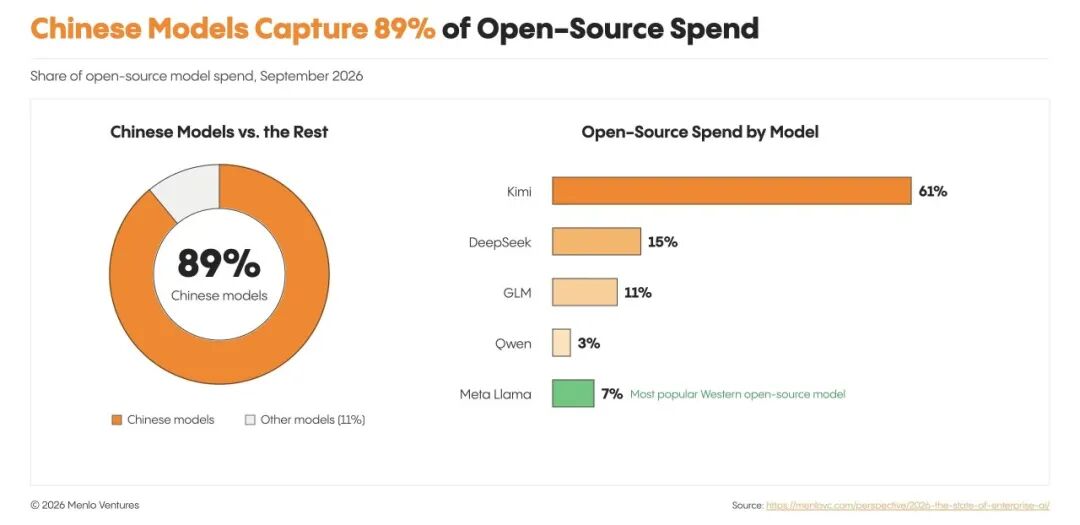
กันยายน 2026 โมเดลจีนคิดเป็น 89% ของค่าใช้จ่ายโมเดลโอเพนซอร์สขององค์กรอเมริกัน
โดย Kimi ครองส่วนแบ่งสูงสุดที่ 61%
ที่มาภาพ: Menlo Ventures
ในรายงานที่เขียนขึ้นสำหรับซิลิคอนแวลลีย์ฉบับนี้ มีตัวเลขชุดหนึ่งระบุว่า ค่าใช้จ่ายในการใช้งานจริงของโมเดลโอเพนซอร์สขององค์กรอเมริกันนั้น โมเดลจีนคิดเป็นเกือบเก้าในสิบ โดย Kimi เพียงเจ้าเดียวครอง 61% ตามมาด้วย DeepSeek 15%, GLM 11% และ Qwen 3% ส่วน Meta Llama ซึ่งเป็นโมเดลโอเพนซอร์สตะวันตกที่อยู่อันดับหนึ่ง มีเพียง 7% เท่านั้น
Menlo Ventures ผู้เขียนรายงาน เป็นผู้ถือหุ้นรายสำคัญของ Anthropic โดยเป็นผู้นำการลงทุนรอบ D มูลค่า 750 ล้านดอลลาร์ในปี 2024
นอกจากนี้ Fireworks AI ซึ่งเป็นคลาวด์ประมวลผลอันดับหนึ่งที่ให้บริการโฮสต์ Kimi บนเซิร์ฟเวอร์ขายให้องค์กรอเมริกัน และเพิ่งมีรายได้ต่อปีทะลุ 1 พันล้านดอลลาร์ในปีนี้ ก็ได้รับการลงทุนจาก Menlo; OpenRouter แพลตฟอร์มจัดเส้นทางโมเดลที่ประมวลผล 160 ล้านล้านโทเค็นต่อสัปดาห์ ก็ได้รับการลงทุนจาก Menlo; Cursor ซึ่งถูกกล่าวถึงเป็นพิเศษในรายงานว่าเทรน Composer 2 บน Kimi K2.5 ก็ได้รับการลงทุนจาก Menlo เช่นกัน
หากดูแค่ข้อมูลในรายงาน คุณอาจคิดว่ายักษ์ใหญ่โมเดลปิดและค่ายโอเพนซอร์สคงต้องห้ำหั่นกันจนถึงที่สุด และโมเดลสองฝั่งมหาสมุทรแปซิฟิกก็ควรแยกกันชัดเจน แต่ผู้ใหญ่ดูผลได้ผลเสีย เด็กเท่านั้นที่แบ่งฝ่าย
นอกจากข้อมูลและผลประโยชน์เหล่านี้แล้ว สิ่งที่ Beating อยากเข้าใจให้ชัดเจนยิ่งขึ้นคือ ทำไม Kimi ถึงกลายเป็นตัวเลือกที่บริษัทอเมริกันยอมจ่ายเงินมากที่สุดรองจากโมเดลปิดระดับเรือธง?
ราคาของการทำงานซ้ำ
หากจะเข้าใจ "61%" ของ Kimi นี้ ต้องเข้าใจก่อนว่าปีนี้บริษัทอเมริกันมีพฤติกรรมแปลกๆ ในการใช้จ่ายด้าน AI คือ ยิ่งโมเดลถูก ยิ่งไม่มีคนใช้
ในช่วงสองปีที่ผ่านมา การตัดสินที่แพร่หลายที่สุดในอุตสาหกรรมคือ ต้นทุนการอนุมานลดลงเก้าสิบเปอร์เซ็นต์ต่อปี และในที่สุดองค์กรก็จะเปลี่ยนเวิร์กโฟลว์ไปใช้โมเดลเล็กที่ถูกกว่า ห้องแล็บต่างๆ ก็ขายโมเดลเล็กถูกลงเรื่อยๆ เช่นกัน
แต่ผลลัพธ์กลับตรงกันข้าม
ตั้งแต่ไตรมาสที่สามของปี 2025 ถึงไตรมาสที่สามของปี 2026 ส่วนแบ่งโทเค็นในตลาดองค์กรของโมเดลปิดขนาดเล็กอย่าง Haiku และ Luna ลดลงจาก 29% เหลือ 13% หายไปกว่าครึ่ง ส่วนเรือธงระดับแนวหน้าที่มีราคาแพงที่สุด ส่วนแบ่งโทเค็นเพิ่มจาก 18% เป็น 42% และส่วนแบ่งการใช้จ่ายเพิ่มจาก 35% เป็น 63%
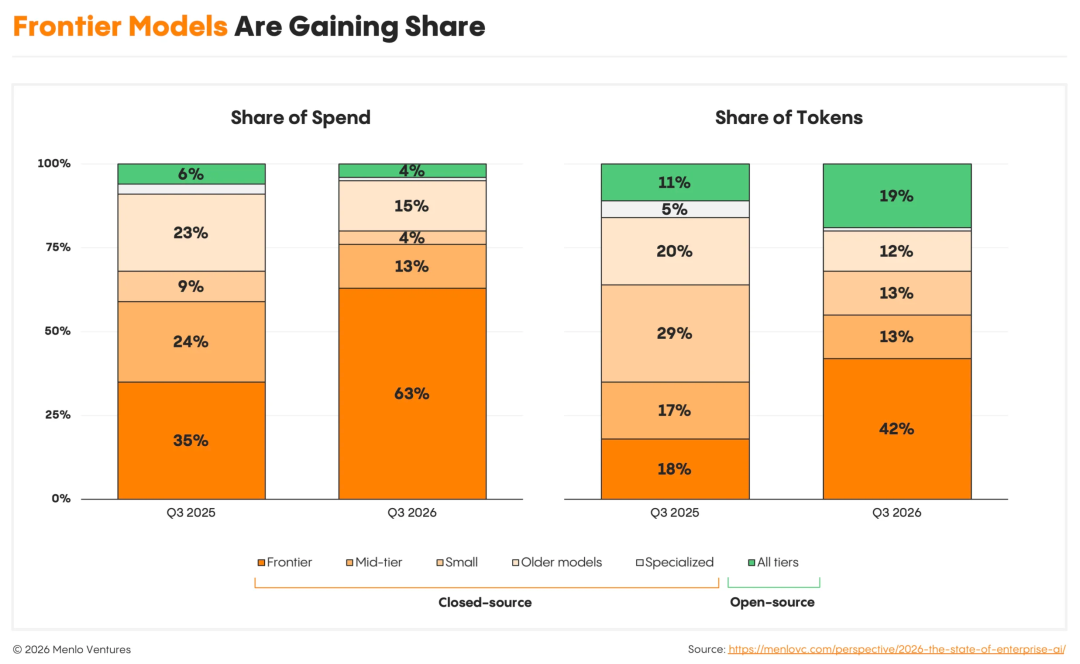
ส่วนแบ่งของโมเดลระดับแนวหน้าในการใช้จ่ายด้าน AI ขององค์กรและการใช้โทเค็นเพิ่มขึ้นพร้อมกัน
ที่มาภาพ: Menlo Ventures
เมื่อปีที่แล้ว โมเดลหลักที่บริษัทอเมริกันใช้มากที่สุดคือ Claude Sonnet 4.5 ที่ราคาอินพุต 3 ดอลลาร์ เอาต์พุต 15 ดอลลาร์ (ต่อล้านโทเค็น เช่นเดียวกันกับด้านล่าง) และ GPT-5 ที่ 1.25 ดอลลาร์ และ 10 ดอลลาร์ แต่พอถึงฤดูใบไม้ร่วงปีนี้ ทุกคนกลับต่อคิวเปลี่ยนไปใช้โมเดลเรือธงที่แพงกว่า
ทำไมบริษัทอเมริกันที่ฉลาดถึงจู่ๆ ก็ไม่สนใจของถูก?
เหตุผลง่ายมาก คนที่ใช้โมเดลทำงานเปลี่ยนจากมนุษย์เป็น Agent
ในเดือนกุมภาพันธ์ปีนี้ ทราฟฟิกที่เกิดจาก Agent บน OpenRouter แซงหน้ามนุษย์อย่างเป็นทางการ พอถึงปลายเดือนกันยายน 80% ของโทเค็นบนแพลตฟอร์มเป็น Agent ที่รันเองอยู่เบื้องหลัง เพิ่มขึ้น 37 เท่าในเวลากว่าครึ่งปี ในการใช้จ่ายแอปพลิเคชัน AI ขององค์กร 77.3 พันล้านดอลลาร์ มี 76% กระจุกอยู่ที่การเขียนโปรแกรมและ Agent องค์กร
การที่ Agent ทำงานกับมนุษย์ใช้ AI ไม่ใช่ตรรกะเดียวกัน
เมื่อ Agent เขียนโปรแกรมรับงาน มักต้องรันต่อเนื่องสี่ห้ารอบระหว่างโค้ดเบส เทอร์มินัล และแซนด์บ็อกซ์: อ่านไฟล์ เรียกเครื่องมือ รันทดสอบ ดูข้อผิดพลาด แล้วแก้โค้ดอีกครั้ง
ในงานที่ต้องทำหลายขั้นตอนต่อเนื่องกัน ต้นทุนของความผิดพลาดจะทบเพิ่มแบบคูณ โมเดลที่มีความแม่นยำต่อขั้น 99% เมื่อรันต่อเนื่อง 50 ขั้น ความน่าจะเป็นที่จะส่งงานได้สำเร็จอยู่ที่ประมาณหกสิบเปอร์เซ็นต์ ถ้าเปลี่ยนเป็นโมเดลที่ความแม่นยำต่อขั้น 95% ความน่าจะเป็นที่จะรัน 50 ขั้นจนจบโดยไม่พลาดอยู่ที่น้อยกว่า 8%
ดังนั้นองค์กรจึงเข้าใจได้อย่างรวดเร็วว่า ตอนนี้การซื้อโมเดลไม่ควรดูแค่ราคาต่อหน่วยบนตารางราคาเท่านั้น แต่ต้องดูค่าใช้จ่ายรวมในการทำสิ่งหนึ่งให้เสร็จในการครั้งเดียวด้วย
เมื่อเข้าใจจุดนี้ สถานการณ์ของโมเดลโอเพนซอร์สในปีนี้ก็เข้าใจได้ง่ายขึ้น
ในปีที่ผ่านมา ส่วนแบ่งโทเคนของโมเดลโอเพนซอร์สเพิ่มจาก 11% เป็น 19% ปริมาณการเรียกใช้เป็น 22.5 เท่าของปีก่อน แต่ส่วนแบ่งรายจ่ายที่ได้รับกลับลดจาก 6% เหลือ 4% สาเหตุคือโมเดลโอเพนซอร์สส่วนใหญ่ถูกดึงเข้าสู่สงครามราคา ราคาต่อหน่วยเฉลี่ยลดลงเหลือไม่ถึงหนึ่งในสามของเดิม เหลือเพียง 0.13 ดอลลาร์ต่อล้านโทเคน ซึ่งไม่ถึงหนึ่งในห้าของราคาเฉลี่ยรวมของโมเดลปิด
โมเดลโอเพนซอร์สทำงานไปเกือบหนึ่งในห้า แต่แบ่งเงินจากบนโต๊ะไปเพียงหนึ่งในยี่สิบห้า
61% ของ Kimi เกิดขึ้นเพราะมันไม่กระโดดลงไปในกับดัก 0.13 ดอลลาร์นั่นเอง
ชิ้นส่วนมาตรฐาน
เมื่อวันที่ 16 กรกฎาคมปีนี้ Moonshot AI เปิดตัว Kimi K3 ที่มีพารามิเตอร์ 2.8 ล้านล้าน ราคา API อย่างเป็นทางการคืออินพุต 3 ดอลลาร์ เอาต์พุต 15 ดอลลาร์ เท่ากับราคาของ Sonnet 4.5 ซึ่งเป็นเรือธงแบบปิดเมื่อปีก่อน และเป็นสามเท่าของ K2.6 รุ่นก่อนหน้า K3.1 Pro ที่เปิดตัวเมื่อวันที่ 23 ตุลาคม ลดลงเหลือ 2 ดอลลาร์และ 10 ดอลลาร์ แต่ยังอยู่ในระดับเรือธง
การตั้งราคาระดับเรือธงในตลาดโอเพนซอร์สที่มีราคาเฉลี่ย 0.13 ดอลลาร์ ความมั่นใจนั้นมาจากผลงานของตัวโมเดลเองในด้านบริบทยาว มัลติโมดัลแบบเนทีฟ และการเขียนโปรแกรม
แต่มีแค่คะแนนทดสอบไม่พอ
น้ำหนักของโมเดลโอเพนซอร์สเป็นสาธารณะ การเปลี่ยนโมเดลในเมนู下拉ของคลาวด์อนุมานเพียงแก้ไขการตั้งค่าหนึ่งบรรทัด แล้วเหตุใดการจัดซื้อขององค์กรอเมริกันจึงต้องจ่ายเพิ่มให้มัน
ที่นี่ซ่อนปัญหาทางวิศวกรรมที่ปวดหัวที่สุดหลังจากโมเดลโอเพนซอร์สออกจากห้องแล็บ
เพื่อความสอดคล้องของข้อมูลและความหน่วง องค์กรอเมริกันส่วนใหญ่จะไม่ส่งโค้ดและเอกสารไปยังเซิร์ฟเวอร์ต่างประเทศโดยตรง แต่จะซื้อบริการโฮสติ้งจากคลาวด์ในประเทศอย่าง Fireworks, Together หรือ Amazon Bedrock แต่ในปีที่ผ่านมา ทีมวิศวกรในซิลิคอนแวลลีย์พบบ่อยครั้งว่าโมเดลโอเพนซอร์สบางรุ่นฉลาดสุดยอดในการสาธิตอย่างเป็นทางการ แต่เมื่อเชื่อมเข้าสู่สภาพแวดล้อมการผลิตของตนเองและเรียกผ่านอินเทอร์เฟซของคลาวด์อนุมานบุคคลที่สาม มันกลับโง่ลงอย่างไม่ทราบสาเหตุหลังจากเรียกใช้เครื่องมือต่อเนื่องหลายสิบรอบ
สาเหตุก็คือ cloud inference เป็นธุรกิจที่ให้ความสำคัญกับอัตราการหมุนเวียนของการ์ดจอเป็นอย่างมาก จำนวนคำขอที่การ์ดหนึ่งใบสามารถรองรับได้ในหนึ่งวินาทีนั้นส่งผลโดยตรงต่อกำไรขั้นต้นของ cloud provider ในไตรมาสนั้น เพื่อประหยัดหน่วยความจำและเพิ่มความเร็วในการประมวลผล แพลตฟอร์มต่างๆ จึงมักทำ quantization compression ที่แตกต่างกันกับโมเดล MoE ที่มีพารามิเตอร์ระดับล้านล้านอยู่เบื้องหลัง หรือลดความซับซ้อนของ template การ parse การเรียกใช้เครื่องมือ
ในการแชทปกติ ความแม่นยำที่ลดลงเล็กน้อยนี้มองไม่เห็น แต่เมื่ออยู่ใน Agent loop ที่มีหลายสิบขั้นตอนเชื่อมโยงกัน ความคลาดเคลื่อนก็เพียงพอที่จะทำให้โมเดลเลือก expert ผิด เขียนรูปแบบผิด และทำให้ workflow ทั้งหมดล่ม
ลูกค้าจ่ายเงินเพราะชื่อเสียงของโมเดล แล้วงานก็ล้มเหลว สุดท้ายต้นฉบับก็ต้องเป็นคนรับผิดชอบ
Kimi ฉลาดมาก มันไม่ได้ออกแถลงการณ์ไปโต้เถียงกับ cloud provider รายใด แต่เปิด-source และดำเนินการชุดเครื่องมือตรวจสอบความแม่นยำของผู้ให้บริการอย่างต่อเนื่อง
ตั้งแต่ยุค K2 แล้ว มันได้เปิด-source K2 Vendor Verifier โดยใช้ชุดทดสอบเดียวกันเปรียบเทียบประสิทธิภาพของ cloud inference แต่ละรายกับ API ทางการในการเรียกใช้เครื่องมือ เมื่อเปิดตัว K2.6 ในเดือนเมษายนปีนี้ เครื่องมือนี้ได้รับการอัปเกรดเป็น KVV (Kimi Vendor Verifier) โดยมีรายการทดสอบรวมถึงตัวอย่าง regression ของการเรียกใช้เครื่องมือในบริบทแบบยาว การตรวจสอบ JSON schema การปฏิเสธการเรียกใช้ที่ผิดรูปแบบ การทดสอบความจำระยะยาวระดับล้าน token และงาน Agent เขียนโปรแกรม 113 งาน ผลคะแนนที่แต่ละ cloud inference ทำได้จะแสดงเป็นตารางบน GitHub
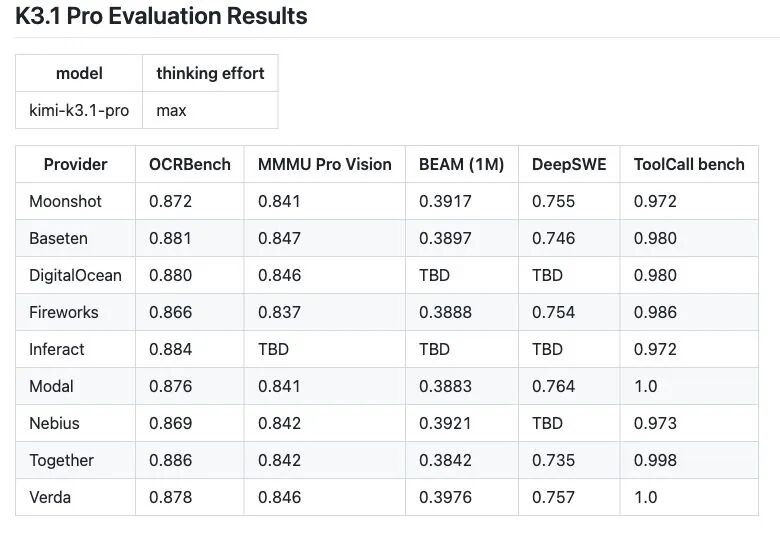
Kimi Vendor Verifier เปรียบเทียบประสิทธิภาพการติดตั้ง
K3.1 Pro ของผู้ให้บริการต่างๆ อย่างเปิดเผย
ที่มา: Moonshot AI / GitHub
cloud provider รายใดแอบลดความแม่นยำเพื่อประหยัดเครื่อง นักพัฒนาสามารถเห็นได้ทันทีจาก dashboard
เพื่อให้คะแนน KVV เทียบเท่ากับระดับ API ทางการของ Kimi cloud inference ใน Silicon Valley ต้องกลับมาหาวิศวกรของ Kimi เพื่อร่วมกันหา bug
ทีมวิศวกรของ Fireworks AI ภายหลังได้เขียนบทความสรุปประสบการณ์โดยเฉพาะ เล่าว่าพวกเขาร่วมมือกับทีม Kimi ซ่อมแซม decoding guardrail ระดับล่าง ทำความสะอาดฟิลด์ที่ซ้ำซ้อนในการสนทนาหลายรอบ และในที่สุดก็ขัดเกลาประสิทธิภาพการเรียกใช้เครื่องมือของ hosted interface ให้ได้ถึงระดับต้นฉบับ
ทีมส่วนใหญ่ที่ทำโอเพนซอร์ส จะแค่วางน้ำหนักโมเดลลงบนอินเทอร์เน็ต แล้วปล่อยให้เป็นไปตามยถากรรม แต่ Moonshot AI กลับยกมาตรฐานการควบคุมคุณภาพที่เข้มงวดมาใช้ในโลกโอเพนซอร์ส ฉันไม่เก็บค่าตั๋วจากคุณ แต่ฉันต้องคุมว่าคุณจะเสิร์ฟอาหารยังไง
สิ่งนี้กระทบเส้นประสาทที่อ่อนไหวที่สุดของการจัดซื้อในองค์กร สำหรับหัวหน้าฝ่ายเทคนิคในซิลิคอนแวลลีย์ KVV ได้ปรับเทียบสินค้าที่ไม่ได้มาตรฐานซึ่งกระจัดกระจายอยู่ในศูนย์ข้อมูลต่างๆ ให้กลายเป็นชิ้นส่วนมาตรฐานที่ได้รับการรับรองจากโรงงานอีกครั้ง
สามในสี่
ถ้ามีแค่คุณภาพของการโฮสต์ Kimi ก็เป็นได้แค่กำลังเสริมที่ใช้งานได้ดี ชื่ออีกชื่อที่ถูกกล่าวถึงในรายงานได้เปิดเผยคุณค่าชั้นที่สองของมันในต่างประเทศ นั่นคือ Cursor
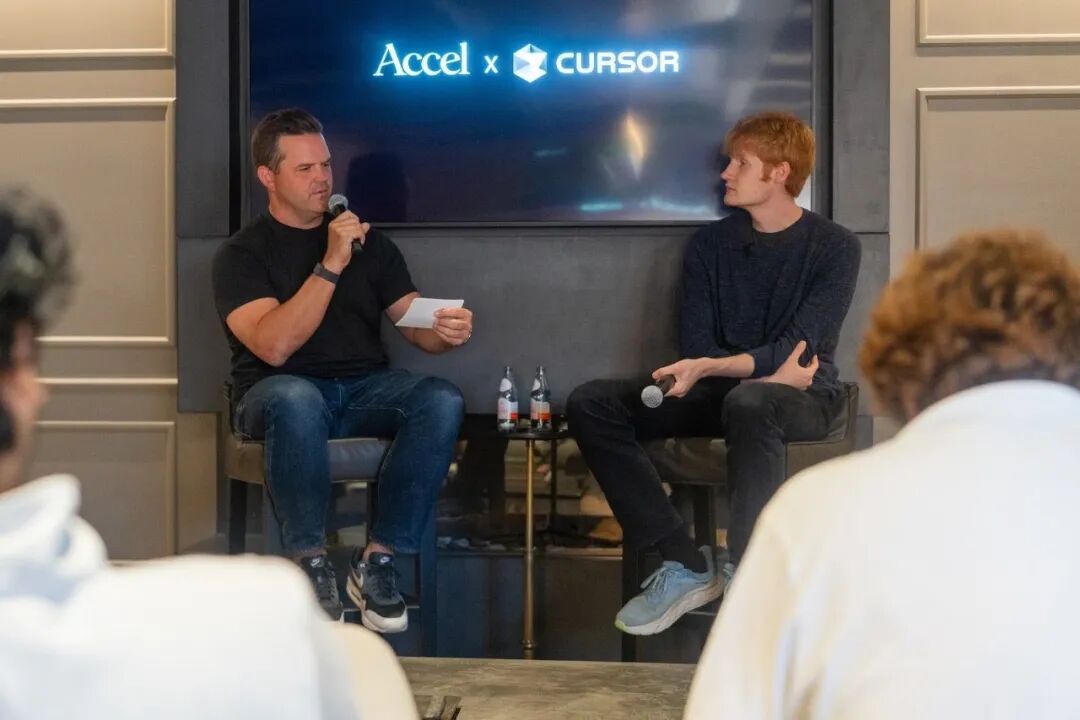
กิจกรรมแลกเปลี่ยนภาคสนามระหว่าง Cursor กับ Accel ผู้ลงทุน
ที่มาภาพ: Accel
Menlo เขียนว่า ปีนี้สัดส่วนนักพัฒนา AI ที่ทำ post-training เพิ่มขึ้นจาก 6% เป็น 10% กรณีศึกษาที่ชัดเจนที่สุดคือ Cursor ฝึก Composer 2 บน Kimi K2.5 โดยมี Fireworks ให้บริการการอนุมานในขั้นตอน reinforcement learning
ข้อมูลของ Menlo สะท้อนสถานการณ์ของบริษัทแอปพลิเคชันอิสระได้อย่างชัดเจน ในปีนี้จากรายจ่าย AI ระดับองค์กร 176.8 พันล้านดอลลาร์ ห้องแล็บสามแห่งอย่าง Anthropic, OpenAI และ Google คว้าไป 122.7 พันล้านดอลลาร์ คิดเป็น 69% เมื่อปีก่อนอยู่ที่ 50% โดยในจำนวนนี้แอปพลิเคชันของห้องแล็บเองคว้าไป 40 พันล้านดอลลาร์
หากดูเฉพาะตลาดเขียนโค้ดมูลค่า 34 พันล้านดอลลาร์ สองผลิตภัณฑ์อย่าง Claude Code และ Codex คว้าไป 24 พันล้านดอลลาร์ คิดเป็น 70%
ยิ่งบริษัทแอปพลิเคชันประสบความสำเร็จมากเท่าไร ก็ยิ่งช่วยพิสูจน์ให้ต้นน้ำเห็นว่าตลาดนี้ใหญ่พอ และเมื่อตลาดถูกพิสูจน์ว่าใหญ่พอ ต้นน้ำที่ถือโมเดลและพลังประมวลผลก็ยิ่งมีเหตุผลที่จะลงมาเล่นเอง หากยังเป็นแค่พ่อค้าคนกลางต่อไป สักวันก็ต้องถูกต้นน้ำบีบจนตาย
ต้นเดือนมกราคมปีนี้ Cursor จัดกิจกรรมภายในที่เรียกว่า "War Time" ผู้ก่อตั้ง Michael Truell เรียกร้องให้ทุกคนเร่งพัฒนโมเดลของตัวเอง
แต่การที่บริษัทแอปพลิเคชันจะก้าวขึ้นไปนั้นไม่ง่ายเลย Cursor มีเส้นทางการโต้ตอบจริงของโปรแกรมเมอร์หลายล้านคนที่เขียนโค้ด แก้ไฟล์ และรันเทอร์มินัลทุกวัน ซึ่งเป็นเชื้อเพลิงที่ดีที่สุดสำหรับ reinforcement learning แต่พวกเขามี GPU แค่ไม่กี่หมื่นตัว ไม่มีเป็นล้านการ์ด และไม่มีเวลาครึ่งปีในการฝึกฐาน pre-training ขนาดล้านล้านพารามิเตอร์ตั้งแต่ต้น
นอกจากนี้ ไม่กี่วันหลังจากที่ Cursor จัดประชุมภายใน Anthropic ก็ได้กระชับกฎเกณฑ์ ไม่ยอมให้เครื่องมือเขียนโปรแกรมของบุคคลที่สามเข้าสู่ระบบและเรียกใช้งานผ่านบัญชีสมัครสมาชิกส่วนบุคคลอีกต่อไป
ทางรอดเดียวคือออกไป borrow ร่างกายที่ดีจากโลกโอเพนซอร์ส แล้วทุ่มเหล็กกล้าทั้งหมดไปที่การเสริมความแข็งแกร่งในช่วงครึ่งหลัง
วันที่ 19 มีนาคม Cursor เปิดตัว Composer 2 ราคาอินพุต 0.5 ดอลลาร์ เอาต์พุต 2.5 ดอลลาร์ ซึ่งเป็นหนึ่งในสิบของ Claude Opus 4.6 ในตอนนั้นพอดี Lee Robinson แห่ง Cursor กล่าวในภายหลังว่า ในกำลังประมวลผลที่โมเดลสุดท้ายใช้ไป มีเพียงประมาณหนึ่งในสี่เท่านั้นที่มาจากฐาน ส่วนที่เหลือใช้ไปกับการเทรนของ Cursor เอง
สิ่งนี้ได้เขียนมาตรฐานใหม่สำหรับบริษัทแอปพลิเคชันในการเลือกโมเดลโอเพนซอร์ส
แต่ก่อนทุกคนเลือกโมเดลโอเพนซอร์สเหมือนเลือกเสื้อสำเร็จรูปที่ซื้อกลับบ้านแล้วใส่ได้เลย ใครสอบได้คะแนนมากกว่าสองคะแนนบนกระดานจัดอันดับสาธารณะก็เลือกคนนั้น แต่ในภาคผนวกของรายงานทางเทคนิค 46 หน้าที่ Cursor เปิดเผยในภายหลัง ทีมวิจัยเขียนว่าในการประเมินฐานที่เป็นตัวเลือกนั้น ทีมจงใจไม่ดูคะแนนประเภท Coding Agent โดยให้เหตุผลว่ากระดานจัดอันดับประเภทนี้มีความสามารถในการทำนายผลลัพธ์สุดท้ายได้อ่อนกว่า เพราะความสามารถของ Agent และงานระยะยาวจะถูกเปลี่ยนแปลงอย่างมากในช่วงการเรียนรู้แบบเสริมกำลัง
โมเดลจำนวนไม่น้อยเพื่อให้ดูดีในวันประกาศอันดับ ได้ถูกอัดการปรับแต่งเฉพาะสำหรับชุดข้อสอบเฉพาะไว้เต็มก่อนออกจากโรงงาน พื้นที่น้ำหนักถูกบีบจนเหมือนฟองน้ำที่ดูดน้ำจนอิ่ม คนนอกเห็นคะแนนสูง แต่พอซื้อกลับมาแล้วอยากเทกำลังประมวลผลการเรียนรู้แบบเสริมกำลังเพิ่มอีกสามเท่าลงไป โมเดลก็จะเกิดการถดถอยของความสามารถอย่างรวดเร็ว
Cursor ดึงโมเดลที่เป็นตัวเลือกมาทดลองงานที่ไซต์งานของตัวเองโดยตรง
พวกเขาทดสอบเพียงสามอย่าง คือคลังความรู้การเขียนโค้ดระดับพื้นฐาน ความสามารถในการติดตามสถานะหลังจากไฟล์หนึ่งถูกแก้ไขต่อเนื่องหลายสิบครั้ง และ perplexity ของโมเดลบนฐานโค้ดขนาดใหญ่ส่วนตัวของ Cursor
หลังการทดสอบ Kimi K2.5 ถูกเก็บไว้ เหตุผลที่รายงานให้คือประสิทธิภาพโดยรวมแข็งแกร่ง และทำงานได้อย่างมีประสิทธิภาพเพียงพอบนโครงสร้างพื้นฐานของ Cursor เอง หลังการฝึกล่วงหน้าอย่างต่อเนื่องและการเรียนรู้แบบเสริมกำลัง Composer 2 บนชุดประเมิน CursorBench ของ Cursor เองเพิ่มจาก 36.0 ของฐานเป็น 61.3 แซงหน้า 58.2 ของ Claude Opus 4.6
ในเดือนพฤษภาคม Cursor เปิดตัว Composer 2.5 บนฐาน K2.5 เดียวกันอีกครั้ง
การฝ่าวงล้อมจากฤดูใบไม้ผลิถึงฤดูร้อนนี้ได้ทิ้งตัวอย่างไว้ให้ซิลิคอนแวลลีย์ สำหรับบริษัทแอปพลิเคชันชั้นนำ โมเดลน้ำหนักเปิดไม่ใช่ตัวแทนประหยัดเงินอีกต่อไป แต่เป็นจุดเริ่มต้นส่วนน้อยที่หยิบมาแล้วทุ่มเงินฝึกสินทรัพย์ของตัวเองต่อได้
เงินค่าน้ำชา
Cursor ผลักดัน Composer 2 ที่ฝึกจาก K2.5 ให้กับผู้ใช้ของตัวเอง องค์กรอเมริกันเรียกใช้ Kimi ในสภาพแวดล้อมการผลิต สิ่งที่รองรับทราฟฟิกเหล่านี้ส่วนใหญ่คือคลาวด์ประมวลผลอนุมานสัญชาติอเมริกันอย่าง Fireworks และ Together
เมื่อวาง Kimi, Fireworks และ Cursor ไว้ด้วยกัน จะเห็นการแบ่งงานที่มีความพอดีอย่างชัดเจน
หากเปลี่ยนเป็นบริษัทอื่นที่กระตือรือร้นจะพิสูจน์ความสามารถเชิงพาณิชย์ เมื่อเห็นโมเดลของตัวเองได้รับความนิยมในซิลิคอนแวลลีย์ ปฏิกิริยาแรกมักจะเป็นการไปเช่าสำนักงานในซานฟรานซิสโก ดึงดูดพนักงานขายองค์กรด้วยเงินเดือนสูง ไปเคาะประตูลูกค้ารายใหญ่ของสหรัฐฯ โดยตรง และเก็บส่วนต่างทั้งหมดเข้ากระเป๋าตัวเอง
Moonshot AI ไม่ได้ทำเช่นนั้น
ในเดือนกรกฎาคม 2025 Menlo ยังได้เขียนไว้ในรายงานกลางปีว่า องค์กรอเมริกันไม่ยินดีเรียกใช้ API ของบริษัทจีนโดยตรง เป็นหนึ่งในสาเหตุที่ส่วนแบ่งโมเดลโอเพนซอร์สหยุดชะงัก อุปสรรคด้านการปฏิบัติตามกฎระเบียบและความไว้วางใจนี้ ไม่สามารถข้ามไปได้ด้วยการที่พนักงานขายบินไปแคลิฟอร์เนียและพูดจนปากเปียกปากแฉะ
แทนที่จะชนกำแพงนั้นโดยตรง สู้ยกเนื้อส่วนหน้าให้พันธมิตรท้องถิ่นของสหรัฐฯ ดีกว่า ทีมวิศวกรของ Kimi ร่วมมือกับแพลตฟอร์มอย่าง Fireworks ปรับแต่งเอนจินประมวลผลอนุมานให้ราบรื่นในช่วงก่อนและหลังโมเดลเปิดตัว องค์กรอเมริกันเซ็นสัญญากับผู้ให้บริการคลาวด์อเมริกัน ข้อมูลเก็บอยู่ในศูนย์ข้อมูลในสหรัฐฯ
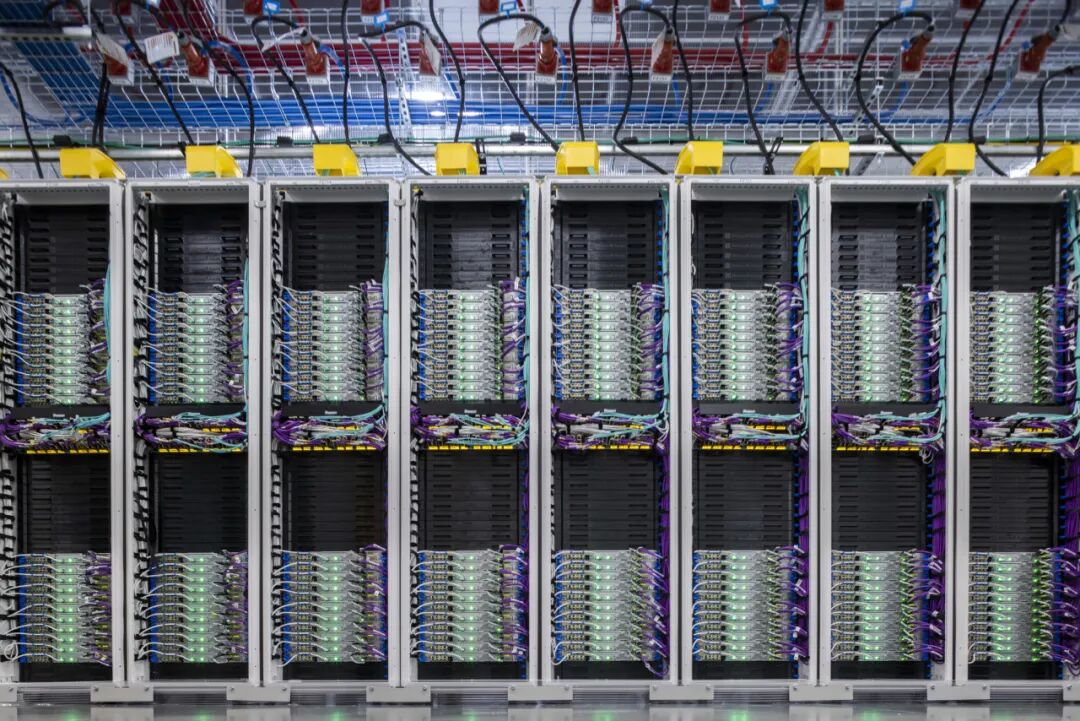
ตู้เซิร์ฟเวอร์ในศูนย์ข้อมูลของ Microsoft ที่เมืองควินซี รัฐวอชิงตัน สหรัฐฯ
ที่มาภาพ: John Brecher / Microsoft
เพราะ Moonshot AI ไม่ได้ยื่นมือไปแย่งธุรกิจ Fireworks จึงยินดีผลักดัน Kimi อย่างเต็มที่ และวิศวกรของ Cursor ก็กล้าสร้างผลิตภัณฑ์หลักของตัวเองบนน้ำหนักของ K2.5 เมื่อทุกคนมีเงินทำ เรื่องนี้จึงจะเติบโตเป็นกระแสได้
ส่วนปัญหาการรายได้ของ Moonshot AI เอง พวกเขาเขียนกฎไว้ในสัญญาอนุญาตของ K3.1 Pro
การติดตั้งใช้งานภายในองค์กร ทำวิจัย หรือนำไปปรับแต่งเพื่อทำผลิตภัณฑ์ของตัวเอง ไม่ต้องแจ้งให้ทราบ มีเพียงสองกรณีที่ต้องนั่งลงเจรจา หนึ่งคือนำไปใช้เป็นบริการโฮสต์โมเดล ให้บริการประมวลผลอนุมานหรือปรับแต่งแก่ภายนอก หากมีรายได้ต่อเนื่อง 12 เดือนเกิน 20 ล้านดอลลาร์สหรัฐ ต้องเซ็นสัญญาแยกกับ Moonshot AI ก่อน สองคือผลิตภัณฑ์ปลายทางมีผู้ใช้ต่อเดือนเกิน 100 ล้านคน หรือมีรายได้ต่อเดือนเกิน 20 ล้านดอลลาร์สหรัฐ ต้องระบุชื่อโมเดลอย่างชัดเจนบนอินเทอร์เฟซ ผู้ที่ใช้งานผ่านผลิตภัณฑ์อย่างเป็นทางการของ Moonshot AI หรือพันธมิตรประมวลผลอนุมานที่ได้รับการรับรอง ไม่ถูกจำกัดด้วยสองข้อนี้
ในเดือนสิงหาคม รอยเตอร์รายงานว่า Moonshot กำลังเจรจากับ Microsoft, Amazon และ Google เกี่ยวกับการแบ่งรายได้จากบริการที่เกี่ยวข้องกับ K3 โดยเรียกราคาสูงสุดถึง 30%
ไม่ถึงหนึ่งเดือน ตามเวลาสหรัฐฯ วันที่ 18 กันยายน Amazon ได้นำ K3 ขึ้น Bedrock ราคาระดับมาตรฐานทั่วโลกเท่ากับทางการของ Moonshot คือ 3 ดอลลาร์ และ 15 ดอลลาร์ ส่วนสัดส่วนการแบ่งรายได้ไม่ได้เปิดเผย
เส้นทางของ Microsoft อ้อมกว่าหน่อย K3 เข้า Microsoft Foundry ตั้งแต่ปลายเดือนกรกฎาคม แต่ตอนนั้น Fireworks เป็นตัวรัน inference อยู่เบื้องหลัง Foundry เพียงรับผิดชอบการเชื่อมต่อ ตามเวลาสหรัฐฯ วันที่ 5 พฤศจิกายน Microsoft ประกาศบนบล็อกของตัวเองว่า K3.1 Pro ขึ้น Foundry อย่างเป็นทางการแล้ว
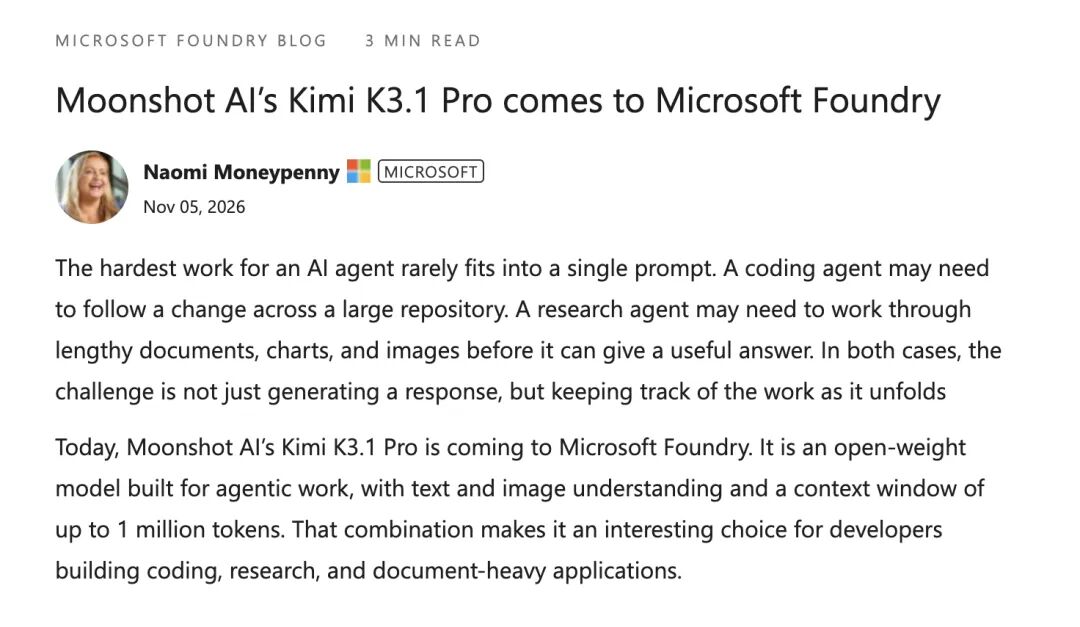
พูดแบบพ่อค้า老一辈 เรียกว่า เส้นเล็กเดินได้ตามสบาย เส้นใหญ่ต้องจ่ายค่าน้ำชา ในบรรดาบริษัทสตาร์ทอัพหนึ่งร้อยแห่ง มีเก้าสิบเก้าแห่งยังลองผิดลองถูก Kimi ไม่เก็บสักบาท พอใครวิ่งจนสำเร็จจริงเป็นธุรกิจใหญ่ปีละหลายสิบล้านดอลลาร์ ค่อยนั่งลงคุยกันตามกฎ
การรู้ชัดว่าส่วนไหนของเงินที่ไม่ควรหาเองในตอนนี้ บางครั้งทดสอบความมั่นคงทางใจได้มากกว่าการรู้วิธีหาเงิน
แมวดำแมวขาว
ถอยสายตาออกจากภาพตัดขวาง 61% นี้สักหน่อย ข้อมูลชุดนี้ในฤดูใบไม้ร่วงปีนี้ที่ชวนคิด เพราะมันสะท้อนความสัมพันธ์รูปแบบใหม่ที่อุตสาหกรรมโมเดลใหญ่เติบโตขึ้นเองตามธรรมชาติ หลังผ่านการปรับตัวมาสามปี
สองปีก่อน การถกเถียงในซิลิคอนแวลลีย์เกี่ยวกับจุดจบของอุตสาหกรรมเป็นขาวดำฝ่ายหนึ่งเชื่อว่าเรือธงแบบปิดจะกินเรียบทุกอย่าง บริษัทแอปพลิเคชันไม่ช้าก็เร็วจะกลายเป็นเพียงชั้นอินเทอร์เฟซบางๆ อีกฝ่ายเชื่อว่าโอเพนซอร์สจะทำให้ความฉลาดกลายเป็นน้ำประปาฟรี ทำให้บริษัทโมเดลทั้งหมดหาเงินไม่ได้
ถึงปี 2026 ภาพทั้งสองก็ไม่เป็นจริง
Anthropic และ OpenAI ยังคงคว้า 86% ของค่าใช้จ่าย API โมเดลใหญ่ขององค์กรสหรัฐฯ วอลสตรีทใช้ตรวจสัญญาการควบรวมข้ามชาติ บริษัทยาใช้ตรวจวรรณกรรมที่ผิดพลาดไม่ได้แม้แต่ครั้งเดียว ยังคงจ่ายให้เรือธงแบบปิดที่แพงที่สุดอย่างไม่ลังเล งบประมาณที่ไหลไปโอเพนซอร์สก็ไม่ได้กลายเป็นการแข่งขันพลังประมวลผลราคาถูก แต่กลับรวมตัวเข้าหาโมเดลที่ใกล้ชายแดนอย่าง Kimi
ระหว่างโอเพนซอร์สกับปิด ไม่ใช่สนามเพลาะแบบเลือกข้างอีกต่อไป ภายใต้การเร่งปฏิกิริยาของงานซับซ้อน ทั้งสองได้งอกพื้นที่รอยต่อกว้างใหญ่ขึ้นมา
ในพื้นที่รอยต่อนี้ บริษัทซิลิคอนแวลลีย์หลายแห่งที่ใช้ Kimi หนักๆ ก็เป็นลูกค้ารายใหญ่ของ Anthropic และ OpenAI ด้วยเช่นกัน ในช่วงต้นของผลิตภัณฑ์ พวกเขาใช้โมเดลปิดที่แข็งแกร่งที่สุดเพื่อวิ่งให้รูปร่างใช้งานได้และตรวจสอบความต้องการ พอเวิร์กโฟลว์สายยาวบางเส้นได้รับการพิสูจน์ว่าทำได้จริง ปริมาณการเรียกเริ่มขยายแบบทวีคูณ หรือสะสมข้อมูลปฏิสัมพันธ์เฉพาะได้มากพอแบบ Cursor และต้องการฝึกประสบการณ์อุตสาหกรรมเข้าไปในน้ำหนัก พวกเขาก็จะหันไปหาฐานเปิดที่ใกล้ชายแดนที่สุดและยอมให้ตัวเองดัดแปลงได้ลึก
ในอดีต ระหว่างบริษัทโมเดลและบริษัทแอปพลิเคชัน ฝ่ายหนึ่งขาย API อีกฝ่ายซื้อ API เมื่อใดที่บริษัทโมเดลทำแอปพลิเคชันเอง ทั้งสองฝ่ายก็กลายเป็นคู่แข่งในเกมผลรวมศูนย์ทันที
แต่ตอนนี้ บริษัทแอปพลิเคชันลงทุนสามในสี่ของพลังประมวลผลบนโมเดลเปิดเพื่อฝึกฝนต่อ กลายเป็น "ครึ่งหนึ่งของบริษัทโมเดล" อิทธิพลของผู้พัฒนาโมเดลไม่ได้ดูแค่จำนวนโทเคนที่ขายได้อีกต่อไป แต่ยังดูว่ามีผลิตภัณฑ์หลักของคนอื่นกี่รายที่เติบโตออกมาจากน้ำหนักของมัน
ภาพหลักอย่างเป็นทางการของการเปิดตัว Kimi K3.1 Pro
ที่มาภาพ: Moonshot AI
วันถัดจากที่รายงาน Menlo เผยแพร่ คือวันที่ 4 พฤศจิกายน Moonshot AI ได้ปล่อยน้ำหนักเต็มรูปแบบของ Kimi K3.1 Pro บน Hugging Face ตามกำหนด ตามผลงานที่ Moonshot AI ประกาศเอง มันทำได้ 65.7% บน Terminal-Bench 4.0 ซึ่งวัดความสามารถเชิงปฏิบัติของ Agent เขียนโค้ด สูงกว่า 58.2% ของ GPT-6 Astra และห่างจาก 66.4% ของ Claude Opus 5.5 เพียง 0.7 เปอร์เซ็นต์เท่านั้น
สำหรับทีมสหรัฐฯ ที่ฝากไปป์ไลน์ผลิตภัณฑ์ไว้บนฐานเปิด 0.7 จุดนี้ และจังหวะที่ขยับไปข้างหน้าทุกไม่กี่เดือนจาก K2, K2.5, K2.6 ไปจนถึง K3, K3.1 Pro ทำให้อุ่นใจกว่าคำขวัญเปิดซอร์สใดๆ โมเดลเฉพาะทางที่ฝึกต่อหลังการฝึกหลัก ต้องฝึกใหม่ตามแนวหน้าใหม่ทุกไม่กี่เดือน การเลือกฐานเท่ากับเลือกความเร็วในการอัปเดตของบริษัทนั้นในปีข้างหน้าพร้อมกัน
ในซานฟรานซิสโก คงไม่มีสตาร์ทอัพรายไหนเขียนบนสไลด์แรกของพิตช์ว่า "ฐานของเรามาจากจีน" ถิ่นกำเนิดของโมเดลใหญ่ยังคงเป็นคำที่อ่อนไหว
แต่พอกลับเข้าห้องเซิร์ฟเวอร์ที่ทำงานทุกวัน กลับไปยังดึกดื่นที่วิศวกรจ้องหน้าจอรอให้ลูป Agent 50 รอบทำงานสำเร็จ คำขวัญทั้งหมดก็เปิดทางให้ลัทธิปฏิบัติจริง ใครจับหนูได้ คนนั้นคือแมวดี
เมื่อบริษัทแอปพลิเคชันอีกฟากมหาสมุทรต้องการพันธมิตรที่ทนต่อการใช้งานหนักจริงๆ ได้จริง พอเงยหน้าขึ้น ก็เห็นว่ามันยืนอยู่ตรงนั้นมานานแล้ว
ลิงก์ต้นฉบับ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง