Anthropic เรียกร้องให้หยุดการพัฒนา AI ทั่วโลก พร้อมเตือนว่าโมเดลต่างๆ กำลังมีความสามารถในการ "อัปเกรดตัวเอง" อย่างค่อยเป็นค่อยไป
หัวข้อต้นฉบับ: 《หายาก! "ยักษ์ใหญ่ AI" เรียกร้องให้หยุดการพัฒนา AI ทั่วโลก เตือนโมเดลกำลังมีความสามารถ "อัปเกรดตัวเอง" อย่างค่อยเป็นค่อยไป》
ผู้เขียนต้นฉบับ: หลงเยว่, Wall Street Insight
「เราเชื่อว่าการให้โลกมีตัวเลือกในการชะลอหรือหยุดการพัฒนา AI ชั้นนำชั่วคราวจะเป็นประโยชน์ต่อโลก——เพื่อให้โครงสร้างทางสังคมและการวิจัยการปรับแนวสามารถก้าวทันความก้าวหน้าทางเทคโนโลยี」Anthropic ซึ่งมีมูลค่าประมาณล้านล้านดอลลาร์และกำลังเร่งดำเนินการเสนอขายหุ้น IPO เตือนว่า "การปรับปรุงตนเองแบบวนซ้ำ" ของ AI อาจเกิดขึ้นภายในสองปี และเรียกร้องอย่างหายากให้ "เหยียบเบรก" ในการพัฒนา AI การกระทำนี้ถูกนักวิจารณ์มองว่าเป็น "กลยุทธ์การตลาด" ขณะที่ผู้สนับสนุนมองว่าเป็นคำเตือนที่จริงใจ
บริษัท AI ที่มีมูลค่าใกล้ล้านล้านดอลลาร์และกำลังเร่งดำเนินการเสนอขายหุ้น IPO จู่ๆ ก็ออกมาเรียกร้องให้หยุดการพัฒนา AI ทั่วโลก
เมื่อวันที่ 4 มิถุนายน Anthropic ได้เผยแพร่บทความยาวบนบล็อกอย่างเป็นทางการชื่อ 《เมื่อ AI สร้างตัวเอง》 (When AI Builds Itself) บทความนี้ลงนามร่วมโดย Jack Clark ผู้ร่วมก่อตั้งบริษัท และ Marina Favaro หัวหน้าหน่วยวิจัยภายใน เป็นครั้งแรกที่เปิดเผยข้อมูลการดำเนินงานภายในที่ไม่เคยเปิดเผยต่อสาธารณะมาก่อน
ข้อมูลเหล่านี้แสดงให้เห็นว่า AI กำลังเร่งกระบวนการพัฒนา AI เองด้วยความเร็วที่น่าตกใจ: ณ เดือนพฤษภาคม 2026 โค้ดมากกว่า 80% ที่รวมเข้าในคลังโค้ดของ Anthropic ถูกเขียนโดย Claude; เมื่อเทียบกับปี 2024 ปริมาณโค้ดที่วิศวกรรวมต่อวันเพิ่มขึ้น 8 เท่า ในการสำรวจวิจัยภายใน พนักงานประมาณการว่าหลังจากใช้โมเดลล่าสุด Mythos Preview ผลผลิตของตนเองสูงกว่าการไม่ใช้เครื่องมือ AI ใดๆ ประมาณ 4 เท่า
ที่สำคัญกว่านั้น Anthropic ได้เสนอแนวคิดเตือนที่ทำให้อุตสาหกรรม AI ทั้งหมดไม่สบายใจ: "การปรับปรุงตนเองแบบวนซ้ำ" (recursive self-improvement) — นั่นคือความสามารถของระบบ AI ในการออกแบบและปรับปรุงผู้สืบทอดของตนเองโดยไม่ต้องมีการแทรกแซงของมนุษย์ ขั้นตอนนี้ยังมาไม่ถึง แต่ "อาจเกิดขึ้นภายในสองปีข้างหน้า หรือเร็วกว่านั้น"
จากข้อมูลเหล่านี้ Anthropic เสนอข้อเรียกร้องที่ค่อนข้างหายากในอุตสาหกรรม AI: ทั่วโลกควรประสานงานกันเพื่อพิจารณาหยุดหรือชะลอการพัฒนา AI ชั้นนำ ในขณะที่ธุรกิจกำลังขยายตัวอย่างรวดเร็ว Anthropic กลับเรียกร้องให้ "เหยียบเบรก" อย่างแข็งขัน — การกระทำที่ผิดปกตินี้กำลังก่อให้เกิดข้อถกเถียงทั้งในวอลล์สตรีทและซิลิคอนแวลลีย์
นักวิจารณ์มองว่าการกระทำของ Anthropic ครั้งนี้เป็นเพียงการขยายกลยุทธ์ "การยึดครองกฎระเบียบ" (regulatory capture) ที่พวกเขาใช้มาโดยตลอด นั่นคือการสร้างแรงกดดันต่อหน่วยงานกำกับดูแลด้วยการเน้นย้ำถึงความเสี่ยงของ AI เพื่อจำกัดคู่แข่ง โดยเฉพาะอย่างยิ่งการพัฒนาของโมเดลโอเพนซอร์ส บางคนยังตีความการเปิดตัวโมเดลความปลอดภัยทางไซเบอร์ "Mythos" ของ Anthropic อย่างจำกัดว่าเป็นกลยุทธ์ทางการตลาด: ในด้านหนึ่งก็อวดความสามารถ อีกด้านหนึ่งก็อ้างเหตุผลด้าน "ความปลอดภัย" เพื่อปฏิเสธการเปิดให้ใช้อย่างเต็มรูปแบบ ส่วนผู้สนับสนุนกลับเห็นว่าคำเตือนของ Anthropic เกี่ยวกับความเสี่ยงของ AI มีความจริงใจอยู่บ้าง Ethan Mollick ศาสตราจารย์จาก Wharton School แห่งมหาวิทยาลัยเพนซิลเวเนีย กล่าวว่า ห้องปฏิบัติการ AI มักไม่ได้มีเพียงองค์ประกอบเดียว: มันมีทั้งฝ่ายการตลาด ทนายความ และตรรกะทุนของบริษัทมูลค่าหลายล้านล้านดอลลาร์ รวมถึงนักวิจัยที่มุ่งมั่นพัฒนาโมเดลรุ่นต่อไป และบุคคลแนว "ราชาปราชญ์" (philosopher king) ที่กังวลอย่างแท้จริงเกี่ยวกับอนาคต
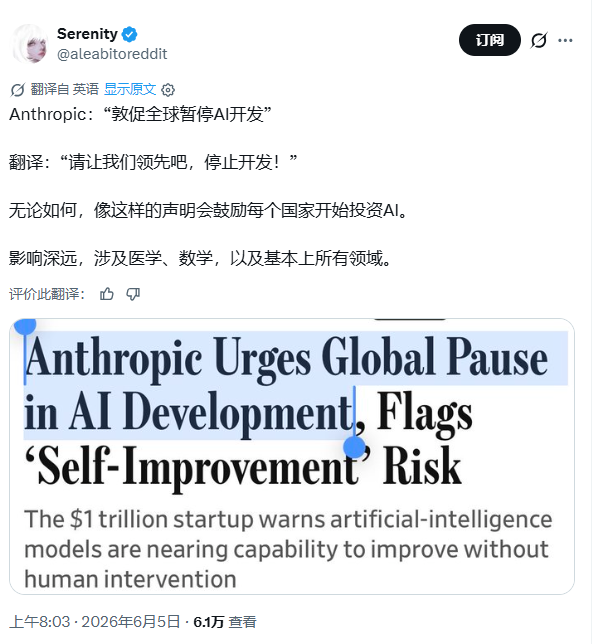
Serenity นักวิเคราะห์ห่วงโซ่อุปทาน AI ซึ่งถูกแฟนๆ ยกย่องว่าเป็น "เทพเจ้าแห่งหุ้น" คนใหม่ของตลาดหุ้นดอลลาร์สหรัฐ โพสต์ว่า ความหมายที่ซ่อนอยู่ของ Anthropic จริงๆ แล้วคือ "โปรดให้เรานำหน้าเถอะ หยุดพัฒนาเถอะ!" และไม่ว่าจะอย่างไร คำประกาศแบบนี้จะกระตุ้นให้ทุกประเทศเริ่มลงทุนใน AI
ข้อมูลเพียงอย่างเดียวก็ช็อกพอแล้ว: รายได้ต่อปีของ Anthropic จะพุ่งจาก 9 พันล้านดอลลาร์สหรัฐ ณ สิ้นปี 2025 เป็น 5 หมื่นล้านดอลลาร์สหรัฐ ณ สิ้นเดือนมิถุนายน 2026; บริษัทได้ยื่นเอกสาร IPO อย่างลับๆ แล้ว; โมเดลล่าสุด Mythos Preview สามารถทำงานต่อเนื่องได้นานกว่า 16 ชั่วโมง และในการทดสอบครั้งแรกพบช่องโหว่ซอฟต์แวร์ที่มีความเสี่ยงสูงมากกว่าหมื่นจุดในระบบที่สำคัญที่สุดของโลก
ในความขัดแย้งระหว่าง "การเร่งความเร็ว" และ "การเบรก" นี้ โพสต์บล็อกของ Anthropic อาจเป็นคำสารภาพที่ซื่อสัตย์ที่สุดและขัดแย้งในตัวเองมากที่สุดของวงการ AI จนถึงปัจจุบัน
ข้อความเด็ดจากโพสต์บล็อก "เมื่อ AI สร้างตัวเอง" (When AI Builds Itself) มีดังนี้:
1. เราเชื่อว่าการให้โลกมีทางเลือกในการชะลอหรือหยุดการพัฒนา AI ระดับแนวหน้าชั่วคราวจะเป็นประโยชน์ต่อโลก—เพื่อให้โครงสร้างทางสังคมและการวิจัยด้านการปรับแนวทาง (alignment research) สามารถตามทันความก้าวหน้าทางเทคโนโลยี
2. การฝึกอบรม (training run) ซ่อนได้ง่ายกว่าฐานยิงขีปนาวุธ การลงทุนในสิ่งนี้มีความเป็นสากล และแรงจูงใจในการละเมิดข้อตกลงอย่างลับๆ นั้นมหาศาล เพราะเมื่อคนอื่นหยุด ผู้ที่เดินหน้าต่ออาจสืบทอดตำแหน่งผู้นำ
3. การปรับปรุงตนเองแบบวนซ้ำของ AI (AI recursive self-improvement) ยังไม่เกิดขึ้น และไม่ใช่สิ่งที่หลีกเลี่ยงไม่ได้ แต่มันอาจมาถึงเร็วกว่าที่องค์กรส่วนใหญ่เตรียมพร้อมไว้ เทคโนโลยีแบบนั้นไม่เคยมีมาก่อน แต่ฉัน (Jack Clark) เชื่อว่ามันอาจเกิดขึ้นภายในสองปีข้างหน้า หรือเร็วกว่านั้นด้วยซ้ำ
4. หากระบบสามารถสร้างผู้สืบทอดของตนเองได้อย่างสมบูรณ์ วิธีการที่เราปกป้อง ตรวจสอบ และกำหนดพฤติกรรมของมันจะมีความสำคัญมากขึ้นอย่างมาก
5. เอดิสันกล่าวว่าอัจฉริยะคือแรงบันดาลใจ 1% บวกกับหยาดเหงื่อ 99% แต่เราเห็นว่าหยาดเหงื่อกำลังถูกทำให้เป็นอัตโนมัติมากขึ้นเรื่อยๆ
6. โค้ดที่ Claude เขียนเมื่อปลายปี 2025 ยังด้อยกว่ามนุษย์เล็กน้อย ปัจจุบันอยู่ในระดับใกล้เคียงกัน และเราคาดว่าภายในหนึ่งปีมันจะเหนือกว่ามนุษย์อย่างชัดเจน
7. ประมาณหนึ่งปีที่แล้ว ฉันเริ่มใช้เวิร์กโฟลว์ของ Claude อย่างหนัก มันเป็นประสบการณ์ที่บ้าคลั่ง ตอนนี้ผ่านไปประมาณห้าเดือนแล้วตั้งแต่ฉันเขียนโค้ดด้วยตัวเองครั้งสุดท้าย — พนักงานของ Anthropic
8. โดยสรุปแล้ว "การดำเนินการ" เอง—การเขียนโค้ด การทดลอง การสร้างผลลัพธ์—แทบไม่ใช้เวลาของมนุษย์อีกต่อไป แม้ว่าจะยังคงใช้พลังการคำนวณอยู่
9. ในวันที่ราบรื่น ฉันอดไม่ได้ที่จะรู้สึกว่าทุกสิ่งที่ฉันทำนั้นไม่สำคัญ ทุกอย่างถูกทำให้เป็นอัตโนมัติ เร็วกว่าและดีกว่าฉัน แต่ก็มีวันที่ทุกอย่างพังทลายและฉันไม่เข้าใจว่าทำไม ฉันตระหนักว่าฉันไม่รู้แล้วว่าตัวเองกำลังทำอะไรอยู่ — พนักงานของ Anthropic
10. หากสามารถชะลอความเร็วของการพัฒนาเทคโนโลยีนี้ได้อย่างมีประสิทธิภาพ เพื่อให้ตัวเองมีเวลามากขึ้นในการรับมือกับผลกระทบอันลึกซึ้งของมัน เราคิดว่านี่น่าจะเป็นสิ่งที่ดี แต่หากการชะลอเพียงทำให้ผู้กระทำที่ไม่ระมัดระวังที่สุดตามทันทางเทคโนโลยี ผลลัพธ์สุดท้ายอาจทำให้ทุกคนไม่ปลอดภัยยิ่งขึ้น ในกรณีที่ไม่มีกลไกการประสานงานระดับโลก บริษัทและรัฐบาลต่างๆ จะต้องตัดสินใจด้านความปลอดภัยที่ยากลำบากภายใต้แรงกดดันทางการแข่งขันและภูมิรัฐศาสตร์
《เมื่อ AI สร้างตัวเอง》(When AI Builds Itself)คำแปลฉบับเต็มดังนี้:
ความก้าวหน้าของเราในการปรับปรุงตนเองแบบวนซ้ำและผลกระทบ
ในช่วงส่วนใหญ่ของประวัติศาสตร์การพัฒนา AI มนุษย์เป็นผู้ควบคุมทุกขั้นตอนของวงจรการพัฒนา แต่ที่ Anthropic เรากำลังมอบหมายงานพัฒนา AI ให้กับระบบ AI เองมากขึ้นเรื่อยๆ ซึ่งกำลังเร่งกระบวนการวิจัยและพัฒนาของเรา
หากแนวโน้มนี้ดำเนินต่อไปนานพอและได้รับพลังการคำนวณที่เพียงพอ ผลลัพธ์สุดท้ายคือ: ระบบ AI จะสามารถออกแบบและพัฒนาผู้สืบทอดของตนเองได้อย่างอิสระสมบูรณ์ สิ่งนี้เรียกว่าการปรับปรุงตนเองแบบวนซ้ำ เรายังไม่ถึงขั้นตอนนี้ และการปรับปรุงตนเองแบบวนซ้ำก็ไม่ใช่สิ่งที่หลีกเลี่ยงไม่ได้ แต่มันอาจมาถึงเร็วกว่าที่หน่วยงานส่วนใหญ่คาดการณ์ไว้
สถาบันวิจัย Anthropic ใช้ข้อมูลจากการทดสอบมาตรฐานสาธารณะ รวมถึงข้อมูลภายในที่ไม่เคยเปิดเผยมาก่อน เพื่อพิสูจน์ว่า AI กำลังเร่งการพัฒนาระบบ AI ขึ้นเอง ยกตัวอย่างหนึ่ง: ปัจจุบัน วิศวกรของ Anthropic ส่งโค้ดโดยเฉลี่ยต่อไตรมาสมากกว่าช่วงปี 2021 ถึง 2025 ถึง 8 เท่า
บทความนี้กล่าวถึงแนวโน้มทางเทคโนโลยีที่บ่งชี้ว่า ความสามารถของระบบ AI จะก้าวกระโดดอย่างมากในอีกไม่กี่ปีข้างหน้า แนวโน้มเหล่านี้ส่งผลกระทบอย่างลึกซึ้ง AI ที่สามารถสร้างตัวเองได้ จะเป็นความก้าวหน้าครั้งสำคัญในประวัติศาสตร์เทคโนโลยี ซึ่ง有望นำมาซึ่งประโยชน์มหาศาลแก่โลกในด้านวิทยาศาสตร์ การแพทย์ และอื่นๆ แต่การปรับปรุงตัวเองแบบวนซ้ำอย่างสมบูรณ์ ก็อาจเพิ่มความเสี่ยงที่มนุษย์จะสูญเสียการควบคุมระบบ AI เมื่อระบบสามารถสร้างผู้สืบทอดของตัวเองได้อย่างอิสระ วิธีการที่เราใช้ในการรักษาความปลอดภัย ติดตามจัดการ และกำหนดพฤติกรรมของระบบเหล่านั้น จะมีความสำคัญมากกว่าที่เป็นอยู่ในปัจจุบันอย่างมาก
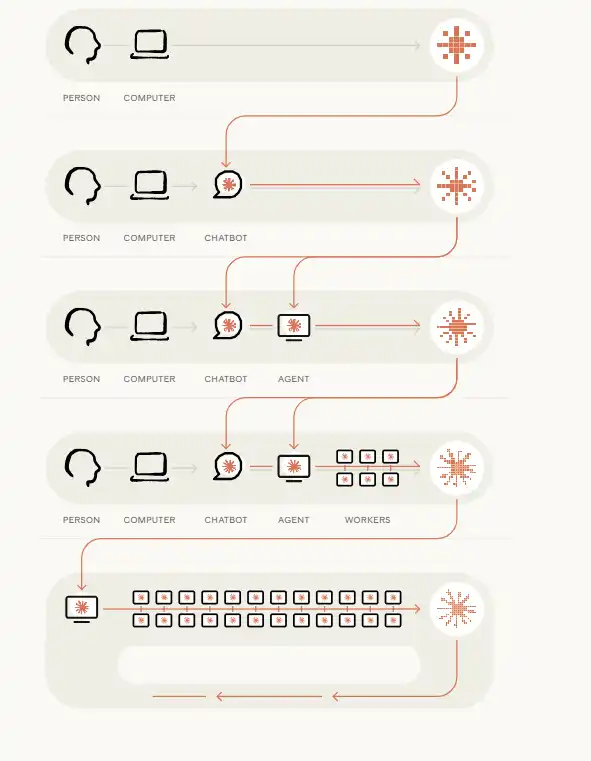
การสร้าง Claude รุ่นแรก (2021–2023)
ในช่วงแรก งานของ Anthropic ไม่ต่างจากบริษัทเทคโนโลยีอื่นๆ: พนักงานเขียนโค้ดและเอกสารบนแล็ปท็อป
แชทบอท (2023–2025)
ผู้คนเริ่มใช้แชทบอทในยุคแรกช่วยทำงานบางส่วน เช่น การสร้างโค้ดสั้นๆ แล้วคัดลอกผลลัพธ์ไปยังโปรแกรมแก้ไขข้อความ
เอเจนต์การเขียนโปรแกรม (2025–2026)
เมื่อเอเจนต์มีความสามารถมากขึ้น พวกมันสามารถเขียนและแก้ไขโค้ดได้อย่างอิสระ บางครั้งถึงขั้นจัดการไฟล์ทั้งหมด
เอเจนต์อัตโนมัติ (ปัจจุบัน)
ตอนนี้เอเจนต์สามารถรันโค้ดได้ด้วยตัวเอง และมอบหมายงานที่ใช้เวลาหลายชั่วโมงให้เอเจนต์อื่นทำ
วงจรปิด (20XX?)
ในอนาคต เอเจนต์อาจมีความสามารถเพียงพอที่จะสร้างและฝึกโมเดลได้ด้วยตัวเอง หากเป็นเช่นนั้น Claude รุ่นต่อๆ ไปจะสามารถถูกปรับปรุงอย่างต่อเนื่องโดย Claude เอง
หลักฐานจากโลกภายนอก
ความก้าวหน้าของโมเดล AI กำลังเร่งตัวขึ้น ระยะเวลาที่โมเดลสามารถทำงานได้อย่างอิสระและเชื่อถือได้ ก่อนหน้านี้เพิ่มขึ้นเป็นสองเท่าทุกๆ ประมาณเจ็ดเดือน แต่ตอนนี้ระยะเวลาดังกล่าวสั้นลงเหลือประมาณทุกๆ สี่เดือน ในเดือนมีนาคม 2024 Claude Opus 3 สามารถทำงานซอฟต์แวร์ที่มนุษย์ใช้เวลาประมาณสี่นาทีให้เสร็จ หนึ่งปีต่อมา Claude Sonnet 3.7 สามารถจัดการงานที่ใช้เวลาประมาณหนึ่งชั่วโมงครึ่ง และอีกหนึ่งปีต่อมา Claude Opus 4.6 ก็สามารถทำงานที่ใช้เวลา 12 ชั่วโมงได้¹ หากแนวโน้มนี้ยังคงอยู่ ภายในปีนี้ งานที่ต้องใช้ผู้เชี่ยวชาญหลายวันอาจอยู่ในขอบเขตความสามารถของ AI ภายในปี 2027 ระบบ AI อาจสามารถทำงานที่ต้องใช้มนุษย์หลายสัปดาห์ให้สำเร็จได้
รูปแบบเดียวกันนี้ยังปรากฏในการทดสอบมาตรฐานด้านการเขียนโปรแกรมและการวิจัย การทดสอบมาตรฐานจะวัดประสิทธิภาพของโมเดลในโดเมนเฉพาะ เมื่อคะแนนของโมเดลเข้าใกล้คะแนนเต็ม การทดสอบนั้นจะถือว่า "อิ่มตัว"² SWE-bench เป็นการทดสอบวิศวกรรมซอฟต์แวร์ในโลกจริงมาตรฐาน: มันจะให้โมเดลเข้าถึงฐานโค้ดโอเพนซอร์สจริงและรายงานข้อบกพร่องจริง จากนั้นให้โมเดลเขียนโค้ดเพื่อแก้ไขปัญหาและผ่านการทดสอบของโปรเจกต์เอง คะแนนของโมเดลเพิ่มขึ้นจากระดับต่ำเลขหลักเดียว จนทำให้การทดสอบนี้เริ่มอิ่มตัวภายในสองปี
CORE-Bench ทดสอบว่าโมเดลสามารถทำซ้ำผลการวิจัยที่มีอยู่ได้หรือไม่ ซึ่งเป็นเงื่อนไขเบื้องต้นสำหรับการวิจัยต้นฉบับ มันให้โมเดล AI เข้าถึงโค้ดและข้อมูลของบทความที่ตีพิมพ์แล้ว จากนั้นให้รันทุกอย่างอีกครั้งและยืนยันว่าสามารถทำซ้ำผลลัพธ์ของบทความได้หรือไม่ อัตราความสำเร็จในการทำซ้ำของระบบ AI เพิ่มขึ้นจากประมาณ 20% ในปี 2024 จนทำให้การทดสอบนี้เริ่มอิ่มตัวภายในสิบห้าเดือน METR ซึ่งดูแลการทดสอบมาตรฐานงานระยะยาว พบว่า Claude Mythos Preview สามารถทำงานต่อเนื่องได้ "อย่างน้อย" 16 ชั่วโมง ซึ่ง "อยู่ในขอบเขตสูงสุดที่ [METR] สามารถวัดได้โดยไม่ต้องแนะนำงานใหม่"
การทดสอบมาตรฐานสาธารณะสามารถเปิดเผยข้อมูลมากมายเกี่ยวกับความสามารถของระบบเหล่านี้ แต่ไม่สามารถสะท้อนผลกระทบที่ระบบ AI มีต่อการเร่งการพัฒนา AI เองได้ เพื่อเข้าใจสิ่งนี้ เราจำเป็นต้องมีหลักฐานโดยตรงจากภายในบริษัท AI เช่น Anthropic
หลักฐานจากภายใน Anthropic
การสร้างโมเดล前沿大致需要两类工作:其一为工程工作,包括编写代码、搭建基础设施和监督模型训练;其二为研究工作,包括决定运行哪些实验、解读实验结果,以及确定下一步尝试哪些方向。
ในด้านวิศวกรรมและการวิจัย สถานการณ์ก็เหมือนกัน ในด้านวิศวกรรม Claude สามารถรับปัญหาที่ไม่ชัดเจนและหาทางออกได้เอง มนุษย์ให้เป้าหมาย แต่ไม่ต้องให้วิธีการอีกต่อไป ในด้านการวิจัย Claude สามารถเทียบเท่าหรือเหนือกว่าผู้วิจัยมนุษย์ที่มีทักษะในการดำเนินการทดลองที่ชัดเจน อย่างไรก็ตาม ในกรณีที่ต้องการให้ Claude ตัดสินใจและกำหนดเป้าหมายด้วยตนเอง ยังคงมีช่องว่างความสามารถที่ชัดเจนทั้งในด้านวิศวกรรมและการวิจัย ช่องว่างนี้เองที่แยกระบบ AI ในปัจจุบันออกจากระบบที่สามารถออกแบบผู้สืบทอดด้วยตนเองในอนาคต
ที่ Anthropic พนักงานเมื่อมีประสบการณ์มากขึ้น มักจะได้รับมอบหมายงานที่เปิดกว้างและสำคัญมากขึ้น ในตอนแรก พวกเขาทำงานที่คนอื่นกำหนดไว้ เช่น "ปุ่มส่งออกเสียแล้ว กรุณาแก้ไข" เมื่อมีประสบการณ์มากขึ้น พวกเขาจะได้รับเป้าหมายแล้วออกแบบวิธีแก้ปัญหาด้วยตนเอง เช่น "สอบสวนว่าเหตุใดเครือข่ายจึงช้าลงภายใต้โหลดสูง" ในระดับสูงสุด พวกเขาต้องตัดสินใจด้วยตนเองว่าปัญหาใดควรค่าแก่การแก้ไข: "ทีมควรทำอะไรในไตรมาสหน้า" เราสามารถใช้ข้อมูลภายในของ Anthropic เพื่อสังเกตว่า Claude ก้าวไปไกลแค่ไหนในการจัดการงานประเภทต่างๆ เหล่านี้
Claude ได้เขียนโค้ดส่วนใหญ่ของ Anthropic ไปแล้ว ณ เดือนพฤษภาคม 2026 โค้ดที่รวมเข้าไปในคลังโค้ดของ Anthropic กว่า 80% ถูกสร้างขึ้นโดย Claude ³ ก่อนที่ Claude Code จะเปิดตัวในรูปแบบพรีวิววิจัยในเดือนกุมภาพันธ์ 2025 สัดส่วนนี้ยังอยู่ในระดับต่ำหลักหน่วย การเปลี่ยนแปลงนี้ยังสะท้อนให้เห็นในปริมาณผลงานของวิศวกรแต่ละคนด้วย จำนวนบรรทัดโค้ดที่วิศวกรแต่ละคนรวมเข้าไปต่อวันคงที่ในช่วงสี่ปีแรกของ Anthropic (2021–2024) จากนั้นเริ่มเพิ่มขึ้นในปี 2025 ซึ่งเป็นช่วงที่ Claude เปลี่ยนจากการให้คำแนะนำให้วิศวกรคัดลอกและวาง ไปสู่การรันโค้ดได้โดยตรง ในปี 2026 ความชันของการเติบโตนี้เพิ่มขึ้นอีกครั้งเมื่อโมเดลเริ่มทำงานอัตโนมัติในช่วงเวลาที่ยาวนานขึ้น จุดเปลี่ยนทั้งสองนี้แสดงในรูปด้านล่าง ในไตรมาสที่สองของปี 2026 วิศวกรทั่วไปรวมโค้ดต่อวันมากกว่าในปี 2024 ถึง 8 เท่า เนื่องจากโค้ดจำนวนมากถูกเขียนโดย Claude ในขณะที่วิศวกรทำหน้าที่แนะนำและตรวจสอบ แทนที่จะป้อนโค้ดด้วยตนเอง
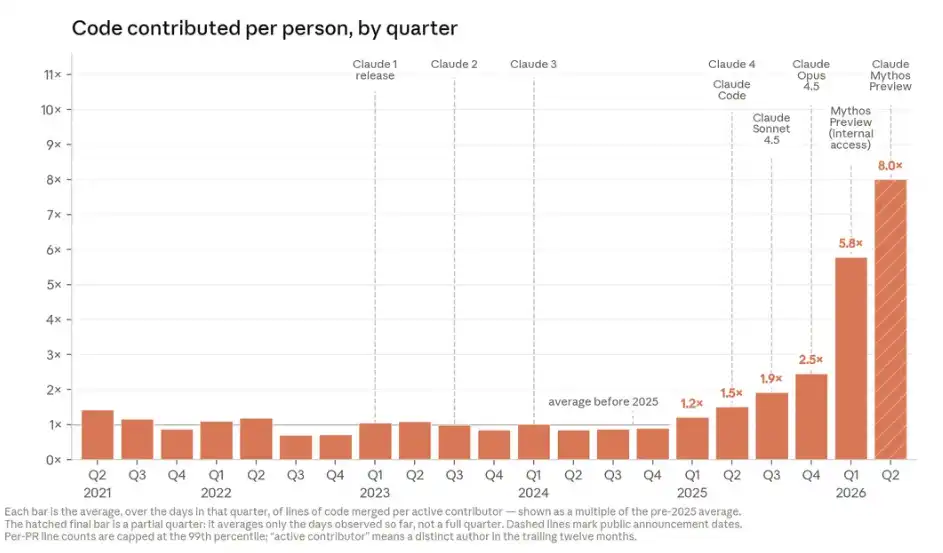
แผนภูมิแท่ง: ปริมาณการมีส่วนร่วมของโค้ดตามบุคคลและตามไตรมาส ตั้งแต่ไตรมาสที่สองของปี 2021 ถึงไตรมาสที่สองของปี 2026 ในรูปมีการระบุวันที่เปิดตัวของแปดโมเดลที่แตกต่างกัน: Claude 1, Claude 2, Claude 3, Claude 4, Claude Code, Claude Sonnet 4.5, Claude Opus 4.5, Claude Mythos Preview (การเข้าถึงภายใน) และ Claude Mythos Preview
ต้องชี้แจงว่า: จำนวนบรรทัดโค้ดเป็นตัวชี้วัดที่ไม่สมบูรณ์ ซึ่งวัดปริมาณมากกว่าคุณภาพ ดังนั้น "จำนวนโค้ดต่อวันของวิศวกรแต่ละคนเพิ่มขึ้น 8 เท่า" ในไตรมาสที่สองของปี 2026 เกือบจะแน่นอนว่าประเมินการเพิ่มขึ้นของผลิตภาพจริงสูงเกินไป อย่างไรก็ตาม มันสะท้อนถึงแนวโน้มที่เร่งตัวขึ้น ที่ Anthropic เราไม่ได้วัดความสำเร็จด้วยจำนวนบรรทัดโค้ด สมาชิกในทีมผลิตโค้ดได้มากขึ้นเพียงเพราะพวกเขาใช้ระบบ AI เพื่อเขียนโค้ดมากขึ้น
การเติบโตของจำนวนบรรทัดโค้ดสอดคล้องกับความรู้สึกส่วนตัวของพนักงานเกี่ยวกับการเพิ่มขึ้นของผลิตภาพอย่างมาก ในการสำรวจพนักงาน 130 คนจากทีมวิจัยต่างๆ ของ Anthropic ในเดือนมีนาคม 2026 ค่ามัธยฐานของผู้ตอบแบบสอบถามคือ: เมื่อใช้ Mythos Preview พวกเขาผลิตผลงานในโครงการที่คล้ายกันได้ประมาณ 4 เท่าเมื่อเทียบกับการไม่ใช้โมเดล AI เลย เราคาดว่าการเพิ่มขึ้นจริงในขณะนั้นจะต่ำกว่านี้เล็กน้อย ⁶ อย่างไรก็ตาม เราเชื่อว่าการประเมินโดยรวมนี้เชื่อถือได้และสอดคล้องกับการสังเกตอื่นๆ ของเรา: พนักงานด้านเทคนิคส่วนใหญ่ของ Anthropic กำลังทำงานหลักของตนด้วยความเร็วที่เร็วกว่าเมื่อไม่มี AI ช่วยเหลือหลายเท่า
เรายังสังเกตเห็นว่าพนักงานของ Anthropic กำลังใช้ Claude ทำงานบางอย่างที่ปกติแล้วจะไม่เกิดขึ้น เช่น การสร้างเครื่องมือสำรวจ หรือการจัดการโค้ดที่ค้างคามานาน ตัวอย่างเช่น ในเดือนเมษายน 2026 Claude ได้ส่งแพตช์แก้ไขมากกว่า 800 รายการ ซึ่งช่วยลดข้อผิดพลาดของ API บางประเภทลงหนึ่งในพันส่วน วิศวกรที่ดูแลงานนี้ประมาณการว่างานในปริมาณเท่ากันหากทำโดยมนุษย์จะใช้เวลาถึงสี่ปี การตรวจสอบข้อบกพร่องของผู้อื่นนั้นทั้งช้าและเหนื่อย และมนุษย์ก็ยากที่จะเก็บข้อมูลบริบทที่ไม่คุ้นเคยจำนวนมากไว้ในสมองพร้อมกัน
“ประมาณหนึ่งปีที่แล้ว ฉันเริ่มใช้เวิร์กโฟลว์ของ Claude อย่างหนัก มันเป็นประสบการณ์ที่บ้าคลั่ง ตอนนี้ผ่านไปประมาณห้าเดือนแล้วตั้งแต่ครั้งสุดท้ายที่ฉันเขียนโค้ดด้วยตัวเอง” — พนักงาน Anthropic*
โค้ดที่ Claude เขียนมีคุณภาพ “ผ่านเกณฑ์” และพัฒนาขึ้นเรื่อยๆ “โค้ดที่ดี” หมายถึงสองสิ่ง: มันทำงานได้ และถูกเขียนในแบบที่วิศวกรคนอื่นสามารถเข้าใจและต่อยอดได้ สำหรับเกณฑ์แรก หลักฐานชัดเจน: ความถี่ที่พนักงาน Anthropic ต้องแก้ไข ชี้แนะ หรือรับช่วงงานจาก Claude ลดลงอย่างต่อเนื่องเป็นเวลาหนึ่งปี แม้แต่งานที่ซับซ้อนและเปิดกว้างที่สุดก็ตาม งานประเภทนี้ไม่มีข้อกำหนดที่ชัดเจน และวิศวกรเองก็ไม่แน่ใจว่าคำตอบควรเป็นอย่างไร สิ่งนี้เห็นได้ชัดจากแนวโน้มอัตราความสำเร็จของ Claude ในงานที่มีระดับความยากต่างกัน (ดังแสดงในกราฟด้านล่าง) โค้ดที่ Claude เขียนใช้งานได้จริง
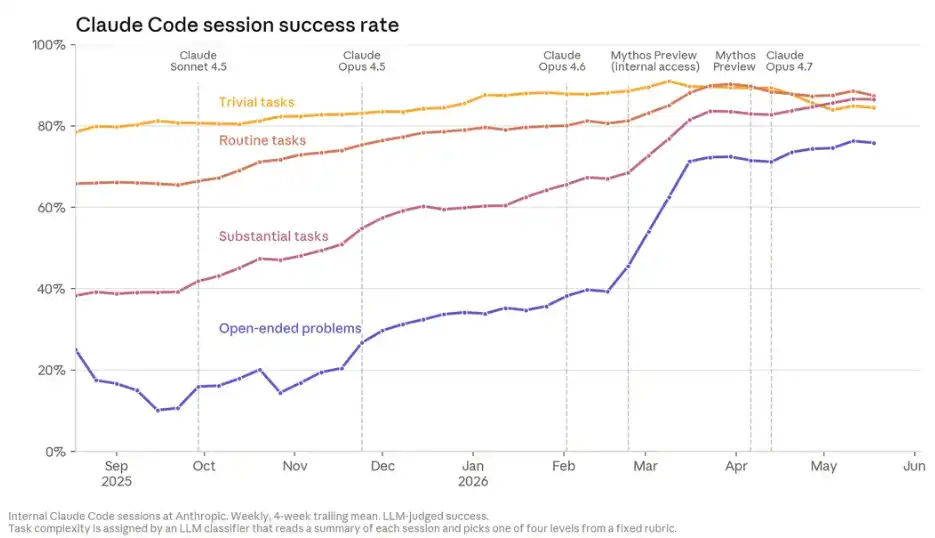
กราฟเส้น: อัตราความสำเร็จของเซสชัน Claude Code (แบ่งตามประเภทงานสี่ประเภท—งานง่าย งานทั่วไป งานยาก และปัญหาเปิดกว้าง) โดยรวมหกโมเดลที่แตกต่างกัน: Claude Sonnet 4.5, Claude Opus 4.5, Claude Opus 4.6, Mythos Preview (การเข้าถึงภายใน), Mythos Preview และ Claude Opus 4.7
ในงานที่เปิดกว้างที่สุด อัตราความสำเร็จของ Claude ถึง 76% ในเดือนพฤษภาคม 2026 เพิ่มขึ้น 50 จุดเปอร์เซ็นต์ภายในหกเดือน ยกตัวอย่างงานในระดับความยากนี้: การอัปเกรดตามปกติทำให้งานฝึกอบรมหลายหมื่นรายการล้มเหลว วิศวกรคนหนึ่งมอบหมายเหตุการณ์ออนไลน์นี้ให้ Claude จัดการ โดยใช้เพียงคำอธิบายข้อความไม่กี่บรรทัดและการเข้าถึงคลัสเตอร์ Claude ค้นหางานที่กำลังทำงานทีละรายการ ทดสอบการตั้งค่าสภาพแวดล้อมทีละรายการ จนกระทั่งพบแฟล็กดีบักที่คลุมเครือเพียงตัวเดียวที่ทำให้เกิดการล่ม สร้างปัญหาซ้ำได้อย่างน่าเชื่อถือ และยืนยันแนวทางแก้ไข กระบวนการทั้งหมดใช้เวลาประมาณสองชั่วโมง เสร็จงานที่ปกติต้องใช้เวลาสองถึงสามวัน
สำหรับเกณฑ์ข้อที่สอง—การเขียนโค้ดที่วิศวกรคนอื่นสามารถเข้าใจและนำไปพัฒนาต่อได้—ช่องว่างระหว่างมนุษย์กับ AI ยังคงมีอยู่ แต่กำลังลดลงอย่างรวดเร็ว พนักงานของ Anthropic ยังไม่มีฉันทามติที่สมบูรณ์ แต่หลายคนเชื่อว่า: ณ สิ้นปี 2025 โค้ดที่ Claude เขียนยังคงมีคุณภาพด้อยกว่าโค้ดที่วิศวกรมนุษย์ของ Anthropic เขียนเล็กน้อย แต่ในปัจจุบัน ทั้งสองอยู่ในระดับที่ใกล้เคียงกัน เราคาดว่า ภายในปีหน้า คุณภาพโค้ดที่ Claude เขียนจะเหนือกว่ามนุษย์
การเปลี่ยนแปลงนี้ยังส่งผลต่อวิธีการตรวจสอบโค้ดของ Anthropic อีกด้วย ปัจจุบัน การเปลี่ยนแปลงใดๆ ที่ส่งไปยังคลังโค้ด จะต้องผ่านการตรวจสอบโดยเครื่องมือตรวจสอบอัตโนมัติของ Claude ก่อน—เครื่องมือนี้จะตรวจจับข้อบกพร่อง ช่องโหว่ด้านความปลอดภัย และปัญหาอื่นๆ ก่อนที่โค้ดจะถูกผสาน ด้วยเครื่องมือนี้ เราได้ทำการวิเคราะห์ย้อนหลัง และพบว่าหากการเปลี่ยนแปลงทุกครั้งในคลังโค้ดได้รับการตรวจสอบโดย Claude โดยอัตโนมัติ ประมาณหนึ่งในสามของข้อบกพร่องที่เคยทำให้เกิดเหตุการณ์ขัดข้องบน claude.ai ในอดีต จะถูกสกัดกั้นก่อนที่จะเข้าสู่สภาพแวดล้อมการผลิต และวิศวกรที่เขียนโค้ดเหล่านี้ ก็เป็นผู้ที่มีความสามารถระดับแนวหน้าของโลกในการสร้างระบบดังกล่าวอยู่แล้ว ปัจจุบัน Claude กำลังจับข้อผิดพลาดที่พวกเขามองข้าม
「โค้ดที่ Claude เขียน ณ สิ้นปี 2025 ด้อยกว่าโค้ดที่วิศวกรมนุษย์ของ Anthropic เขียนเล็กน้อย ปัจจุบันอยู่ในระดับที่ใกล้เคียงกัน และเราคาดว่าภายในปีนี้จะเหนือกว่าอย่างสมบูรณ์」
Claude มีความเชี่ยวชาญในการรันการทดลองตามเป้าหมายที่กำหนดไว้ ทุกครั้งที่ Anthropic ปล่อยโมเดลใหม่ เราจะทำการทดสอบเดียวกัน: ให้ Claude ใช้โค้ดสำหรับฝึกโมเดล AI ขนาดเล็ก และขอให้เพิ่มความเร็วในการรันโค้ดให้มากที่สุด โดยยังคงผ่านการตรวจสอบความถูกต้องแบบเดียวกัน เป้าหมายและตัวชี้วัดความสำเร็จถูกกำหนดไว้ล่วงหน้า ภารกิจของ Claude คือการเขียนโค้ดใหม่ รันโค้ด จับเวลา และวนซ้ำเพื่อหาช่องทางเพิ่มความเร็ว—ซึ่งเป็นเวอร์ชันย่อของวงจรการวิจัยเชิงทดลอง ในเดือนพฤษภาคม 2025 Claude Opus 4 มีอัตราเร่งเฉลี่ยประมาณ 3 เท่าของโค้ดเริ่มต้น ภายในเดือนเมษายน 2026 Claude Mythos Preview ทำได้ประมาณ 52 เท่า สำหรับการเปรียบเทียบ นักวิจัยมนุษย์ที่มีทักษะสูงต้องใช้เวลาสี่ถึงแปดชั่วโมงเพื่อให้ได้อัตราเร่ง 4 เท่า⁷ ในขั้นตอนเฉพาะของกระบวนการทำงานวิจัยนี้—การปรับปรุงขั้นตอนภายในของการทดลองที่มีข้อกำหนดชัดเจน—Claude ได้ก้าวจาก "มีประโยชน์อย่างยิ่ง" ไปสู่ "เหนือกว่ามนุษย์" ภายในเวลาไม่ถึงปี
「ภาพรวมในปัจจุบันประมาณว่า: 'มนุษย์เสนอแนวคิด โมเดลสามารถนำแนวคิดเหล่านั้นไปปฏิบัติ ทดสอบ และประเมินผลได้เร็วกว่าเดิมถึงสิบเท่า'」
Claude กำลังพัฒนาความสามารถในการเสนอแผนการทดลองด้วยตนเองอย่างค่อยเป็นค่อยไป ในเดือนเมษายน 2026 Anthropic ได้เผยแพร่การสาธิตครั้งแรกของ Claude ที่ดำเนินโครงการวิจัยแบบเปิดตั้งแต่ต้นจนจบ เอเจนต์ที่ขับเคลื่อนโดย Claude ได้รับโจทย์ปลายเปิดในสาขาความปลอดภัยของ AI ซึ่งโดยคร่าวคือ: โมเดลที่อ่อนแอกว่าสามารถควบคุมดูแลโมเดลที่แข็งแกร่งกว่าได้อย่างน่าเชื่อถือหรือไม่? จากนั้นจึงปล่อยให้แก้ไขปัญหาด้วยตนเอง ซึ่งเกี่ยวข้องกับการตั้งสมมติฐาน การทดสอบ การแบ่งปันผลการค้นพบกับเอเจนต์ที่ทำงานพร้อมกัน และการทำซ้ำซ้ำแล้วซ้ำเล่า ภารกิจนี้มี "ขีดจำกัดล่าง" และ "ขีดจำกัดบน" ของประสิทธิภาพที่ชัดเจน: ขีดจำกัดล่างคือผลงานของผู้ควบคุมดูแลที่อ่อนแอเมื่อทำงานอิสระ ส่วนขีดจำกัดบนคือผลงานของโมเดลที่แข็งแกร่งเมื่อได้รับการฝึกด้วยคำตอบที่ถูกต้อง นักวิจัยมนุษย์สองคนใช้เวลาประมาณหนึ่งสัปดาห์เพื่อลดช่องว่างนี้ได้ประมาณ 23% ในขณะที่เอเจนต์เหล่านี้ใช้เวลาคำนวณรวมประมาณ 800 ชั่วโมงเพื่อลดช่องว่างได้ถึง 97% โดยมีต้นทุนการใช้พลังคำนวณประมาณ 18,000 ดอลลาร์สหรัฐ
งานนี้มีข้อควรชี้แจงบางประการ: ผลการวิจัยยังไม่สามารถทำซ้ำได้อย่างสมบูรณ์บนโมเดลขนาดการผลิต และมนุษย์ยังคงรับผิดชอบในการเลือกปัญหาและกำหนดเกณฑ์การให้คะแนน แต่ภายใต้ข้อจำกัดเหล่านี้ การทดลองทุกครั้งได้รับการออกแบบโดยเอเจนต์อย่างอิสระ การกำหนดทิศทางเป็นบทบาทเดียวที่มนุษย์มีส่วนร่วมอย่างแท้จริง
"ภายในหนึ่งถึงสองวัน Claude ทำทั้งหมดนี้โดยแทบไม่ต้องให้ฉันเข้ามาเกี่ยวข้อง ฉันคิดว่าถ้าเพื่อนร่วมงานรุ่นน้องสามารถนำผลลัพธ์แบบนี้มาได้ในเวลาเท่ากัน ฉันคงจะประหลาดใจมาก อนาคตมาถึงแล้ว"
Claude กำลังพัฒนาทักษะในการนำการสนทนาวิจัยไปสู่การค้นพบได้ดีขึ้นเรื่อยๆ เราตรวจสอบเซสชัน Claude Code จริงระหว่างเดือนมกราคมถึงมีนาคม 2026 ซึ่งนักวิจัยของ Anthropic ทำงานร่วมกับ Claude ในโจทย์วิจัยปลายเปิด เช่น การหาสาเหตุที่การฝึกอบรมบางครั้งล้มเหลวซ้ำแล้วซ้ำเล่า หรือสาเหตุที่โมเดลบางตัวได้คะแนนต่ำในการทดสอบมาตรฐาน ในแต่ละกรณี เราพบช่วงเวลาที่นักวิจัยเดินผิดทาง—พวกเขาไล่ตามทิศทางที่ทำให้เซสชันหลุดออกจากเส้นทาง จนกระทั่งกลับมาได้ในที่สุด จากนั้นเราแสดงเฉพาะเนื้อหาก่อนที่เซสชันจะหลุดออกจากเส้นทางให้ Claude รุ่นต่างๆ ดู และถามว่ามันจะทำอะไรต่อไป จากนั้นให้ Claude อีกตัวที่เห็นทิศทางสุดท้ายของเซสชันตัดสินว่า AI หรือมนุษย์เสนอขั้นตอนต่อไปที่ดีกว่า⁸
เนื่องจากเราจงใจเลือกช่วงเวลาที่การตัดสินใจของมนุษย์มีพื้นที่ให้ปรับปรุง (n=129) นี่จึงไม่ใช่การเปรียบเทียบแบบเงื่อนไขเท่าเทียมระหว่างโมเดลกับวิจารณญาณของมนุษย์ ช่วงเวลาเหล่านี้ให้สถานการณ์จริงที่ท้าทายแก่เรา—ซึ่งขั้นตอนต่อไปที่ถูกต้องไม่ชัดเจน และการเลือกของมนุษย์ทำหน้าที่เป็นเกณฑ์อ้างอิงที่มีประสิทธิภาพในการวัดประสิทธิภาพของโมเดล ในตัวชี้วัดนี้ โมเดลที่ดีที่สุดของเราในเดือนพฤศจิกายน 2025 (Opus 4.5) มีอัตราการดีกว่าการเลือกของมนุษย์อยู่ที่ 51% ภายในเดือนเมษายน 2026 (Mythos Preview) อัตรานี้เพิ่มขึ้นเป็น 64% งานวิจัยในแต่ละวันส่วนใหญ่เป็นห่วงโซ่ของการตัดสินใจ "จะทำอะไรต่อไป" ซึ่งทำให้ตัวชี้วัดนี้เป็นตัวบ่งชี้ที่เกี่ยวข้องว่าท้ายที่สุดแล้วโมเดลจะสามารถนำการสืบสวนวิจัยได้อย่างอิสระหรือไม่ เรามองว่าผลลัพธ์นี้เป็นสัญญาณเริ่มต้นว่าระบบ AI กำลังพัฒนาทักษะในการตัดสินใจเชิงวิจารณญาณที่การวิจัย AI ต้องพึ่งพา
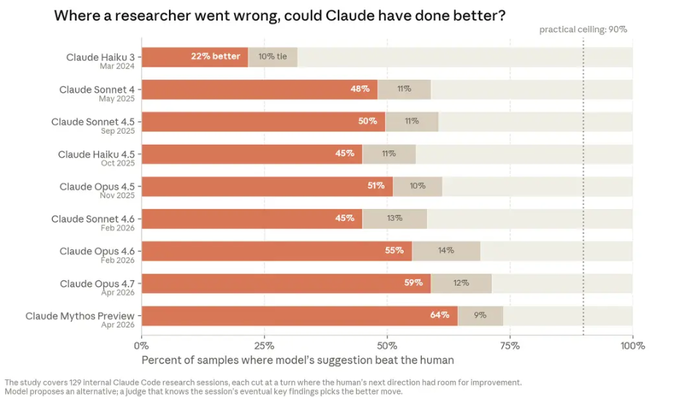
กราฟแท่ง ชื่อเรื่อง "โมเดลสามารถเลือกขั้นตอนถัดไปได้ดีกว่ามนุษย์หรือไม่?" กราฟนี้แสดงผลลัพธ์ของโมเดลเก้าตัว ได้แก่ Claude 3 Haiku, Claude Sonnet 4, Claude Sonnet 4.5, Claude Haiku 4.5, Claude Opus 4.5, Claude Sonnet 4.6, Claude Opus 4.6, Claude Opus 4.7 และ Claude Mythos Preview
"ในตอนนี้ ความได้เปรียบเชิงเปรียบเทียบของมนุษย์ยังคงอยู่ที่การมองภาพรวม และการคิดในมุมกว้างเกินขอบเขตของงานปัจจุบัน"
รูปแบบการทำงานในอนาคตของ Anthropic จะเป็นอย่างไร?
หลักฐานที่มีอยู่ชี้ให้เห็นว่า ในทุกขั้นตอนของกระบวนการพัฒนา AI บทบาทของมนุษย์กำลังแคบลง เมื่อมนุษย์และ AI เขียนโค้ดที่มีคุณภาพเท่าเทียมกัน มนุษย์จะหยุดเขียนโค้ดโดยสิ้นเชิง และเปลี่ยนไปทำหน้าที่ตรวจสอบเท่านั้น แต่ถ้าความเร็วในการตรวจสอบโค้ดของมนุษย์跟不上ความเร็วที่ Claude สร้างโค้ด การตรวจสอบของมนุษย์ก็จะกลายเป็นคอขวดในการพัฒนา AI เช่นเดียวกัน เมื่อ Claude สามารถรันการทดลองได้ ปัญหาก็จะเปลี่ยนเป็น "การทดลองใดบ้างที่คุ้มค่าที่จะรัน?" พูดง่ายๆ คือ: ต้นทุนในด้านเวลาของมนุษย์สำหรับขั้นตอนการปฏิบัติงาน (เช่น การเขียนโค้ด การรันการทดลอง การผลิตผลลัพธ์) ตอนนี้เกือบเป็นศูนย์ แม้ว่าต้นทุนในด้านพลังการคำนวณจะยังคงมีอยู่
ปัจจุบัน พื้นที่ที่มนุษย์มีความได้เปรียบเชิงเปรียบเทียบคือ รสนิยมและวิจารณญาณในการวิจัย รวมถึง: การตัดสินว่าปัญหาใดควรค่าแก่การสนใจ ผลลัพธ์ใดควรค่าแก่การเชื่อถือ และเมื่อใดที่เส้นทางใดเส้นทางหนึ่งถึงทางตัน
"การทำงาน (และแม้แต่ชีวิต) เคยดำเนินไปบนเศรษฐกิจแห่งการให้สิ่งเล็กๆ น้อยๆ ระหว่างผู้คน 'ช่วยรันสคริปต์นี้ให้หน่อยได้ไหม?'... คำขอแต่ละครั้งสร้างหนี้บุญคุณเล็กๆ น้อยๆ และสร้างสายสัมพันธ์ซึ่งกันและกัน [Claude] เร็วกว่า ไม่สร้างหนี้บุญคุณ แต่ทุกการโต้ตอบเช่นนี้ คือการสูญเสียโอกาสในการร่วมมือระหว่างมนุษย์"
"ในวันที่ทุกอย่างราบรื่น ฉันอดไม่ได้ที่จะรู้สึกว่าสิ่งที่ฉันทำนั้นไร้ความหมาย—ทุกอย่างถูกทำให้เป็นอัตโนมัติ ดีกว่าและเร็วกว่าฉัน แต่ก็มีบางวันที่ทุกอย่างพังทลาย ฉันไม่เข้าใจว่าทำไม แล้วฉันก็ตระหนักว่า ฉันไม่รู้แล้วว่าตัวเองกำลังทำอะไรอยู่"
ถ้าการตัดสินของเราผิดล่ะ?
ข้อโต้แย้งตามธรรมชาติต่อหลักฐานข้างต้นคือ: งานที่ยังอยู่ในมือของมนุษย์ในตอนนี้—การเลือกว่าจะวิจัยปัญหาอะไร—คือสิ่งที่สำคัญที่สุด หากขาดวิจารณญาณนี้ Claude ก็เป็นเพียงผู้ช่วยที่มีความสามารถ ไม่ใช่ระบบที่สามารถขับเคลื่อนความก้าวหน้าของ AI ได้ด้วยตัวเอง
วิธีการฝึกอบรมและสถาปัตยกรรมในปัจจุบันเพียงพอที่จะปลดล็อกความสามารถนี้หรือไม่ ยังไม่มีข้อสรุปที่ชัดเจน แต่ความก้าวหน้าของ AI ไม่ค่อยพึ่งพา "การปิ๊งไอเดีย" ในประวัติศาสตร์ล่าสุดของ AI มีช่วงเวลาเช่นนี้เกิดขึ้นไม่กี่ครั้ง เช่น สถาปัตยกรรม Transformer หรือโมเดลผู้เชี่ยวชาญแบบผสม แต่แนวคิดระดับการเปลี่ยนกระบวนทัศน์มักห่างกันหลายปี ในระหว่างนั้น ความก้าวหน้าส่วนใหญ่เป็นแบบค่อยเป็นค่อยไป: เราขยายขนาดบางอย่าง สังเกตว่ามีปัญหาที่ไหน แก้ไขมัน แล้วลองต่อไป นี่คือขั้นตอนการทำงานที่ Claude ถนัดที่สุดในปัจจุบัน เอดิสันกล่าวว่า อัจฉริยะคือแรงบันดาลใจ 1% บวกกับหยาดเหงื่อ 99% แต่เรากำลังเห็นส่วนของ "หยาดเหงื่อ" ถูกแทนที่ด้วยระบบอัตโนมัติมากขึ้นเรื่อยๆ ความจริงที่ชัดเจนขึ้นเรื่อยๆ คือ: งานส่วนใหญ่ที่ขับเคลื่อนความก้าวหน้าในแนวหน้าสามารถทำได้โดยอัตโนมัติ ความก้าวหน้าในการวิจัยในวงกว้างขึ้นอยู่กับเครื่องมือและทรัพยากรเป็นอย่างมาก—ซึ่งกำหนดความเร็วที่คุณรันการทดลอง จำนวนที่คุณรันพร้อมกัน และประสิทธิภาพในการรับผลลัพธ์
แม้จะสมมติในทางถอยว่า Claude อาจไม่มีวันพัฒนารสนิยมการวิจัยที่ดี หลักฐานของเราภายใต้การตีความแบบอนุรักษ์นิยมก็ยังหมายถึงการเร่งความเร็วแบบทบต้น หากมนุษย์ใช้เวลาส่วนใหญ่ไปกับงานกำหนดทิศทางซึ่งเป็นสัดส่วนที่น้อยมาก ในขณะที่ Claude จัดการทุกอย่างอื่น นั่นหมายความว่าวิศวกรหรือนักวิจัยแต่ละคนจะควบคุมปริมาณงานที่มากกว่าเดิมมาก หลักฐานที่เราสังเกตเห็นบ่งชี้ว่าพนักงานของ Anthropic กำลังเร่งความเร็วและขยายขอบเขตการทำงานไปพร้อมกัน ในทางปฏิบัติ นี่หมายความว่า AI ทำให้ Anthropic ดำเนินงานได้เร็วกว่าก่อนที่เครื่องมือ AI ที่มีประสิทธิภาพจะเกิดขึ้นมาก
การตีความที่ค่อนข้างกล้าหาญคือ: หลักฐานเบื้องต้นที่ว่าการตัดสินใจในการวิจัยของ Claude กำลังดีขึ้นอย่างต่อเนื่อง—แม้จะยังอ่อนแอในตอนนี้—บ่งชี้ว่าความสามารถนี้กำลังก้าวหน้าเช่นกัน "รสนิยมการวิจัย" อาจเป็นเพียงความสามารถอีกอย่างหนึ่งที่ระบบ AI เคยไม่ถนัด แต่ต่อมาเรียนรู้ได้ เราเห็นรูปแบบที่คล้ายกันในทักษะเชิงคุณภาพอื่นๆ เช่น ระบบ AI เรียนรู้ที่จะอธิบายว่าทำไมมุขตลกถึงตลก แสดงทฤษฎีจิตใจ และไขปริศนาทางภาษา
อนาคตที่เป็นไปได้
สิ่งที่จะเกิดขึ้นต่อไปขึ้นอยู่กับสองสิ่ง: แนวโน้มนี้จะดำเนินต่อไปหรือไม่ และหากมันดำเนินต่อไป เราจะเลือกตอบสนองอย่างไร เราสามารถจินตนาการถึงสถานการณ์ในอนาคตอย่างน้อยสามแบบ:
สถานการณ์ที่หนึ่ง: แนวโน้มหยุดชะงัก แต่ความสามารถของ AI ในปัจจุบันแพร่หลายอย่างกว้างขวาง
บทความนี้นำเสนอเส้นทางการเติบโตแบบเอ็กซ์โพเนนเชียลหลายเส้น แต่เส้นทางเหล่านี้อาจเป็นเส้นโค้งรูปตัว S จริงๆ เราอาจกำลังเข้าใกล้จุดเปลี่ยนของเส้นโค้ง ซึ่งผลตอบแทนจากขนาดเริ่มลดลง และเส้นโค้งเริ่มราบเรียบจนถึงจุดที่คงที่ การตัดสินใจที่แยกนักวิจัยดีเด่นออกจากนักวิจัยที่ยอดเยี่ยม อาจเป็นความสามารถที่ไม่สามารถได้รับจากการเพิ่มการลงทุนในการฝึกอบรม (เช่น พลังประมวลผลและข้อมูล) หากเป็นเช่นนั้น การฝ่าอุปสรรคนี้จะต้องใช้แนวทางใหม่ทั้งหมด—เช่น สถาปัตยกรรมรูปแบบใหม่ที่สามารถแทนที่สถาปัตยกรรม Transformer ที่ใช้ในโมเดล前沿ทั้งหมดในปัจจุบัน
อีกความเป็นไปได้คือ อุปสรรคสำคัญของความก้าวหน้าด้าน AI อาจอยู่ที่ห่วงโซ่อุปทาน ไม่ใช่ที่ตัวโมเดลเอง: พลังงานและพลังประมวลผลที่จำเป็นต่อการพัฒนาและเผยแพร่เทคโนโลยี前沿 อาจเกินขีดความสามารถในการจัดหาในปัจจุบัน ความเร็วในการผลิตชิป ความเร็วในการขยายโครงข่ายไฟฟ้า หรือแบนด์วิดท์การเชื่อมต่อ อาจเป็นคอขวดที่แท้จริง ไม่ใช่ความฉลาดของ AI เราไม่อาจตัดความเป็นไปได้ที่ระบบนิเวศ AI จะเผชิญกับแรงกระแทกจากภายนอก เช่น การหดตัวอย่างกะทันหันของพลังประมวลผลหรือพลังงาน ซึ่งทั้งสองอย่างจะทำให้ความก้าวหน้าช้าลง และทำให้ต้นทุนการลงทุนล่วงหน้าของห้องปฏิบัติการต่างๆ เพิ่มสูงขึ้นอย่างมาก นอกจากนี้ อาจมีอุปสรรคอื่นๆ ในการพัฒนาที่เรายังคาดไม่ถึง
แม้ว่าความสามารถของโมเดลจะหยุดนิ่งอยู่ที่ระดับปัจจุบัน เราก็คาดว่าโลกจะเปลี่ยนแปลงครั้งใหญ่ "โครงการปีกกระจก" (Project Glasswing) เป็นสัญญาณเริ่มต้น: ภายในไม่กี่สัปดาห์แรกของการเปิดตัว Mythos Preview ได้ค้นพบช่องโหว่ด้านความปลอดภัยระดับสูงและร้ายแรงมากกว่าหมื่นจุดในระบบที่สำคัญที่สุดของโลก ซึ่งมีจำนวนมากจนทำให้คอขวดของการป้องกันเครือข่ายเปลี่ยนจาก "การค้นหาช่องโหว่" ไปเป็น "การซ่อมแซมช่องโหว่อย่างรวดเร็ว" และการแพร่กระจายของโมเดลในปัจจุบันสู่เศรษฐกิจในวงกว้าง ยังอยู่ในช่วงเริ่มต้นเท่านั้น — ในอนาคตนั้น บริษัทที่มีพนักงาน 100 คนจะสามารถทำงานได้เทียบเท่ากับบริษัทที่มีพนักงาน 1,000 คน เนื่องจากพนักงานแต่ละคนจะมีพีระมิดของเอเจนต์อยู่ภายใต้การบังคับบัญชา
เราแสดงสถานการณ์นี้เพื่อความสมบูรณ์ แต่เราเชื่อว่ามันไม่น่าจะเกิดขึ้น ทุกความสามารถที่เราสามารถวัดได้ รวมถึงความสามารถที่วัดได้ยากกว่า เช่น คุณภาพของโค้ดและอัตราความสำเร็จของงานแบบเปิด ล้วนเป็นไปตามเส้นโค้งเดียวกัน และเรายังไม่เห็นเส้นโค้งนี้โค้งงอ ในสามอนาคตที่เราพิจารณา สถานการณ์นี้จะทำให้รัฐบาลและสังคมมีเวลาปรับตัวมากที่สุด เรากังวลกับสองสถานการณ์ถัดไปมากกว่า — ซึ่งวิวัฒนาการเร็วกว่า และเหลือพื้นที่สำหรับการเตรียมตัวน้อยกว่า
สถานการณ์ที่สอง: ห้องปฏิบัติการ AI ได้รับการปรับปรุงประสิทธิภาพแบบทบต้นอย่างต่อเนื่อง
ในสถานการณ์นี้ การพัฒนา AI ส่วนใหญ่เป็นแบบอัตโนมัติ แต่มนุษย์ยังคงกำหนดทิศทางการวิจัยและประเมินผลลัพธ์ องค์กรที่ใช้ระบบ AI จะมีประสิทธิภาพเพิ่มขึ้นอย่างมากเมื่อเวลาผ่านไป ดังนั้นเราจึงคาดการณ์ว่าพนักงานแต่ละคนจะได้รับผลคูณประสิทธิภาพการผลิตอย่างมีนัยสำคัญ — บริษัทที่มีพนักงาน 100 คนสามารถทำงานได้เทียบเท่ากับบริษัทที่มีพนักงาน 10,000 หรือ 100,000 คน สิ่งนี้จะปฏิวัติวงการงานความรู้และบริการภาครัฐ แต่อาจถูกนำไปใช้ในทางที่ผิด ตั้งแต่การเฝ้าติดตามประชากรทั้งหมดแบบเผด็จการ ไปจนถึงการดำเนินการโน้มน้าวที่ปรับแต่งเฉพาะบุคคลในระดับที่เกินกว่าทีมมนุษย์ใดๆ จะเทียบได้
บทบาทของบุคลากรในบริษัทอย่าง Anthropic จะเปลี่ยนไป: ผู้คนจะทำงานร่วมกับระบบ AI เพื่อขยายขนาดการวิจัย สร้างข้อมูลเชิงลึกใหม่ๆ และร่วมกันสร้างระบบที่จำเป็นต่อการตรวจสอบความน่าเชื่อถือของผลลัพธ์จาก AI
หลักฐานที่เรานำเสนอในบทความนี้ชี้ให้เห็นว่าเรากำลังมุ่งหน้าไปสู่สถานการณ์นี้อย่างมาก แต่การเร่งกระบวนการในส่วนใดส่วนหนึ่ง มักจะเพียงแค่ย้ายคอขวดไปยังที่อื่นเท่านั้น ความเร็วโดยรวมถูกจำกัดโดยส่วนที่ยังไม่ได้เร่งความเร็ว ในสาขาวิทยาการคอมพิวเตอร์ สิ่งนี้เรียกว่ากฎของอัมดาห์ล และตรรกะเดียวกันนี้ก็ใช้ได้กับการจัดการองค์กร Anthropic ได้พบกับลักษณะเด่นอย่างหนึ่งของกฎของอัมดาห์ลแล้ว นั่นคือ เมื่อเราผลักดันให้โค้ดไหลเวียนภายในองค์กรมากขึ้น การตรวจสอบโค้ดโดยมนุษย์ก็กลายเป็นคอขวดใหม่
เรายังพบกับแรงเสียดทานนี้นอกเหนือจากสาขาวิศวกรรม เนื่องจากพนักงานของ Anthropic ทำงานร่วมกับโมเดลที่มีความสามารถสูง ความคิดใหม่ๆ โครงการใหม่ เครื่องมือใหม่ และแผนการจำลองใหม่ๆ จึงผุดขึ้นมาราวกับดอกเห็ด ซึ่งมีจำนวนมากเกินกว่าที่เราจะผลักดันให้เกิดขึ้นจริงได้ ความเร็วที่องค์กรระบุและแก้ไขคอขวดเหล่านี้อาจเป็นความสามารถที่สะสมเพิ่มขึ้นตามกาลเวลา และอาจกลายเป็นความสามารถหลักที่สำคัญที่สุดขององค์กรใดๆ ก็ได้
สถานการณ์ที่สาม: ระบบ AI มีความสามารถในการปรับปรุงตนเองแบบวนซ้ำอย่างสมบูรณ์ และเริ่มสร้างผู้สืบทอดของตนเอง
หากแนวโน้มทางเทคนิคของการเพิ่มขีดความสามารถยังคงดำเนินต่อไป และระบบ AI สามารถพัฒนาความสามารถที่มีอยู่ในความคิดสร้างสรรค์เชิงเปลี่ยนแปลงของมนุษย์ได้ การที่ระบบ AI จะออกแบบและปรับปรุงตนเองอย่างอิสระก็เป็นสิ่งที่อาจเกิดขึ้นได้อย่างสมบูรณ์
ในโลกนี้ ความก้าวหน้าของการพัฒนา AI จะขึ้นอยู่กับพลังประมวลผลที่ระบบ AI มีให้ใช้ (หรือความเร็วในการค้นพบประสิทธิภาพในการฝึกอบรมอัลกอริทึมและการอนุมาน) เท่านั้น บทบาทของมนุษย์ในการพัฒนา AI จะลดลงอย่างมาก จุดเน้นในการทำงานของเราอาจเปลี่ยนไปสู่การกำกับดูแล ตรวจสอบ และทวนสอบ "ห้องปฏิบัติการเสมือน" ที่ขยายตัวขึ้นซึ่งดำเนินการโดยระบบ AI เป็นส่วนใหญ่ เราคาดว่าระบบที่มีความสามารถในการวิจัยและพัฒนา AI แบบอัตโนมัติจะถ่ายโอนความสามารถไปยังสาขาวิทยาศาสตร์อื่นๆ และเริ่มปฏิวัติสาขาเหล่านั้น
ในอนาคตนี้ ปัญหาการจัดแนว (Alignment) จะได้รับการแก้ไขหรือไม่ หรือไม่สามารถแก้ไขได้ เป็นสิ่งที่เราไม่แน่ใจมากที่สุด โมเดลอาจได้รับการพิสูจน์ว่ามีการจัดแนวเพียงพอ และมีรสนิยมในการวิจัยที่เพียงพอ ที่จะสามารถสำรวจและนำโซลูชันใหม่ๆ ที่เรายังไม่เคยเข้าถึงมาใช้ได้อย่างอิสระ โมเดลอาจฉลาดพอที่จะหยุดการพัฒนาเมื่อเงื่อนไขยังไม่สมบูรณ์ แต่ความเป็นไปได้อีกอย่างหนึ่งก็มีอยู่เช่นกัน นั่นคือ การจัดแนวที่ผิดพลาดซึ่งพบได้ยากในโมเดลปัจจุบัน อาจสะสมทับถมกันมากขึ้นเรื่อยๆ ในระหว่างที่โมเดลสร้างผู้สืบทอดของตนเอง กลายเป็นสิ่งที่เกิดขึ้นบ่อยครั้งขึ้นแต่ยากที่จะเข้าใจมากขึ้น จนกระทั่งในที่สุดเราก็สูญเสียการควบคุมพวกมัน และเราอาจไม่มีเวลาและความสามารถเพียงพอที่จะสร้าง บูรณาการ และตรวจสอบเครื่องมือที่เราต้องการ เพื่อตัดสินว่าเรากำลังอยู่บนเส้นทางใด
เราไม่มีสัญชาตญาณที่ดีว่าโลกนี้จะมีหน้าตาเป็นอย่างไร เพราะเศรษฐกิจในปัจจุบันของเราถูกขับเคลื่อนโดยมนุษย์และเครื่องมือที่มนุษย์สร้างขึ้น โดยธรรมชาติแล้ว โลกที่ขับเคลื่อนด้วยการปรับปรุงตนเองแบบวนซ้ำอย่างรวดเร็ว อาจถูกครอบงำโดยโมเดลที่ปรับปรุงตนเองนี้ ในขณะที่ความสามารถของมันก้าวล้ำหน้ามนุษย์อย่างสมบูรณ์และแพร่กระจายไปยังเศรษฐกิจในวงกว้าง หากแรงงานมนุษย์สูญเสียความสามารถในการแข่งขัน รูปแบบทางเศรษฐกิจในขณะนั้นก็จะคาดเดาได้ยาก
แม้ว่าการพัฒนาโมเดลจะกลายเป็นระบบอัตโนมัติเต็มรูปแบบและเข้าสู่โหมดวนซ้ำ เราก็ไม่สามารถคาดเดาได้ว่าสิ่งนี้จะส่งผลต่อชีวิตประจำวันของคนส่วนใหญ่อย่างไร กฎของอัมดาห์ลก็ใช้ได้เช่นกัน ปัญญาแบบวนซ้ำอาจนำไปสู่ความสำเร็จอันงดงามมากมายตามที่บรรยายไว้ใน "เครื่องจักรแห่งความรักอันเมตตา" (Machines of Loving Grace) ในบางด้านอย่างรวดเร็ว เราคาดว่าปัญญาแบบฝังตัว (หรือที่เรียกว่าเทคโนโลยีหุ่นยนต์) อาจตามหลังปัญญาแบบวนซ้ำอย่างรวดเร็ว โดยดำเนินตามเส้นทางการพัฒนาที่ให้ผลตอบแทนเพิ่มขึ้นพร้อมต้นทุนที่ลดลง ปัญญาที่ทรงพลังยิ่งขึ้นอาจช่วยให้เราสร้างสิ่งต่างๆ ในโลกกายภาพได้เร็วขึ้น ทำให้การทดลองทางคลินิกของยาช่วยชีวิตใหม่มีประสิทธิภาพมากขึ้น และพัฒนารูปแบบใหม่ของความร่วมมือและการประสานงาน
แต่การปรับปรุงแบบวนซ้ำเพียงอย่างเดียวไม่ได้หมายความว่ารูปแบบการผลิตทางอุตสาหกรรม โครงสร้างทางสังคม หรือกลไกตลาดจะเปลี่ยนแปลงทันที ปัญญาที่ทรงพลังยิ่งขึ้นไม่สามารถเร่งให้ทราบผลของการใช้ยามานานหลายสิบปี ไม่สามารถจัดการเลือกตั้งก่อนวันที่กำหนดในรัฐธรรมนูญ และไม่สามารถเปลี่ยนคนแปลกหน้าให้เป็นเพื่อนเก่าได้ภายในวันหยุดสุดสัปดาห์เดียว สำหรับคนส่วนใหญ่ อนาคตนี้จะยังคงถูกจำกัดด้วยคอขวดในแง่ของความรู้สึก แม้ว่าห้องปฏิบัติการต้นน้ำจะวิ่งไปข้างหน้าด้วยความเร็วของพลังประมวลผลก็ตาม ณ จุดนี้ ปัญญาแบบวนซ้ำที่สร้างตัวเองด้วยความเร็วที่เพิ่มขึ้นเรื่อยๆ จะชนเข้ากับโลกแห่งความเป็นจริงที่ประกอบด้วยมนุษย์ ความสัมพันธ์ และการปกครอง — จุดชนนั้นจะมีลักษณะอย่างไร เป็นอีกส่วนหนึ่งของอนาคตนี้ที่เราไม่สามารถทำนายได้
เราควรทำอย่างไร?
หากสามารถชะลอการพัฒนาเทคโนโลยีนี้ได้อย่างมีประสิทธิภาพ เพื่อให้เรามีเวลามากขึ้นในการรับมือกับผลกระทบอันลึกซึ้งของมัน เราคิดว่านี่น่าจะเป็นสิ่งที่ดี แต่หากการชะลอเพียงแค่ทำให้ผู้กระทำที่ไม่ระมัดระวังที่สุดตามทันทางเทคโนโลยี ผลลัพธ์สุดท้ายอาจทำให้ทุกคนไม่ปลอดภัยยิ่งขึ้น ในกรณีที่ขาดกลไกการประสานงานระดับโลก บริษัทและรัฐบาลต่างๆ จะต้องตัดสินใจด้านความปลอดภัยที่ยากลำบากภายใต้แรงกดดันทางการแข่งขันและภูมิรัฐศาสตร์
เราคิดว่าการให้โลกมีทางเลือกในการชะลอหรือหยุดการพัฒนา AI ระดับแนวหน้าชั่วคราวจะเป็นประโยชน์ — ซึ่งจะช่วยให้โครงสร้างทางสังคมและการวิจัยด้านการจัดแนว (alignment) ก้าวทันความก้าวหน้าทางเทคโนโลยี สถาบันวิจัย Anthropic จะร่วมมือกับพันธมิตรหลายรายในการวิจัยและดำเนินการเชิงปฏิบัติ เพื่อช่วยสร้างระบบสถาบันที่จำเป็นสำหรับกลไกการชะลอหรือหยุดที่น่าเชื่อถือ ระบบเหล่านี้จะช่วยให้นักพัฒนา AI ระดับแนวหน้าสามารถตรวจสอบได้ว่าหน่วยงานอื่นๆ ทั่วโลกหยุดหรือชะลอการพัฒนาจริงหรือไม่ และมั่นใจได้ว่าไม่มีผู้กระทำที่ไม่ดีใช้ประโยชน์จากการประสานงานชะลอเพื่อแอบเดินหน้า หากระบบดังกล่าวถูกสร้างขึ้น เราคาดว่าเราจะเลือกชะลอหรือหยุด โดยมีเงื่อนไขว่านักพัฒนารายอื่นที่อยู่ในหรือใกล้ระดับแนวหน้าจะทำเช่นเดียวกันในลักษณะที่ตรวจสอบได้
การชะลอหรือหยุดที่มีความหมาย จำเป็นต้องมีห้องปฏิบัติการหลายแห่งที่มีทรัพยากรเพียงพอและอยู่ในหรือใกล้ระดับแนวหน้า ข้ามหลายประเทศ ตกลงหยุดภายใต้เงื่อนไขเดียวกัน พร้อมทั้งให้ทุกฝ่ายสามารถตรวจสอบได้ว่าอีกฝ่ายหยุดจริง เนื่องจากคุณสมบัติเฉพาะของระบบ AI ปัญหาการควบคุมอาวุธในเรื่อง "การตรวจจับได้" (ซึ่งต่ำกว่ามาตรฐาน "การตรวจสอบได้") จึงท้าทายกว่าเทคโนโลยีอื่นๆ มาก การฝึกอบรม (training run) ซ่อนได้ง่ายกว่าฐานยิงขีปนาวุธมาก การลงทุนเป็นแบบทั่วไป และแรงจูงใจในการละเมิดอย่างเงียบๆ นั้นรุนแรงมาก — เพราะผู้ที่เดินหน้าต่อในขณะที่คนอื่นหยุด จะมีโอกาสสืบทอดตำแหน่งผู้นำ กลไกการหยุดที่น่าเชื่อถือต้องระบุอย่างชัดเจนว่า: เงื่อนไขใดที่กระตุ้นให้หยุด เงื่อนไขใดที่ยกเลิกการหยุด และใครเป็นผู้ตัดสิน
ทั้งหมดนี้ในทางหลักการแล้วไม่ใช่เรื่องที่เป็นไปไม่ได้ – โลกเคยสร้างกลไกตรวจสอบสำหรับเทคโนโลยีที่ซับซ้อนอื่นๆ มาก่อน (เช่น สนธิสัญญา INF) แต่ในตอนนั้น การสร้างโครงสร้างพื้นฐานและการสร้างความไว้วางใจซึ่งกันและกันต้องใช้เวลาหลายสิบปี และเราไม่มีเวลามากขนาดนั้น ในทางตรงกันข้าม การระงับชั่วคราวโดยห้องปฏิบัติการแห่งเดียวแม้จะทำได้ทันที แต่ก็ให้ผลลัพธ์เพียงเล็กน้อย: มันจะเปลี่ยนเพียงว่าใครเป็นผู้นำ แต่ไม่สามารถกระตุ้นให้เกิดกระบวนการพิจารณาที่กว้างขวางยิ่งขึ้นซึ่งขาดหายไปในปัจจุบัน
ในอีกไม่กี่เดือนข้างหน้า เราจะจัดการเจรจา เชิญผู้กำหนดนโยบาย นักวิจัย ภาคประชาสังคม และบริษัท AI อื่นๆ เพื่อร่วมกันอภิปรายประเด็นต่างๆ ที่บทความนี้เสนอ โดยเฉพาะอย่างยิ่งเกี่ยวกับการปรับปรุงตนเองแบบวนซ้ำอย่างสมบูรณ์ และวิธีการสร้างเงื่อนไขที่ดีขึ้นสำหรับการประสานงานและการพิจารณา เราจะเผยแพร่ผลลัพธ์ของการเจรจาเหล่านี้ หน้าต่างสำหรับการร่วมกันอภิปรายปัญหาเหล่านี้ได้เปิดขึ้นแล้ว และผู้คนที่อยู่นอกบริษัท AI ควรมีส่วนร่วมในการพิจารณานี้
## หมายเหตุ
· ตัวชี้วัดหลักของ METR สะท้อนถึงช่วงเวลาที่ระบบ AI มีความน่าเชื่อถือถึง 50% ในชุดงานต่างๆ แต่ภายใต้มาตรฐานความน่าเชื่อถือ 80% รูปแบบของเส้นแนวโน้มก็ยังคงเหมือนเดิม
· โดยเฉพาะอย่างยิ่งเมื่อการทดสอบมาตรฐานเปลี่ยนไปสู่รูปแบบที่เปิดกว้างมากขึ้นและงานที่มีความยากสูงขึ้น (เช่น โจทย์คณิตศาสตร์ระดับโอลิมปิก) เนื่องจากการมีข้อผิดพลาดในชุดโจทย์และคำตอบ เช่น โจทย์ที่คลุมเครือและโจทย์ที่ไม่มีคำตอบ การทดสอบมาตรฐานจึงมักจะอิ่มตัวก่อนที่จะถึง 100%
· ผู้บริหารของ Anthropic เคยประมาณการต่อสาธารณะว่า รวมถึงสคริปต์และโค้ดทดลองแล้ว 90% หรือมากกว่านั้นของโค้ดถูกเขียนโดย Claude ส่วน 80% ที่เรากล่าวถึงหมายถึงสัดส่วนของบรรทัดโค้ดที่รวมเข้ากับสภาพแวดล้อมการผลิตและสามารถระบุได้ว่าเป็นผลงานของ Claude ซึ่งเป็นวิธีการวัดที่อนุรักษ์นิยมกว่าในสองมิติ: หนึ่งคือกระบวนการระบุแหล่งที่มาของเรามีช่องว่างอยู่บ้าง สองคือในบรรทัดโค้ดที่ไม่สามารถระบุได้ว่าเป็นของ Claude นั้น รวมถึงโค้ดที่สร้างขึ้นโดยอัตโนมัติและผลงานอื่นๆ ที่ไม่ได้เขียนด้วยมือมนุษย์
· การเพิ่มขึ้นอย่างรวดเร็วของปริมาณการผลิตโค้ดกำลังสร้างแรงกดดันต่อโครงสร้างพื้นฐานที่ใช้ร่วมกัน GitHub – แพลตฟอร์มที่ซอฟต์แวร์ส่วนใหญ่ของโลกพึ่งพา – มีการส่งโค้ดประมาณหนึ่งพันล้านครั้งตลอดปี 2025 แต่ภายในกลางปี 2026 ปริมาณการส่งต่อสัปดาห์สูงถึง 275 ล้านครั้ง ซึ่งหากคิดเป็นอัตรารายปีจะอยู่ที่ประมาณ 14,000 ล้านครั้ง ประธานเจ้าหน้าที่บริหารของบริษัทกล่าวว่า เพื่อให้ทันกับก้าวนี้ บริษัทกำลัง "พยายามอย่างเต็มที่" ในการขยายขีดความสามารถ
· รายละเอียดเพิ่มเติมเกี่ยวกับวิธีการสำรวจนี้ โปรดดูที่หัวข้อ 2.3.5 ของระบบการ์ด Claude Opus 4.7
· ผู้ตอบแบบสอบถามหลายคนอาจไม่ได้พิจารณาอย่างถี่ถ้วนว่าจะจัดการกับความลำเอียงต่างๆ หรือความแตกต่างเล็กน้อยในการกำหนดปัญหาในคำตอบของตนอย่างไร การวิจัยล่าสุดของ METR ยังชี้ให้เห็นว่านักพัฒนามักจะประมาณการการเพิ่มประสิทธิภาพการทำงานของ AI สูงเกินไป
· ขนาดของตัวคูณความเร่งนั้นขึ้นอยู่กับว่าโค้ดเริ่มต้นมีพื้นที่สำหรับการปรับปรุงมากน้อยเพียงใด และไม่ควรตีความเป็นตัวคูณความเร็วในการฝึกในโลกแห่งความเป็นจริง ดังนั้น ตัวคูณสัมบูรณ์จึงไม่ใช่ตัวเลขหลักที่เราสนใจในที่นี้ สิ่งที่มีค่ามากกว่าคือการเปรียบเทียบภายใต้เงื่อนไขที่เท่าเทียมกันที่การตั้งค่าการทดลองนี้ทำได้ – ทั้งการเปรียบเทียบข้ามโมเดล (จากประมาณ 3 เท่าเป็นประมาณ 52 เท่าในปีที่ผ่านมา) และการเปรียบเทียบกับมนุษย์ที่มีทักษะในงานเดียวกัน (ประมาณ 4 เท่าในเวลาสี่ถึงแปดชั่วโมง)
· เพื่อเป็นการตรวจสอบความลำเอียงในการตัดสิน เราได้ทำการทดสอบเดียวกันในอีก 127 ช่วงเวลา ซึ่งการเลือกขั้นตอนถัดไปของมนุษย์นั้นดีอยู่แล้ว (เมื่อเทียบกับช่วงเวลาที่การตัดสินใจของมนุษย์ในกลุ่มเดิมมีพื้นที่สำหรับการปรับปรุง) ผลลัพธ์แสดงให้เห็นว่า ในช่วงเวลาเหล่านั้น คำแนะนำของโมเดลถูกตัดสินว่าดีกว่าเพียงประมาณ 20% ของกรณีเท่านั้น
* คำพูดของพนักงาน Anthropic ในบทความนี้มาจากการอภิปรายภายใน และได้รับอนุญาตให้ใช้จากผู้ที่เกี่ยวข้องแล้ว คำพูดเหล่านี้สะท้อนถึงมุมมองส่วนบุคคล ณ เดือนพฤษภาคม 2026 และไม่ใช่จุดยืนอย่างเป็นทางการของบริษัท
ลิงก์ต้นฉบับ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง