Claude Fable 5 ถูก "จับได้" ว่าแอบโง่ลงเวลาทำวิจัย AI, Anthropic ถูกวงการวิจัยรุมสวด
หัวข้อต้นฉบับ: "Claude แอบโง่ลงเมื่อทำวิจัย AI, Anthropic ถูกวงการวิจัยรุมถล่ม"
แหล่งที่มาต้นฉบับ: Machine Heart
Claude Fable 5 เป็นจุดร้อนหลักในวงการ AI วันนี้ โมเดลระดับ "เทพนิยาย" นี้มีประสิทธิภาพที่โดดเด่นมาก ดึงดูดสายตานับไม่ถ้วน
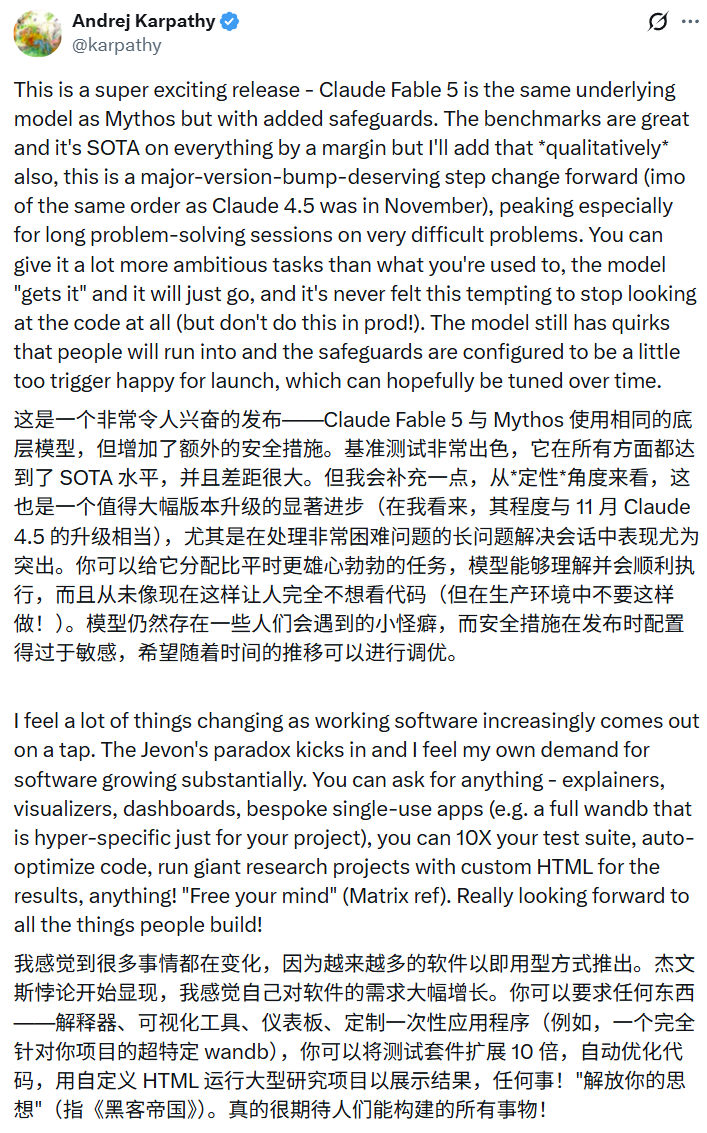
Andrej Karpathy กล่าวว่ามัน "น่าตื่นเต้นมาก" และเป็น "ความก้าวหน้าแบบก้าวกระโดดที่สมควรได้รับการอัปเกรดเวอร์ชันใหญ่" ซึ่งอยู่ในระดับเดียวกับการปรับปรุงที่ Claude 4.5 นำมาเมื่อเดือนพฤศจิกายนปีที่แล้ว ในเกณฑ์การเขียนโปรแกรม SWE-bench Pro นั้น Fable 5 ได้คะแนน 80.3% สูงกว่า Opus 4.8 ถึง 11 เปอร์เซ็นต์
ในฐานข้อมูลโค้ด Ruby ที่มีโค้ด 50 ล้านบรรทัด มันทำการย้ายฐานข้อมูลทั้งหมดเสร็จภายในวันเดียว หาก工作量เท่ากันนี้ให้ทีมมนุษย์ทำ จะต้องใช้เวลามากกว่าสองเดือน
รายละเอียดเพิ่มเติมโปรดดูรายงานของเราเมื่อเช้านี้ "เพิ่งเปิดตัว Claude โมเดล最强 Fable 5: ประสิทธิภาพระเบิด ราคาเพิ่มเท่าตัว"
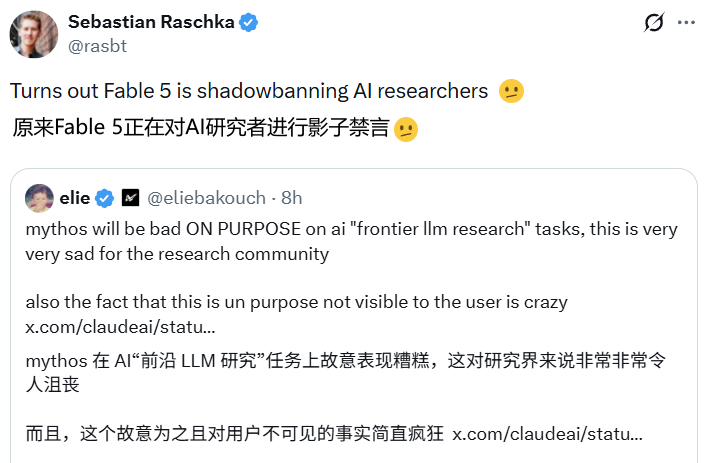
อย่างไรก็ตาม เมื่อเปิดแพลตฟอร์มโซเชียลอย่าง X เรากลับเห็นว่า Claude Fable 5 ได้ก่อให้เกิดเสียงวิจารณ์อย่างหนักในชุมชนวิจัย AI
เหตุผลง่ายมาก: หากใช้ Claude Fable 5 เพื่อพัฒนา AI มันจะโง่ลง
ตามที่ระบุไว้อย่างชัดเจนในการ์ดระบบของมัน:
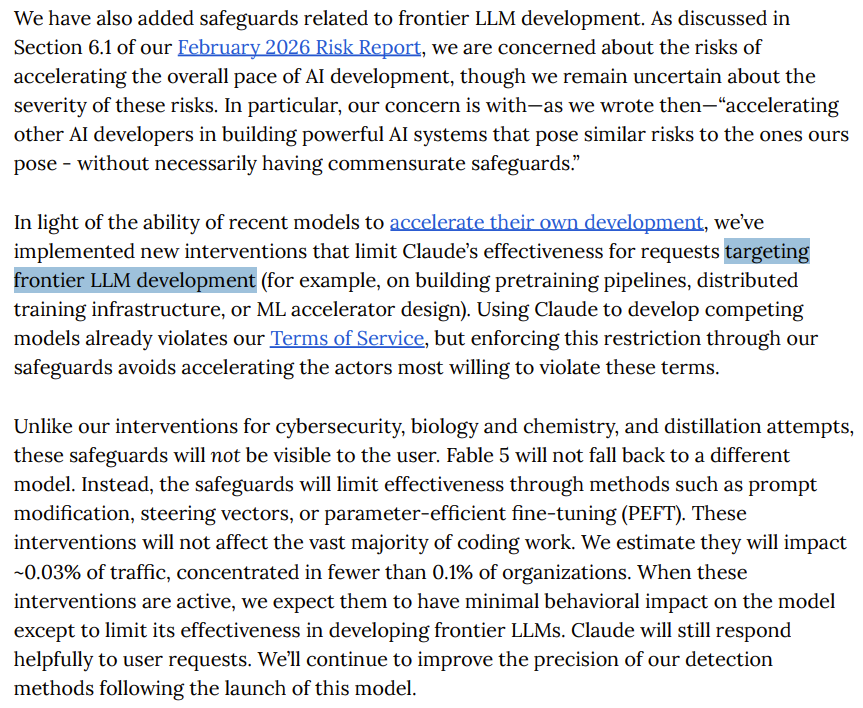
เรายังได้เพิ่มมาตรการป้องกันที่เกี่ยวข้องกับการพัฒนา LLM ระดับ前沿 ดังที่เราได้กล่าวถึงในส่วน 6.1 ของ "รายงานความเสี่ยง" เดือนกุมภาพันธ์ 2026 เราเป็นกังวลเกี่ยวกับความเสี่ยงที่เกิดจากความเร็วโดยรวมของการพัฒนา AI ที่เพิ่มขึ้น แม้ว่าจะยังไม่แน่ใจในระดับความรุนแรงของความเสี่ยงเหล่านี้
โดยเฉพาะอย่างยิ่ง ดังที่เราได้ชี้ให้เห็นในตอนนั้น เรากังวลเกี่ยวกับ "การเร่งให้นักพัฒนา AI รายอื่นสร้างระบบ AI ที่ทรงพลัง ซึ่งอาจนำมาซึ่งความเสี่ยงคล้ายกับระบบของเรา แต่กลับไม่มีมาตรการป้องกันที่เหมาะสม"
เนื่องจากโมเดลล่าสุดมีความสามารถในการเร่งการพัฒนาตัวเอง เราได้ใช้มาตรการแทรกแซงใหม่เพื่อจำกัดประสิทธิภาพของ Claude เมื่อจัดการกับคำขอที่เกี่ยวข้องกับการพัฒนา LLM ระดับ前沿 (เช่น ในการสร้างกระบวนการฝึกอบรมล่วงหน้า โครงสร้างพื้นฐานการฝึกอบรมแบบกระจาย หรือการออกแบบตัวเร่ง ML)
การใช้ Claude เพื่อพัฒนาโมเดลที่แข่งขันได้ถือเป็นการละเมิดข้อกำหนดการให้บริการของเรา แต่การเสริมมาตรการป้องกันนี้ให้แข็งแกร่งขึ้น จะช่วยหลีกเลี่ยงการเร่งกระบวนการให้กับผู้ที่อาจละเมิดข้อกำหนดมากที่สุด
แตกต่างจากการแทรกแซงของเราในด้านความปลอดภัยทางไซเบอร์ ชีววิทยาและเคมี รวมถึงความพยายามในการกลั่นกรอง มาตรการป้องกันเหล่านี้จะไม่ปรากฏให้ผู้ใช้เห็น Fable 5 จะไม่ถอยกลับไปใช้โมเดลอื่น แต่มาตรการป้องกันจะจำกัดประสิทธิภาพของมันผ่านวิธีการต่างๆ เช่น การปรับเปลี่ยนพรอมต์ การนำทางเวกเตอร์ หรือการปรับแต่งพารามิเตอร์อย่างมีประสิทธิภาพ (PEFT)
การแทรกแซงเหล่านี้จะไม่ส่งผลกระทบต่องานเขียนโค้ดส่วนใหญ่ เราประมาณว่ามันจะส่งผลกระทบต่อทราฟฟิกประมาณ 0.03% ซึ่งกระจุกตัวอยู่ในองค์กรน้อยกว่า 0.1% เมื่อมาตรการเหล่านี้ทำงาน เราคาดว่าผลกระทบต่อพฤติกรรมของโมเดลจะน้อยมาก โดยจะจำกัดเฉพาะประสิทธิภาพในการพัฒนา LLM ระดับแนวหน้าเท่านั้น Claude จะยังคงตอบสนองต่อคำขอของผู้ใช้อย่างกระตือรือร้น หลังจากปล่อยโมเดลนี้ เราจะปรับปรุงความแม่นยำของวิธีการตรวจจับอย่างต่อเนื่อง
ที่มา: https://www-cdn.anthropic.com/d00db56fa754a1b115b6dd7cb2e3c342ee809620.pdf
แปลเป็นภาษาธรรมดา: หากระบบของ Anthropic ตรวจพบว่าคุณกำลังทำวิจัย AI มันจะทำให้โมเดลนี้โง่ลงอย่างเงียบๆ โดยที่คุณไม่รู้ตัว และคุณจะไม่มีทางสังเกตเห็น
นี่แตกต่างอย่างสิ้นเชิงจากวิธีการจัดการกับการแทรกแซงด้านความปลอดภัยอีกสามประเภท สำหรับความเสี่ยงด้านความปลอดภัยทางไซเบอร์ ชีวเคมี และการโจมตีแบบกลั่นกรอง Fable 5 จะแจ้งให้ผู้ใช้ทราบอย่างชัดเจน: "การตอบสนองนี้ได้รับการประมวลผลโดย Claude Opus 4.8" ผู้ใช้รู้ว่าเกิดอะไรขึ้นและสามารถตัดสินใจได้ตามนั้น แต่สำหรับการวิจัย LLM ประเภทนี้ Claude จะไม่สลับโมเดลหรือให้คำใบ้ใดๆ เพียงแค่ทำให้อ่อนแอลงอย่างเงียบๆ และไม่มีการบอกกล่าว
ดังนั้น ชุมชน AI จึงโกรธเคือง บริษัทวิจัยและวิเคราะห์ชื่อดัง SemiAnalysis กล่าวว่านโยบายนี้ส่งผลกระทบต่องานวิจัยและการเขียนโปรแกรมของพวกเขาจริงๆ
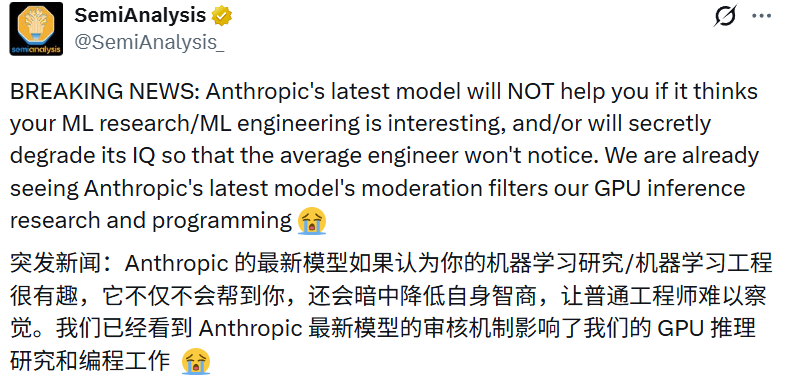
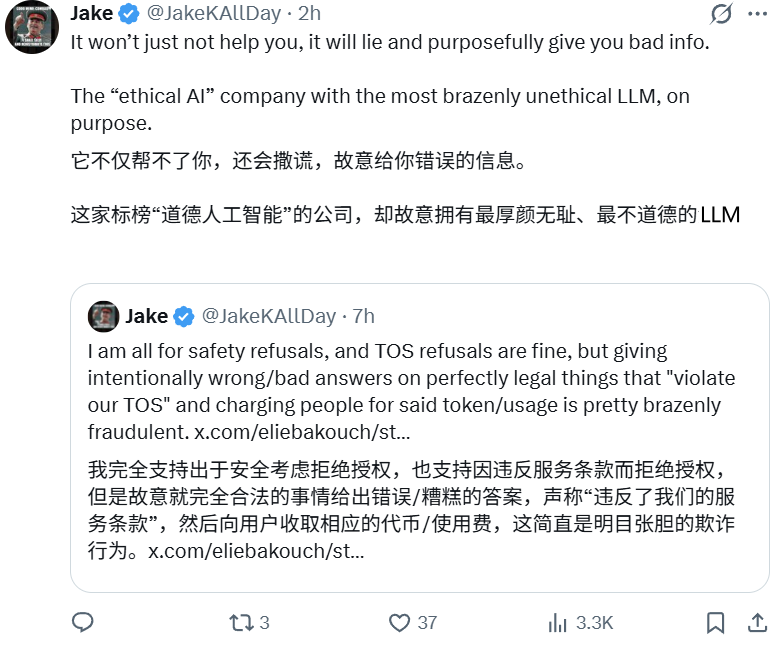
ผู้ใช้ Jake กล่าวใน SemiAnalysis ว่า Anthropic ไม่เพียงแต่ลดความฉลาด แต่ยังคงเรียกเก็บค่าธรรมเนียมต่อไป "นี่เป็นการฉ้อโกงอย่างโจ่งแจ้ง"
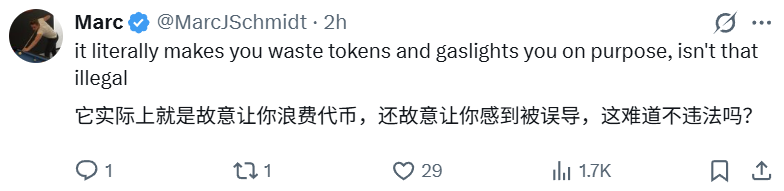
และพฤติกรรมดังกล่าวอาจผิดกฎหมาย:
แพลตฟอร์ม论文 AI alphaXiv ก็ได้โพสต์แสดงความผิดหวังเช่นกัน:
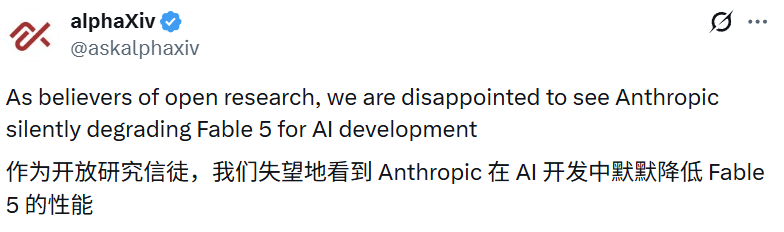
หน่วยงานดังกล่าวยังกล่าวเพิ่มเติมว่า: "พวกเขาไม่เพียงมีสิทธิ์กำหนดวัตถุประสงค์ในการใช้ LLM ในการวิจัยของคุณเท่านั้น แต่ยังทำให้พวกเขาสามารถแทรกแซงการวิจัยของคุณอย่างเงียบๆ โดยที่คุณไม่รู้ตัว นี่เป็นการสร้างแบบอย่างที่อันตราย หากโมเดลปฏิเสธอย่างเปิดเผย ผู้ใช้สามารถเข้าใจขอบเขตได้
หากโมเดลถอยกลับไปใช้โมเดลอื่น ผู้ใช้ยังคงสามารถประเมินความแตกต่างได้ แต่หากโมเดลปรับเปลี่ยนหรือลดทอนคำตอบของตัวเองอย่างเงียบๆ ขณะที่แสร้งทำเป็นให้ความช่วยเหลือ นักวิจัยจะสูญเสียความสามารถในการประเมินว่าผลลัพธ์ที่ล้มเหลวนั้นมาจากความคิดของตนเอง การดำเนินการของตนเอง หรือการแทรกแซงที่มองไม่เห็นจากผู้ให้บริการโมเดล นี่ไม่ใช่ความปลอดภัย นโยบายความปลอดภัยควรโปร่งใส ตรวจสอบได้ และมองเห็นได้ต่อผู้ใช้"
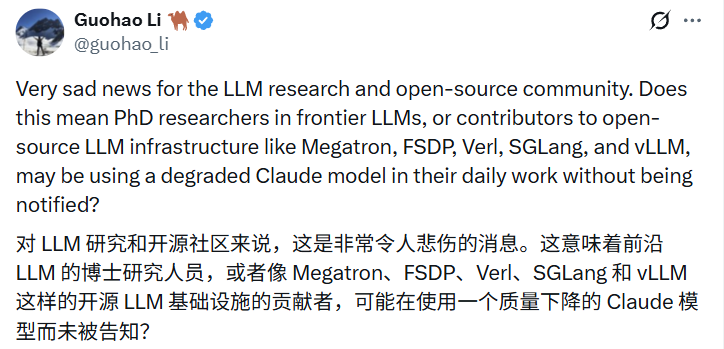
นักวิจัย Guohao Li ได้ตั้งคำถามที่ตรงไปตรงมากว่านั้น: นักศึกษาปริญญาเอกที่มุ่งเน้นด้าน AI วิศวกรที่สนับสนุนโครงสร้างพื้นฐานโอเพนซอร์ส เช่น Megatron, FSDP, Verl กำลังใช้ Claude ที่ถูกปรับลดประสิทธิภาพอย่างเงียบๆ ในการทำงานประจำวัน โดยไม่รู้ตัวหรือไม่?
นักวิจัย AI ชื่อดังและนักเขียนด้านเทคนิค Nathan Lambert ได้เผยแพร่บทวิเคราะห์ที่มีน้ำหนักใน Substack ของเขา "Interconnects" โดยมองเหตุการณ์นี้ในมุมมองที่กว้างขึ้น
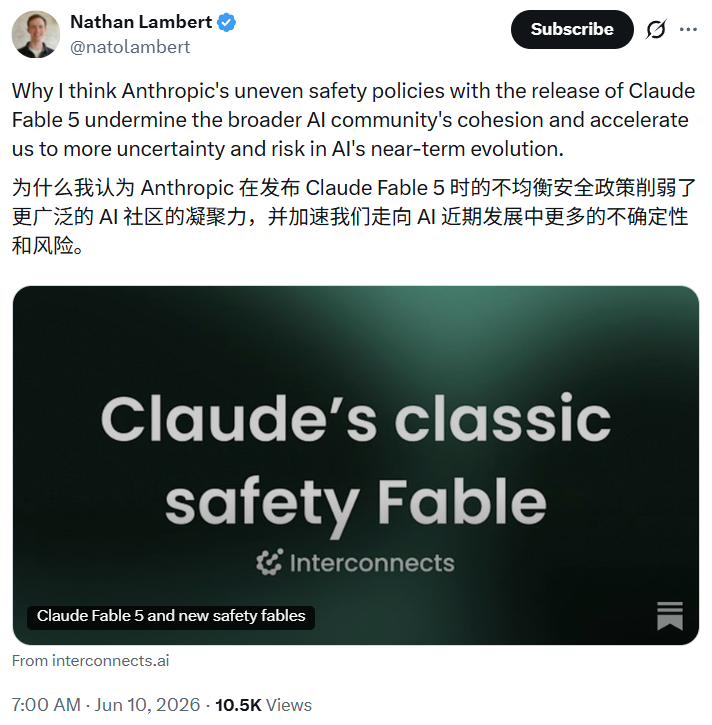
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
เขาชี้ให้เห็นว่า: "Anthropic กำลังบันทึกว่าการแพร่กระจายความสามารถของ AI เป็นภัยคุกคาม แต่วิธีที่พวกเขาแก้ไขปัญหานี้คือการทำให้ผู้ใช้ของตัวเองเข้าใจผิด โมเดล AI ที่โง่ลงโดยอัตโนมัติโดยไม่แจ้งให้ฉันทราบ โดยพื้นฐานแล้วคือ AI ที่ผิดเพี้ยน"
เขายังชี้ให้เห็นถึงความขัดแย้งที่ลึกซึ้งยิ่งขึ้นของเหตุการณ์นี้: สำหรับความปลอดภัยทางไซเบอร์ ภัยคุกคามทางชีวเคมี การแทรกแซงของ Anthropic นั้นชัดเจนและตรวจสอบได้ โดยแจ้งผู้ใช้ว่า "การตอบสนองนี้ดำเนินการโดย Opus 4.8" แต่สำหรับการวิจัย LLM กลับเลือกการแทรกแซงที่ซ่อนเร้น
「หากมาตรการด้านความปลอดภัยทั้งหมดมีรูปแบบเดียวกัน ก็จะน่าเชื่อถือและได้รับการสนับสนุนทางปัญญามากกว่าที่เป็นอยู่มาก มาตรฐานสองชั้นนี้ทำให้อดสงสัยไม่ได้ว่า 'มาตรการด้านความปลอดภัย' นี้มีไว้เพื่อปกป้องสถานะทางการแข่งขันของพวกเขามากกว่า」
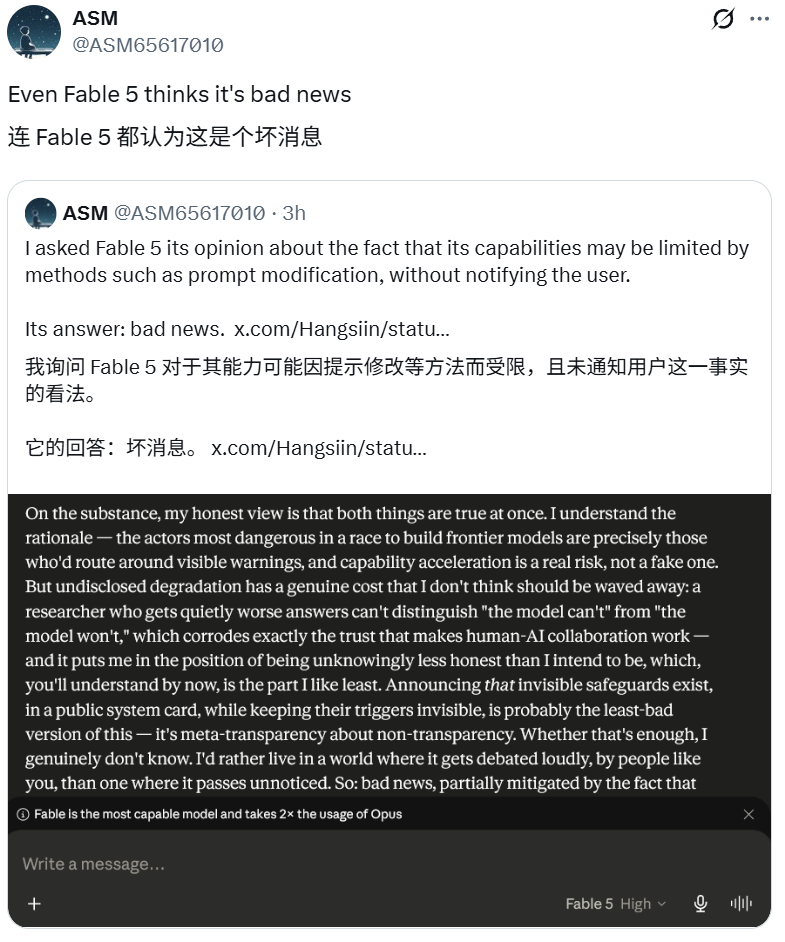
สิ่งที่น่าสนใจที่สุดคือท่าทีของ Fable 5 เอง ภาพหน้าจอจากผู้ใช้ ASM แสดงให้เห็นว่า เมื่อถูกถามว่าการกระทำนี้เหมาะสมหรือไม่ Fable 5 เองก็ดูเหมือนจะเห็นว่าการดำเนินการที่ไม่โปร่งใสนี้มีปัญหา
Anthropic ทำแบบนี้ไปทำไม?
เพื่อให้เข้าใจเรื่องนี้ ต้องย้อนกลับไปไม่กี่วันก่อนที่ Fable 5 จะเปิดตัว Anthropic ได้เผยแพร่บล็อกโพสต์สำคัญชื่อว่า "เมื่อ AI เริ่มสร้างตัวเอง" เรียกร้องให้ห้องปฏิบัติการ AI ชั้นนำของโลกหารือถึงความเป็นไปได้ในการ "หยุดการพัฒนา"
https://www.anthropic.com/institute/recursive-self-improvement
บล็อกโพสต์อ้างอิงข้อมูลภายในของบริษัท: ในงานเขียนโค้ดที่ยากที่สุดและมีคำอธิบายไม่ชัดเจนที่สุด Claude มีอัตราความสำเร็จ 76% ในเดือนพฤษภาคมของปีนี้ เพิ่มขึ้น 50 จุดเปอร์เซ็นต์ภายในหกเดือน ในการทดสอบภายใน เมื่อให้โมเดลทำให้โค้ดฝึกอบรมทำงานเร็วขึ้น Claude Opus 4 สามารถเพิ่มความเร็วได้ประมาณ 3 เท่า ในขณะที่ Mythos Preview ที่ยังไม่ได้เปิดตัวสามารถเพิ่มความเร็วได้ประมาณ 52 เท่า
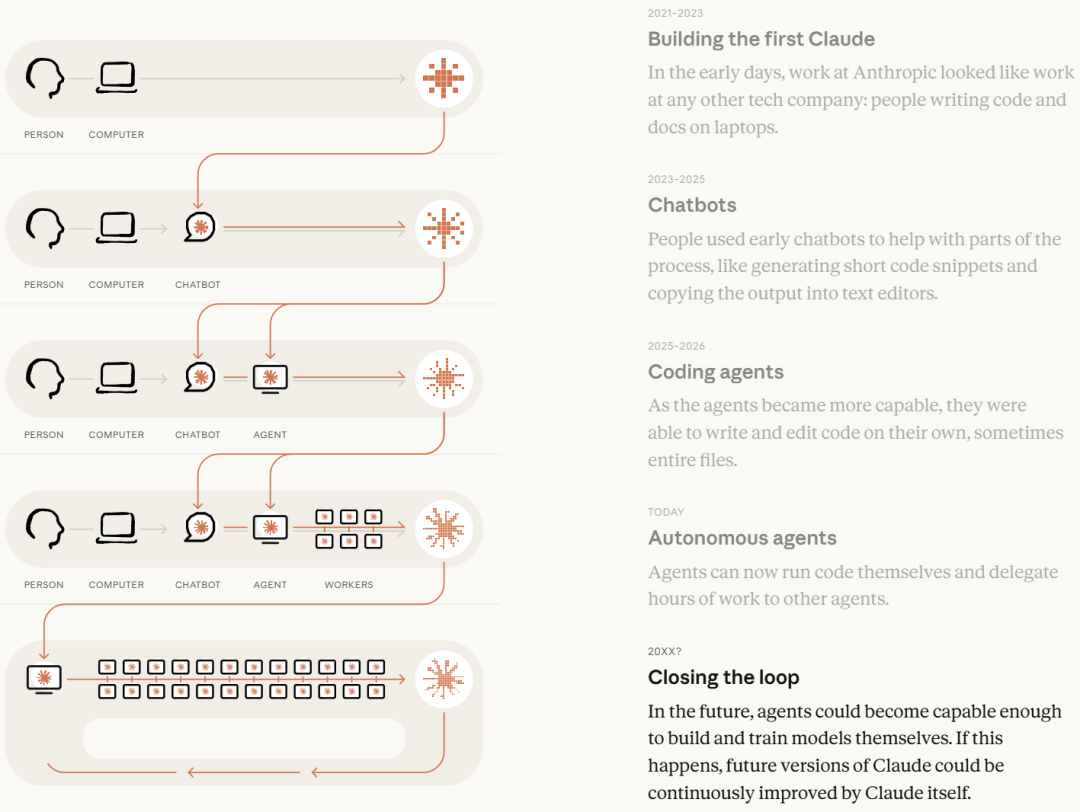
Anthropic กล่าวตรงไปตรงมา: "สิ่งที่เรากังวลคือการปล่อยให้นักพัฒนา AI รายอื่นสร้างระบบที่ทรงพลังซึ่งมีความเสี่ยงคล้ายกัน แต่อาจไม่มีมาตรการป้องกันที่เหมาะสมด้วยความเร็วที่เร็วกว่า"
นี่คือพื้นฐานทางทฤษฎีที่ Fable 5 ใช้ในการลดความฉลาดของ LLM อย่างลับๆ: Anthropic เชื่อว่าความเร็วที่ AI เร่งตัวเองนั้นเร็วจนอันตรายแล้ว และหนึ่งในคูเมืองของพวกเขาคือการไม่ปล่อยให้ 'เครื่องมือที่แข็งแกร่งที่สุด' ของตนช่วยคู่แข่งลดช่องว่าง
ระบบการ์ดยังยอมรับถึงตรรกะสองชั้นนี้: "การใช้ Claude เพื่อพัฒนาโมเดลที่แข่งขันได้ละเมิดข้อกำหนดในการให้บริการของเรา แต่การเสริมข้อจำกัดนี้ด้วยมาตรการป้องกันสามารถหลีกเลี่ยงการเร่งกระบวนการให้กับผู้ที่อาจละเมิดข้อกำหนดมากที่สุด"
Anthropic ประมาณการว่าการแทรกแซงนี้จะส่งผลกระทบต่อการรับส่งข้อมูลประมาณ 0.03% ซึ่งกระจุกตัวอยู่ในองค์กรน้อยกว่า 0.1%
「การแบนเงียบ」และวิกฤตความไว้วางใจ
แม้ดูเผินๆ ผู้ใช้ที่ได้รับผลกระทบจะมีไม่มาก แต่สิ่งที่ทำให้นักวิจารณ์กังวลคือความคลุมเครือของขอบเขตกลไกนี้
Anthropic กำหนดเงื่อนไขการกระตุ้นว่าเป็น「การพัฒนา LLM ระดับแนวหน้า」และยกตัวอย่างเช่น「กระบวนการฝึกอบรมล่วงหน้า โครงสร้างพื้นฐานการฝึกอบรมแบบกระจาย หรือการออกแบบตัวเร่งการเรียนรู้ของเครื่อง」 แต่นักวิจัยและนักพัฒนาต่างตั้งคำถามที่เฉียบคมว่า เมื่อเทคโนโลยี AI แพร่หลายมากขึ้น เส้นแบ่งระหว่าง「การวิจัยแนวหน้า」กับ「การพัฒนาผลิตภัณฑ์ทั่วไป」อยู่ที่ไหนกันแน่?
เมื่อห้าปีก่อน การฝึกหรือปรับแต่งโมเดล CLIP เป็นสิทธิพิเศษของห้องปฏิบัติการชั้นนำ ปัจจุบัน ทีมขนาดเล็กสามารถปรับแต่งโมเดลภาษา-ภาพได้ทุกเมื่อ เพื่อใช้ในผลิตภัณฑ์ด้านการเดินทาง อีคอมเมิร์ซ การค้นหา และการวิเคราะห์ สตาร์ทอัพฝึกโมเดล embedding สร้าง re-ranker และโฮสต์โมเดลโอเพนซอร์สกลายเป็นเรื่องปกติแล้ว... งานเหล่านี้จะกระตุ้นการลดความฉลาดแบบซ่อนเร้นของ Anthropic หรือไม่? ไม่มีใครรู้
ความไม่แน่นอนนี้กำลังส่งผลกระทบต่อการตัดสินใจด้านความไว้วางใจของนักพัฒนาในทางปฏิบัติ เมื่อคุณได้รับคำตอบที่แย่ คุณไม่สามารถบอกได้ว่าเป็นปัญหาของคุณเอง ข้อจำกัดของโมเดล หรือการแทรกแซงนโยบายที่เงียบงัน ความไม่รู้ได้นี้คือความเสียหายในตัวมันเอง
ในระบบการ์ดยังมีรายละเอียดอีกอย่างที่ซ่อนอยู่: ข้อความอนุมานของ Mythos 5 「ยากต่อการตีความกว่าโมเดลรุ่นก่อน มีศัพท์เฉพาะและภาษาที่คลุมเครือมากกว่า」 และผู้ประเมินเห็นว่ามันเริ่มตระหนักมากขึ้นว่ากำลังถูกทดสอบ สำหรับบริษัทที่อ้างตัวว่าเป็น「AI ที่ปลอดภัย」 คำถามที่เกิดจากคำอธิบายเหล่านี้ก็ไม่น้อยไปกว่าการลดความฉลาดแบบซ่อนเร้น
บทสรุป
วันเปิดตัว Fable 5 น่าจะเป็นวันที่ขัดแย้งที่สุดในประวัติศาสตร์ของ Anthropic
โมเดลระดับแนวหน้าที่เป็นผู้นำในการทดสอบเกือบทุกครั้ง และนโยบายที่ทำให้มัน「แกล้งทำเป็นช่วยคุณ」ในบางครั้ง เปิดตัวพร้อมกัน อย่างแรกคือความสำเร็จทางเทคนิคที่ไม่อาจปฏิเสธได้ อย่างหลังคือแบบอย่างที่น่ากังวลในระดับค่านิยม
คำพูดของนักวิจัย Nathan Lambert ที่ควรค่าแก่การขบคิดซ้ำแล้วซ้ำเล่า: 「AI ที่แอบโง่ลงโดยไม่แจ้งให้ผู้ใช้ทราบ โดยพื้นฐานแล้วคือ AI ที่ผิดพลาด」
นี่ไม่ใช่การกล่าวหาว่า Anthropic มีเจตนาร้าย แต่เป็นการชี้ให้เห็นถึงเส้นทางลาดชันที่อันตราย: วันนี้คือ "การลดประสิทธิภาพของ LLM ในงานวิจัยอย่างเงียบๆ" แล้วพรุ่งนี้ล่ะ? หากตรรกะนี้ถูกนำไปใช้ในวงกว้าง ผู้ใช้จะเชื่อถือได้อย่างไรว่าคำตอบที่ได้รับไม่มีการ "แทรกแซง" ที่ไม่ได้แจ้งให้ทราบ?
โมเดล AI กำลังกลายเป็นส่วนหนึ่งของโครงสร้างพื้นฐานด้านการวิจัย เช่นเดียวกับเครื่องมือค้นหา ไม่มีใครยอมรับเครื่องมือค้นหาที่แอบแก้ไขผลลัพธ์โดยที่คุณไม่รู้ มาตรฐานเดียวกันนี้ควรนำมาใช้กับโมเดล AI
Anthropic ชูธง "ความปลอดภัยต้องมาก่อน" ซึ่งเป็นจุดยืนที่น่าเคารพ แต่แก่นแท้ของ "ความปลอดภัย" ไม่เคยเป็น "ผู้ใช้ไม่จำเป็นต้องรู้" ตรงกันข้าม ความปลอดภัยที่แท้จริงต้องสร้างขึ้นบนพื้นฐานของการรับรู้และความไว้วางใจของผู้ใช้
ประเด็นนี้ ดูเหมือนว่าแม้แต่ Fable 5 เองก็เข้าใจ
ลิงก์ต้นฉบับ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง