a16z: อนาคตของ Visual AI ไม่ใช่รูปภาพ แต่เป็นโค้ด
หัวข้อต้นฉบับ: The Next Frontier of Visual AI Is Code
ผู้เขียนต้นฉบับ: @stuffyokodraws, a16z
แปลและเรียบเรียง: Peggy
หมายเหตุบรรณาธิการ: ในช่วงไม่กี่ปีที่ผ่านมา การแข่งขันของ AI ด้านภาพเกือบทั้งหมดวนเวียนอยู่กับคำถามเดียว: ใครสร้างภาพที่สมจริงกว่า ใครสร้างวิดีโอที่ลื่นไหลกว่า โมเดล Diffusion เปลี่ยนข้อความแจ้งให้เป็นภาพ วิดีโอ และฉากที่สมจริง ทำให้คนภายนอกคุ้นเคยกับการประเมินความสามารถของโมเดลด้วยเกณฑ์ "เหมือนหรือไม่" "สวยหรือไม่"
แต่บทความจาก a16z นี้ชี้ให้เห็นว่า ขั้นตอนถัดไปของ AI ด้านภาพอาจไม่ใช่แค่การสร้างพิกเซลที่สวยงามขึ้น แต่เป็นการสร้าง "code artifact" (ไฟล์ที่มีโครงสร้างซึ่งสามารถแก้ไข ทดสอบ และส่งมอบต่อได้) ที่อยู่เบื้องหลังพิกเซลเหล่านั้น
ความแตกต่างนี้ดูเหมือนเป็นเรื่องเทคนิค แต่แท้จริงแล้วเป็นตัวกำหนดว่า AI จะสามารถเข้าสู่เวิร์กโฟลว์การผลิตจริงได้หรือไม่ นักออกแบบไม่ต้องการแค่ภาพหน้าจอ UI แต่ต้องการ HTML/CSS, คอมโพเนนต์ React, เลเยอร์ และไฟล์ที่ส่งมอบได้ นักสร้างแอนิเมชันไม่ต้องการแค่วิดีโอ แต่ต้องการคีย์เฟรม, เส้นโค้งเวลา และพารามิเตอร์การเคลื่อนไหวที่ปรับเปลี่ยนได้ ศิลปิน 3D ไม่ต้องการแค่ภาพเรนเดอร์ แต่ต้องการโครงสร้างเรขาคณิต, พื้นผิว, แสง, กล้อง และลำดับชั้นของฉาก
ดังนั้น บทความจึงแบ่งการสร้างภาพออกเป็นสองเส้นทาง: การสร้างแบบ Pixel-Native (สร้างภาพหรือวิดีโอโดยตรง) เหมาะกับความสมจริง บรรยากาศ และการสำรวจ ส่วนการสร้างแบบ Code-Native (สร้าง SVG, Lottie, สคริปต์ Blender, ฉาก USD ฯลฯ) เหมาะกับการแก้ไข การทำซ้ำ และการผลิตมากกว่า สิ่งที่สำคัญจริงๆ สำหรับเส้นทางหลังคือ มันสามารถสร้างวงจรปิดของ "โค้ด → เรนเดอร์ → ตรวจสอบ → แก้ไข" ได้ โมเดลไม่จำเป็นต้องสุ่มตัวอย่างใหม่ซ้ำแล้วซ้ำเล่า แต่กำลังดีบักโปรแกรมภาพที่ตรวจสอบได้
นี่คือเหตุผลที่ผู้เขียนมองโลกในแง่ดีเป็นพิเศษเกี่ยวกับ 3D เพราะภาพเรนเดอร์ของเก้าอี้ไม่ใช่เก้าอี้ แต่เป็นแค่รูปภาพของเก้าอี้ สินทรัพย์ที่สามารถใช้ได้จริงในเกม, ตัวจำลอง หรือเครื่องมือ 3D ต้องมีโครงสร้างเรขาคณิตที่เสถียร, ลำดับชั้นของชิ้นส่วน, พื้นผิว และข้อจำกัดด้านฟังก์ชัน: ประตูต้องเปิดได้, ลิ้นชักต้องเลื่อนได้, ล้อต้องหมุนได้ กล่าวอีกนัยหนึ่ง คุณค่าของ AI ด้านภาพในอนาคตไม่ได้อยู่ที่ "ดูเหมือน" แต่อยู่ที่ "สามารถนำไปใช้ต่อได้หรือไม่"
บทความนี้ให้กรอบการตัดสินใจที่ดี: คลื่นลูกแรกของ AI ด้านภาพแก้ปัญหาการสร้าง คลื่นลูกถัดไปจะแก้ปัญหาการผลิต เมื่อ AI ด้านภาพก้าวจากผลลัพธ์สุดท้ายไปสู่ซอร์สโค้ด สิ่งที่เปลี่ยนแปลงจริงๆ ไม่ใช่แค่เครื่องมือออกแบบ แต่เป็นห่วงโซ่การผลิตเนื้อหาภาพทั้งหมด
ต่อไปนี้เป็นเนื้อหาต้นฉบับ:
ในช่วงไม่กี่ปีที่ผ่านมา AI ด้านภาพส่วนใหญ่มักถูกประเมินจาก "พิกเซล" ยิ่งภาพหรือวิดีโอที่สร้างออกมาดูดีเท่าไร โมเดลก็ดูเหมือนจะแข็งแกร่งมากขึ้นเท่านั้น
นี่ไม่ใช่เรื่องน่าแปลกใจ โมเดล Diffusion เริ่มจากการเปลี่ยนข้อความแจ้งให้เป็นภาพสวยงาม จากนั้นขยายไปสู่วิดีโอ และต่อไปยังโลกที่สมจริงยิ่งขึ้น ผู้คนจึงเปรียบเทียบมันกับ Photoshop หรือกล้องถ่ายรูปโดยธรรมชาติ
แต่สำหรับงานที่เกี่ยวข้องกับภาพหลายประเภท เช่น การออกแบบกราฟิก การออกแบบ UI หรือการสร้างโมเดล 3 มิติ สิ่งที่ผู้ใช้ต้องการจริงๆ ไม่ใช่แค่พิกเซลที่แสดงผลสุดท้ายเท่านั้น พวกเขาต้องการสิ่งที่สามารถปรับเปลี่ยนซ้ำได้ตามความคิดเห็นและแนวคิดใหม่ๆ นักออกแบบไม่เพียงต้องการ mockup (แบบร่าง) แต่ยังต้องการเลเยอร์ คอมโพเนนต์ และไฟล์ส่งมอบ นักสร้างแอนิเมชันไม่เพียงต้องการวิดีโอ แต่ยังต้องการเส้นเวลา คีย์เฟรม และเส้นทางการเคลื่อนที่ที่แก้ไขได้ ศิลปิน 3 มิติไม่เพียงต้องการภาพเรนเดอร์ แต่ยังต้องการโครงสร้างเรขาคณิต วัสดุ แสง กล้อง และโครงสร้างฉาก
เครื่องมือ AI ด้านภาพที่น่าสนใจที่สุดในปัจจุบันไม่ได้พยายามสร้างผลลัพธ์สุดท้ายโดยตรงอีกต่อไป แต่เริ่มสร้างซอร์สโค้ดที่อยู่เบื้องหลังผลลัพธ์สุดท้าย การเปลี่ยนแปลงนี้กำลังปลดปล่อยความสามารถในการแก้ไข การทำซ้ำ และวงจรป้อนกลับ ซึ่งโมเดลที่เน้นพิกเซลโดยธรรมชาติไม่สามารถเทียบได้
สองชุดเทคโนโลยีของการสร้างภาพ
เราสามารถเข้าใจการสร้างภาพได้ด้วยสองวิธีหลัก
วิธีแรกคือการสร้างแบบเน้นพิกเซลโดยธรรมชาติ ระบบประเภทนี้มักสร้างภาพหรือวิดีโอโดยตรง ซึ่งมักทำในพื้นที่แฝง พวกมันเชี่ยวชาญด้านพื้นผิว บรรยากาศ แสง และความสมจริง หากเป้าหมายคือการสร้างช็อตที่มีบรรยากาศแบบภาพยนตร์ moodboard (บอร์ดอารมณ์) ที่สวยงาม หรือภาพที่สมจริงระดับภาพถ่าย โมเดล Diffusion ยังคงเป็นวิธีหลัก
วิธีที่สองคือการสร้างแบบเน้นโค้ดโดยธรรมชาติ ระบบประเภทนี้สร้างรูปแบบการแสดงผล ซึ่งจากนั้นจะถูกดำเนินการหรือเรนเดอร์โดยเอนจินอื่น โมเดลไม่ได้สร้างพิกเซลสุดท้ายโดยตรง แต่สร้างโปรแกรมที่สามารถสร้างพิกเซลได้
โปรแกรมนี้สามารถเป็นไฟล์ SVG เลย์เอาต์ HTML/CSS คอมโพเนนต์ React ไฟล์ Lottie JSON สคริปต์ Blender กราฟฉาก USD shader (เชเดอร์) หรือฉากเอนจินเกม ผลลัพธ์ภาพสุดท้ายยังคงเป็นพิกเซล แต่ "แหล่งที่มาที่แท้จริง" คือชุดการแสดงผลที่มีโครงสร้าง
ความแตกต่างนี้สำคัญมาก เพราะเวิร์กโฟลว์การผลิตให้ความสำคัญกับ "สิ่งที่เกิดขึ้นหลังจากการสร้าง" ภาพที่สร้างขึ้นสามารถใช้เป็นผลลัพธ์ได้ แต่โปรแกรมภาพที่สร้างขึ้นสามารถใช้เป็นสิ่งประดิษฐ์ได้: มันสามารถแก้ไข นำกลับมาใช้ใหม่ ปรับปรุง และจัดการเวอร์ชันได้ มันสามารถรวมเข้ากับสแต็กซอฟต์แวร์และตรวจสอบตามข้อจำกัด มันสามารถเรนเดอร์ซ้ำภายใต้เงื่อนไขต่างๆ และส่งต่อระหว่างนักออกแบบ วิศวกร และ Agent
ผมคิดว่าการเปลี่ยนแปลงครั้งสำคัญกำลังเกิดขึ้นแล้ว: สำหรับปัญหาทางภาพบางประเภท เราจะเรียนรู้ที่จะปรับโจทย์การสร้างภาพใหม่ให้เป็นโจทย์การเข้ารหัส และได้รับประสิทธิภาพที่สูงขึ้นอย่างมากผ่านการแก้ปัญหาการเข้ารหัสที่มีขอบเขตชัดเจนและตรวจสอบได้
โค้ดคือตัวกลางที่ดีในการแก้ปัญหาทางภาพ
วิธีที่ง่ายที่สุดในการเข้าใจคุณค่าของการสร้างโค้ดทางภาพ คือการดูว่าเกิดอะไรขึ้นหลังจากร่างแรกเสร็จ
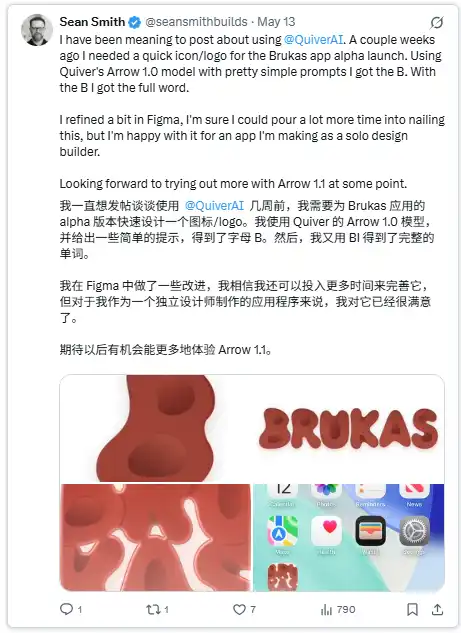
สมมติว่าโมเดลสร้างโลโก้ขึ้นมา หากผลลัพธ์เป็นภาพแรสเตอร์ และเส้นโค้งเส้นหนึ่งไม่ถูกต้อง ผู้ใช้จะต้องทำการซ่อน, วาดใหม่เฉพาะจุด, สร้างใหม่ หรือวาดด้วยมือใหม่ทั้งหมด แต่ถ้าผลลัพธ์เป็น SVG ผู้ใช้สามารถแก้ไขพาธ, รูปทรงพื้นฐาน, การไล่สี, เส้นขอบ หรือองค์ประกอบข้อความได้โดยตรง นี่คือวิธีที่นักออกแบบออกแบบโลโก้บน Quiver อยู่แล้ว
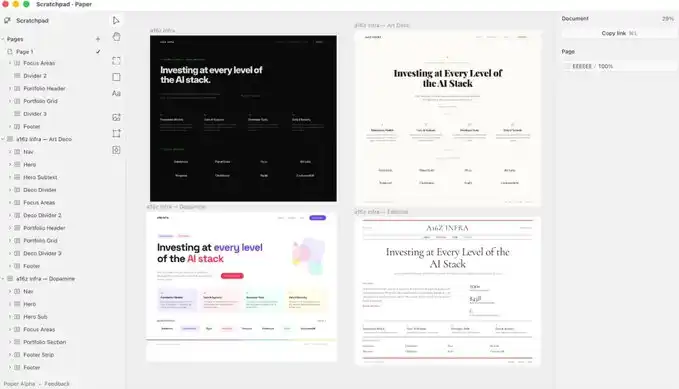
ในด้านการออกแบบ UI หากผลลัพธ์เป็นภาพหน้าจอ มันก็เป็นแค่แรงบันดาลใจเท่านั้น แต่ถ้าผลลัพธ์เป็น HTML/CSS หรือ React นักออกแบบสามารถตรวจสอบ DOM, เปลี่ยนคอมโพเนนต์จริง, ทดสอบสถานะการตอบสนอง, ตรวจสอบการเข้าถึง และเชื่อมต่อกับแอปพลิเคชันได้
นี่คือเหตุผลที่การสร้างโค้ดทางภาพเหมาะเป็นพิเศษสำหรับ test-time compute (การคำนวณขณะทดสอบ) ในการสร้างพิกเซลแบบดั้งเดิม การเพิ่มการคำนวณเชิงอนุมานมักหมายถึงการสุ่มตัวอย่างผลลัพธ์มากขึ้น: สร้างภาพ 20 ภาพ เลือกภาพที่ดีที่สุด แล้วลองอีกครั้ง แน่นอนว่ามันใช้ได้ แต่ทุกครั้งที่ลองก็เหมือนการโยนลูกเต๋าใหม่ โมเดลสามารถตอบสนองต่อคำติชมได้ แต่คำติชมนี้มักจะเป็นภาพรวมและไม่แม่นยำพอ
ในทางเทคนิค โมเดล Diffusion ก็สามารถได้รับประโยชน์จาก test-time compute เช่นกัน ตัวอย่างเช่น Inference-time Scaling of Diffusion Models through Classical Search แสดงให้เห็นว่าการค้นหาในขั้นตอนการอนุมานสามารถปรับปรุงประสิทธิภาพของโมเดล Diffusion ในการวางแผน, การเรียนรู้แบบเสริมกำลัง และการสร้างภาพ แต่กลไกการวนซ้ำที่นี่แตกต่างกัน ในโมเดล Diffusion ระบบมักจะค้นหาระหว่างวิถีที่เป็นไปได้หรือตัวอย่างสุดท้าย สัญญาณรางวัลสามารถบอกโมเดลได้ว่าผลลัพธ์หนึ่งดีกว่าอีกอันหนึ่ง แต่มันไม่สามารถแมปคำติชมไปยังการแก้ไขเฉพาะในระดับซอร์สโค้ดได้อย่างชัดเจน
การสร้างโค้ดแบบดั้งเดิมสร้างวงจรที่แม่นยำยิ่งขึ้น: โค้ด → เรนเดอร์ → ตรวจสอบ → แก้ไข
โมเดลสร้างผลงาน เรนเดอร์มันออกมา สังเกตว่ามีอะไรผิดพลาด แล้วแก้ไขไฟล์ต้นฉบับ ถ้าระยะห่างไม่ถูกต้อง ก็แก้ CSS ถ้าเส้นโค้งโลโก้เบี่ยงเบน ก็แก้พาธ SVG ถ้าจังหวะแอนิเมชันช้าเกินไป ก็ปรับพารามิเตอร์เวลา จุดสำคัญคือ ทุกครั้งที่วนซ้ำจะปรับปรุงผลงานต้นแบบ ไม่ใช่แค่ผลลัพธ์ที่เรนเดอร์แล้ว นี่คือเหตุผลที่การสร้างโค้ดทางภาพสามารถได้รับประโยชน์จาก token ที่มากขึ้นและ test-time compute โดยธรรมชาติ โมเดลกำลังดีบักโปรแกรมทางภาพในสภาพแวดล้อมแบบปิดและตรวจสอบได้ ไม่ใช่แค่สุ่มตัวอย่างภาพมากขึ้น
สแต็กเทคโนโลยีการสร้างภาพที่ขับเคลื่อนด้วยโค้ด
เบื้องหลังตัวอย่างข้างต้นคือสแต็กเทคโนโลยีนี้: โมเดลการเข้ารหัส + การแสดงสัญลักษณ์ + เรนเดอร์เรอร์หรือเอนจิน
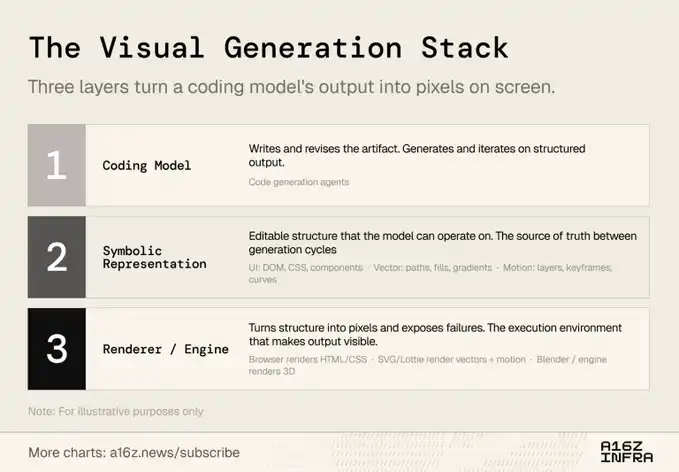
โมเดลการเข้ารหัสคือผู้สร้างและผู้แก้ไขผลงาน มันมีหน้าที่เขียน HTML, SVG, Lottie JSON, สคริปต์ Blender, ฉาก USD หรือโปรแกรมสินทรัพย์ 3D ที่กำหนดเอง
การแสดงสัญลักษณ์คือแหล่งที่มาของความจริง นี่คือเหตุผลที่ผลงานมีความสามารถในการแก้ไขได้ UI มีโหนด DOM, กฎเค้าโครง และคอมโพเนนต์; แอนิเมชัน Lottie มีเลเยอร์, รูปทรงเวกเตอร์, เส้นโค้งเวลา, คีย์เฟรม และพารามิเตอร์การเคลื่อนไหว; สินทรัพย์ 3D มีโครงสร้างเรขาคณิต, วัสดุ, ข้อต่อ, ข้อจำกัด และความสัมพันธ์แบบลำดับชั้น
เรนเดอร์เรอร์หรือเอนจินจะแปลงโครงสร้างเหล่านี้เป็นพิกเซล เบราว์เซอร์เรนเดอร์ HTML/CSS, เรนเดอร์เรอร์ SVG เรนเดอร์กราฟิกเวกเตอร์, เครื่องเล่น Lottie เรนเดอร์แอนิเมชัน, Blender หรือเอนจินเกมเรนเดอร์ฉาก 3D และซิมูเลเตอร์จะตรวจสอบว่าสินทรัพย์ที่มีข้อต่อสามารถเคลื่อนที่หรือโต้ตอบได้จริงหรือไม่
OmniLottie เป็นตัวอย่างที่ดีว่าทำไมการแสดงสัญลักษณ์ถึงสำคัญ Lottie เป็นรูปแบบแอนิเมชันที่เบาและใช้ JSON เป็นฐาน มันไม่ได้แสดงแอนิเมชันเป็นวิดีโอแบนๆ แต่ใช้รูปทรงเวกเตอร์ที่แก้ไขได้, เลเยอร์, คีย์เฟรม และพารามิเตอร์เวลาเพื่อแสดงการเคลื่อนไหว OmniLottie เสนอให้แปลง Lottie JSON ดั้งเดิมเป็นลำดับคำสั่งที่โมเดลเข้าใจได้ง่ายขึ้น ทำให้โมเดลสามารถสร้างและแก้ไขแอนิเมชัน Lottie ได้อย่างน่าเชื่อถือมากขึ้น จุดสำคัญของบทความนี้ไม่ใช่การสร้างลูป Agent ที่สมบูรณ์ แต่เป็นการทำให้ Lottie เหมาะกับการสร้างโดยโมเดลมากขึ้น: มันแปลง Lottie JSON ดั้งเดิมเป็นชุดคำสั่งและพารามิเตอร์ที่กะทัดรัด การกระทำนี้สำคัญเพราะ Lottie เป็นรูปแบบแอนิเมชันที่แก้ไขได้อยู่แล้ว เมื่อการเคลื่อนไหวถูกแสดงเป็นรูปทรง, เลเยอร์, เวลา และพารามิเตอร์แอนิเมชัน ข้อเสนอแนะสามารถแมปไปยังการปรับเปลี่ยนระดับไฟล์ต้นฉบับได้ ถ้าวัตถุเคลื่อนที่ช้าเกินไป ก็ปรับเวลา; ถ้าเส้นทางผิด ก็แก้ไขเวกเตอร์; ถ้าการเปลี่ยนรูปผิดเพี้ยน ก็อัปเดตลำดับรูปทรง
สแต็กเทคโนโลยีนี้สอดคล้องกับลูป test-time compute ที่ Agent การเข้ารหัสสามารถใช้เพื่อปรับปรุงคุณภาพผลลัพธ์: ในแต่ละลูป "โค้ด → เรนเดอร์ → ตรวจสอบ → แก้ไข" โมเดลไม่ได้สร้างตัวอย่างใหม่ แต่ใช้ข้อเสนอแนะจากเรนเดอร์เรอร์เพื่อปรับปรุงผลงานพื้นฐาน มันสามารถแก้ไขกฎ CSS, ปรับเส้นทาง SVG, แก้ไขเวลาแอนิเมชัน หรืออัปเดตข้อจำกัด 3D จากนั้นเรนเดอร์อีกครั้งและปรับปรุงต่อไป
สิ่งนี้ทำให้วงจรมีโอกาสที่จะลู่เข้า ในการสร้างภาพแบบดั้งเดิม การลองใหม่แต่ละครั้งมักจะให้ผลลัพธ์ใหม่ ในขณะที่การสร้างภาพแบบโค้ดดั้งเดิม การลองใหม่แต่ละครั้งสามารถปรับปรุงต้นฉบับของผลงานได้เอง โมเดลไม่ได้แค่สุ่มตัวอย่างภาพหรือวิดีโอมากขึ้น แต่กำลังดีบักโปรแกรมภาพในสภาพแวดล้อมแบบวงปิดที่สามารถเรนเดอร์ได้
แผนที่ตลาด: การสร้างจุดเชื่อมต่อรอบรันไทม์
ตลาดการสร้างภาพด้วยโค้ดกำลังถูกจัดระเบียบรอบ "รันไทม์" ซึ่งเป็นสถานที่ที่ผลงานถูกเรนเดอร์หรือดำเนินการ ในการสร้างภาพแบบโค้ดดั้งเดิม โมเดลจะสร้างผลงานเชิงสัญลักษณ์ ซึ่งจะถูกดำเนินการในสภาพแวดล้อมบางอย่าง เช่น เบราว์เซอร์, ตัวเรนเดอร์ SVG, เครื่องเล่น Lottie, Blender, เกมเอนจิน หรือซิมูเลเตอร์
รันไทม์แต่ละประเภทจะสร้างจุดเชื่อมต่อที่แตกต่างกัน เนื่องจากแต่ละรันไทม์มีการแสดงผลต้นฉบับ วงจรป้อนกลับ และเวิร์กโฟลว์การผลิตของตัวเอง
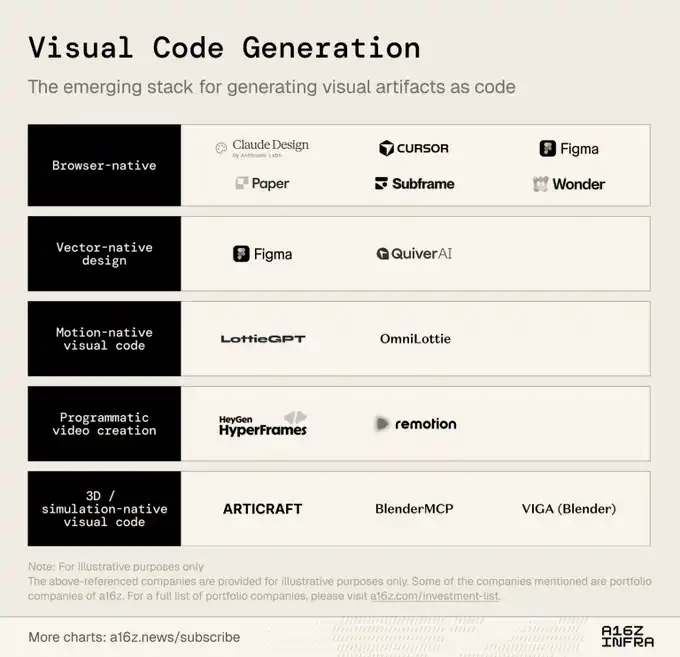
การใช้งานที่ชัดเจนที่สุดในปัจจุบันอยู่ในสาขาการออกแบบ 2 มิติ โดยเฉพาะการออกแบบ UI และการออกแบบกราฟิก แต่การสร้างภาพด้วยโค้ดไม่ได้จำกัดอยู่แค่เครื่องมือออกแบบเท่านั้น มันสามารถเกิดขึ้นได้ทุกที่ที่มีการแสดงผลเบื้องหลังของผลงานภาพที่สามารถสร้าง เรนเดอร์ ตรวจสอบ และปรับให้เหมาะสม
ทำไม 3D ถึงเป็นแนวหน้าสำคัญถัดไป
แม้ว่าการออกแบบผลิตภัณฑ์และการออกแบบ 2 มิติจะเป็นกรณีการใช้งานที่เข้าใจง่ายที่สุดในปัจจุบัน แต่ผลงาน 3D อาจได้รับประโยชน์มากที่สุดจากแนวทาง "การกำหนดปัญหาความสอดคล้องเป็นปัญหาการเขียนโค้ด" นี้
การออกแบบ 2 มิติบางครั้งก็มีประโยชน์เพียงแค่ดูถูกต้อง แต่สินทรัพย์ 3D ไม่ใช่แบบนั้น ภาพเรนเดอร์ของเก้าอี้ไม่ใช่เก้าอี้ มันเป็นแค่รูปภาพของเก้าอี้ เพื่อให้สินทรัพย์นี้ใช้งานได้จริงในเกม ซิมูเลเตอร์ หรือเครื่องมือแก้ไข 3D มันต้องมีการแสดงผล 3D ที่สอดคล้องกันในเบื้องหลัง รวมถึงโครงสร้างเรขาคณิตที่ถูกต้อง วัสดุ ลำดับชั้นของชิ้นส่วน และบริบทของฉาก
นี่คือเหตุผลที่ 3D เหมาะสมกับการสร้างภาพด้วยโค้ดโดยธรรมชาติ คุณค่าของมันไม่ได้อยู่ที่การสร้างสิ่งที่ดูเหมือน 3D จากมุมมองใดมุมมองหนึ่งเท่านั้น แต่อยู่ที่การสร้างโครงสร้าง 3D ที่สอดคล้องกันซึ่งสามารถทำงานได้ในมุมมอง การแก้ไข และการโต้ตอบที่แตกต่างกัน สิ่งนี้ต้องการวงจรการทำซ้ำ: เสนอวัตถุ เรนเดอร์มัน ตรวจสอบว่าโครงสร้างเรขาคณิตและชิ้นส่วนสมเหตุสมผลหรือไม่ จากนั้นแก้ไขการแสดงผลเบื้องต้น แต่วงจรนี้จะทำงานได้ก็ต่อเมื่อ Agent มีเครื่องมือและบริบทที่ถูกต้องเท่านั้น การรัน Blender ซ้ำๆ จนกว่าบางอย่างจะดูดีขึ้นนั้นไม่เพียงพอ Agent ต้องสามารถสลับมุมมองกล้อง สอบถามสถานะของฉาก แยกวัตถุ เปรียบเทียบกับเป้าหมาย จดจำความพยายามก่อนหน้านี้ และแปลงความแตกต่างทางภาพเป็นการแก้ไขในระดับไฟล์ต้นฉบับ ความสามารถเหล่านี้เองที่ทำให้ test-time compute มีโอกาสลู่เข้า
สำหรับสินทรัพย์หลายประเภท ความสอดคล้องทางสายตาเป็นเพียงมาตรฐานขั้นต่ำเท่านั้น วัตถุยังต้องมีความหมายของชิ้นส่วนและข้อจำกัดด้านฟังก์ชันที่ถูกต้อง: ประตูควรเปิดได้ บานพับควรหมุนได้ ลิ้นชักควรเลื่อนได้ และล้อควรหมุนได้ กล่าวอีกนัยหนึ่ง ผลลัพธ์ต้องไม่ใช่แค่รูปร่างที่ดูสมเหตุสมผลเท่านั้น แต่ยังต้องทำงานเหมือนกับสิ่งที่มันเป็นตัวแทนด้วย
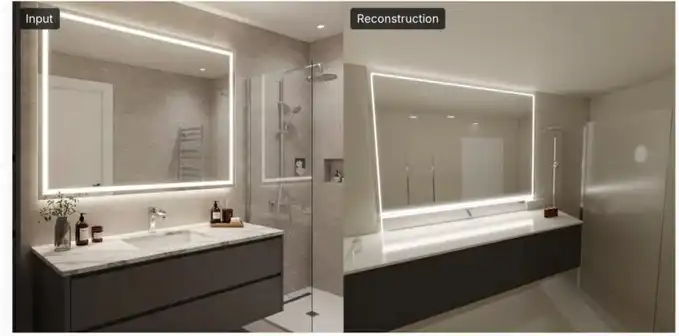
นี่คือสิ่งที่ทำให้โปรเจกต์อย่าง VIGA และ Articraft3D น่าสนใจ เราคาดว่าจะเห็นงานที่เกี่ยวข้องเพิ่มขึ้นอีกในปีนี้ รวมถึงโปรเจกต์เชิงพาณิชย์และโอเพนซอร์ส VIGA ใช้ Blender เป็นสภาพแวดล้อมสำหรับการเรนเดอร์และป้อนกลับ โดยเปลี่ยนการสร้างภาพใหม่ให้เป็นวงจร "โค้ด-เรนเดอร์-ตรวจสอบ" แต่ VIGA ไม่ได้เปิดเผย Blender ดิบๆ ให้กับ Agent loop โดยตรง มันจัดเตรียมเครื่องมือเชิงความหมายสำหรับ Agent ในการสังเกตและแก้ไข พร้อมกับเก็บความทรงจำของความพยายามในอดีต ทำให้ Agent สามารถตรวจสอบวัตถุจากมุมมองที่ดีขึ้น วินิจฉัยปัญหา และปรับเปลี่ยนอย่างตรงจุด ส่วน Articraft3D จัดการกับโครงสร้างของสินทรัพย์โดยตรง: มันกำหนดการสร้าง 3D ที่มีข้อต่อเป็นการเขียนโปรแกรม ซึ่งโปรแกรมเหล่านี้มีหน้าที่กำหนดชิ้นส่วน โครงสร้างเรขาคณิต ข้อต่อ และการทดสอบ
ผลกระทบในอนาคตและปัญหาที่ยังไม่ได้รับการแก้ไข
หากการสร้างโค้ดทางสายตาเป็นจริงได้จริง ผลิตภัณฑ์ที่ชนะในที่สุดจะไม่ใช่แค่การสร้างผลลัพธ์ที่สวยงามขึ้นเท่านั้น แต่พวกมันจะควบคุมวงจรทั้งหมด: สร้างสินค้า เรนเดอร์สินค้า ตรวจสอบว่ามีอะไรผิดพลาด และแก้ไขไฟล์ต้นฉบับ
สิ่งนี้จะนำมาซึ่งผลกระทบหลายประการ
ประการแรก เรนเดอร์จะกลายเป็นสภาพแวดล้อมป้อนกลับ เบราว์เซอร์, SVG renderer, Lottie player, Blender, เกมเอนจิน และซิมูเลเตอร์ จะกลายเป็นสภาพแวดล้อมที่ Agent ทดสอบและปรับปรุงผลงาน เช่นเดียวกับที่ Coding Agent ในปัจจุบันใช้แซนด์บ็อกซ์และเครื่องเสมือน
ประการที่สอง คุณภาพของบริบทการทำซ้ำจะมีความสำคัญมากกว่าที่เคย เพื่อให้ Agent เข้าสู่ "Ralph loop" ของเวอร์ชันโค้ดทางสายตา การแสดงผลระดับกลางต้องแม่นยำพอที่จะชี้แนะขั้นตอนถัดไป โมเดลต้องรู้ไม่เพียงแค่ว่า "บางอย่างดูไม่ถูกต้อง" แต่ยังต้องรู้ว่าควรแก้ไขส่วนใดในไฟล์ต้นฉบับและทำไมถึงต้องแก้ไข ข้อผิดพลาดเล็กน้อยในโครงสร้าง การเรนเดอร์ หรือการป้อนกลับ อาจสะสมอย่างรวดเร็วในหลายรอบการทำซ้ำ
ประการที่สาม อนาคตน่าจะเป็นแบบผสมผสาน โมเดลที่เน้นพิกเซลยังคงเก่งที่สุดในด้านความสมจริง พื้นผิว และการสำรวจ ส่วนระบบที่เน้นโค้ดเหมาะกับโครงสร้าง การทำซ้ำ และการผลิตมากกว่า เวิร์กโฟลว์ที่มีประโยชน์ที่สุดจะรวมทั้งสองอย่างเข้าด้วยกัน
แน่นอนว่ายังมีปัญหาที่เปิดกว้างอีกมากมาย แต่ละสาขาจะใช้รูปแบบการแสดงผลแบบใดในที่สุด? เราจำเป็นต้องสร้างเอนจินและเรนเดอร์ใหม่แทนที่จะใช้เครื่องมือรุ่นเก่าต่อไปหรือไม่? รสนิยมทางสายตาสามารถถูกจับได้มากเพียงใดผ่านข้อจำกัด การทดสอบ และวงจรป้อนกลับ?
แต่ทิศทางชัดเจนแล้ว: AI ด้านภาพกำลังก้าวจากผลลัพธ์ไปสู่โค้ดที่ใช้งานได้ คลื่นลูกแรกทำให้การสร้างภาพง่ายขึ้น คลื่นลูกถัดไปจะทำให้การสร้างผลงานภาพที่แก้ไขได้ ทดสอบได้ ส่งมอบได้ และปรับปรุงได้ง่ายขึ้น
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง