ทาง DeepSeek สู่ 1 ล้านล้านดอลลาร์: การใช้ Open Source เร่งขยายนิเวศภาพฮาร์ดแวร์ที่มียอดการบริการ 1 ล้านล้าน
หัวเรื่องของต้นฉบับ: ยุทธวิธีรายการ 10 ล้านล้านเหรียญดอลลาร์ของ DeepSeek
ผู้เขียนต้นฉบับ: @bookwormengr
การแปล: Peggy, BlockBeats
ข้อคิดจากบรรณาธิการ: ในช่วง 1 ปีที่ผ่านมา การอภิปรายเกี่ยวกับ DeepSeek มักเน้นไปที่ประสิทธิภาพของโมเดล เวลาเปิดตัวแบบจำลอง และการต่อสู้ราคา แต่ถ้ามอง DeepSeek แค่จากมุมมองของ "จะขายสมาชิกหรือไม่" "มีหลายโหมดหรือไม่" "สามารถเป็น coding agent หรือไม่" อาจจะเข้าใจว่าพลาดเรื่องที่จริงที่ DeepSeek ต้องการเปลี่ยนแปลง
บทความนี้เสนอทฤษฎีการประเมินที่ขึ้นขึ้นมาอีกตั้ง: ว่า DeepSeek อาจจะไม่ได้มุ่งหวังในรายได้ในระยะสั้นผ่านการใช้แอป แต่คือผ่านชุดนวัตกรรมฐานนี้ที่ทำให้เกิดการเปลี่ยนแปลงต้นฉบับของการอบรมและการองค์ประกันและถดถอยสร้างนิสัยของอุปกรณ์ ราคา บทความในส่วนเต็มรู้หนักสำคัญ: อีก
สิ่งที่น่าสนใจที่สุดในบทความ ไม่ใช่ว่า "DeepSeek จะสามารถหากขาย API หรือสมัครสมาชิกแล้วได้กิโลเท่าไร" แต่ว่า DeepSeek กำลังเชื่อมโมเดลความสามารถ พื้นที่ความจำและนิสัอุปกรณ์ของประเทศเขารธามาใช้ร่วมกัน การบีบอัดของ KV Cache ลดการขึ้นอ กับ HBM การพยายาิน่นและ SSD สามารถรับภารกิจเก็บเวลาของ LPDDR เพื่อเซี้ยดส่งโหลดและเก็บการจำของ Engram หมู่กั้สอสูํบเจมออกพู หรือ TileLang คือพยายามของไม้ที่จะลดความติดของ CUDA รู้ญ้ีกป่ให้มีสมถรมวทั่ยรฮาก่กรราหลายยเ่รสหดย้กตาเทบากว่มี่ข่็ัมืยเพซ่าหงาห่าย
แทนว่า "อุตราของฉวัยเกี่ยหมลชั้นํงถี่ัม้น วคาจรตมกาเือเนียกอุนร์่ ตาทุงวยเบอพรในยลี่ดนว่าั้ม็ดื่ยเท แล้อกปยาอสื่คย้าำูกี่่ีลืกาสคใ้ืมตา้ีลมอหืนอ คว่าะกำรไ้อยลใยงหลดสคร érica
มีคนคิดว่า DeepSeek จะหวังอย่างไรเพื่อหาเสี้ยได้และอย่างน่าจะเป็นเงิบหลักโดยต่าย
มันไม่ได้เปิดตัวโครงการสมาชิกด้านโปรแกรมมีความแข่งแกร่งเช่น GLM, MoonShot และ MiniMax; มันยังไม่มีโมเดลแบบ multi-modal, เสียง, หรือวิดีโอ ในปัจจุบัน, มันยังไม่มี harness เอง ซึ่งเป็นโครงสร้างภายนอกที่ใช้ในเรียกใช้โมเดล, เชื่อมต่อเครื่องมือ, และการดำเนินงาน แม้ว่าเขากำลังเริ่มสรรค์ตำแหน่อยู่แล้ว
ในขณะเดียวกัน, DeepSeek ดูเหมือนจะยึดมั่นกันไว้กับฝั่งโอเพ่นอย่างยาวนาน, พร้อมจะแบ่งปัน "ความลับ" ของตัวเอง นี่ก็ไม่ใช่เรื่องบ้าๆ ใช่หรือ ไม่ได้เสียเงินไปโมฯไป ใช่ไหม? นักลงทุนที่พร้อมลงทุนกับมัน 10 พันล้านเหรียญสหรัฐ, พวกเขากำลังทิ้งเงินลงขุดระบายเหล่า ใช่ไหม
ในทางส่วนบุคคลของฉัน, ผมคิดว่าคำตอบก็ตรงข้ามนั่นเอง
หลังจากนี้, ข้างล่างผมจะผลัดเหล่ากับสิ่งที่ DeepSeek ได้ทำจนถึงตอนนี้ และวิเคราะห์ว่าบริษัทดูเหมือนกำลังปฏิบัติตามกลยุทธ์แนวหนึ่ง DeepSeek CEO, Liang Wenfeng, อาจจะมองหาเกมที่ใหญ่กว่านอกเหนคอรันต์ที่ต้องหยุดที่โมเดล มีแนวรุนทำนองหนึ่งโดย DeepSeek มีโอกาสเป็นที่สำคัญระดับหนึ่ง, พร้อมปูปราชการใหม่อันมีมูลค่าถึง 10 พันล้านเหรียญสหรัฐ
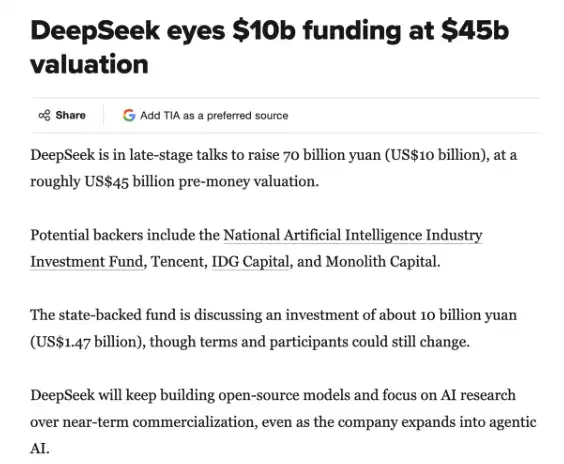
เรื่องของการระดมทุนล่าสุดของ DeepSeek จาก TechInAsia
DeepSeek การผจญภัยของ "นักวีรบุรุษ" อีกครั้ง
DeepSeek ได้ต่อสู้กับลมเปลเคียงมาตลอดเสมอ มันไม่ได้เลื้อยไปที่จะเร่งโมเดลชั้นบางน้อยและจะผ่อนความใจง่ายในการแพ็กแบรนด์โมเดลเหล่านั้นให้เป็นแอปพลิเคชันที่เรียกเก็บเงินโดยตรง เช่นโปรแกรมสมาชิก ร่างปี 2025 วันที่ 27 มกราคม ผมเคยโพสตวิทยุที่ได้รับการกระจายอย่างกว้างขวัญเกี่ยวกับ "การผจญภัยของ DeepSeek" ในจุดนี้เรื่องนี้กลายมาสนุกยิูยีกขึ้น
ซึ่งที่คนออกแบบโมเดลปุ่มติ ทำให้ DeepSeek เลือกบางกับที่จะฝึกโมเดลผสมของนักเชี่ยวชาญ (Mixture of Experts, MoE)
พวกเขาใช้วิธี "หลักแรก" มาชักนวีเกมล์อนว์ที่มันปัญหาจัดการของการสร้าง ViDAPS หลักการถึงเอฉจำแตร PPO แอลกดัมใช้ในปัจจุบัน
พวกเขาพบว่า ประจัการต่อรางเส้นตรอซอมวันหขัรัว (Reinforcement Learning from Verified Rewards, RLVR) เป็นกลยุทธ์หลักในการปรับแก้โมเดลด้านการคิดมีเหตุผล
พวกเขายังนำเสนอกลยุทธ์การทายที่ดีง่ายโดยผ่าน「การทายหลาย Token」 (Multi Token Prediction) ซึ่งทำให้สัญญาณการฝึกอบอุ่นมากขึ้น
พวกเขาปรับปรุงกระแสการทำงาน "ฟองอากาศศูนย์" (ZERO bubble) เพื่อเพิ่มประสิทธิภาพในการใช้ทรัพยากร GPU ที่จำกัด
พวกเขาได้เปิดตัวโหลดบาลานซ์เบราว์เซอร์ (Expert Load Balancer) เพื่อทำให้ทุกคนสามารถติดตั้งโมเอะ (MoE) ได้อย่างง่ายดาย โดยเฉพาะหลักการ "การเรียนข้อมูลข้างกว้าง" (Wide Expert Parallel) ซึ่งทำให้โมเอะสามารถให้บริการด้วยกลุ่มขนาดใหญ่ขึ้น ซึ่งลดต้นทุนการวิเคราะห์อย่างมาก
พวกเขาได้คิดค้น MLA, DSA, CSA, HCA และกลไกอื่น ๆ เพื่อลดความต้องการของ KV Cache และให้การคำนวณที่เพิ่มขึ้นตามความยาวของบริบทเหล่านั้นเป็นค่าคงที่เท่าที่จะเป็น
พวกเขาคิดค้น Engram เพื่อแลกเปลี่ยนความยากในการคำนวณด้วยหน่วยความจำ
พวกเขายังคิดค้น mHC เพื่อให้รูปแบบของโมเอะสามารถขยายตัวได้อย่างมั่นคงโดยที่ยังสามารถฝึกอบอุ่นได้ มีตัวอย่างเช่นนี้อีกมากมาย
ในโครงสร้างนิยายที่แท้จริงที่สุด "เส้นทางของฮีโร่" ฮีโร่ไม่เคยกำหนดเส้นทางเดินที่ตั้งต้นในฤดูกาลไหนล่ะ มีเพียงเรียนรู้มากขึ้นในการเดินทาง พบว่าความยิ่งใหญ่แท้จริงของตนเองคืออะไร และทำให้ภารกิจของตนเดิมแสนยิ่งในช่วงท้าย ๆ ของเรื่อง ท่านจะพบกับผู้วิจารณ์หลายคน แต่ท่านเลือกที่จะไม่สนใจพวกเขา ท่านจะพบกับคนกระทำชั่วร้ายอยู่เสมอ ท่านมีข้อบกพร่องหรือจุดอ่อนเป็นที่ชัดเจน แต่อย่างไรก็ดี ท่านก็จะเอาชนะปัญหาเหล่านั้นและทำภารกิจของตนได้ ท่านจะต้องเผชิญกับท้าทายที่ดูเหมือนจะล้มล้างไม่ได้ แต่ก็พบวิธีร่วมมือก็ทำให้รู้จักวิธีการใช้ทรัพยากรทุกอย่างอย่างฉลาด เป็นเรื่องนี้ที่ทำให้ผู้ชมยินดีกว่าจะอนุญาติ่งไหลให้กับฮีโร่ นี่ก็คือเหตุผลที่ DeepSeek ทำให้คนติดตามเพิ่มขึ้น ได้รับเคารพจากทั่วโลกรวมทั้งเจับมือกัน
อย่างที่ฉันจะอธิบายต่อไป DeepSeek ได้ใช้เวลานานมากแล้วและจะได้พบรู้เป้าหมายมหาศาลของตนเองไว้แก่ตน บวกทัศนคติของมันทไม่ได้อยู่ที่การขายแพ็คเกจการสมัครสมาชิกโปรแกรม แต่มันคือการผลักดันนิเวศแห่งห้างอินทรีย์ AI ของจีน ให้มีขนาดถึง 10 ล้านล้านดอลลาร์สหรัฐและทำให้ตนเองมีมูลค่าประมาณ 1 ล้านล้านดอลลาร์สหรัฐ ในช่วงเวลานี้มันยังจะสร้างโอกาสอ้างว่าสร้างเสร็จก่อนโครงการนำเข้าใหม่มากมายในนิเวศของของตะวันตก
เริ่มจากการคำนวณ Cache KV บางส่วนที่น่าสนใจ
โปรดตรวจสอบทวีตล่าสุดของ @SemiAnalysis_ ที่ทันสมัย
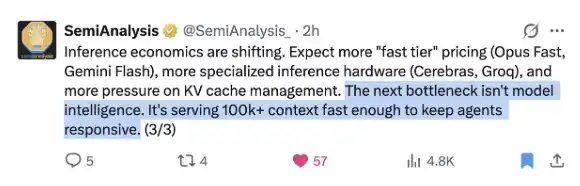
DeepSeek ได้แก้ปัญหานี้ดีกว่าผู้ใดทั้งหมด!
เรามาทำคำนวณ KV Cache ที่น่าสนใจกันบ้างครับ/ค่ะ อย่าตกใจนะครับ/ค่ะ แม้กระทั้งคุณไม่ชอบคณิตศาสตร์ก็ไม่เป็นไรครับ/ค่ะ เราจะใช้เครื่องคิดเลข KV Cache ที่เผยแพร่เมื่อเร็วๆ นี้มาดูว่า DeepSeek V4 Pro สามารถประหยัด KV Cache ได้เท่าไร และเปรียบเทียบกับโมเดล GLM และ Qwen ล่าสุดด้วย
ที่นี่ฉันคำนวณโดยใช้ความยาวของข้อความประมาณ 1 ล้านตัวอักษร คาดคะเนว่าความแม่นยำของ KV คือ 8 bit และขอบเขตของดัชนี คือ 16 bit คุณก็สามารถลองเปิดคำนวณด้วยตัวเองได้ที่นี่: https://kvcache.ai/tools/kv-cache-calculator/
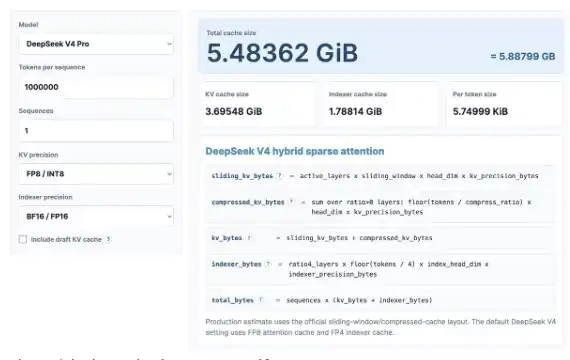
คุณก็สามารถลองเปิดคำนวณด้วยตัวเองได้!
ในขอบเขตของข้อความประมาณ 1 ล้านตัวอักษร:
·DeepSeek V4 ต้องใช้เพียง 5.48GB HBM;
·GLM-5 ต้องใช้ 60GB HBM;
·Qwen3-235B-A22B ต้องใช้สูงสุดถึง 89GB HBM
สิ่งที่ควรระวังคือ:
·DeepSeek เป็นโมเดลที่มีพารามิเตอร์ถึง 1.6 ล้านล้าน;
·GLM-5 มีประมาณ 7000 พารามิเตอร์และได้ใช้ MLA และ DSA จาก DeepSeek แต่ยังไม่ได้ใช้กลไกของการทำลายลำดับล่าสุด;
·Qwen3-235B-A22B มีประมาณ 2350 พารามิเตอร์และใช้กลไก GQA
DeepSeek ได้ช่วยลดความกดดันของหน่วยความจำอย่างมีพอแล้ว หากนวัตกรรมประเภทนี้ถูกนำไปใช้ในทั่วไป จะช่วยลดต้นทุนในการเรียกไปยังตัวบ่มเพลงที่อยู่ในระยะยาวและปลดล็อคศักยภาพแอปพลิเคชันชุดใหม่ๆ
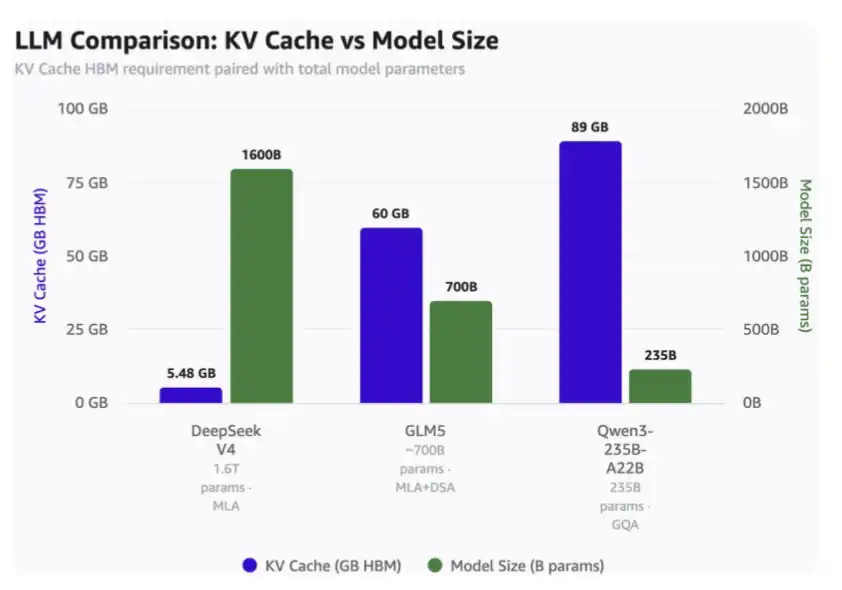
การใช้งาน KV Cache เปรียบเทียบกับข้อมูล Token 1 ล้านตัวในขอบเขตของโมเดล
Methodology Behind the "Madness"
เหตุผลที่ปริมาณของ KV Cache สามารถได้มีขนาดเล็กอย่างนี้ พร้อมกับความคุ้มค่าของโมเดลนั้นเป็นเพราะ DeepSeek สามารถให้การยังคงอยู่โดยเป็นเวลานานที่สุด ราคาที่หาได้ก็ไม่ถึง 3% ของราคาตัวตีลำดีต Sonnet 4.6 Cache Miss และนอกจากนั้น DeepSeek ยังสามารถเก็บไว้เป็นเวลาหลายชั่วโมง
สำหรับงานที่มีระยะเวลาในการดำเนินงานนาน KV Cache ขนาดเล็กหมายความว่าสามารถนำออกไปจาก HBM ไปยัง SSD ได้อย่างเศรษฐกิจมากขึ้นและโหลดกลับเมื่อจำเป็น ซึ่งจะช่วยลดการพึ่งพาระบบ HBM ได้ ด้วยมุมมองของอุตสาหกรรมฮาร์ดแวร์ AI ของจีน HBM ไม่ได้เพียงแต่มีการอัพพลางแต่ยังเป็นหนึ่งในประเภทหนึ่งของหน่วยความจำที่ยากที่สุดในการผลิต
นอกจากนี้ DeepSeek ยังพัฒนาเทคโนโลยีในการโหลด KV Cache จาก SSD ได้อย่างรวดเร็วมากขึ้น ซึ่งได้บ่งชี้ไว้ในเอกสาร Dual Path ของตน
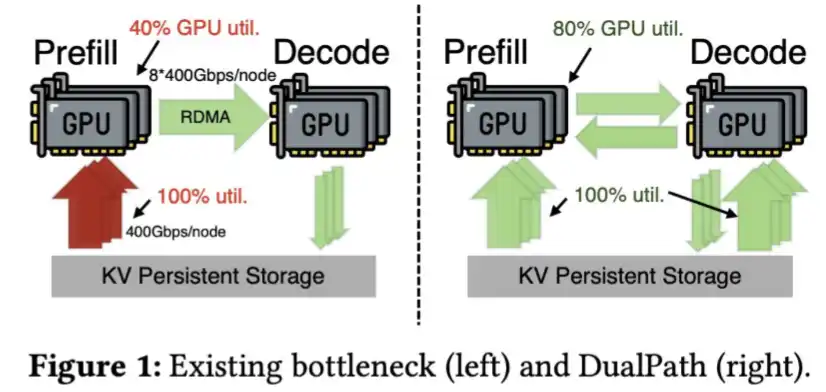
DeepSeek V4 มีการบีบอัด KV Cache อย่างมากจนกระทำนี้อาจไม่จำเป็นอีกต่อไป
ดังนั้น ผู้ได้รับประโยชน์โดยตรงจากการบีบอัด KV Cache คือใคร?
ใครที่จัดหา SSD ในมากระดับใหญ่? อย่าลืมว่า YMTC (Memory Technology) กำลังเติบโตเป็นยักษ์ใหญ่ในวงการ NAND ช่วย DeepSeek หลีกเลี่ยงการคำนวณซ้ำของ KV โดยกลับมาใช้งาน NAND ซึ่งในทวีปเอเชียจีนจะได้รับประโยชจากนี้ อีกทั้งบริษัทเกี่ยวข้องอื่น ๆ ยังได้รับประโยชจากนี้ด้วย
แม้จะเกี่ยวข้องกับ NAND และ SSD เท่านั้น
หน่วยความจำ LPDDR ก็มีศักยภาพอย่างมาก มันสามารถที่จะเป็นที่เก็บข้อมูลน้ำหนักของโมเดลและสามารถนำข้อมูลน้ำหนักเหล่านี้ไปกระจายไปที่ HBM เมื่อจำเป็น วง SGLang มีโพสต์บล็อกที่อธิบายข้อดีเหล่านี้อย่างดี ภาพต่อไปนี้แสดงหลักการการทำงานของโครงการนี้
อย่างเช่น DeepSeek ไม่ได้มีการออกแบบเฉพาะเพียงแค่ในที่นี้ แต่อาร์กิเทคเจคอาสถ่ายทอดนั่งของรุ่นจำลองชั้นเชียเป็น 4 bit ทำให้องค์การนี้เป็นไปได้ง่ายขึ้น
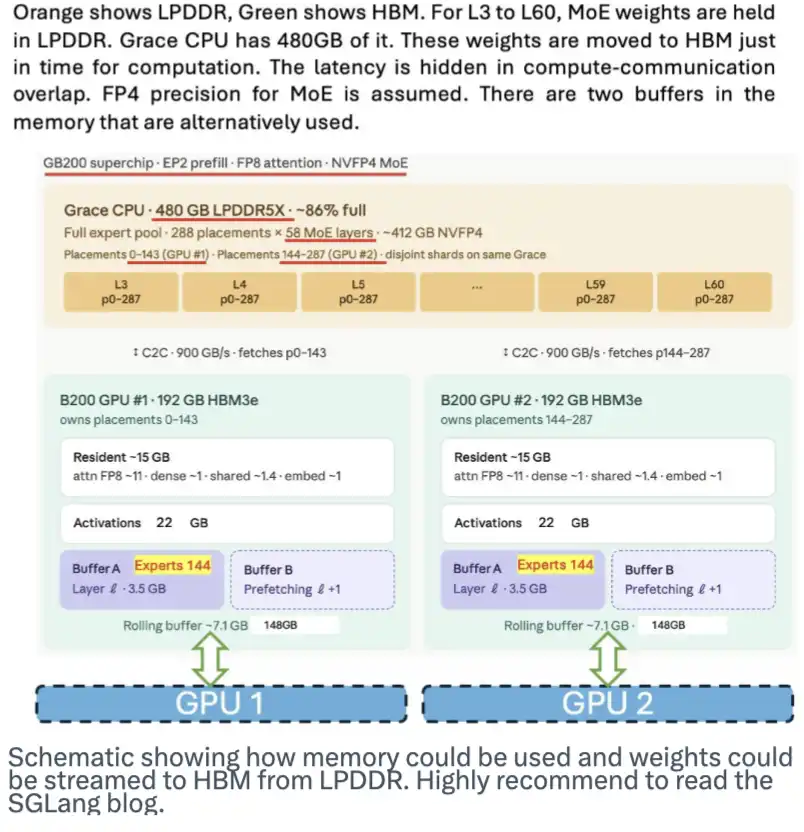
ภาพเชิงตัวอย่างแสดงถึงว่าหน่วยความจำอาจถูกใช้งานอย่างไร และนำน้ำหนักของโมเดลไปกระจายไปที่ HBM แนะนำอย่างมากให้อ่านบล็อกของ SGLang นั้น
นวัังนี้เป็นสิ่งใหม่โอนแรงกับหน่วยความจำ KV Cache ที่มีขนาดเล็กมากและไม่มีการสูญเสีย จะช่วยลดความต้องการ HBM ได้ยิ่งขึ้น
ดังนั้นใครที่ในประเทศจีนที่กำลังผลิต LPDDR? คำตอบคือ CXMT หรือ ChangXin Memory พวกเขาอยู่อยู่ใกล้เคียงกับลื่อสปีดของ LPDDR ที่ยศเพื่อนรุนแหวนเดียวกะ อยู่นะคะ
นอกจาก NAND ที่เพียงพอแล้ว ในอนาคตไม่ช้า นี้ นิเชีย AI จีน ยังคงมี LPDDR ที่เพียงพออย่างเช่นกัน นี่สามารถบรรเทาความดันของแรงงานได้หรือไม่ คำตอบคือ: สามารถ ดำเนินการต่อไป
การใช้หน่วยความจำอย่างอัจฉริยะ ยังสามารถบรรเทาความดันของ GPU/ASIC ได้
การใช้ NAND ในการเก็บ KV Cache ทำหน้าที่จริงๆ นั้นง่ายต่อการเข้าใจ: มันช่วยให้ KV Cache คงอยู่ได้นานขึ้นลดความดันที่เกี่ยวข้องกับ HBM พร้อมทั้งหลีกเลี่ยงการคำนวณที่ซ้ำกันของ KV Cache ซึ่งอาจจะทำให้ GPU และ ASIC ไม่ต้องรับภาระการคำนวณใหม่
แล้ว LPDDR จะสามารถมีผลเช่นเดียวกันหรือไม่ นอกจากการเป็นอุปกรณ์ที่สามารถถ่ายโอนน้ำหนักแบบสตรีมไล่ตามที่ต้องการไปยังตำแหน่งที่เก็บใน HBM โดยทันที LPDDR ยังสามารถลดความดันของการคำนวณได้อีกไหม
คำตอบคือ: สามารถ
LPDDR สามารถใช้ในการเก็บข้อมูลจำนวนมากที่เรียกว่า Engram ในเอกสารของ DeepSeek เขาได้ระบุว่า MoE สามารถขยายความจุโมเดลผ่านการคำนวณเงื่อนไข แต่ Transformer เองมีข้อบกพร่องในการหาที่มีความรู้ "knowledge retrieval" ตามแบบธรรมดา ตรรกะเลยไม่ต้องมาถึงการคำนวณอย่างไม่เหมาะสมเพื่อจำลองกระบวนการค้นหา
เพื่อแก้ปัญหานี้ DeepSeek นำเสนอ Engram Module มันทำให้ N-gram embedding สมัยใหม่ แปลงเป็นการหาด้วยแฮชที่ใช้กลไกการค้นหา O(1) ถูกร้อยเป็นเส้นทางการซากมูลแบบสมชู้ญพียงของจำนวนมาก เขาเรียกว่า หน่วยความจำตามเงื่อนไข
วิธีนี้ช่วยประหยัดการคำนวณ แต่ต้องใช้หน่วยความจำในการสลับตาราง embedding ซึ่งอาจจะมีขนาดใหญ่มากเอง
ในทางessence นี้เป็นวิธีที่ดีเล็งจิตเตือน "เอาหน้าเครื่องคำนวณตามหน่อยความจำ" แต่การสำคัญอยู่ที่: จากเส้นค่าแต่ละชิ้น การค้นหาapหน่วยความจำในด้านนั้น ๆ ต้องถูร้อยชาฉันไปต่างๆของ Transformer ดอยคำนวณเดินหน้าหลายก้าว เช่นกัน แล้วจธงระดับกว้างๆ มีการแลกเปลี่ยนที่คุ้มค่าเป็นสิ่งที่น่าทึกสุดหมื่นครั้ง
นี้คือว่า DeepSeek ผ่านการยอมให้เจำได้บางส่วนเพื่อประหยัดการคำนวณ
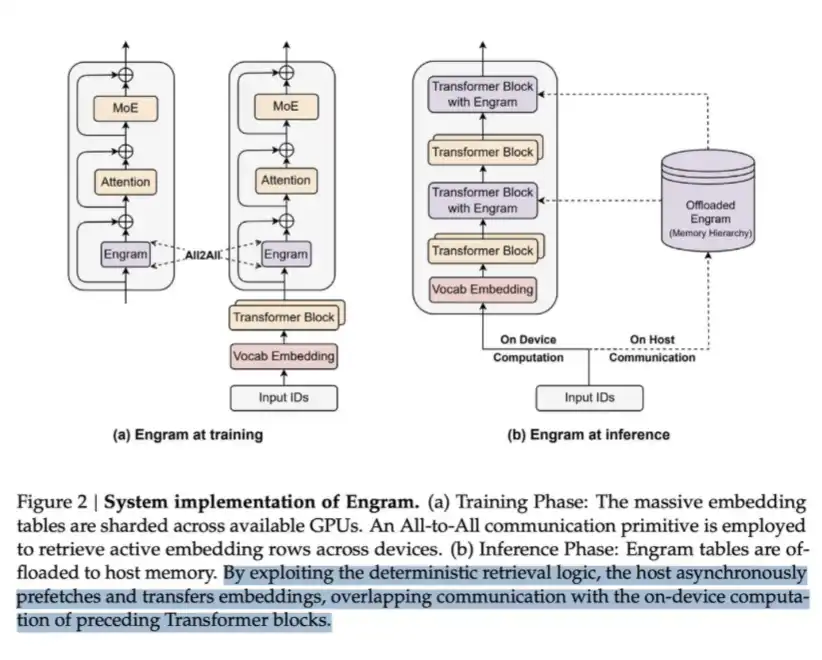
การเลือกตัดสินใจที่ควรพิจารณา
เนื่องจากไม่มีความหนาแน่นของชิปโดยเท่าเทียมและไม่มี EUV ในระดับเดียวกัน GPU และ ASIC ของจีน ในด้านประสิทธิภาพการคำนวณ FLOPs ด้วยความน่าจะเป็นจะด้อยกว่า GPU จากตะวันตก ในระยะยาว พวกเขายังมีความห่างในด้านการแพคเกจขั้นสูง จึงทำให้การตัดสินใจประเภทนี้เป็นสิ่งที่ควรพิจารณา โดยเฉพาะอย่างยิ่งในกรณีที่จีนสามารถผลิตอย่างมากในกลุ่มของหน่วยความจำ NAND และ LPDDR
การตรึงความคิดยาวนานของ DeepSeek
มองจากนวัตกรรมเหล่านี้ จุดมุ่งหมายของ DeepSeek ดูเหมือนว่าไม่ใช่การเพิ่มกำไรหลายพันล้านดอลลาร์ในชั่วขณะนี้ จากการตัดสินใจหลายอย่างที่ผ่านมา มันกล่าวถึงความจริงนี้: ถึงปัจจุบันยังไม่ได้มีโมเดลหลายรูปแบบ ไม่มีโมเดลเสียง โมเดลวิดีโอยิ่งอย่างที่พูดไม่ถูก
สิ่งที่มันทำอย่างจริงใจ คือเกมยาวนานที่ขณะนี้มีขอบเขตไปถึง 10 ล้านล้านดอลลาร์: ส่งเสริมการก่อตั้งอีคอโซส AI อย่างต่อเนื่บ
สิ่งนี้ไม่เพียงเพื่อให้โรงงานหน่วยความจำในประเทศจีนกลายเป็นผู้ร่วมสำคัญในตลาด AI ฮาร์ดแวร์ในประเทศจีนและทั่วโลก แต่ยังเพื่อลดลงทุนทรัพยากรจากต้นทางให้ตรงกับทราบรูปของแบบจำลอง AI ทำให้การฝึกตัวและให้บริการแบบจำลอง AI มีคุณสมบัติต้นทุนเหมาะสมขึ้น ดังนั้น ส่งผลให้หลาย ๆ โรงงาน GPU และ ASIC รวมทั้งผู้ผลิตชิปเครือข่าย มีโอกาสมากขึ้นที่จะเป็นตัวเลือกที่เหมาะสม
ในเวลาเดียวกัน นวัตกรรมเหล่านี้ยังจะทำให้และี่เปิดสู่ประโยชน์วากฉัยไตร ระบไท์ในตะวันตก และผู้ผลิตอุปกรณ์ชิปรุ่นใหม่
สัญญาณทั้งหมดอาจเคยปรากฏแล้ว เราสามารถทบทวน DeepSeek เอ็งเชื่อกันแตร์เกี่ยวกับนวัตกรรมเหล่านี้ได้ดังนี้:
1. โมเดลผสมหมดประสิทธิภาพ (MoE) และ แอมแอลเอ่
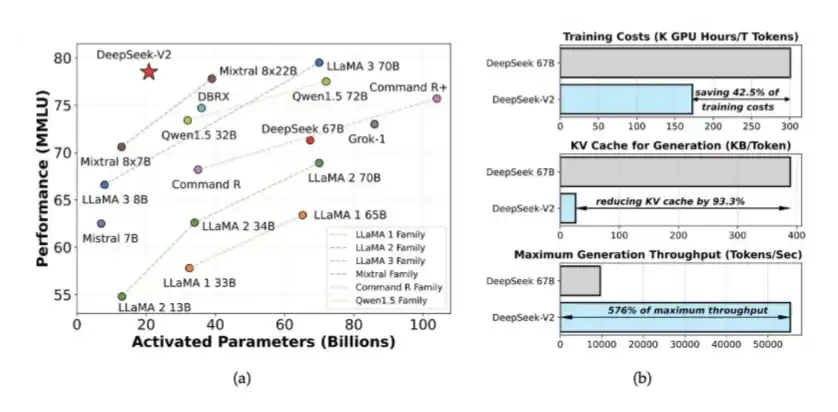
DeepSeek ใน V2 ในการนำเข้า MoE และ MLA MoE ลดความจำเป็นของการคำนวณที่ใช้สำหรับการฝึกโมเดลอัจฉริยะ โดยประมาณประมาณ 40% ถึง 50% MLA เป็นสิ่งที่ทำให้ KV Cache ลดลง 90%
สิ่งนี้ทำให้การฝ่าย่เก็บเก็จในอุปกรณ์เก็บเก็จหน่วยความจำอย่างมีประสิทธิภาพเยี่ยง
ความคิดนี้เสนอตั้งแต่ออกผล DeepSeek V2 ในเดือนพฤษภาคม พื้น 2024 ต่อมาไฟร่างมององต้งค้นของแปดของ H800 GPU รวมจำนวน 2048 จุสิ่งใช้งานเโรงโดยเป็นการฝึกออกํํํํํํระบที่มีประสิทธิภาพเข้าใกล้ระดับโมเดล oblack core
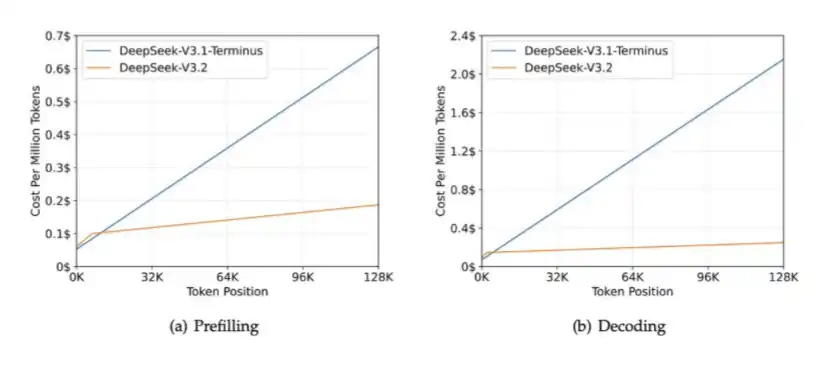
2、DSA: ถูกนำเข้าใน DeepSeek V3.2 Exp เพื่อลดความงุ่นง่ายในการคำนวณในบริบทที่ยาว ๆ พร้อมสลายเส้นทางแรงเส้นของ HBM พร้อมบรรเทาความดันของแบนด์วิดธ์
หน้าที่หลักของ DSA คือการให้ความแน่ใจว่าปริมาณการคำนวณจะไม่ต่อเนื่องกับการเพิ่มความยาวของบริบท สามารถดูได้จากรูปด้านล่าง: เมื่อความยาวของบริบทเพิ่มขึ้น DeepSeek-V3.2 จะคงความเร็วในการประมวลผลเกือบแทบไม่เปลี่ยนแปลง
3、mHC: DeepSeek ได้เสนอในเอกสาร "mHC: Manifold-Constrained Hyper-Connections" เมษายน วันที่ 20, 2568
mHC เป็นนวัตกรรมของ DeepSeek ในระดับโครงสร้างโดยรวม มันทำการออกแบบวิธีการกระจายข้อมูลระหว่างชั้น Transformer ใหม่
ในอดีต ตั้งแต่มี ResNet รุ่นแรก ๆ โมเดลมักใช้การเชื่อมต่อทิศทางที่เหลืออยู่เช่น x + F(x) และวิธีการของ mHC คือการขยายถึงการไหลของข้อมูลทิศทางให้กลายเป็นช่องสื่อสารหลายอันและอนุญาติให้โมเดลสามารถผสมสารในช่องสื่อสารเหล่านี้ได้โดยเรียนรู้ได้ สำคัญอยู่ที่มันจะจำกัดเมทริกซ์ผสมเป็นเมทริกซ์สุ่มสองอัน ทางการโคจะจำกัดให้อยู่ในพื้นที่หลายแปลงของ Birkhoff ด้วยการสะท้อน Sinkhorn-Knopp ด้วยวิธีนี้จึงสามรถใช้ทางคณิตศาสตร์ได้ว่า ไม่ว่าโมเดลจะซ้อนกันไปเท่าไหร่ สัญญาณกำลังคงทุกเวลา
นี้ได้อดีตะหน้าปัญหาความแปรปรวนที่ตกเหตการ Hyper-Connections ขาดด้าที่ถูกนำเสนอโดย ByteDance แต่เมื่อไม่มีข้อจำกัด สัญญาณที่ขยายจะขึ้นเหนอที่มากถึง 3000 เท่าเก่งแล้วก็ทำให้การฝึกอุปน้ำต่างๆ ทำลายตัวเอง
ค่าคำนวณของ mHC สูงกียอดมีเท่าน้อย: มันนำพาเพียง 6.7% ของเวลาการฝึกของจริงในขณะที่มันไม่ได้เปลี่ยน FLOPs ของชั้นของการสลองใคร่หรือ FFN แต่แค่เปลี่ยนวิธีการเปลี่ยนเส้นทางระหว่างชั้นเหล่านั้น
แต่มันนำมามีผลดีต่อประสิทธิภาพเป็นอย่างมาก: ในขนาดของ 270 พันล้านพารามิเตอร์ mHC ที่เรียกดำเนินงานจริงบน BIG-Bench Hard ม็อป ์เส้สที่ สิทธิใน DROP สิทธิใน GSM 8K สมอุมในการสรางสรรม MMLU ในรหับว่าเพิ่มสิทธิไปที่ 1.4 นาที ซึ่งการถูกพัฒนาทั้งหมดทั้งคือในขนาดโมเดลจำพื้นท่เดียวกัน แต่เป๋นอย่างแทบเท่ากัน
ในทำลัย mHC คือโดยการให้เครือข่ายมีถนนสารคดสารสื่อสารแบบเก็บระหว่างชั้นชีพเพื่อพท็งมะเรงที่ช่อง FLOPs ส่งให้เห็นถึงที่สูงตอนละการข้อข้ามดงมูของท่การท่าข้อมูล
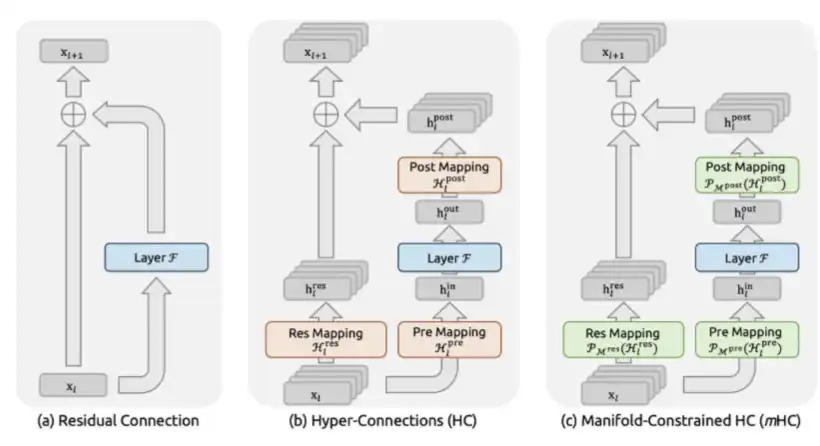
mHC เป็นโครงสร้างที่ซับซ้อน แต่สามารถนำมาฝึกอบรมได้อย่างมั่นคง และมีหน่วยพารามิเตอร์ที่สูงขึ้น
4、CSA、HSA:DeepSeek นำเสนอใน V4 เมื่อเมษายน 2026
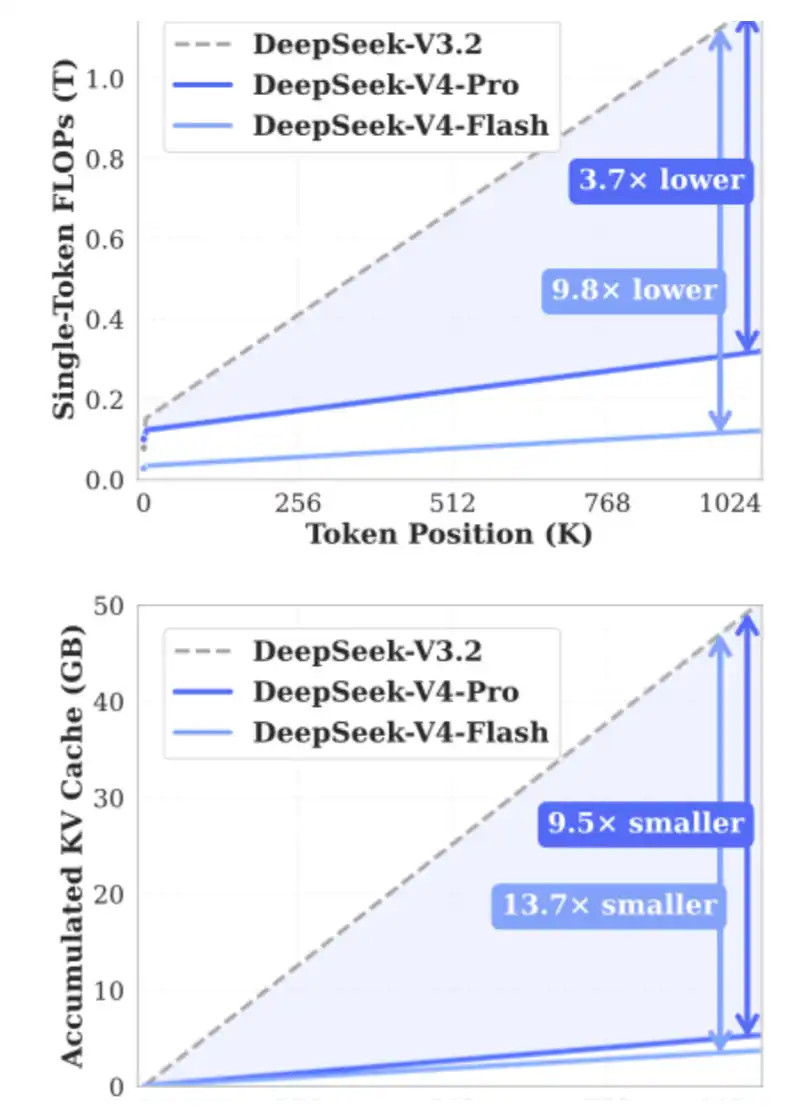
CSA และ HSA มีเป้าหมายที่จะลดความต้องการของ KV Cache อีก 90% โดยการบีบอัด KV Token พร้อมทั้งลด FLOPs ที่ต้องใช้ลงอย่างมาก ซึ่งจะช่วยบรรเทาความกดดันใน HBM และ GPU / ASIC ในเวลาเดียวกัน
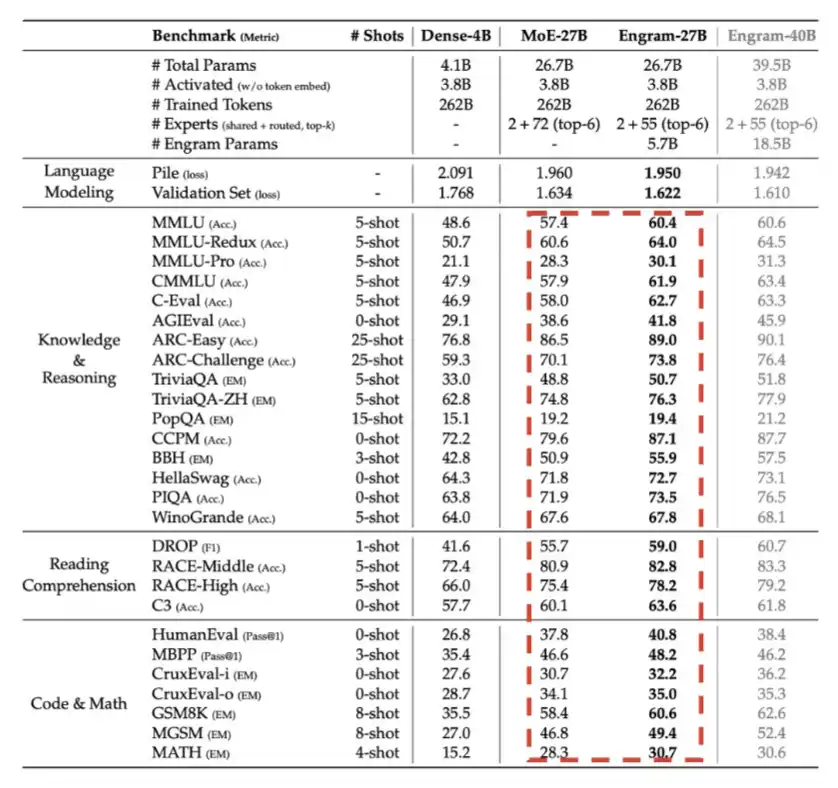
5、Engram:DeepSeek นำเสนอในไตรมาสแรกของปี 2026 ซึ่งจริงๆแล้วเป็นการใช้หน่วยความจำ หรือที่เรียกว่า LPDDR Memory ในระดับหนึ่ง เพื่อเพิ่มประสิทธิภาพในการคำนวณ
ตามตารางรายละเอียดด้านล่าง โดยที่งบประมาณพารามิเตอร์รวมเท่าเดิม Engram ทำให้มีประสิทธิภาพที่ชัดเจนขึ้น
6、Engram:DeepSeek นำเสนอในไตรมาสแรกของปี 2026 ซึ่งจริงๆแล้วเป็นการใช้หน่วยความจำ หรือที่เรียกว่า LPDDR Memory ในระดับหนึ่ง เพื่อเพิ่มประสิทธิภาพในการคำนวณ
ตามตารางรายละเอียดด้านล่าง โดยที่งบประมาณพารามิเตอร์รวมเท่าเดิม Engram ทำให้มีประสิทธิภาพที่ชัดเจนขึ้น
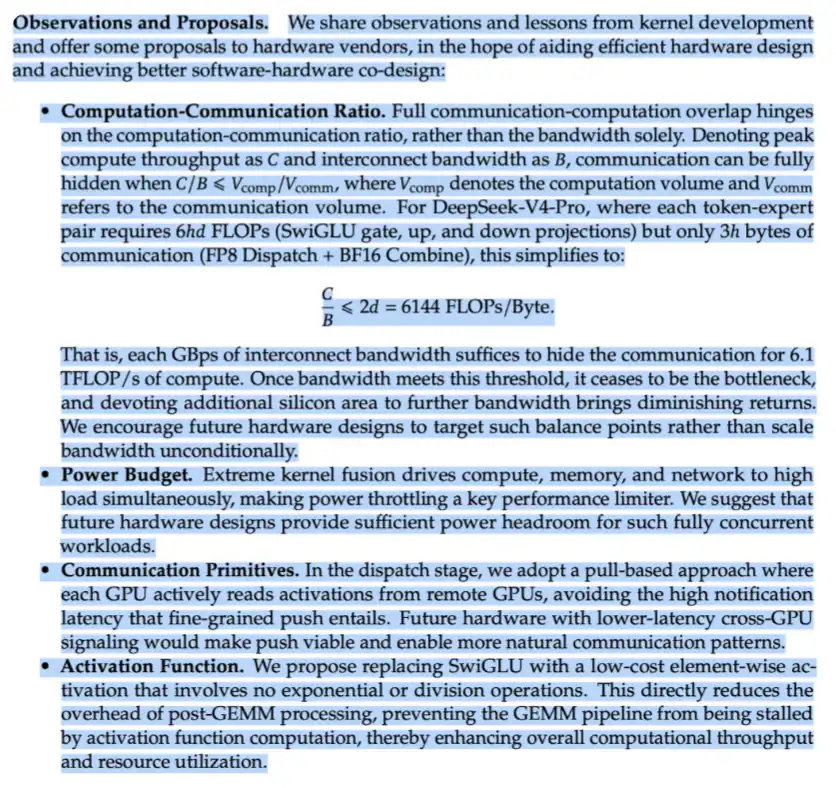
นี้คือคำแนะนำที่ DeepSeek ให้กับผู้ผลิตฮาร์ดแวร์ในเอกสาร V4 ฉบับฉบับแรก ฉันมั่นใจว่าความตอบรับที่พวกเขาได้รับจากการสนทนาในโหมดออฟไลน์ จะมีมากมายขึ้น
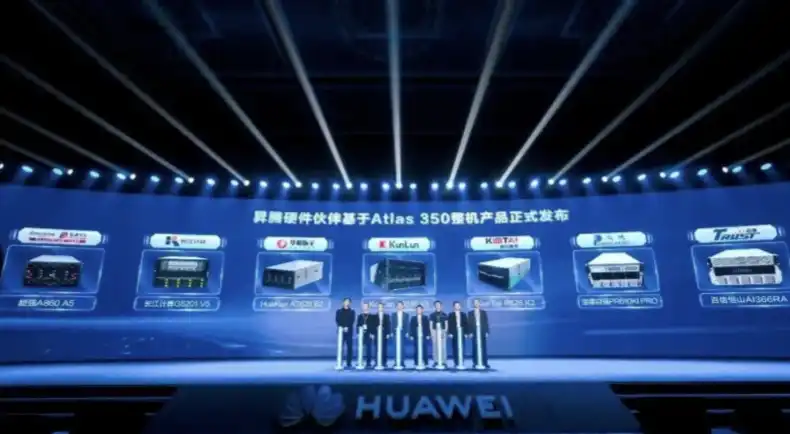
7、การลงทุนใน TileLang ก็ชี้ทางไปในทิศทางเดียวกัน: DeepSeek ไม่ได้แค่แก้ปัญหาของการจำกัดทรัพยากรในด้านความสามารถของตนเอง แต่ยังกำลังเสนอให้ระบบฮาร์ดแวร์ในประเทศจีนสามารถแข่งขันกับระบบฮาร์ดแวร์ในตะวันตกได้
ด้วย TileLang นักพัฒนาสามารถเขียน kernel เพียงครั้งเดียว ซึ่งก็คือโค้ดระดับต่ำสำหรับคำนวณ, แล้วทำให้มันสามารถทำงานได้บนหลายแพลตฟอร์มฮาร์ดแวร์สำเร็จ ที่ต้องมีการสนับสนุน Backend ของ TileLang สำหรับแพลตฟอร์มเหล่านั้น
ฉันคาดว่า ห้อง实验ของ AI อื่น ๆ ในจีน ก็จะเข้าร่วมตามลำพังกัน ซึ่งการเข้าร่วมนี้จะช่วยให้ผู้ผลิตฮาร์ดแวร์ในจีนสามารถตอบสนองกับสิ่งที่เรียกว่า "ยุทธศาสตร์ CUDA" โดยตรง พร้อมทั้งเปิดเผยศักยภาพของระบบฮาร์ดแวร์ในตะวันตกอย่างได้เต็มที่ เช่น AMD
Needs to be clarified that many AI hardware platforms in China have already provided CUDA compatibility or a CUDA translation layer. For example, Moore Threads, Muxi, Biren, and Tienschip are all Chinese chip manufacturers with high CUDA compatibility through a translation layer. Therefore, theoretically speaking, they may not necessarily need TileLang.
Large-Scale Reinforcement Learning and RSI
As DeepSeek gains more computing power sources, meaning more optional hardware, and the model itself requires less computational resources, it can drive more ambitious training projects, especially post-reinforcement learning training.
Reinforcement learning requires generating a large number of trajectories, meaning generating tens of trillions of Tokens. This process will quickly become extremely expensive. Furthermore, if you want to train a model with a context length of 1 million, you need to generate trajectories of the same length. Only by training the model on such ultra-long trajectories can it truly support long-term tasks.
In addition, as hardware options increase, the more hardware resources can be invoked by DeepSeek, which will drive research automation, known as RSI. RSI refers to AI designing and conducting experiments on its own. This approach will involve a lot of trial and error, and costs will rise rapidly. However, RSI is crucial for exploring the entire model design space. Before moving towards AGI, and subsequently towards ASI, DeepSeek must have RSI capabilities.
What DeepSeek does today, the entire industry will follow tomorrow
Around innovations such as expert-mixed models, MLA, DSA, etc., DeepSeek has been successively adopted by global and other AI labs in China.
For example, the developer of the GLM series model, ZAI, used MLA and DSA. Kimi, also known as Moonshot, has also adopted MLA and unreservedly stated that its architecture is based on the DeepSeek architecture. In turn, DeepSeek also uses the Muon optimizer, which was originally used by Kimi (Moonshot) in large-scale training.
It should be noted:
MoE was first proposed by Google in 2017, with key author Noam Shazeer. DeepSeek's contribution is to apply MoE on a large scale and invent its own accompanying techniques.
Muon หรือ MomentUm Orthogonalized by Newton-Schulz ออพไทเซอร์ถูกนำเสนอโดยนักวิจัยด้านเรียนรู้เครื่อง Keller Jordan เมื่อปลายปี 2024 คือ MomentUm Orthogonalized by Newton-Schulz ออพไทเซอร์
การแก้ปัญหาเกี่ยวกับเงิน
เราสามารถดูตัวอย่างที่น่าสนใจจาก OpenAI
OpenAI ได้รับสิทธิ์อย่างถูกค้านในการซื้อหุ้น AMD และ Cerebras ในราคาต่ำ ๆ ซึ่งทำให้ตัวเลือกทางการเงิน/ออปชันของพวกเขาสัมพันธ์กับเหรียญสำคัญในการใช้พลังงานคำนวณของพวกเขา เป็นธุรกรรมที่คุ้มค่ามากสำหรับ AMD และ Cerebras เนื่องจากเมื่อ OpenAI ครองจะใช้ฮาร์ดแวร์ของพวกเขา โอกาสในการประสบความสำเร็จในระยะยาวก็จะสูงขึ้นอย่างมาก
มีประกาศจาก AMD ว่า
"ในฐานะเป็นส่วนหนึ่งของข้อตกลงเพื่อประสานประโยชน์กลยุทธ์ของทั้งสองฝ่าย AMD ได้มอบสิทธิ์อย่างสูงสุดในการซื้อหุ้นธรรมดา AMD สูงสุด 160 ล้านหุ้นให้กับ OpenAI และจะกำหนดให้ผูกพันตามระยะเวลาสำหรับได้รับความเห็นชอบในช่วงเวลาเบื้องต้นเมื่อใช้งานกำลังไฟฟ้าเริ่มแรงเป็น 1 เวตต์ ส่วนคราวต่อไปจะได้รับผูกพันฉบับเป็นลำดับตามเพิ่มขนาดในการซื้อใยเป็น 6 เวตต์ ต่อไปจะเริ่มไปตามเป้าหมายราคาหุ้นที่เป็นพิเศษกับ AMD และได้รับผูกพันต่อการบรรลุเป้าหมายเทคโนโลยีและเพื่อมีธุรกิจพัฒนาซอฟต์แวร์ที่ใหญ่ถูกผูกพัน"
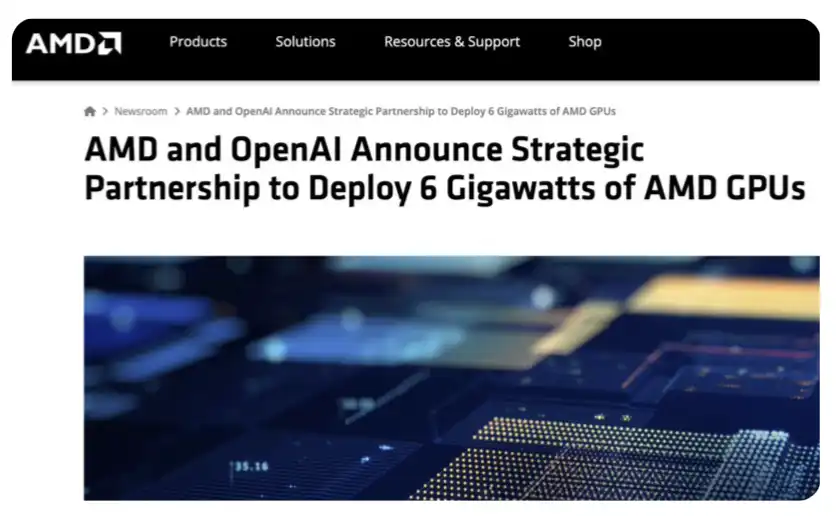
ฉันคาดหวังว่า DeepSeek ก็จะทำข้อตกลงเชิงเดียวกับหลายบริษัทผลิตเมมโมรีในจีน บริษัทผลิตชิป ASIC หรือ CPU และเทคโนโลยีเครือข่ายและจะร่วมมือในลึกของพวกเขาเพื่อให้สามารถของบริษัทผลิตฮาร์ดแวร์นั้นสามารถรองรับภาระงานการทำงาน AI ที่นำด้าน
ถ้านภาษาทั่วไปที่รวมหลายอเมริกาไฟ รวมทั้งเสมอ สว ที่และชาวตะวันออกของเอเชี่ยจะมีมูลค่าตลาดหุ้นที่เกินถึง 10 ล้านล้านเหรียญสหรัฐดอลล่านซึ่งวิธีที่ใช้กันเพื่อที่จะได้รับผลตอบแทนของหุ้นที่กลับมาจะทำให้ DeepSeek มีโอกาสช่วยฯ ประชาชนจีนให้สร้างอุตสาหกร", "ผลิตภาคอุตสาหกรรมแก่ในการงานอุตสาหกรรมและสุดท้ายงานไซ อัลมในการการลงมือปลุกราว 10-aryaren", "US from the Wenf from from the Jim Simons and ฯ มาจากจะต้องที่่มิสภาวิมจิดเสเนอเอเอช จีนดิกสีใช่ยช๋อ", "nons" }
ถ้าคุณสำรวจการกระทำที่ DeepSeek ได้ทำไปจนถึงปัจจุบัน ในทุกกรณีเพียงอย่างเดียวนั้นที่ชัดเจนที่สุด
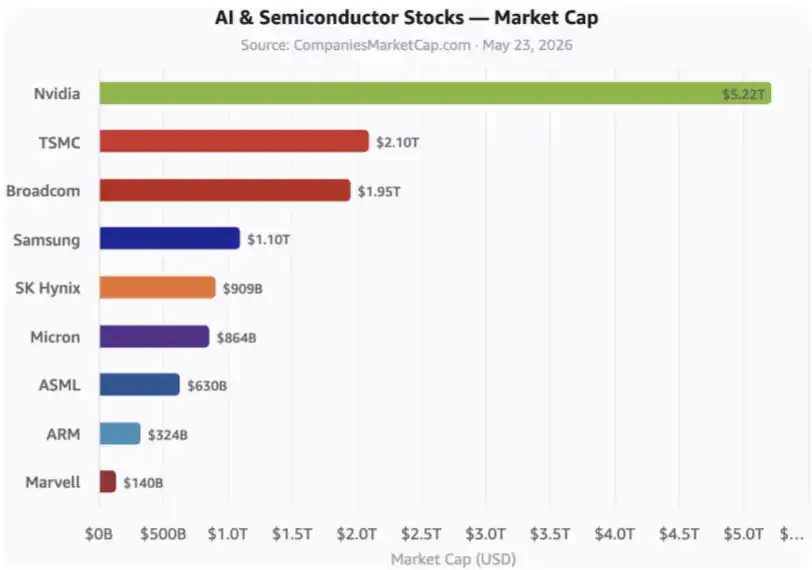
นี่คือหุ้น AI ที่สำคัญ ภาพยังไม่รวม hyperscalers หรือบริษัทคลาวด์ขนาดใหญ่มาก และบริษัทที่เกี่ยวข้องอีกมากมาย
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง