รายงานวิจัย SemiAnalysis: ทำไมจึงปรับลดคาดการณ์ความต้องการชิป และปรับลดคาดการณ์รายได้ของ NVIDIA ลงอย่างมาก?
หัวข้อต้นฉบับ: ปรับลดความต้องการตัวเร่งและแนวโน้มการจัดส่ง; Nvidia แบกรับผลกระทบหนักที่สุด
ผู้เขียนต้นฉบับ: Myron Xie และ Ivan Chiam
บทบรรณาธิการ: ชิป Nvidia Feynman Ultra หนึ่งตัว มีราคาขายเฉลี่ยแตกต่างกันประมาณ 77,000 ดอลลาร์สหรัฐในแบบจำลองสองเวอร์ชันของ SemiAnalysis เมื่อวันที่ 13 พฤศจิกายน สถาบันวิจัยเซมิคอนดักเตอร์แห่งนี้ได้ปรับลดคาดการณ์ราคาขายเฉลี่ยของชิปดังกล่าวจากประมาณ 175,000 ดอลลาร์สหรัฐ เหลือ 98,000 ดอลลาร์สหรัฐ ลดลงประมาณ 44% การปรับลดลงของต้นทุนหน่วยความจำแบนด์วิดท์สูง (HBM) อธิบายได้ส่วนหนึ่ง ส่วนการปรับที่เหลือสะท้อนการประเมินใหม่ของนักวิเคราะห์ต่อความสามารถในการกำหนดราคาของ Nvidia เมื่อลูกค้ารายใหญ่มีทางเลือกทดแทนมากขึ้น พรีเมียมที่ Nvidia จะเรียกเก็บสำหรับชิปเจเนอเรชันถัดไปอาจต่ำกว่าที่คาดไว้ก่อนหน้านี้
การปรับครั้งนี้ไม่ได้จำกัดอยู่แค่ Nvidia เท่านั้น SemiAnalysis ปรับลดคาดการณ์การใช้จ่ายตัวเร่ง AI ทั่วโลกในปี 2028 จาก 1.054 ล้านล้านดอลลาร์สหรัฐ เหลือ 758,000 ล้านดอลลาร์สหรัฐ ลดลงเกือบ 300,000 ล้านดอลลาร์สหรัฐ ตามแบบจำลองใหม่ การใช้จ่ายรายปีจะยังคงเกิน 900,000 ล้านดอลลาร์สหรัฐภายในปี 2030 ซึ่งมากกว่าปี 2026 เกินสองเท่า การเติบโตยังคงมีนัยสำคัญ แต่รายได้ประจำต่อปีแบบใหม่สุทธิในไตรมาสที่สามของห้องปฏิบัติการ AI ชั้นนำชะลอตัวลง และนักลงทุนก็เข้มงวดการระดมทุนสำหรับศูนย์ข้อมูลมากขึ้น โครงการที่ขาดคำมั่นสัญญาจัดซื้อจากลูกค้ารายใหญ่มักต้องแก้ปัญหาก่อนว่าใครจะออกเงินสร้างห้องเซิร์ฟเวอร์ ต่อไฟฟ้า และซื้ออุปกรณ์ คำสั่งซื้อชิปจึงจะมีโอกาสเป็นจริง
แรงกดดันที่ Nvidia เผชิญมาจากลูกค้าสองประเภท Anthropic สามารถจัดสรรพลังประมวลผลระหว่าง TPU ของ Google, Trainium ของ Amazon และผู้ผลิต GPU สองราย OpenAI ทั้งผลักดันชิปที่พัฒนาขึ้นเอง และยังได้รับผลประโยชน์ที่เป็นไปได้จากข้อตกลงใบสำคัญแสดงสิทธิกับ AMD ในขณะเดียวกัน Nvidia มีการเปิดรับต่อผู้ให้บริการคลาวด์เกิดใหม่มากที่สุดในบรรดาผู้จัดหาชิปทุกราย ลูกค้าเหล่านี้จำเป็นต้องระดมทุนซื้อ GPU ก่อน แล้วจึงเรียกคืนเงินลงทุนจากการให้เช่าพลังประมวลผล ผู้ซื้อรายใหญ่มีทางเลือกมากขึ้น ขณะที่ผู้ซื้อที่พึ่งพาการขยายธุรกิจด้วยการระดมทุนก็สั่งซื้อได้ยากขึ้น แรงกดดันสองด้านรวมกัน ทำให้ SemiAnalysis ปรับลดคาดการณ์รายได้จากผลิตภัณฑ์พลังประมวลผลที่สอดคล้องกับการจัดส่งของ Nvidia ในปี 2030 ลง 66%
การเปรียบเทียบระหว่าง Broadcom และ MediaTek เผยให้เห็นบัญชีหนึ่งที่มักถูกละเลยในการแข่งขันรอบนี้ ทั้งสองรายเข้าร่วมโครงการ TPU โดย MediaTek สามารถเสนอต้นทุนระบบที่ต่ำกว่า แต่ Broadcom มีความสามารถในการสนับสนุนการจัดหาเงินทุนสำหรับที่ดิน ไฟฟ้า ห้องเซิร์ฟเวอร์ และอุปกรณ์ สำหรับผู้ซื้อที่การเงินตึงตัว ต้นทุนสุดท้ายของระบบหนึ่งชุดกับเงินสดที่ต้องจ่ายวันนี้เป็นเกณฑ์การจัดซื้อที่แตกต่างกันสองด่าน เมื่อการแข่งขันชิปขยายไปสู่ศูนย์ข้อมูลทั้งหมด ผู้จัดหาที่ช่วยลูกค้าสร้างโครงการได้ก็มีโอกาสได้รับคำสั่งซื้อมากกว่า
ต่อไปนี้เป็นข้อความต้นฉบับ:
สรุปสั้น
·SemiAnalysis ปรับลดคาดการณ์การใช้จ่ายด้านตัวเร่งความเร็วในปี 2028 จาก 1.054 ล้านล้านดอลลาร์เหลือ 7.58 แสนล้านดอลลาร์ และคาดการณ์ปี 2030 ต่ำกว่าฉบับเก่าประมาณ 40%
·ห้องปฏิบัติการ AI ชั้นนำมีรายได้ประจำปีแบบต่อเนื่อง (ARR) สุทธิที่เพิ่มใหม่ในไตรมาส 3 ชะลอตัวลง ขณะที่นักลงทุนทั้งฝั่งหนี้และฝั่งทุนก็เข้มงวดการระดมทุนสำหรับโครงสร้างพื้นฐาน AI มากขึ้น โดยโครงการที่ขาดคำมั่นจัดซื้อจากผู้ให้บริการคลาวด์รายใหญ่มีความเปราะบางเป็นพิเศษ
·สมมติฐานราคาหน่วยความจำแบนด์วิดท์สูง (HBM) ที่ปรับลดลงเป็นหนึ่งในสาเหตุหลักที่ทำให้คาดการณ์การใช้จ่ายด้านตัวเร่งความเร็วลดลง ภายใต้โมเดลใหม่ ความต้องการ HBM ในหน่วยบิตยังคงเติบโต year-on-year
·สมมติฐานทั้งด้านปริมาณและราคาของ NVIDIA ถูกปรับลดลงทั้งคู่ เมื่อวัดจากรายได้ผลิตภัณฑ์ด้านกำลังประมวลผลที่สอดคล้องกับการจัดส่ง คาดการณ์ปี 2027 ถึง 2030 ถูกปรับลดลง 22%, 39%, 56% และ 66% ตามลำดับ
·คาดการณ์รายได้สะสมของชิปออกแบบเฉพาะของ Broadcom ปี 2026 ถึง 2030 ถูกปรับลดลง 11% โดยหลักมาจากราคา HBM ที่ลดลง ส่วน Triggerfish ที่ MediaTek ออกแบบให้ Anthropic คาดการณ์ปริมาณการจัดส่งตลอดวงจรชีวิตถูกปรับลดลง 42%
·คาดการณ์การใช้จ่ายระยะยาวของ AMD ก็ถูกปรับลดลงเช่นกัน แต่ธุรกรรมใบสำคัญแสดงสิทธิช่วยเพิ่มความน่าสนใจต่อ Meta และ OpenAI ส่วนคาดการณ์การจัดส่ง Trainium ของ Amazon ปี 2027 และ 2028 ยังคง维持在ระดับเดิม
การปรับคาดการณ์ความต้องการ
เราปรับลดคาดการณ์ปริมาณการจัดส่ง การใช้จ่าย และความต้องการไฟฟ้าของชิป AI และเซิร์ฟเวอร์ตลอดช่วงการคาดการณ์ทั้งหมด โดยคาดการณ์ปี 2028 ถึง 2030 ได้รับผลกระทบมากกว่า การปรับลดครั้งนี้สะท้อนการปรับสามด้าน ได้แก่ ปริมาณการจัดส่งที่ลดลง ราคาที่ลดลง และสมมติฐานการใช้พลังงานต่อชิปที่ต่ำลงสำหรับโครงการตัวเร่งความเร็วในอนาคตปี 2029 และ 2030
โดยรวมแล้ว เหตุผลที่เราปรับคาดการณ์มีดังนี้
1、เราประเมินความคาดหวังรายได้รวมจาก token ของระบบนิเวศทั้งหมดใหม่ โดยเฉพาะเมื่อพิจารณาจากการชะลอตัวของรายได้ประจำปีแบบต่อเนื่อง (ARR) สุทธิที่เพิ่มใหม่ในไตรมาส 3 ของห้องปฏิบัติการ AI ชั้นนำแต่ละแห่ง ดังนั้นเราจึงปรับลดประมาณการอุปทานใหม่ เพื่อให้รายได้สามารถครอบคลุมต้นทุนกำลังประมวลผลโดยรวมได้อย่างยั่งยืนมากขึ้น ดังที่เราได้ระบุไว้ในรายงานล่าสุด เรายังคงมองรายได้ของห้องปฏิบัติการเหล่านี้ในแง่ดีกว่าฉันทามติของตลาด และเห็นหลายพื้นที่ที่สามารถนำความสามารถ AI ชั้นนำไปใช้และได้รับผลตอบแทนการลงทุนสูง อย่างไรก็ตาม การที่การสร้างโครงสร้างพื้นฐานจะได้รับการระดมทุนหรือไม่นั้น ขึ้นอยู่กับความคาดหวังโดยรวมของผู้เล่นในตลาดทุน ซึ่งนำไปสู่ประเด็นถัดไป
2、ตลาดทุนได้ตึงตัวขึ้นแล้ว ทั้งนักลงทุนในตราสารหนี้และตราสารทุนต่างไม่เต็มใจที่จะลงทุนในรายจ่ายฝ่ายทุนที่เกี่ยวข้องกับการสร้างโครงสร้างพื้นฐาน AI มากขึ้น โดยเฉพาะโครงการที่ไม่มีคำมั่นสัญญาจัดซื้อจากผู้ให้บริการคลาวด์ขนาดใหญ่พิเศษ เรได้ discuss ปัญหานี้ในรายงานกรอบการระดมทุน ซึ่งจะลดการพัฒนาที่ดินสำหรับศูนย์ข้อมูล การติดตั้งระบบไฟฟ้า และการก่อสร้างอาคารหลัก โครงการที่ได้รับผลกระทบจะกระจุกตัวอยู่ในโครงการที่ขาดการสนับสนุนจากผู้ให้บริการคลาวด์ขนาดใหญ่พิเศษมากขึ้น และพลังงานไฟฟ้าที่ใช้สำหรับการติดตั้งระบบก็จะลดลงตามไปด้วย
3、ผลการเลือกตั้งกลางเทอมของสหรัฐฯ ทำให้กำลังการผลิตศูนย์ข้อมูลในสหรัฐฯ จำนวน 5.8 GW ที่เดิมกำหนดจะเปิดใช้งานในช่วงครึ่งหลังของปี 2027 และครึ่งแรกของปี 2028 ต้องเลื่อนออกไป ความล่าช้าเพิ่มเติมจากปัจจัยด้านกฎระเบียบยังกดดันกำลังการผลิตศูนย์ข้อมูลรวมในปี 2028 ให้ลดลงอีก เรได้พิจารณาปัจจัยนี้ในการวิเคราะห์ด้วย และมันทำให้ปริมาณการส่งมอบอุปกรณ์คอมพิวเตอร์ลดลงบ้างในระยะใกล้ แต่เราเน้นว่าสองปัจจัยแรกมีความสำคัญมากกว่า
ขนาดของการปรับลดไม่สอดคล้องกันระหว่างแพลตฟอร์มชิปและผู้จัดจำหน่ายต่างๆ ตามกรอบการวิเคราะห์ของเรา ลูกค้ายังคงให้ความสำคัญกับชิปที่มีประสิทธิภาพต่อต้นทุนรวมความเป็นเจ้าของ (perf/TCO) และประสิทธิภาพต่อกำลังไฟฟ้า (perf/W) ดีที่สุดเป็นอันดับแรก และพิจารณาเงื่อนไขทางการเงินบนพื้นฐานนั้น แพลตฟอร์มที่อยู่ในอันดับท้ายสุดในตัวชี้วัดเหล่านี้จะถูกตัดลดมากกว่า ผลลัพธ์คือ NVIDIA ได้รับผลกระทบมากที่สุด โดยการตัดลดรายจ่ายส่วนใหญ่อยู่ที่ NVIDIA นอกจากนี้ ในโครงการ ASIC เราคาดว่าโครงการ TPU ของ MediaTek จะได้รับผลกระทบเช่นกัน เนื่องจากความสามารถในการระดมทุนอ่อนกว่า Broadcom รูปด้านล่างสรุปการเปลี่ยนแปลงของรายจ่ายรวมที่เกี่ยวข้องกับตัวเร่งความเร็วและ HBM
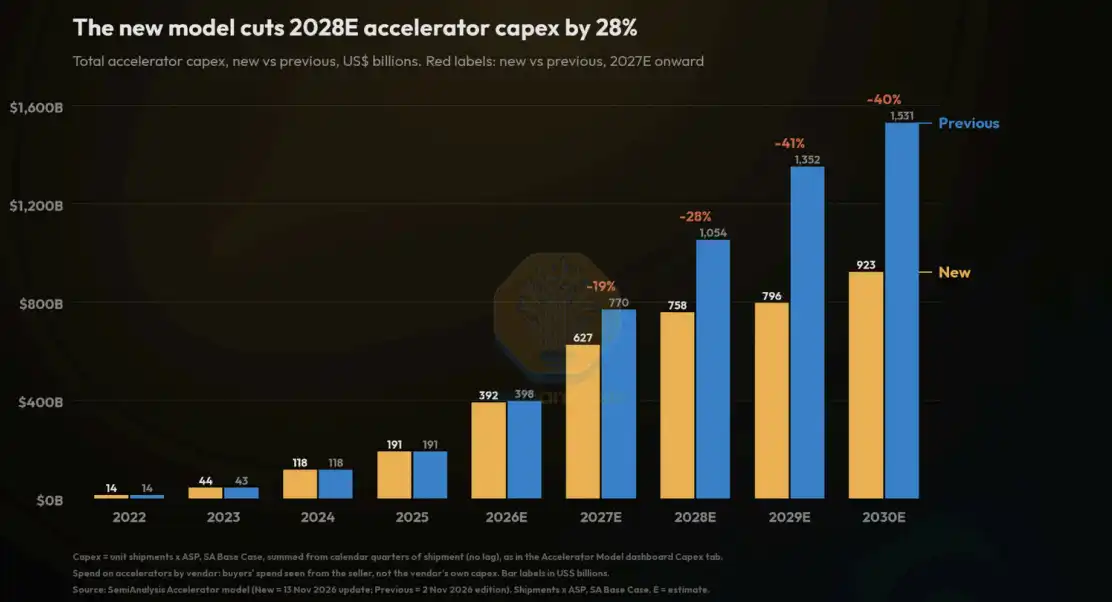
โมเดลใหม่ปรับลดประมาณการรายจ่ายฝ่ายทุนสำหรับตัวเร่งความเร็วในปี 2028 ลง 28% รายจ่ายฝ่ายทุนรวมสำหรับตัวเร่งความเร็ว เปรียบเทียบโมเดลใหม่กับโมเดลเก่า หน่วยเป็นพันล้านดอลลาร์ ตั้งแต่ค่าประมาณการปี 2027 เป็นต้นไป ตัวเลขสีแดงแสดงการเปลี่ยนแปลงของโมเดลใหม่เมื่อเทียบกับโมเดลเก่า สีเหลืองคือเวอร์ชันใหม่ สีน้ำเงินคือเวอร์ชันเก่า
การลดลงของรายจ่ายรวมส่วนใหญ่เกิดจากราคาที่ลดลง เมื่อประมาณการปริมาณการส่งมอบถูกปรับลดลง ความสัมพันธ์ระหว่างอุปสงค์และอุปทานของ HBM จึงสมดุลมากขึ้น เราจึงปรับลดสมมติฐานราคา HBM ลงด้วย รายละเอียดเพิ่มเติมดูได้จากการอัปเดตโมเดลหน่วยความจำที่เผยแพร่ในช่วงเดียวกัน ดังนั้นเราจึงนำการเปลี่ยนแปลงของราคา HBM มาคำนวณในการคาดการณ์ของชิปแต่ละรุ่น เพื่อสะท้อนการเปลี่ยนแปลงของต้นทุนรายการวัสดุ (BOM) สำหรับผลิตภัณฑ์ในอนาคตของ NVIDIA ตั้งแต่ Feynman เป็นต้นไป การปรับลดราคาขายเฉลี่ย (ASP) ยังสะท้อนถึงอัตราการบวกกำไรที่ลดลง และการเปลี่ยนแปลงของต้นทุน HBM ซึ่งสะท้อนว่าการแข่งขันในตลาดฮาร์ดแวร์ AI ได้ทวีความรุนแรงขึ้นอย่างมีนัยสำคัญแล้ว
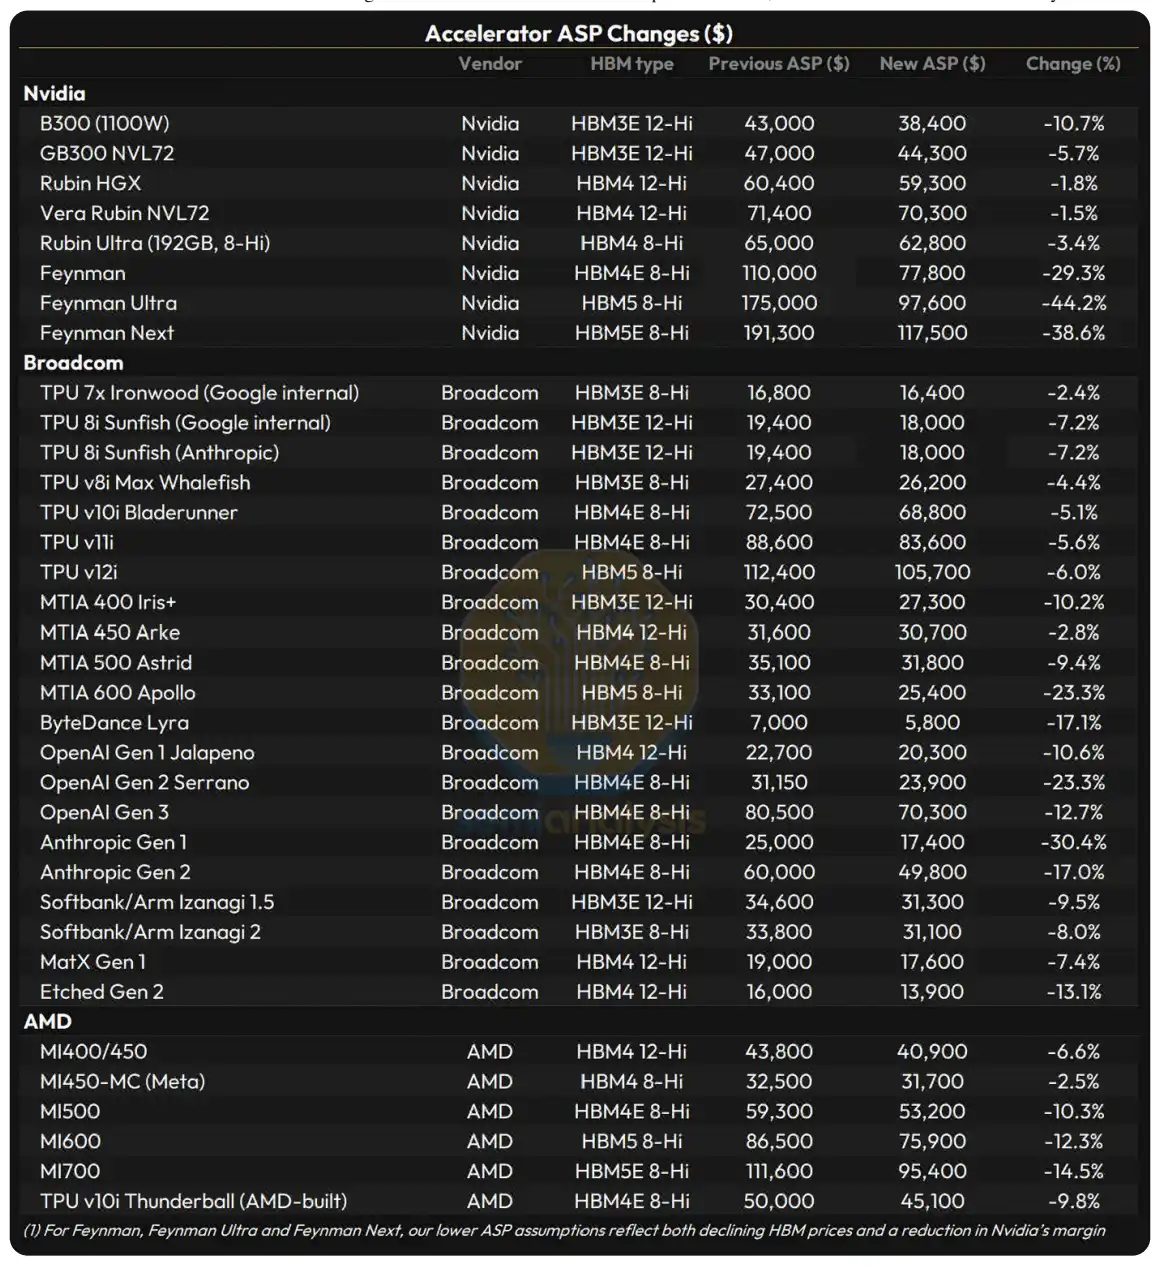
การปรับราคาขายเฉลี่ย (ASP) ของตัวเร่งความเร็ว หน่วยเป็นดอลลาร์ รุ่นผลิตภัณฑ์ ผู้จัดจำหน่าย ประเภท HBM ราคาขายเฉลี่ยโมเดลเก่า ราคาขายเฉลี่ยโมเดลใหม่ อัตราการเปลี่ยนแปลง (%) ที่มา: SemiAnalysis
การเพิ่มขึ้นของรายจ่ายที่คาดการณ์ไว้ก่อนหน้านี้สำหรับปี 2027 ส่วนหนึ่งมาจากการปรับขึ้นของราคา โดยเฉพาะราคาหน่วยความจำที่เพิ่มขึ้น ดังนั้น การปรับลดราคาที่ตามมาจึงหมายความว่าห่วงโซ่อุปทานกลับสู่สภาวะที่ "ปกติ" มากขึ้น
การเปลี่ยนแปลงของราคายังอธิบายได้ว่าทำไมพื้นที่ซิลิคอนที่สอดคล้องกับการจัดส่งและความต้องการ HBM ที่วัดเป็นบิตยังคงเพิ่มขึ้น และเติบโตเร็วกว่ารายจ่ายตามมูลค่าที่ระบุ
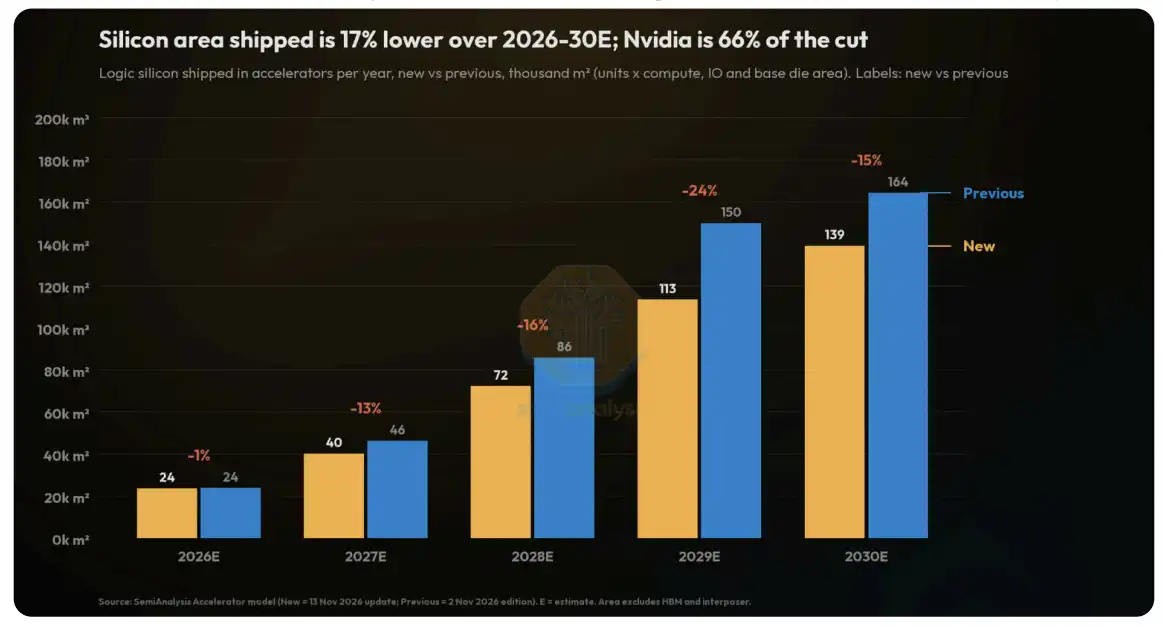
พื้นที่ซิลิคอนรวมของการจัดส่งที่คาดการณ์ในช่วงปี 2026 ถึง 2030 ถูกปรับลดลง 17% โดย NVIDIA คิดเป็น 66% ของปริมาณที่ปรับลด
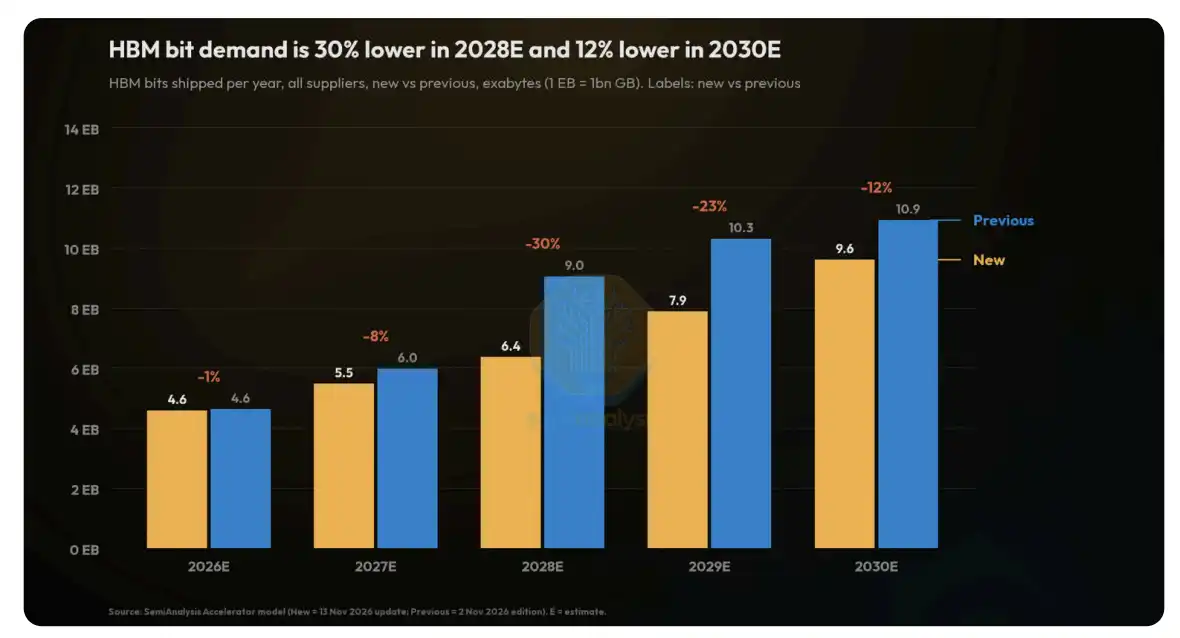
ความต้องการ HBM ที่วัดเป็นบิตในปี 2028 ถูกปรับลดลง 30% และในปี 2030 ปรับลดลง 12%
การคาดการณ์ความต้องการไฟฟ้าสำหรับ AI ก็ถูกปรับลดลงเช่นกัน ซึ่งเป็นผลมาจากปริมาณการจัดส่งที่ลดลงและสมมติฐานการใช้พลังงานต่อชิปที่ปรับลดลง เนื่องจากไฟฟ้ายังคงเป็นปัจจัยจำกัด เราคาดว่าแผนผลิตภัณฑ์ในอนาคตจะปรับลดการใช้พลังงานสูงสุดของชิป การลดลงของความต้องการไฟฟ้ายังหมายความว่า ตามการคาดการณ์อุปทานไฟฟ้าทั่วโลก (ไม่รวมจีน) ในช่วงปี 2027 ถึง 2029 ที่แก้ไขตามแบบจำลองศูนย์ข้อมูลของเรา อุปกรณ์ที่จัดส่งเหล่านี้มีไฟฟ้าเพียงพอสำหรับการติดตั้งใช้งาน
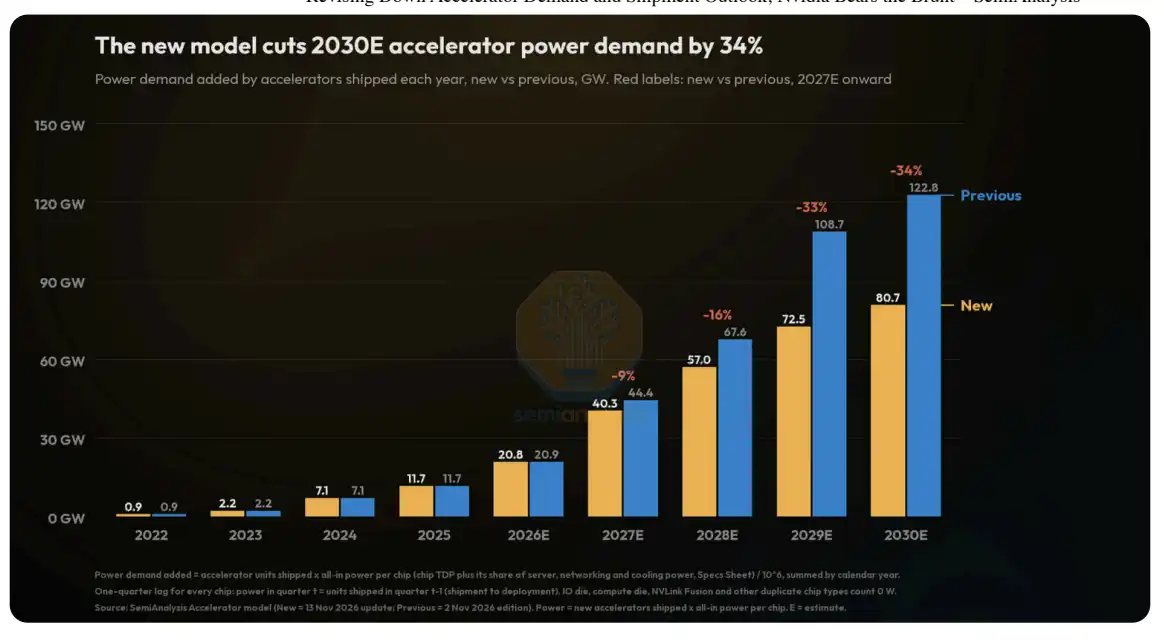
แบบจำลองใหม่ปรับลดการคาดการณ์ความต้องการไฟฟ้าสำหรับตัวเร่งในปี 2030 ลง 34%
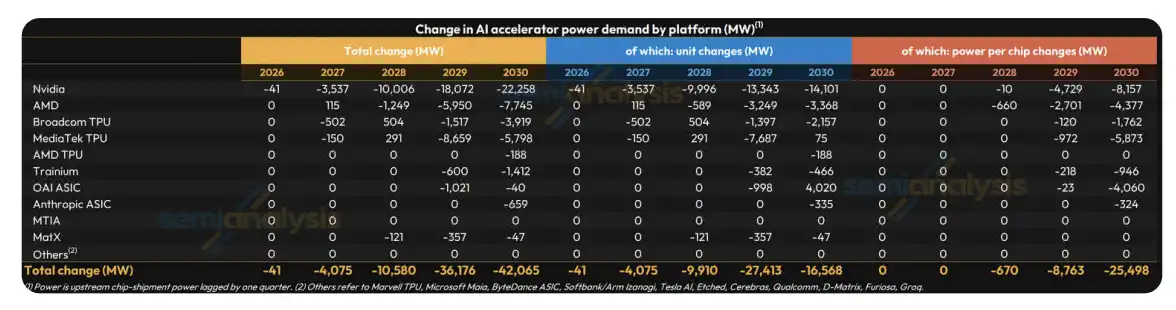
การเปลี่ยนแปลงของความต้องการไฟฟ้าสำหรับตัวเร่ง AI แยกตามแพลตฟอร์ม หน่วยเป็น MW
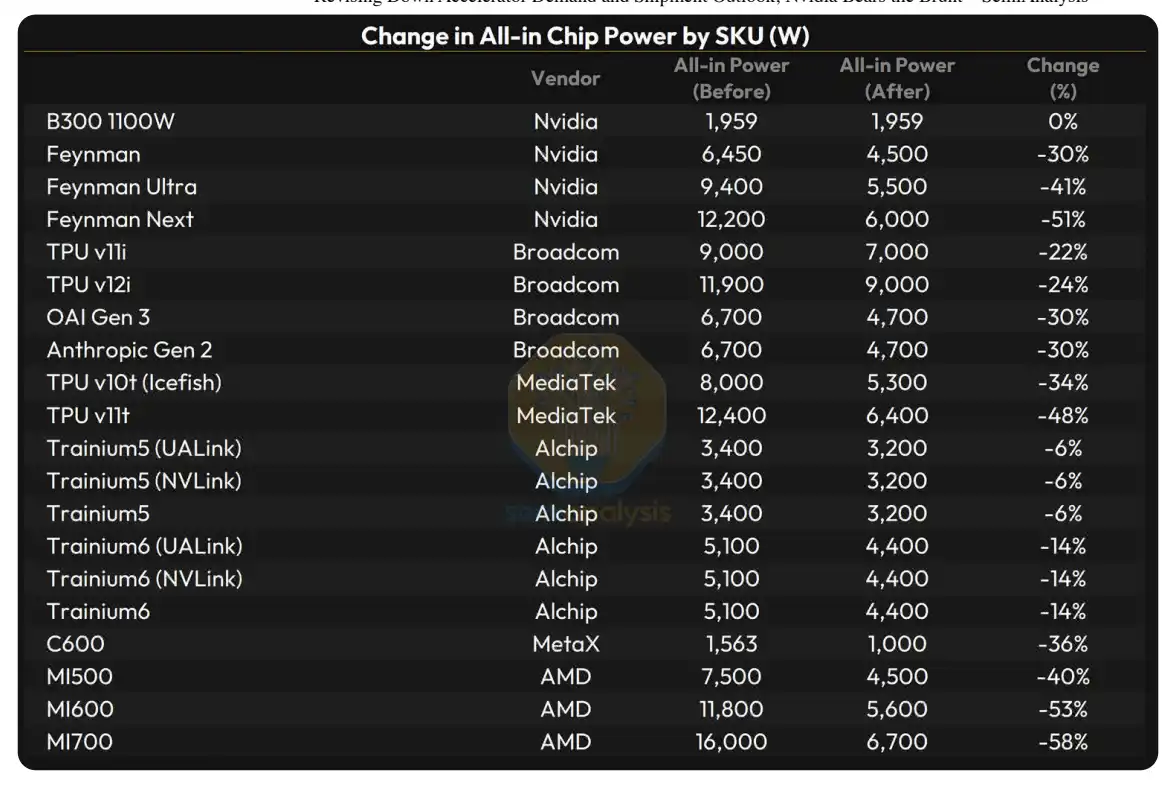
การเปลี่ยนแปลงของการใช้พลังงานรวมของชิปแต่ละรุ่น หน่วยเป็น W
ต่อไป เราจะทบทวนการเปลี่ยนแปลงเหล่านี้ทีละผู้จำหน่ายและแพลตฟอร์ม
NVIDIA
เมื่อวัดจากรายได้จากผลิตภัณฑ์ด้านกำลังประมวลผล เราปรับลดการคาดการณ์การจัดส่งของ NVIDIA ในปี 2027, 2028, 2029 และ 2030 ลงอย่างมีนัยสำคัญที่ 22%, 39%, 56% และ 66% ตามลำดับ เมื่อวัดจากการใช้พลังงานรวม ปรับลดลงที่ 14%, 35%, 50% และ 59% ตามลำดับ เริ่มตั้งแต่ Feynman นอกเหนือจากการคำนึงถึงการเปลี่ยนแปลงต้นทุน HBM แล้ว เรายังปรับลดสมมติฐานราคาขายเฉลี่ยลงอีก เนื่องจากเราเชื่อว่า NVIDIA จำเป็นต้องยอมรับอัตรากำไรที่ต่ำลงเพื่อรักษาความสามารถในการแข่งขันเมื่อเทียบกับโครงการอื่นๆ ราคาขายที่คาดการณ์ของ Feynman ปรับลดจากประมาณ 110,000 ดอลลาร์เหลือประมาณ 78,000 ดอลลาร์ Feynman Ultra จากประมาณ 175,000 ดอลลาร์เหลือประมาณ 98,000 ดอลลาร์ และ Feynman Next จากประมาณ 191,000 ดอลลาร์เหลือประมาณ 118,000 ดอลลาร์ การปรับลดราคาและปริมาณการจัดส่งพร้อมกันหมายความว่ารายได้ที่คาดการณ์ของ NVIDIA จะลดลงอย่างมีนัยสำคัญ การปรับลดครอบคลุม GPU, Groq LPU และ CPU แบบแยก
เราปรับลดประมาณการความต้องการของ NVIDIA มากที่สุด เนื่องจากในระบบพลังประมวลผลของห้องปฏิบัติการ AI ชั้นแนวหน้า GPU ของ NVIDIA มีความน่าสนใจอยู่ในอันดับท้ายๆ ในบรรดาแพลตฟอร์มพลังประมวลผลสี่แห่งที่ Anthropic ใช้งาน ได้แก่ TPU, Trainium, GPU ของ AMD และ GPU ของ NVIDIA นั้น GPU ของ NVIDIA มีสถานะเป็นชายขอบที่สุด ในแง่ประสิทธิภาพต่อต้นทุนต่อหน่วย Anthropic ให้ความสำคัญกับแพลตฟอร์มอื่นมากกว่า
แม้ว่า GPU จะมีบทบาทสำคัญกว่าในโครงสร้างพื้นฐานของ OpenAI แต่เมื่อพิจารณาถึงผลประโยชน์ทางการเงินที่可观จากธุรกรรมใบสำคัญแสดงสิทธิของ AMD แล้ว GPU ของ AMD ได้กลายเป็นทางเลือกที่น่าสนใจมาก นอกจากนี้ OpenAI จะให้ความสำคัญกับการติดตั้งใช้งานโครงการ ASIC ของตน ได้แก่ Jalapeno และ Serrano รุ่นถัดไปก่อน เนื่องจากชิปเหล่านี้มีประสิทธิภาพด้านต้นทุนรวมความเป็นเจ้าของต่อหน่วยเป็นผู้นำอยู่แล้ว
นอกจากนี้ NVIDIA ยังมีการเปิดรับความเสี่ยงต่อลูกค้าผู้ให้บริการคลาวด์เกิดใหม่ (Neocloud) มากที่สุดในบรรดาผู้จำหน่ายทุกราย โดยเฉพาะลูกค้าหางยาวที่มีขนาดค่อนข้างเล็ก ปัจจุบันผู้ให้บริการคลาวด์เกิดใหม่เผชิญความเสี่ยงที่ใหญ่กว่ามากทั้งในด้านการดำเนินโครงการและความสามารถในการระดมทุน ลูกค้าปลายทางในจีนยังได้ให้คำมั่นสัญญากับผู้ให้บริการคลาวด์เกิดใหม่ในการจัดซื้อพลังประมวลผลในปริมาณที่ค่อนข้างมาก ความเป็นไปได้ที่ร่างกฎหมาย RASA จะกลายเป็นกฎหมายดูเหมือนกำลังเพิ่มขึ้น เมื่อมีผลบังคับใช้ การเข้าถึง GPU จากระยะไกลจะถือเป็นการส่งออก ดังนั้นการที่ลูกค้าจีนเข้าถึง GPU ขั้นสูงจากระยะไกลจึงจะถือเป็นการละเมิดการควบคุมการส่งออก
สุดท้าย เราชี้ให้เห็นว่าการปรับแบบจำลองครั้งนี้ยังไม่ได้คำนึงถึงผลกระทบจากการที่ Jensen Huang ลาออกจากตำแหน่ง CEO ของ NVIDIA แม้ว่า Jensen Huang จะยังคงดำรงตำแหน่ง CEO ต่อไป เราก็จะยังคงปรับแบบเดียวกันนี้ เมื่อพิจารณาถึงความสำคัญของ Jensen Huang ต่อ NVIDIA เราเชื่อว่าการเปลี่ยนแปลงผู้นำครั้งนี้จะเพิ่มความเสี่ยงต่อการลดลงของส่วนแบ่งการตลาด โดยอาจลดลงมากกว่าที่เราได้ระบุไว้ในการคาดการณ์นี้
เนื่องจากการจัดส่งการ์ด Vera Rubin L6 ล่าช้าจากไตรมาสที่สามไปเป็นไตรมาสที่สี่ เราจึงได้ปรับประมาณการสำหรับไตรมาสที่สามและสี่ของปี 2026 ด้วย เราย้าย GPU Rubin ประมาณ 100,000 ตัวจากไตรมาสที่สามของปี 2026 ไปเป็นไตรมาสที่สี่ โดยปริมาณการจัดส่ง Vera Rubin ทั้งปี 2026 ยังคงอยู่ที่ประมาณ 980,000 ตัว GB300 เพิ่มปริมาณการจัดส่งประมาณ 130,000 ตัวในไตรมาสที่สามเพื่อเติมเต็มช่องว่างนี้ เมื่อ Rubin เร่งการผลิตเพิ่มขึ้น เราได้ปรับลดประมาณการในไตรมาสที่สี่ของปี 2026 ลงประมาณ 260,000 ตัวสำหรับ GB300 และประมาณ 150,000 ตัวสำหรับ H200 เมื่อรวมการปรับทั้งหมดข้างต้น รายได้รวมของ NVIDIA ในไตรมาสที่สามของปี 2026 จะอยู่ที่ประมาณ 109.1 พันล้านดอลลาร์สหรัฐ และไตรมาสที่สี่ประมาณ 125.3 พันล้านดอลลาร์สหรัฐ
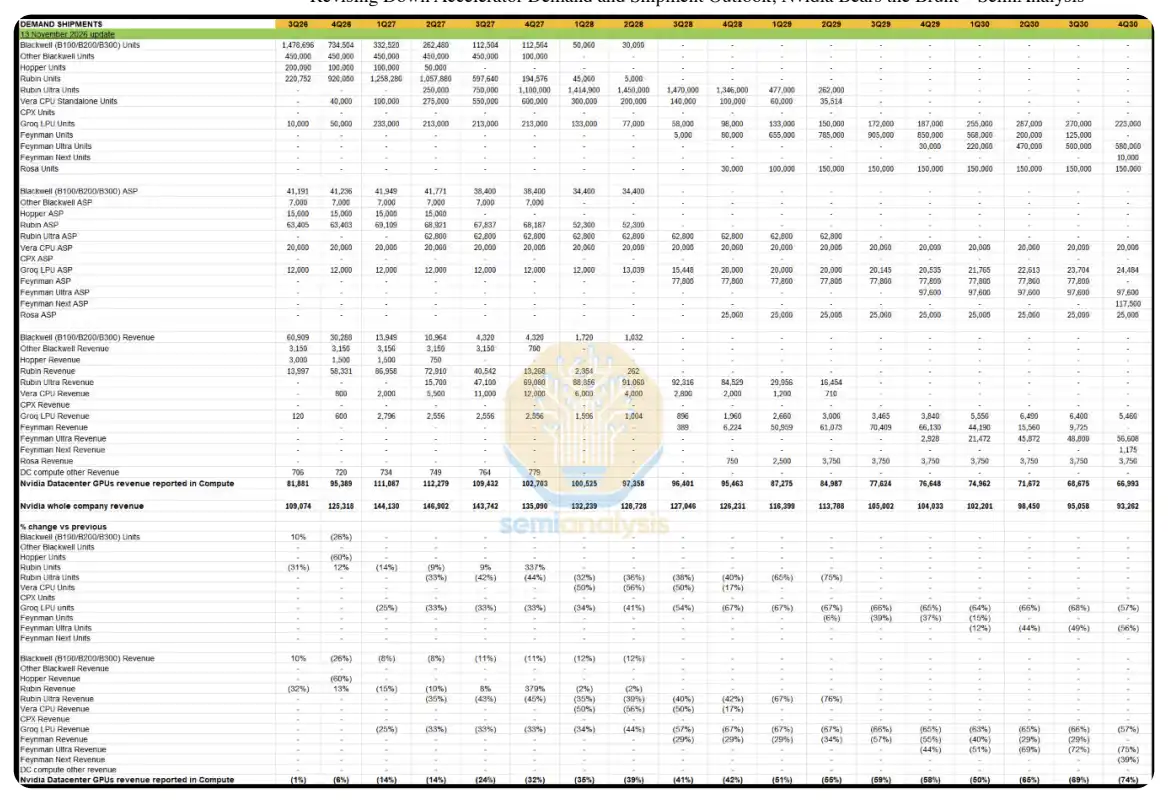
ประมาณการปริมาณการจัดส่ง (NVIDIA) ตารางนี้มีวันที่อัปเดตเป็น 13 พฤศจิกายน 2026 แสดงปริมาณการจัดส่ง ราคาขายเฉลี่ย และรายได้ของแต่ละรุ่นตามรายไตรมาส พร้อมทั้งแสดงอัตราการเปลี่ยนแปลงเมื่อเทียบกับฉบับก่อนหน้า รายการสรุปรวมถึงรายได้ GPU ศูนย์ข้อมูลของ NVIDIA ที่นับรวมในธุรกิจพลังประมวลผล และรายได้รวมของบริษัท NVIDIA ที่มา: SemiAnalysis
Broadcom
Broadcom ได้รับผลกระทบน้อยที่สุด โดยประมาณการรายได้สะสมจาก ASIC ในปี 2026 ถึง 2030 ถูกปรับลดลง 11% สาเหตุหลักมาจากการปรับลดราคาขายเฉลี่ยที่เกิดจากต้นทุน HBM ที่ลดลง ผลกระทบจากการลดปริมาณการจัดส่งมีน้อยกว่า เราเชื่อว่าความต้องการของ Broadcom จะไม่ลดลง เนื่องจากโครงการ ASIC ทั้งสามของบริษัท (TPU, OpenAI และ Anthropic) สามารถมอบประสิทธิภาพต่อต้นทุนต่อหน่วยและประสิทธิภาพต่อกำลังไฟฟ้าต่อหน่วยที่สูงขึ้นให้แก่ลูกค้าปลายทาง ขณะเดียวกัน Broadcom ก็มีความสามารถในการค้ำประกันข้อตกลงทางการเงินที่เจ้าหนี้จัดหาให้ เพื่อระดมทุนสำหรับที่ดิน ไฟฟ้า อาคารหลัก และระบบ สำหรับ OpenAI เราได้ปรับลดขนาดประมาณการของ Serrano รุ่นที่สองในปี 2029 ลง 1 GW พร้อมทั้งปรับเพิ่มปริมาณการจัดส่งของผลิตภัณฑ์รุ่นที่สามในปี 2030 ขึ้นอย่างมาก
เราปรับลดปริมาณการจัดส่ง TPU ลงเล็กน้อย ซึ่งเกี่ยวข้องกับ Google และ Anthropic เนื่องจากคาดว่าการพัฒนาศูนย์ข้อมูลในรัฐเท็กซัสจะหยุดชะงัก เราจึงเลื่อนการส่งมอบ TPU ขนาด 700 MW ให้กับ Anthropic ที่เดิมกำหนดไว้ในปี 2027 ออกไปเป็นปี 2028 ทีมศูนย์ข้อมูลของเราคาดว่าความจุประมาณ 275 MW ของโครงการ Crusoe/Goodnight จะล่าช้าจากไตรมาสที่ 4 ปี 2027 และอีก 330 MW ของโครงการ Nexus ที่ Hubbard ซึ่งยังไม่ได้รับอนุมัติก็มีความเสี่ยงเช่นกัน ทั้งสองโครงการใช้สำหรับการติดตั้ง TPU ของ Anthropic
อีกโครงการของ Broadcom ที่เราปรับลดคาดการณ์ลงมาจากบริษัทสตาร์ทอัพ MatX เราเชื่อว่า MatX มีความไม่แน่นอนสูงกว่าและระดมทุนได้ยากกว่า จึงปรับลดประมาณการความต้องการชิป MatX ของ Anthropic
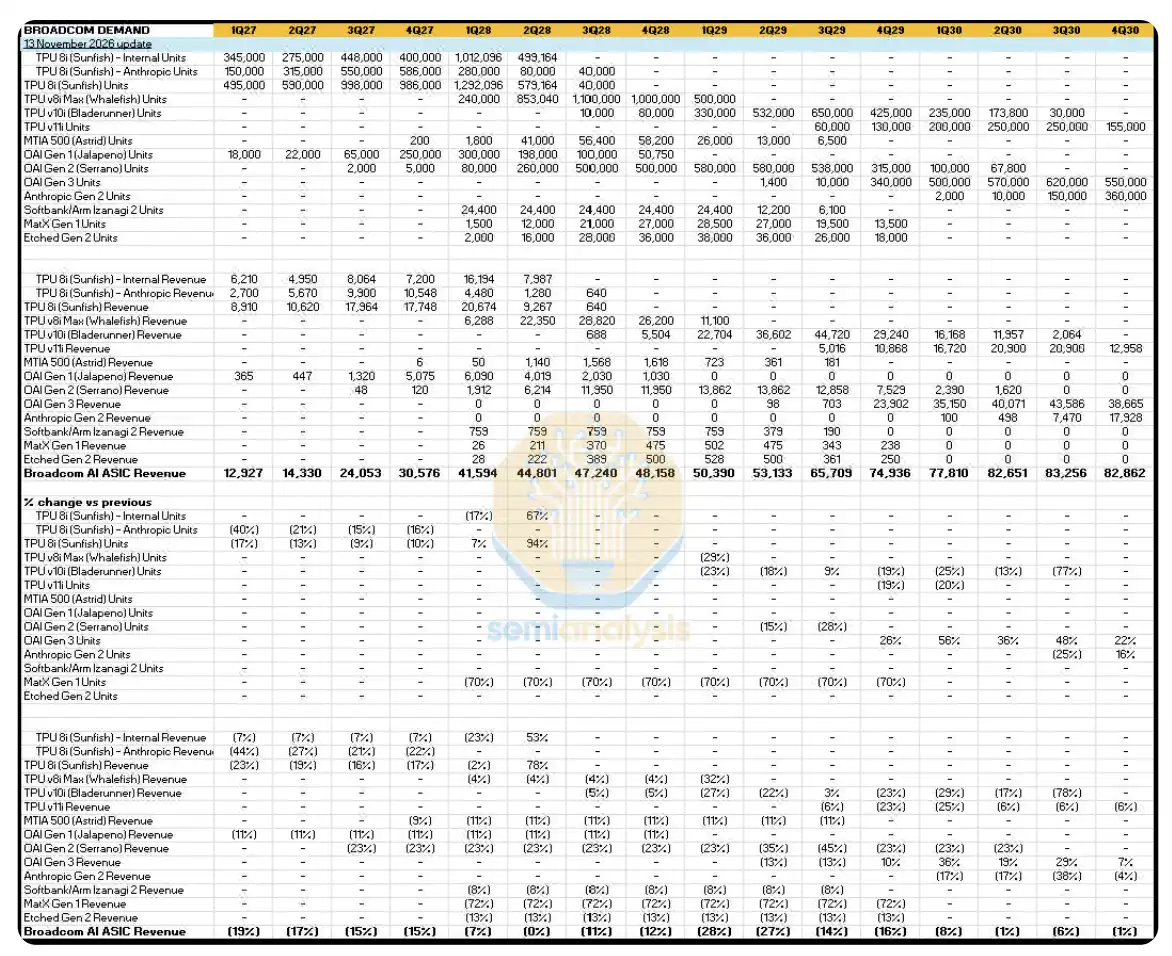
ความต้องการของ Broadcom ตารางอัปเดต ณ วันที่ 13 พฤศจิกายน 2026 แสดงปริมาณการจัดส่ง รายได้ และอัตราการเปลี่ยนแปลงเทียบกับฉบับก่อนหน้าแยกตามไตรมาสของโครงการ TPU, OpenAI, Anthropic เป็นต้น รายการสรุปรวมคือรายได้ AI ASIC ของ Broadcom แหล่งที่มา: SemiAnalysis
MediaTek
เราปรับลดปริมาณการจัดส่งของ MediaTek ลงในสัดส่วนที่มากกว่า
สิ่งนี้สะท้อนทั้งความต้องการของ Anthropic ที่ลดลงจากปัจจัยด้านการระดมทุน และการปรับสมดุลความต้องการ TPU โดยรวมของเราใหม่ เนื่องจากตามแบบจำลองของเรา MediaTek จะรับผิดชอบปริมาณการจัดส่ง TPU ส่วนใหญ่ในอนาคต โดยเฉพาะ TPU ที่ใช้ภายใน Google แม้หลังการปรับลดครั้งนี้ ปริมาณการจัดส่ง TPU ของ MediaTek ในปี 2029 ถึง 2030 ยังคงสูงกว่า Broadcom และพันธมิตรรายอื่นอย่าง AMD/Marvell นอกจากนี้ เนื่องจากลูกค้าของ MediaTek จัดหา HBM เอง การลดราคา HBM จึงไม่มีผลต่อ MediaTek ดังนั้นการเปลี่ยนแปลงของประมาณการรายได้จึงมาจากการปรับลดปริมาณการจัดส่งเพียงอย่างเดียว
การปรับลด主要集中在ผลิตภัณฑ์สองรุ่นของ TPU v9 คือ Humufish และ Triggerfish เราปรับลดปริมาณการจัดส่งตลอดวงจรชีวิตของ Humufish ในปี 2028 และ 2029 รวมกันลง 470,000 ชิ้น ซึ่งสะท้อนถึงความเสี่ยงที่ยังคงมีอยู่ของอัตราผลผลิต EMIB-T เป็นหลัก
เนื่องจากข้อจำกัดด้านการระดมทุนเป็นหนึ่งในสาเหตุหลักของการปรับครั้งนี้ เราเชื่อว่าความสามารถของ Broadcom ในการสนับสนุนทางการเงินสำหรับโครงการก่อสร้างทั้งหมดมีความสำคัญมากกว่าสำหรับ Anthropic ดังนั้นโครงการที่เราปรับลดมากที่สุดคือ TPU v9i (Triggerfish) ซึ่งปรับลดปริมาณการจัดส่งตลอดวงจรชีวิลง 42% Triggerfish ได้รับการออกแบบโดยอ้างอิงความคิดเห็นของ Anthropic และเดิมมีแผนจะเป็น TPU รุ่นแรกของ MediaTek ที่ขายให้กับ Anthropic โดยตรง
อย่างไรก็ตาม เราตระหนักดีว่าอัตรากำไรโดยรวมของ MediaTek ต่ำกว่า Broadcom ดังนั้นต้นทุนระบบโดยรวมจึงต่ำกว่า ซึ่งน่าสนใจเมื่อมีข้อจำกัดด้านเงินทุน สิ่งนี้ต้องให้ Google รับผิดชอบด้านการเงินมากขึ้น หรือให้ Anthropic เพิ่มการชำระเงินล่วงหน้า
สำหรับ TPU v10t (Icefish) ในรุ่นถัดไป เราชะลอความเร็วในการผลิตจำนวนมากในปี 2029 และย้ายปริมาณการจัดส่งส่วนหนึ่งไปยังปี 2030
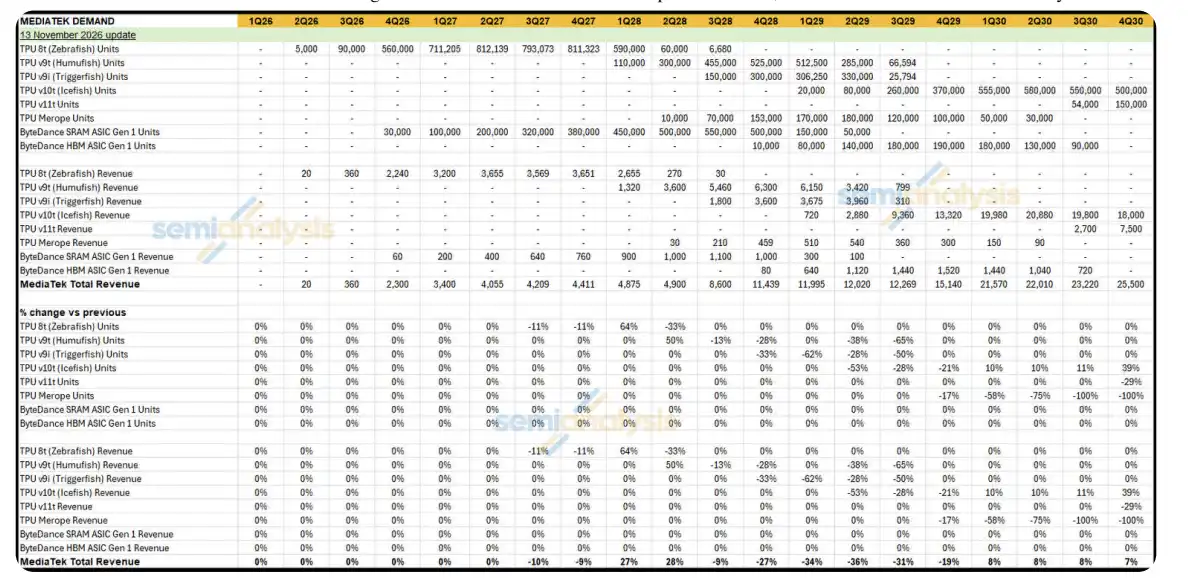
ความต้องการของ MediaTek ตารางอัปเดต ณ วันที่ 13 พฤศจิกายน 2026 แสดงปริมาณการจัดส่ง รายได้ และอัตราการเปลี่ยนแปลงเทียบกับฉบับก่อนหน้าของ TPU แต่ละรุ่นและโครงการ ASIC ของ ByteDance รายไตรมาส รายการสรุปคือรายได้รวมของ MediaTek ที่มา: SemiAnalysis
AMD
ตามเกณฑ์การใช้พลังงานรวม เราปรับลดประมาณการปี 2028, 2029 และ 2030 ของ AMD ลง 23%, 55% และ 57% ตามลำดับ และตามเกณฑ์รายจ่ายปรับลดลง 29%, 35% และ 32% ตามลำดับ ประมาณการใช้พลังงานปี 2027 ใกล้เคียงเดิม ส่วนประมาณการรายจ่ายปรับลดลง 11% แม้ AMD จะเป็นผู้จำหน่ายชิปเชิงพาณิชย์สู่ตลาดเปิดเช่นกัน แต่อัตราการปรับลดรายได้น้อยกว่า NVIDIA เนื่องจาก AMD มีการเปิดรับลูกค้าผู้ให้บริการคลาวด์ขนาดใหญ่และห้องปฏิบัติการ AI ชั้นนำมากกว่า ซึ่งรวมถึง Meta, OpenAI และ Anthropic สำหรับ Meta และ OpenAI การทำธุรกรรมใบสำคัญแสดงสิทธิทำให้การซื้อระบบ AMD แทบจะเป็นทางเลือกที่ไม่ต้องลังเล Anthropic ไม่มีธุรกรรมใบสำคัญแสดงสิทธิ แต่เราเชื่อว่าราคาของ AMD ยังคงเป็นประโยชน์อย่างมากสำหรับ Anthropic ในด้านประสิทธิภาพต่อหน่วยดอลลาร์สำหรับการประมวลผล AMD ดึงดูด Anthropic เป็นอันดับสองรองจาก TPU
นอกจากนี้ ในระยะใกล้ เราจะเลื่อนเวลาการผลิตจำนวนมากของ MI400 ให้เร็วขึ้น เพื่อสะท้อนการเพิ่มกำลังการผลิตที่แข็งแกร่งขึ้นในไตรมาสที่ 4 ปี 2026 เราย้าย MI400 ประมาณ 25,000 ชิ้นและ MI450-MC เวอร์ชันกำหนดเองสำหรับ Meta ประมาณ 30,000 ชิ้นจากไตรมาสที่ 4 ปี 2027 ไปยังไตรมาสที่ 4 ปี 2026
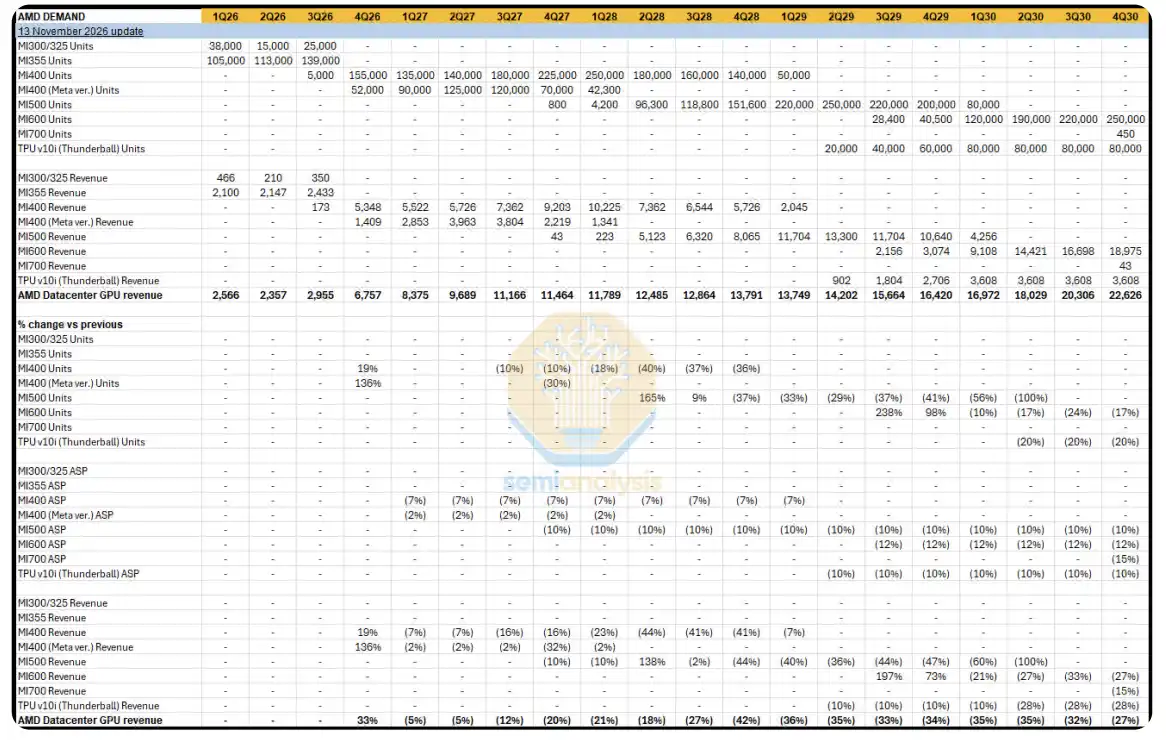
ความต้องการของ AMD ตารางอัปเดต ณ วันที่ 13 พฤศจิกายน 2026 แสดงปริมาณการจัดส่ง รายได้ และอัตราการเปลี่ยนแปลงเทียบกับฉบับก่อนหน้าของแต่ละรุ่นรายไตรมาส พร้อมแสดงอัตราการเปลี่ยนแปลงของราคาขายเฉลี่ย รายการสรุปคือรายได้ GPU ศูนย์ข้อมูลของ AMD ที่มา: SemiAnalysis
Amazon Trainium
เราคงประมาณการการจัดส่ง Trainium ปี 2027 และ 2028 สำหรับปี 2029 เราย้ายปริมาณการจัดส่งที่คาดว่า Trainium4 จะรับผิดชอบไปให้ Trainium5 และขยายวงจรชีวิตของ Trainium5 ออกไปถึงปี 2030 พร้อมทั้งปรับลดขนาดการผลิตจำนวนมากของ Trainium6 เราคงประมาณการการจัดส่ง Trainium ในระยะใกล้ เนื่องจาก Amazon มีโครงการศูนย์ข้อมูลที่อยู่ระหว่างการก่อสร้างและเตรียมการอย่างเพียงพอ ซึ่งส่วนใหญ่ไม่ได้รับผลกระทบ นอกจากนี้ ต้นทุนการผลิตของ Trainium ต่ำกว่ามาก ดังนั้นต้นทุนสำหรับลูกค้าปลายทางจึงต่ำด้วย Amazon ยังยินดีให้เงินอุดหนุนโครงการที่ใช้ Trainium สำหรับลูกค้าคนสำคัญอย่าง Anthropic และ OpenAI ด้วยเหตุผลเชิงกลยุทธ์
การปรับเปลี่ยนอื่นๆ
เราได้เปลี่ยนชื่อ TPU v9i (Whalefish) เป็น TPU v8i Max (Whalefish)
เราได้เปลี่ยนชื่อ "B300 1200W" เป็น "B300 1100W" และอัปเดต Thermal Design Power (TDP) ตามนั้น โดยการใช้พลังงานโดยรวมของชิปยังคงเดิม
ในโมเดล ODM เราได้ปรับลดคำสั่งซื้อตู้ Vera Rubin ของ Microsoft ปี 2027 ลง 200 ตู้
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง