



มอร์แกน สแตนลีย์วิเคราะห์: ชิป AI วิ่งสุดกำลัง ไฟฟ้าจะตามทันหรือไม่? ความต้องการโดยนัยในปี 2027 อยู่ที่ประมาณ 38 กิกะวัตต์
TL;DR
· มอร์แกน สแตนลีย์ ประเมินจาก GPU/ASIC ประมาณ 19 ล้านชิ้น เฉลี่ย 2kW TDP ต่อชิ้น ระบุว่าความต้องการไฟฟ้าโดยนัยของชิปในปี 2027 อยู่ที่ประมาณ 38GW โดย NVIDIA คิดเป็นประมาณ 16GW
· 38GW ไม่ใช่ปริมาณการใช้ไฟฟ้าทั้งหมดของศูนย์ข้อมูลหรือกำลังการผลิตไฟฟ้าที่ก่อสร้างเสร็จแล้ว แต่เป็นการทดสอบแรงกดดันว่าสาธารณูปโภคพื้นฐานจะรองรับการจัดส่งชิปได้หรือไม่
· รายงานคำนวณความต้องการ HBM สำหรับ AI ในปี 2027 อยู่ที่ประมาณ 48.6 พันล้าน Gb และความต้องการ CoWoS อยู่ที่ประมาณ 2.66 ถึง 2.69 ล้านแผ่น แต่สถาปัตยกรรมหน่วยความจำแบบ分层ของ Rubin Ultra ยังไม่ได้รับการสรุปขั้นสุดท้าย
· การจัดส่ง TPU ของ Google คาดว่าจะเพิ่มขึ้นจาก 3.7 ล้านชิ้นในปี 2026 เป็น 7.35 ล้านชิ้นในปี 2027 ซึ่งจะช่วยผลักดันคำสั่งซื้อในห่วงโซ่อุปทานการทดสอบ เช่น KYEC
การตรวจสอบห่วงโซ่อุปทานเอเชียล่าสุดของมอร์แกน สแตนลีย์แปลงการขยายตัวของ AI ให้เป็นตัวเลขไฟฟ้าที่เข้าใจง่ายขึ้น: ตามการประเมิน GPU และ ASIC โดยนัยจาก CoWoS ประมาณ 19 ล้านชิ้นในปี 2027 โดยเฉลี่ย 2kW TDP ต่อชิ้น กำลังการผลิตไฟฟ้าที่สอดคล้องกับชิปชุดนี้อยู่ที่ประมาณ 38GW
ในจำนวนนี้ NVIDIA คิดเป็นประมาณ 16GW, Google ประมาณ 9GW, AMD ประมาณ 7GW, AWS ประมาณ 2GW ขณะที่ Microsoft, Meta และผู้ผลิตรายอื่นๆ คิดเป็นรายละประมาณ 1GW
ต้องเน้นย้ำว่า 38GW ไม่ใช่ปริมาณการใช้ไฟฟ้าทั้งหมดของศูนย์ข้อมูล AI ทั่วโลกในขณะนั้น และไม่ใช่กำลังการผลิตไฟฟ้าที่ได้รับการยืนยันแล้ว ตัวเลขนี้ไม่ได้รวมการใช้ไฟฟ้าของ CPU, เครือข่าย, พื้นที่จัดเก็บข้อมูล, ระบบทำความเย็น และอุปกรณ์เสริมอื่นๆ อย่างครบถ้วน แต่ใกล้เคียงกับการทดสอบแรงกดดันที่ได้มาจากปริมาณการจัดส่งชิป: หากตัวเร่งความเร็ว AI ในปี 2027 ถูกผลิตออกมาตามโมเดลห่วงโซ่อุปทาน โครงสร้างพื้นฐานด้านไฟฟ้าจะสามารถรองรับชิปเหล่านี้ได้พร้อมกันหรือไม่?
นั่นหมายความว่า ข้อจำกัดของการขยายกำลังประมวลผล AI กำลังขยายจาก "GPU จะผลิตออกมาได้หรือไม่" ไปสู่การที่ HBM, CoWoS, การทดสอบ, การส่งมอบแร็ค และการเชื่อมต่อไฟฟ้าจะต้องมาถึงพร้อมกันหรือไม่
การทดสอบแรงกดดัน 38GW ผลักดันคอขวดของ AI ไปสู่ไฟฟ้า
การคำนวณครั้งนี้ของมอร์แกน สแตนลีย์อ้างอิงจากสมมติฐานหลักสองข้อ: ปริมาณชิป GPU และ ASIC ที่สอดคล้องกับ CoWoS ในปี 2027 อยู่ที่ประมาณ 19 ล้านชิ้น และค่า TDP เฉลี่ยต่อชิปคำนวณที่ 2kW จึงได้ความต้องการไฟฟ้าโดยนัยของชิปประมาณ 38GW
ค่า 2kW เป็นสมมติฐานเฉลี่ยที่ใช้เพื่อประมาณการโดยรวม ไม่ได้หมายความว่า GPU และ ASIC ทั้งหมดมีอัตราการใช้พลังงานเท่ากัน 38GW ยังไม่เท่ากับโหลดการทำงานจริงของศูนย์ข้อมูล เนื่องจากชิปไม่ได้ทำงานเต็มกำลังตลอดเวลา และ CPU, เครือข่าย, พื้นที่จัดเก็บข้อมูล และระบบทำความเย็นในเซิร์ฟเวอร์ก็จะเพิ่มการใช้ไฟฟ้าเพิ่มเติม
แต่ตัวเลขนี้ยังคงมีคุณค่าในการอ้างอิง ในช่วงสองปีที่ผ่านมา การอภิปรายเกี่ยวกับห่วงโซ่อุปทาน AI มุ่งเน้นไปที่การจัดสรรการผลิต GPU อุปทาน HBM และกำลังการผลิต CoWoS เป็นหลัก เมื่อการจัดส่งชิปยังคงเพิ่มขึ้นอย่างต่อเนื่อง การเชื่อมต่อโครงข่ายไฟฟ้า การก่อสร้างสถานีไฟฟ้าย่อย การเลือกที่ตั้งศูนย์ข้อมูล และการจัดการข้อตกลงการซื้อไฟฟ้าระยะยาว อาจส่งผลโดยตรงต่อว่าชิปจะสามารถเปลี่ยนเป็นกำลังประมวลผลที่ใช้งานได้จริงหรือไม่
การจัดส่งชิปเป็นเพียงขั้นตอนแรกเท่านั้น หลังจาก GPU หรือ ASIC เข้าสู่ศูนย์ข้อมูลแล้ว ยังจำเป็นต้องมีเซิร์ฟเวอร์ ชั้นวาง เครือข่าย ระบบระบายความร้อน ไฟฟ้า และระบบปฏิบัติการและบำรุงรักษามารองรับ หากการก่อสร้างโครงสร้างพื้นฐานช้ากว่าการจัดส่งชิป ตลาดอาจเกิดความไม่สอดคล้องกันในลักษณะที่ "ชิปมาถึงแล้ว แต่ห้องเครื่องและไฟฟ้ายังไม่พร้อม"
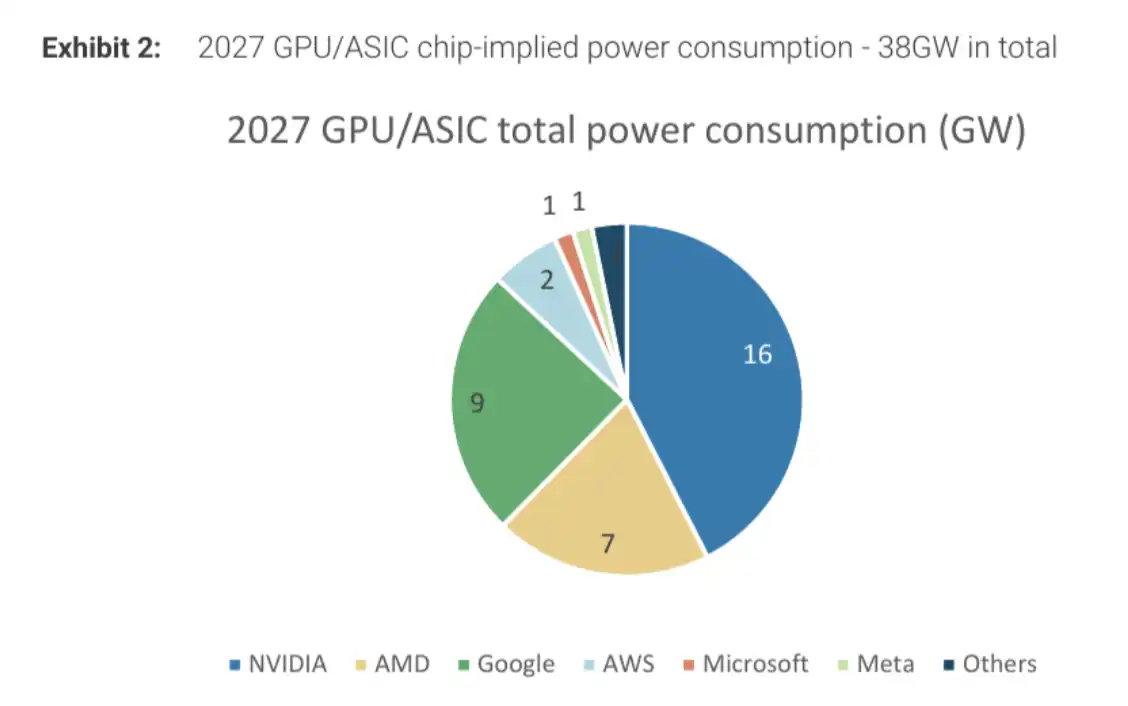
ความต้องการไฟฟ้าโดยนัยของชิป GPU/ASIC ในปี 2027 อยู่ที่ประมาณ 38GW โดย NVIDIA 16GW, Google 9GW, AMD 7GW
สำหรับ NVIDIA ความต้องการโดยนัย 16GW ยังอธิบายได้ว่าทำไมบริษัทจึงเพิ่มความหนาแน่นของ GPU ต่อชั้นวางอย่างต่อเนื่อง รายงานระบุว่า NVIDIA มีเป้าหมายระยะยาวในการเชื่อมต่อ GPU มากขึ้นผ่านสถาปัตยกรรม scale-up เพื่อเพิ่มความสามารถในการคำนวณและประสิทธิภาพในระดับชั้นวาง
แต่โซลูชัน Kyber ของแร็ค Rubin Ultra รุ่นแรกยังคงเผชิญกับความท้าทายด้าน PCB และการระบายความร้อน อาจยังคงใช้การออกแบบ Oberon NVL72 จากนั้นขยายผ่านการเชื่อมต่อ CPO หรือ NPO ไปจนถึงขนาด NVL576 การเพิ่มความหนาแน่นของชั้นวางจะไม่ขจัดความต้องการไฟฟ้า แต่กลับจะรวมแรงกดดันด้านการจ่ายไฟ การระบายความร้อน และการเชื่อมต่อเข้ากับการออกแบบศูนย์ข้อมูลที่มีสเปกสูงขึ้น
HBM และ CoWoS ขยายตัวพร้อมกัน สเปก Rubin Ultra ยังคงต้องรอการกำหนด
นอกเหนือจากไฟฟ้าแล้ว HBM และการบรรจุขั้นสูงยังคงเป็นข้อจำกัดหลักของการขยายตัวของชิป AI ในช่วงปี 2027
ตามแบบจำลองห่วงโซ่อุปทานของ Morgan Stanley ความต้องการ HBM ที่สอดคล้องกับชิป AI ในปี 2027 อยู่ที่ประมาณ 48.618 พันล้าน Gb ปริมาณการกำหนดค่า CoWoS ที่ระบุใน Exhibit 3 อยู่ที่ประมาณ 2.664 ล้านแผ่นเวเฟอร์ ในขณะที่ความต้องการ CoWoS ทั่วโลกที่ให้ไว้ใน Exhibit 5 อยู่ที่ประมาณ 2.694 ล้านแผ่น ซึ่งทั้งสองตัวเลขแตกต่างกันเล็กน้อยเนื่องจากขอบเขตการนับที่ต่างกัน
รายงานยังคำนวณด้วยว่าในปี 2027 ขนาดตลาดรายได้จากเวเฟอร์ที่สอดคล้องกับชิปประมวลผล AI จะมีมูลค่าอย่างน้อย 58.8 พันล้านดอลลาร์สหรัฐ NVIDIA ยังคงเป็นผู้ที่มีความต้องการ CoWoS มากที่สุด คาดว่าจะอยู่ที่ประมาณ 1.222 ล้านแผ่น ส่วน AMD และ Broadcom อยู่ที่ประมาณ 530,000 แผ่นและ 484,000 แผ่นตามลำดับ
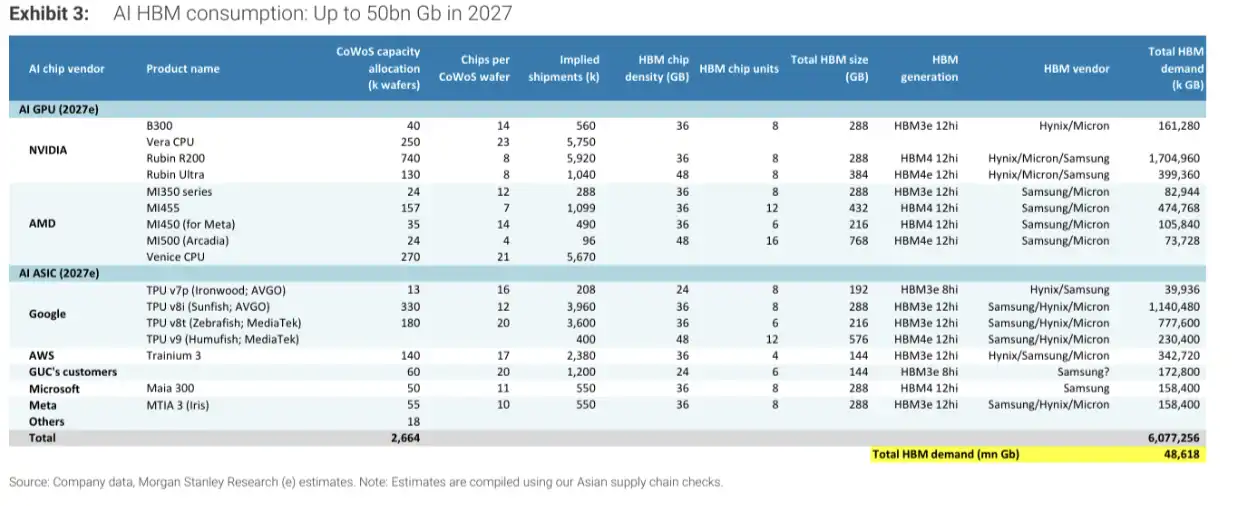
ความต้องการ AI HBM ในปี 2027 อยู่ที่ประมาณ 48.6 พันล้านGb รวมถึงการกำหนดค่า CoWoS และความต้องการ HBM ของ GPU และ ASIC ประเภทต่างๆ
การคาดการณ์ความต้องการยังคงมีตัวแปรสำคัญหนึ่งประการ: การกำหนดค่า HBM ของ Rubin Ultra ยังไม่ได้รับการสรุปขั้นสุดท้าย
การตรวจสอบห่วงโซ่อุปทานแสดงให้เห็นว่า Rubin Ultra อาจใช้สเปกแบบแบ่งระดับ โดยรุ่นสเปกสูงใช้ HBM4e 8Hi ส่วนรุ่นสเปกต่ำอาจใช้ HBM4 12Hi หรือ 8Hi มอร์แกน สแตนลีย์คาดว่า NVIDIA อาจตัดสินใจขั้นสุดท้ายก่อนสิ้นไตรมาสที่สามของปี 2026
การปรับเปลี่ยนนี้สะท้อนแรงกดดันสามด้านหลัก ได้แก่ การขาดแคลนกำลังการผลิต HBM ต้นทุนหน่วยความจำที่เพิ่มขึ้น และความต้องการความจุและแบนด์วิธที่แตกต่างกันของปริมาณงาน AI ประเภทต่างๆ รายงานระบุว่าการลดการกำหนดค่า HBM อาจส่งผลกระทบต่องานถอดรหัส (decode) มากกว่างานเติมข้อมูลล่วงหน้า (prefill) โดยเฉพาะในโมเดลขนาดใหญ่ที่มีบริบทยาว
ควรสังเกตว่า Exhibit 3 ยังคงคำนวณตามการกำหนดค่า Rubin Ultra ที่ใช้ HBM4e 12Hi ความจุรวมต่อชิป 384GB ดังนั้น ความต้องการ HBM ที่ 48.6 พันล้านGb ยังไม่ได้สะท้อนแผนการลดสเปกแบบแบ่งระดับอย่างเต็มที่ หากการกำหนดค่าขั้นสุดท้ายถูกปรับลด ปริมาณ HBM ต่อชิปอาจลดลง แต่ต้นทุนหน่วยความจำที่ต่ำลงอาจผลักดันให้การจัดส่งชิปเพิ่มขึ้น ซึ่งช่วยชดเชยผลกระทบจากการลดปริมาณการใช้ต่อชิปบางส่วน
ข้อมูลสาธารณะของ Micron ระบุว่า HBM4 ของบริษัทเข้าสู่ขั้นตอนการจัดส่งปริมาณมากแล้ว ส่วน HBM4E คาดว่าจะเริ่มผลิตเชิงพาณิชย์ในปี 2027 ฝั่งอุปทานกำลังผลักดันผลิตภัณฑ์ใหม่ แต่การกำหนดค่าขั้นสุดท้ายที่ Rubin Ultra จะใช้ ยังคงขึ้นอยู่กับการชั่งน้ำหนัก综合考虑ของ NVIDIA ระหว่างประสิทธิภาพ ต้นทุน และความมั่นคงของอุปทาน
จังหวะการจัดส่งของซีรีส์ Rubin ยังคงเร่งตัว รายงานคาดว่าในปี 2027 ยอดจัดส่งรวมของ Rubin และ Rubin Ultra จะใกล้เคียง 7 ล้านชิป โดย Rubin อยู่ที่ประมาณ 5.92 ล้านชิป และ Rubin Ultra อยู่ที่ประมาณ 1.04 ล้านชิป ยอดจัดส่งแร็ค Rubin NVL72 อาจอยู่ที่ประมาณ 90,000 เครื่อง
Rubin คาดว่าจะเริ่ม ramping ขึ้นตั้งแต่ไตรมาสที่สามของปี 2026 และเริ่มจัดส่งแร็คในไตรมาสที่สี่ รายงานยังระบุอีกว่า "สต็อกสินค้า" ของ Blackwell ที่ตลาดกังวลก่อนหน้านี้ ส่วนใหญ่เป็นสต็อกกันชนในห่วงโซ่อุปทาน และคาดว่าจะถูกดูดซับจนหมดภายในปี 2026
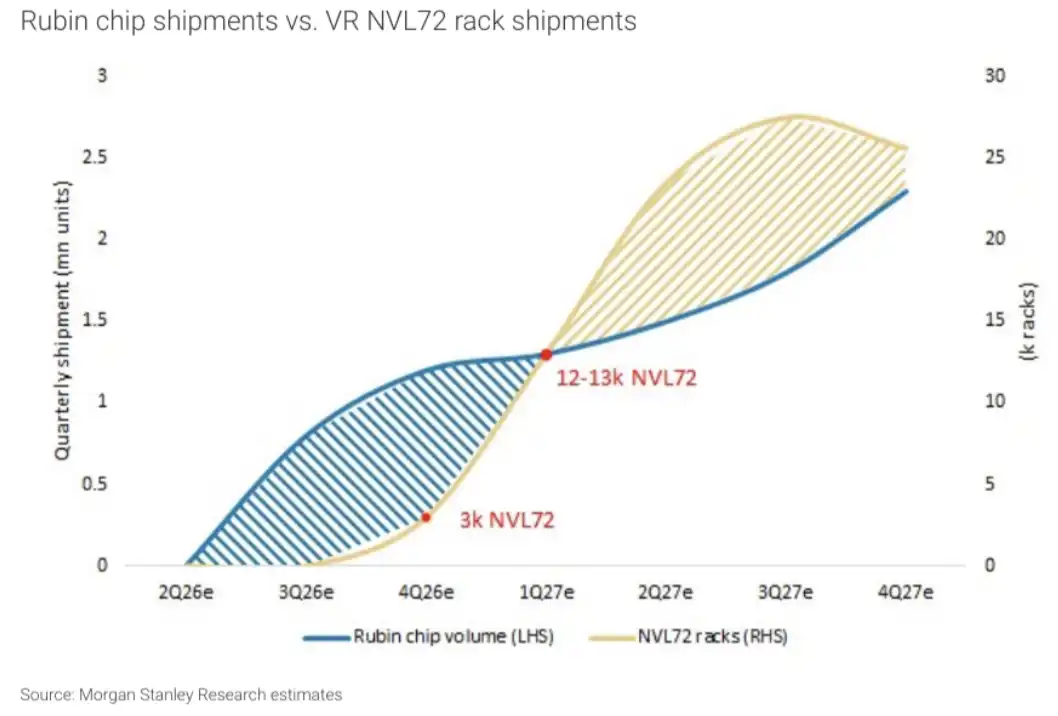
การคาดการณ์การจัดส่งชิป Rubin และ Rubin Ultra รวมถึงการจัดส่งแร็ค Rubin NVL72
ซึ่งหมายความว่า ตั้งแต่ช่วงครึ่งหลังของปี 2026 ถึงปี 2027 ห่วงโซ่อุปทานของ NVIDIA จะต้องจัดการกับการระบายสต็อก Blackwell การเร่งกำลังการผลิต Rubin การเปลี่ยนสเปก HBM และการส่งมอบแร็คไปพร้อมกัน หากจุดใดจุดหนึ่งชะลอตัวลง อาจส่งผลกระทบต่อขนาดกำลังการประมวลผลที่ส่งมอบได้จริง
TPU ของ Google เพิ่มเป็น 7.35 ล้านหน่วย คำสั่งซื้อส่งต่อไปยังห่วงโซ่การทดสอบ
นอกเหนือจาก NVIDIA แล้ว TPU ของ Google เป็นอีกหนึ่งแนวการเติบโตที่ชัดเจนในรายงานฉบับนี้
ตามการคาดการณ์ของ Morgan Stanley ปริมาณการจัดส่ง TPU ของ Google จะเพิ่มขึ้นจาก 3.7 ล้านหน่วยในปี 2026 เป็น 7.35 ล้านหน่วยในปี 2027 โดยในจำนวนนี้ v8i ที่มี Broadcom ร่วมพัฒนาคาดว่าจะจัดส่ง 4 ล้านหน่วย v8t ที่มี MediaTek ร่วมพัฒนาคาดว่าจะจัดส่ง 3 ล้านหน่วย v9 คาดว่าอยู่ที่ประมาณ 150,000 หน่วย และส่วนที่เหลืออีกประมาณ 200,000 หน่วยมาจาก v7
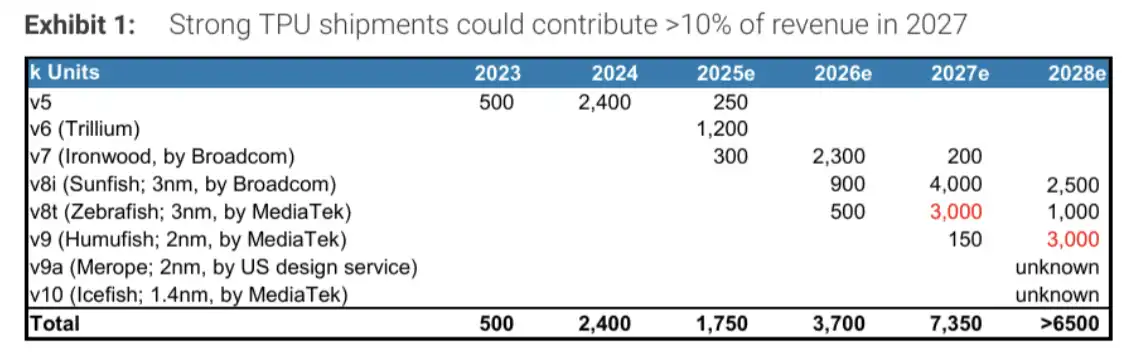
การคาดการณ์การจัดส่ง TPU แต่ละรุ่นของ Google และผลงานที่อาจเกิดขึ้นต่อรายได้ของ KYEC
การเพิ่มปริมาณ TPU จะส่งต่อคำสั่งซื้อไปยังการออกแบบชิป การผลิตเวเฟอร์ การแพ็กเกจจิ้งขั้นสูง และขั้นตอนการทดสอบ รายงานคาดว่าธุรกิจที่เกี่ยวข้องกับ TPU อาจคิดเป็น 7% ถึง 8% ของรายได้ KYEC ในปี 2026 และสัดส่วนในปี 2027 จะสูงกว่า 10% เล็กน้อย ซึ่งรวมถึงการทดสอบขั้นสุดท้ายและรายได้จากการทดสอบเวเฟอร์บางส่วน
หากรวมธุรกิจ CPU ของ Google, TPU, การทดสอบขั้นสุดท้าย และการทดสอบเวเฟอร์บางส่วนทั้งหมดเข้าด้วยกัน ความต้องการที่เกี่ยวข้องกับ Google คาดว่าจะคิดเป็น 10% ถึง 15% ของรายได้ KYEC ในปี 2027 ซึ่งสูงกว่า 8% ถึง 10% ในปี 2026
ความต้องการด้านการทดสอบก็มีความซับซ้อนมากขึ้นเช่นกัน รายงานระบุว่า TPU ขนาด 3nm ที่มี MediaTek ร่วมพัฒนาคาดว่าจะใช้การทดสอบแบบ Burn-in เพื่อเพิ่มความเสถียรของประสิทธิภาพและความน่าเชื่อถือของชิป AI โครงการ CPU ของ Google ก็จำเป็นต้องใช้การทดสอบแบบ Burn-in และการทดสอบระดับระบบเช่นกัน
กระบวนการทดสอบที่ซับซ้อนขึ้นและรอบเวลาการทดสอบที่ยาวนานขึ้นจะเพิ่มคำสั่งซื้อให้กับโรงงานทดสอบ แต่การที่กำลังการผลิตทดสอบจะกลายเป็นคอขวดหรือไม่นั้น ยังขึ้นอยู่กับการเปลี่ยนแปลงร่วมกันของเวลาทดสอบต่อชิปและปริมาณการจัดส่งโดยรวม รายงานยังชี้ให้เห็นว่า การลดเวลาทดสอบบางส่วนอาจช่วยบรรเทาแรงกดดันด้านกำลังการผลิตในระยะสั้น ดังนั้นจึงไม่สามารถสรุปง่ายๆ ว่าความต้องการทดสอบที่เพิ่มขึ้นจะเท่ากับการขาดแคลนกำลังการผลิตอย่างแน่นอน
38GW ไม่ใช่จุดสิ้นสุดของความต้องการ แต่คือการทดสอบขีดความสามารถในการส่งมอบ
สิ่งที่ควรให้ความสนใจมากที่สุดในการตรวจสอบห่วงโซ่อุปทานนี้ ไม่ใช่เพียงการให้ตัวเลขการจัดส่งชิป AI เพิ่มขึ้นอีกชุดหนึ่ง แต่คือการนำข้อจำกัดหลักของการขยายกำลังการผลิตในปี 2027 มาอยู่ในโมเดลเดียวกัน: NVIDIA ยังคงเพิ่มความหนาแน่นของ GPU ต่อไป Google TPU ขยายปริมาณอย่างรวดเร็ว ความต้องการ HBM และ CoWoS เพิ่มขึ้นพร้อมกัน และความต้องการไฟฟ้าโดยนัยของชิปถูกผลักดันขึ้นไปถึง 38GW
ตัวเลขเหล่านี้ยังคงต้องพึ่งพาข้อสมมติหลายประการ แผนการ HBM แบบหลายชั้นของ Rubin Ultra ยังไม่ได้รับการสรุปขั้นสุดท้าย ผลกระทบของการลดการกำหนดค่าหน่วยความจำต่อประสิทธิภาพการถอดรหัสบริบทระยะยาวยังต้องได้รับการตรวจสอบ กำลังการผลิต CoWoS และ HBM ต้องขยายตามแผน และการก่อสร้างเซิร์ฟเวอร์ แร็ค ไฟฟ้า และระบบระบายความร้อนก็ต้องตามให้ทันการจัดส่งชิป
แนวทางการเชื่อมต่อระหว่างกันก็อาจสร้างความแตกต่างได้เช่นกัน รายงานระบุว่า เนื่องจากข้อจำกัดของกระบวนการผลิตในประเทศ ความเร็ว SerDes ของผู้ผลิต GPU AI ของจีนอาจยังคงอยู่ที่ 100Gb/s ต่อช่องสัญญาณ ดังนั้นสถาปัตยกรรมซูเปอร์โหนดของพวกเขาจึงเริ่มนำการเชื่อมต่อแบบ NPO มาใช้มากขึ้น ในขณะที่ NVIDIA ให้ความสำคัญกับ CPO ในระยะยาวมากกว่า เส้นทางที่แตกต่างกันจะส่งผลต่อการออกแบบซูเปอร์โหนด ต้นทุนการติดตั้ง และประสิทธิภาพของระบบ
ดังนั้น 38GW จึงไม่ใช่การคาดการณ์ที่แม่นยำของการใช้ไฟฟ้าจริงในปี 2027 แต่เป็นการทดสอบความเครียดที่ได้มาจากฝั่งการจัดส่งชิป มันแสดงให้เห็นว่าความต้องการชิป AI ยังคงแข็งแกร่ง และยังเตือนตลาดว่า สิ่งที่กำหนดว่าพลังการประมวลผล AI จะเกิดขึ้นจริงได้หรือไม่ อาจไม่ใช่แค่ตารางการผลิต GPU อีกต่อไป แต่คือ HBM, CoWoS, การทดสอบ, แร็ค และไฟฟ้า ที่ต้องมาถึงพร้อมกันในเวลาเดียวกัน
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia






