Kimi K3 นำเสนอประเด็นใหม่: ยิ่งโมเดลมีราคาถูก ความต้องการชิปกลับยิ่งเพิ่มขึ้น?
หัวข้อต้นฉบับ: 《โทเค็นมากขึ้น ชิปมากขึ้น! Kimi K3 สะท้อน "ความขัดแย้งของเจวอนส์" ประสิทธิภาพที่เพิ่มขึ้นกลับทำให้การใช้ทรัพยากรเพิ่มขึ้น》
ผู้เขียนต้นฉบับ: Zhao Ying, Wall Street Insight
Kimi K3 นำนักลงทุน AI กลับมาสู่คำถามหลัก: โมเดลที่ถูกกว่าและมีประสิทธิภาพมากขึ้น หมายถึงความต้องการชิปและหน่วยความจำลดลงหรือไม่? คำตอบจาก Citi และ Bank of America Securities ต่างก็มีแนวโน้มไปในทางปฏิเสธ การปรับปรุงประสิทธิภาพอาจปลดปล่อยการใช้งานที่มากขึ้น ซึ่งจะผลักดันให้การใช้ทรัพยากรโดยรวมเพิ่มขึ้น
ตามรายงานของ Zhui Feng Trading Desk, Kimi K3 ที่เปิดตัวโดย Moonshot AI มีพารามิเตอร์ 2.8 ล้านล้าน รองรับบริบทหน้าต่าง 1 ล้านโทเค็นและงานเอเจนต์ระยะยาว Peter Lee นักวิเคราะห์เซมิคอนดักเตอร์ของ Citi เชื่อว่า แม้ Kimi K3 จะถูกใช้งานอย่างแพร่หลาย ความต้องการหน่วยความจำทั่วไป เช่น DDR5 ของเซิร์ฟเวอร์และ eSSD ก็ยังคงเพิ่มขึ้น
Vivek Arya นักวิเคราะห์เซมิคอนดักเตอร์ของ Bank of America Securities ยังชี้ในงานวิจัยเมื่อวันที่ 17 กรกฎาคมว่า ห้องปฏิบัติการ AI ชั้นนำของสหรัฐฯ มีแนวโน้มที่จะเพิ่มการลงทุนด้านพลังการคำนวณมากกว่าที่จะลดลง หากโมเดลโอเพนซอร์สของจีนยังคงเข้าใกล้ ผู้นำอย่าง OpenAI, Anthropic และ Google จะต้องใช้ขนาดการฝึกที่ใหญ่ขึ้น การอนุมานที่หนักขึ้น และการพัฒนาผลิตภัณฑ์ที่เร็วขึ้นเพื่อรักษาความแตกต่าง
นั่นหมายความว่าตรรกะการกำหนดราคาของตลาดสำหรับ Kimi K3 ไม่สามารถมองแค่ต้นทุนการอนุมานต่อครั้งที่ลดลงเท่านั้น สิ่งที่สำคัญกว่าคือ โมเดลราคาถูกจะนำไปสู่การเรียกใช้ที่มากขึ้น ห่วงโซ่ภารกิจที่ยาวขึ้น และการสร้างโทเค็นที่มากขึ้นหรือไม่ หากคำตอบคือใช่ GPU, HBM, DDR5, eSSD, เครือข่ายความเร็วสูง และระบบอนุมานอาจยังคงได้รับประโยชน์ต่อไป
ราคาถูกและประสิทธิภาพสูง กระตุ้น "ความขัดแย้งของเจวอนส์"
Citi มองว่า Kimi K3 เป็นกรณีตัวอย่างที่เป็นไปได้ของ "ความขัดแย้งของเจวอนส์" ในห่วงโซ่อุตสาหกรรม AI แก่นของความขัดแย้งนี้คือ เมื่อประสิทธิภาพทางเทคโนโลยีเพิ่มขึ้นและลดต้นทุนต่อหน่วยการใช้งาน การใช้งานอาจเพิ่มขึ้นอย่างมาก ส่งผลให้การใช้ทรัพยากรโดยรวมไม่ลดลงแต่กลับเพิ่มขึ้น
ความน่าสนใจของ Kimi K3 มาจากการผสมผสานระหว่างต้นทุนต่ำและประสิทธิภาพสูง ราคาที่เปิดเผยต่อสาธารณะแสดงให้เห็นว่าราคาป้อนข้อมูลที่แคชฮิตอยู่ที่ 0.3 ดอลลาร์ต่อล้านโทเค็น และราคาผลลัพธ์อยู่ที่ 15 ดอลลาร์ต่อล้านโทเค็น น้ำหนักเต็มของโมเดลมีกำหนดเปิดเผยในวันที่ 27 กรกฎาคม โดยมีเป้าหมายเพื่อรองรับงานเอเจนต์ระยะยาว
การประเมินของ Citi คือ การลดราคาโมเดลจะไม่ลดความต้องการฮาร์ดแวร์โดยอัตโนมัติ ในทางตรงกันข้าม ต้นทุนต่ำอาจเพิ่มความตั้งใจของนักพัฒนาและองค์กรในการเรียกใช้โมเดล ผลักดันการปรับใช้เอเจนต์ AI มากขึ้น งานของเอเจนต์ไม่ใช่การถามตอบครั้งเดียว แต่เป็นการสร้าง อ่าน และประมวลผลโทเค็นอย่างต่อเนื่องในภารกิจที่ต่อเนื่อง การเพิ่มขึ้นของจำนวนการเรียกใช้และความยาวของภารกิจจะเปลี่ยนการลดต้นทุนต่อหน่วยกลับมาเป็นการใช้ทรัพยากรโดยรวม
ดังนั้น ผลกระทบของ Kimi K3 ต่อห่วงโซ่เซมิคอนดักเตอร์ไม่ได้เน้นที่ "การเรียกใช้ครั้งเดียวถูกกว่าหรือไม่" แต่เน้นที่ "ปริมาณโทเค็นรวมเพิ่มขึ้นหรือไม่" นี่คือเหตุผลที่ซิตี้มองในแง่ดีต่อความต้องการ DDR5 สำหรับเซิร์ฟเวอร์และ eSSD
การอนุมานบริบทยาว ส่งแรงกดดันไปยังหน่วยความจำ
Kimi K3 ใช้เทคโนโลยีหลักสามประการ: Kimi Delta Attention, Attention Residuals และ Stable LatentMoE Kimi Delta Attention ใช้เพื่อลดต้นทุนของหน้าต่างบริบท 1 ล้านโทเค็น Attention Residuals ใช้เพื่อดึงข้อมูลการแสดงผลแบบเลือกสรรระหว่างความลึกต่างๆ ของโมเดล ส่วน Stable LatentMoE ช่วยเพิ่มระดับความเบาบาง โดยแต่ละโทเค็นจะเปิดใช้งานผู้เชี่ยวชาญเพียง 16 คนจากทั้งหมด 896 คน
เอกสารทางเทคนิคของ Moonshot AI ระบุว่า สถาปัตยกรรมนี้ทำให้ประสิทธิภาพการขยายของ Kimi K3 สูงกว่า K2 ถึง 2.5 เท่า ความสามารถในการเบาบางสูงและบริบทยาวเป็นพื้นฐานสำคัญในการลดต้นทุนการดำเนินงาน
แต่ซิตี้เน้นย้ำว่า นี่ไม่ได้หมายความว่าแรงกดดันด้านทรัพยากรในการอนุมานจะหายไป Kimi K3 ยังคงไม่ใช่โซลูชันการปรับใช้แบบเบา การทำงานต้องใช้คลัสเตอร์หลายโหนด โดยโหนดซูเปอร์มีการกำหนดค่า GPU มากกว่า 64 ตัว ที่สำคัญกว่านั้น งานบริบทยาวและงานเอเจนต์จะเพิ่มการใช้งาน KV Cache ซึ่งจะเพิ่มภาระหน่วยความจำในการอนุมาน
ความต้องการ KV Cache เชื่อมโยงโดยตรงกับ DDR5 สำหรับเซิร์ฟเวอร์และ eSSD DDR5 รับหน้าที่存取ข้อมูลความถี่สูง ส่วน eSSD ได้ประโยชน์จากความต้องการแคชและการจัดเก็บข้อมูลที่มากขึ้น สำหรับผู้ผลิตหน่วยความจำ ตัวแปรสำคัญไม่ใช่การที่โมเดลเดี่ยวประหยัดพลังคำนวณหรือไม่ แต่คือจำนวนครั้งที่โมเดลถูกเรียกใช้หลังจากราคาถูกลง จำนวนโทเค็นที่สร้างต่อการเรียกใช้ และความยาวของห่วงโซ่งานเอเจนต์
โมเดลใกล้เคียงกัน กลับเพิ่มเกณฑ์พลังคำนวณ
ข้อสรุปของ Bank of America Securities สอดคล้องกับซิตี้ แต่เน้นไปที่ GPU และโครงสร้างพื้นฐาน AI มากกว่า Vivek Arya เชื่อว่า โมเดลโอเพนซอร์สจีนที่แข็งแกร่งขึ้นอาจไม่ทำให้ยักษ์ใหญ่ AI ของสหรัฐฯ ลดการลงทุนด้านพลังคำนวณ ในทางกลับกัน การที่ช่องว่างของโมเดลแคบลงจะเพิ่มต้นทุนในการรักษาความเป็นผู้นำ
Bank of America Securities ชี้ว่า หากโมเดลโอเพนซอร์สยังคงเข้าใกล้ OpenAI, Anthropic และ Google จะต้องพึ่งพาการฝึกอบรมขนาดใหญ่ขึ้น การเรียนรู้แบบเสริมกำลังและวงจรข้อมูลสังเคราะห์มากขึ้น การอนุมานในเวลาทดสอบที่หนักขึ้น และจังหวะการเปิดตัวผลิตภัณฑ์ที่เร็วขึ้น เพื่อรักษาความแตกต่าง
ตรรกะนี้ไม่ได้ขึ้นอยู่กับว่าโมเดลไหนนำในระยะสั้น อันดับโมเดลใหญ่ๆ อาจเปลี่ยนเร็ว แต่สิ่งที่องค์กรซื้อจริงๆ คือความเสถียร ความหน่วงต่ำ AI ที่มีความพร้อมใช้งานสูง และต้นทุน 'ต่อหน่วยผลผลิตที่มีประสิทธิภาพ' ที่ต่ำกว่า เมื่อความสามารถของโมเดลเริ่มเหมือนกัน แรงกดดันในการแข่งขันจะส่งต่อไปยังโครงสร้างพื้นฐานระดับล่าง รวมถึง GPU, HBM, เครือข่ายความเร็วสูง และระบบอนุมานผล
ดังนั้น ธนาคาร Merrill Lynch Securities มองว่า การเกิดขึ้นของโมเดลอย่าง Kimi K3 ไม่ควรถูกตีความง่ายๆ ว่า 'โมเดลมีประสิทธิภาพมากขึ้น ใช้ชิปน้อยลง' เส้นทางที่เป็นจริงมากกว่าคือ การแข่งขันของโมเดลทวีความรุนแรงขึ้น ผู้นำจะเพิ่มกำลังคำนวณต่อไปเพื่อรักษาระยะห่าง
สถาปัตยกรรม MoE เปลี่ยนคอขวด หน่วยความจำและการเชื่อมต่อระหว่างกันสำคัญขึ้น
Kimi K3 ใช้สถาปัตยกรรม MoE หมายความว่าจำนวนพารามิเตอร์ทั้งหมดและพารามิเตอร์ที่เปิดใช้งานจริงในการอนุมานแต่ละครั้งสามารถแยกออกจากกันได้ การเปลี่ยนแปลงนี้ลดแรงกดดันด้านการคำนวณบางส่วน แต่ก็ทำให้คอขวดของโครงสร้างพื้นฐานเปลี่ยนจากพลังคำนวณเพียงอย่างเดียว ไปสู่การเข้าถึงหน่วยความจำ การกำหนดเส้นทางผู้เชี่ยวชาญ ความหน่วงในการตอบสนอง และความสามารถในการเชื่อมต่อระหว่างกัน
ธนาคาร Merrill Lynch Securities เน้นย้ำว่า การอนุมานแบบ MoE ต้องการให้ระบบขนส่งข้อมูล จัดการโมดูลผู้เชี่ยวชาญ และเชื่อมต่อคลัสเตอร์คำนวณขนาดใหญ่ได้อย่างมีประสิทธิภาพมากขึ้น NVIDIA เสนอว่าการอนุมาน MoE สมัยใหม่ต้องการโดเมน GPU ที่ใหญ่ขึ้น การคำนวณของพวกเขาแสดงให้เห็นว่า GB300 NVL72 มีประสิทธิภาพต่อวัตต์สูงสุดถึง 25 เท่าของแพลตฟอร์ม Hopper ในโมเดลโอเพนซอร์สชั้นนำ
การทดสอบของ CoreWeave รอบๆ Kimi K2.6 ก็แสดงให้เห็นว่า แม้โมเดล MoE โอเพนซอร์สจะเปิดใช้งานเพียงบางพารามิเตอร์ในแต่ละครั้ง แต่ถ้าต้องการรักษาความเป็นผู้นำด้านความเร็วและความคุ้มค่า ก็ยังคงต้องใช้โครงสร้างพื้นฐาน NVIDIA GB300/GB200 NVL72 ที่ได้รับการปรับแต่ง
นั่นหมายความว่า น้ำหนักของโมเดลอาจค่อยๆ กลายเป็นสินค้าโภคภัณฑ์ แต่ GPU, หน่วยความจำแบนด์วิดท์สูง, การเชื่อมต่อเครือข่าย และระบบอนุมานผลที่จำเป็นในการรันโมเดล จะไม่สูญเสียคุณค่า ในทางกลับกัน เมื่อปริมาณการเรียกใช้โมเดลขยายตัว จุดเหล่านี้อาจกลายเป็นพื้นที่ที่มีการแข่งขันเข้มข้นขึ้น
การใช้ Token ยังคงขยายตัว ด้านอุปสงค์ยังไม่ถึงจุดสูงสุด
ธนาคาร Merrill Lynch Securities ยังอ้างอิงข้อมูลจาก OpenRouter ว่าปริมาณการเรียกใช้โมเดลยังคงเพิ่มขึ้นอย่างรวดเร็ว ในฐานะแพลตฟอร์ม API บุคคลที่สามที่เชื่อมต่อห้องปฏิบัติการโมเดลหลายแห่ง ปริมาณการใช้ token บน OpenRouter เติบโตอย่างต่อเนื่อง โดยปริมาณการใช้ token ของโมเดลจากห้องปฏิบัติการ AI ของจีนนั้นเกินกว่าของโมเดลจากห้องปฏิบัติการที่ไม่ใช่จีนแล้ว
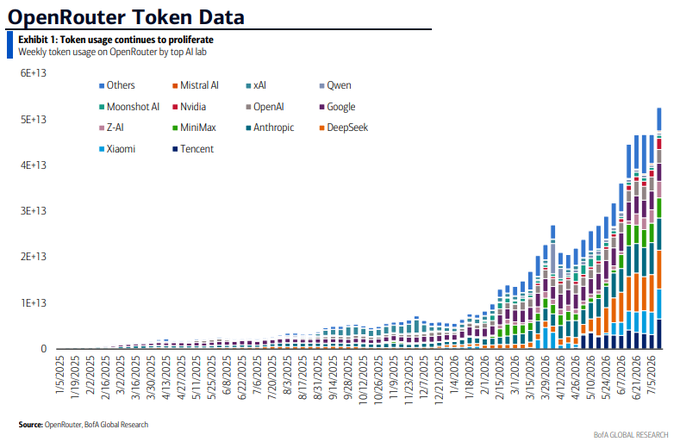
ข้อมูลนี้ไม่สามารถบ่งชี้โดยตรงถึงสถานการณ์ขององค์กรและผู้บริโภคทั้งหมด แต่ก็แสดงให้เห็นว่านักพัฒนาในระบบนิเวศของโมเดลโอเพนซอร์สกำลังเปลี่ยนแปลงทางเลือกของตน ราคาโมเดลที่ลดลงและความสามารถที่เพิ่มขึ้นอาจผลักดันให้ปริมาณการเรียกใช้ขยายตัวต่อไป แทนที่จะถูกหักล้างด้วยประสิทธิภาพที่เพิ่มขึ้นของโมเดลเดี่ยว
การชำระเงินขององค์กรก็เพิ่มขึ้นเช่นกัน ข้อมูลจาก Ramp แสดงให้เห็นว่า ณ เดือนมิถุนายน 2026 ประมาณ 55% ขององค์กรในสหรัฐฯ ได้สมัครสมาชิก AI โมเดล แพลตฟอร์ม หรือเครื่องมือแบบชำระเงิน ซึ่งสูงกว่าค่าประมาณ 21% จากการสำรวจ BTOS ของสำนักงานสำมะโนประชากรสหรัฐฯ เมื่อแยกตามโมเดล อัตราการนำไปใช้ขององค์กรสำหรับ Anthropic อยู่ที่ 42.4% และ OpenAI อยู่ที่ 39.5%
อย่างไรก็ตาม ค่าใช้จ่ายด้าน AI ยังคงกระจุกตัวสูง ผู้ใช้ระดับองค์กร 1% แรกมีค่าใช้จ่าย AI เฉลี่ยต่อพนักงานประมาณ 4,833 ดอลลาร์สหรัฐต่อเดือน ส่วน 10% แรกอยู่ที่ 516 ดอลลาร์สหรัฐ และค่ามัธยฐานโดยรวมอยู่ที่เพียง 11 ดอลลาร์สหรัฐ อัตราการสมัครสมาชิกในอุตสาหกรรมเทคโนโลยีและสื่ออยู่ที่ 79.8% อัตราการนำไปใช้ขององค์กรขนาดใหญ่อยู่ที่ 65.5% สูงกว่าองค์กรขนาดกลางที่ 61.3% และองค์กรขนาดเล็กที่ 48.7%
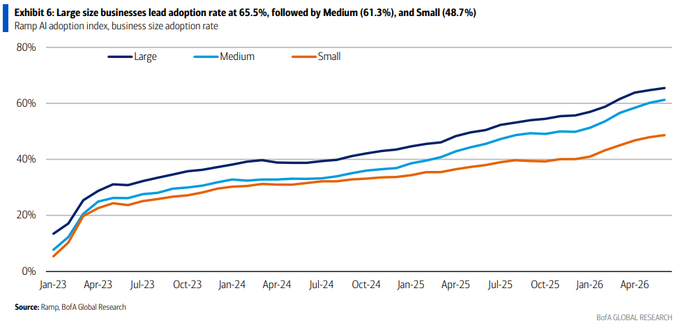
ชุดข้อมูลนี้สนับสนุนข้อสรุปหนึ่ง: การใช้งาน AI ยังอยู่ในกระบวนการแพร่กระจาย หากโมเดลราคาถูกช่วยลดอุปสรรคในการเข้าถึง ความต้องการที่เพิ่มขึ้นในอนาคตอาจมาจากองค์กรมากขึ้น นักพัฒนามากขึ้น และแอปพลิเคชันเอเจนต์มากขึ้น
จาก "ประหยัดพลังคำนวณ" สู่ "ปริมาณงานที่มากขึ้น"
ข้อสรุปร่วมของ Citi และ BofA Securities คือ ความสำคัญของ Kimi K3 ไม่ได้อยู่ที่ว่าโมเดลเดี่ยวจะลดต้นทุนการอนุมานต่อหน่วยหรือไม่ แต่อยู่ที่ว่าต้นทุนต่ำจะปลดปล่อยปริมาณงานในขนาดที่ใหญ่ขึ้นหรือไม่
สำหรับ Citi ทิศทางที่ได้รับประโยชน์โดยตรงที่สุดคือ DDR5 และ eSSD ของเซิร์ฟเวอร์ บริบทที่ยาว KV Cache และงานเอเจนต์จะเพิ่มความต้องการในการเข้าถึงหน่วยความจำและการจัดเก็บ สำหรับ BofA Securities สิ่งที่สำคัญกว่าคือ GPU, HBM, เครือข่ายความเร็วสูง และระบบอนุมาน เนื่องจากการแข่งขันของโมเดลจะบังคับให้ผู้นำลงทุนในโครงสร้างพื้นฐานต่อไป
BofA Securities ยังกล่าวถึงว่า "EDA โอเพนซอร์ส 45 นาโนเมตร" ของ Kimi K3 ไม่ควรถูกตีความง่ายๆ ว่าเป็นการแทนที่ EDA เชิงพาณิชย์ ในทางกลับกัน สิ่งนี้แสดงให้เห็นว่าการออกแบบชิปยังคงต้องพึ่งพาเครื่องมือ EDA ในกระบวนการผลิตขั้นสูง ผู้ผลิต EDA เชิงพาณิชย์อย่าง Cadence และ Synopsys ยังคงอยู่ในตำแหน่งสำคัญ
ความเสี่ยงอยู่ที่อีกสถานการณ์หนึ่ง: หากการบีบอัดโมเดล การเพิ่มประสิทธิภาพการอนุมาน และการปรับปรุงประสิทธิภาพฮาร์ดแวร์ดำเนินไปเร็วกว่าปริมาณงานใหม่ในระยะยาว การขยายโครงสร้างพื้นฐาน AI อาจชะลอตัวลงเป็นระยะๆ แต่ภายใต้กรอบของธนาคารเพื่อการลงทุนทั้งสองแห่งในปัจจุบัน Kimi K3 ดูเหมือนจะเป็นตัวเร่งที่ผลักดันปริมาณการใช้งานให้สูงขึ้น มากกว่าสัญญาณที่ทำให้ความต้องการชิปลดลง หลังจากประสิทธิภาพเพิ่มขึ้น สิ่งที่ตลาดต้องให้ความสนใจกลับเป็น token ที่มากขึ้น การอนุมานที่มากขึ้น และการบริโภคฮาร์ดแวร์พื้นฐานที่มากขึ้น
ลิงก์ต้นฉบับ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง