วิธีใช้ Hermes เพื่อแก้ไข "กลิ่น AI"
หัวข้อต้นฉบับ: วิธีแก้ไข AI Slop (โดยใช้ Hermes)
ผู้เขียนต้นฉบับ: @EXM7777
แปลโดย: Peggy
หมายเหตุบรรณาธิการ: การที่เนื้อหาที่สร้างโดย AI กลายเป็น "ขยะ" มักถูกมองว่าเกิดจากพรอมต์ไม่ดี โมเดลไม่แข็งแรงพอ หรือบริบทไม่สมบูรณ์ แต่บทความนี้เสนอแนวคิดที่ใกล้เคียงกับระบบวิศวกรรมมากกว่า: ปัญหาไม่ได้อยู่ที่ฝั่งอินพุต แต่อยู่ที่ฝั่งเอาต์พุต
ผู้เขียนเชื่อว่าหลายคนพยายามปรับเปลี่ยนพรอมต์ อัปเกรดโมเดล เปิดฟังก์ชันความจำ และซ้อนไฟล์บริบทซ้ำแล้วซ้ำเล่า แต่ AI slop ก็ยังคงปรากฏขึ้นซ้ำแล้วซ้ำเล่า สาเหตุคือวิธีการเหล่านี้ล้วนมุ่งเน้นการปรับปรุง "การสร้าง" เอง แต่ไม่ได้สร้างกลไกควบคุมคุณภาพที่มั่นคง เหมือนกับโรงงานที่ไม่พึ่งพาความรู้สึกของคนงานในการตัดสินว่าสินค้าควรออกจากโรงงานหรือไม่ เอาต์พุตของ AI ก็ไม่ควรไหลจากโมเดลไปยังผู้ใช้โดยตรง โดยขาดการทดสอบ การให้คะแนน และการสกัดกั้น
แนวทางหลักของบทความคือการสร้าง eval loop ในโอเพนซอร์ส Agent ที่ชื่อ Hermes: ก่อนอื่นกำหนดว่า "เอาต์พุตที่ดี" คืออะไร จากนั้นแปลงมาตรฐานเป็นระบบการให้คะแนนที่วัดผลได้ และตรวจสอบอย่างต่อเนื่องก่อนเผยแพร่ ระหว่างรันไทม์ และในสภาพแวดล้อมการผลิต ไม่ว่าจะเป็นการแสดงออกที่ว่างเปล่าในการสร้างเนื้อหา หรือคำตอบที่หลอน ข้อผิดพลาดของรูปแบบ และการเสื่อมถอยของประสบการณ์ในผลิตภัณฑ์ ล้วนเป็นเอาต์พุตของ AI ที่ไม่ได้รับการวัดผลและส่งถึงผู้รับโดยตรง
ดังนั้น สิ่งที่สำคัญจริงๆ ไม่ใช่การเขียนพรอมต์ที่ยาวขึ้นอีก แต่เป็นการเพิ่มชั้นระบบคุณภาพที่ขาดหายไป กรณีทดสอบ ตัวชี้วัดการให้คะแนน ค่าเกณฑ์ การทดสอบการถดถอย ปุ่มอนุมัติ และการตรวจสอบสภาพแวดล้อมการผลิต ล้วนประกอบกันเป็นกลไกนี้ มันเปลี่ยน "คุณภาพเอาต์พุตของ AI" จากความรู้สึกส่วนตัว ให้เป็นตัวเลขที่สามารถสังเกต เปรียบเทียบ และซ่อมแซมได้
ต่อไปนี้คือเนื้อหาต้นฉบับ:
บางคนดูเหมือนจะสามารถส่งมอบซอฟต์แวร์ที่ดีที่สุด เขียนเนื้อหาที่ยอดเยี่ยม หรือสร้างภาพที่น่าทึ่งได้อย่างต่อเนื่อง เบื้องหลังมีเหตุผล
พวกเขาใช้ eval loop ในขณะที่คุณยังไม่ได้ใช้
คุณลองใช้พรอมต์ที่ดีกว่า เปลี่ยนเป็นโมเดลที่แพงกว่า เขียนคำสั่งที่ยาวขึ้น เปิดฟังก์ชันความจำ และสร้างไฟล์บริบทที่ใหญ่โตเหมือนนิยาย แต่ขยะ AI ก็ยังคงปรากฏขึ้นครั้งแล้วครั้งเล่า
มันปรากฏขึ้นซ้ำแล้วซ้ำเล่าเพราะคุณกำลังซ่อมแซมชั้นที่ไม่ได้เสียตั้งแต่แรก
ขยะ AI ไม่ใช่ปัญหาของพรอมต์ แต่เป็นปัญหาของระบบ เหมือนกับโรงงานที่ส่งสินค้าที่มีข้อบกพร่องออกมาอย่างต่อเนื่อง ปัญหาไม่ได้อยู่ที่คนงานคนใดคนหนึ่ง แต่อยู่ที่กลไกควบคุมคุณภาพ: ไม่มีใครตรวจสอบสินค้าก่อนที่มันจะออกจากอาคาร
ดังนั้น บทความนี้จะสร้างกลไกนี้ขึ้นมา หลังจากอ่านจบ คุณจะมี eval loop ที่ทำงานใน Hermes ซึ่งเป็น Agent โอเพนซอร์ส โดยมันจะให้คะแนนตามเกณฑ์ของคุณก่อนที่เอาต์พุตแต่ละรายการจะถูกเผยแพร่ หลังจากเผยแพร่แล้ว มันจะตรวจสอบประสิทธิภาพของเอาต์พุตจริงต่อไป และเปลี่ยนความล้มเหลวแต่ละครั้งให้เป็นการทดสอบใหม่ ทำให้เกณฑ์คุณภาพสูงขึ้นโดยอัตโนมัติ
เราจะสร้างมันขึ้นมาทีละขั้นตอน ผลลัพธ์สุดท้ายนั้นชัดเจนมาก: คุณจะได้เอาต์พุตที่สะอาดและน่าเชื่อถืออย่างแท้จริง โดยไม่ต้องตรวจสอบทีละคำอีกในตอนดึก คุณจะมีคะแนนคุณภาพที่มองเห็นได้ชัดเจน และขยะ AI เหล่านั้นจะถูกสกัดกั้นก่อนที่จะออกไปถึงมือผู้ชมของคุณ
คุณจะได้สิ่งเหล่านี้จากบทความนี้:
ทำไมพรอมต์ที่ดีกว่า โมเดลที่ใหญ่กว่า และฟังก์ชันความจำถึงไม่สามารถกำจัดขยะ AI ได้อย่างสิ้นเชิง และเลเยอร์ไหนที่ได้ผลจริง
ขยะ AI ซ่อนอยู่ในสองที่ในงานของคุณ: เอาต์พุตเนื้อหาและเอาต์พุตผลิตภัณฑ์ และทำไมวิธีการแก้ไขทั้งสองถึงเหมือนกันทุกประการ
อธิบายด้วยภาษาชาวบ้านว่า eval loop คืออะไร: เลเยอร์คุณภาพที่แทบไม่มีใครรันในชีวิตประจำวัน และทำไมไม่มีใครเคยบอกให้คุณสร้างมันขึ้นมา
เกณฑ์มาตรฐานคุณภาพที่คุณสามารถสร้างได้ภายในสัปดาห์นี้ ซึ่งใช้ได้ทั้งกับเนื้อหาและผลิตภัณฑ์: ต้องวัดอะไรบ้าง และตัวเลขบนหน้าจอไหนถึงจะถือว่า "ดี"
ชุดขั้นตอนการสร้างที่สมบูรณ์: วิธีใช้คอมโพเนนต์ที่ Hermes มีอยู่แล้ว—skills, memory, cron และปุ่มอนุมัติ—เพื่อเชื่อมโยงทั้งวงจร ให้ประตูคุณภาพทำงานอัตโนมัติ โดยไม่ต้องพึ่งคุณตรวจสอบด้วยมือ
ถ้าคุณมาหา "5 พรอมต์แก้ขยะ AI" บทความนี้ไม่ใช่
สิ่งเหล่านั้นมีอยู่จริง แต่มันไม่ได้ผลจริง บทความนี้พูดถึงเวอร์ชันที่ได้ผล
คุณลองมาเกือบทุกอย่างแล้ว ยกเว้นสิ่งเดียวที่ควรลองจริงๆ
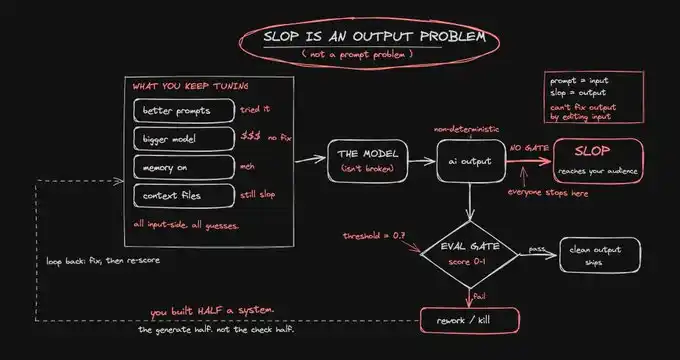
มาทบทวนสั้นๆ ว่าคุณทำอะไรไปแล้วบ้าง: คุณแก้ไขพรอมต์ สามครั้ง สี่ครั้ง คุณเพิ่มตัวอย่าง เพิ่มบุคลิก เพิ่มรายการ "ห้ามทำแบบนี้" ยาวเหยียด คุณอัปเกรดเป็นโมเดล前沿 เสียค่าใช้จ่ายต่อ token มากกว่า 5 เท่า แต่ผลลัพธ์กลับมั่นใจขึ้นเท่านั้น ไม่ได้มีเนื้อหาน้อยลง คุณเปิดฟังก์ชันความจำ สร้างไฟล์บริบท ป้อนโทนเสียงแบรนด์ ผลงานที่ผ่านมา และคู่มือสไตล์ให้มัน
การดำเนินการแต่ละอย่างเหล่านี้ จะทำให้คุณได้ผลลัพธ์ที่ดีสักสองสามครั้ง จากนั้นขยะ AI ก็จะค่อยๆ กลับมาเหมือนเดิม
เพราะทั้งหมดนี้คือการแก้ไขที่ฝั่งอินพุต คุณกำลังขัดเกลาสิ่งที่เรียกว่า "การสร้าง" อยู่ตลอด แต่กลับมองข้ามสิ่งที่ควรทำหน้าที่ "สกัดกั้น" จริงๆ ปืนที่ดีแค่ไหน ถ้ายิงไปในความมืด ก็ยังยิงไม่โดนอะไรอยู่ดี
ขยะ AI เป็นปัญหาที่ฝั่งเอาต์พุต ปัญหาไม่ได้อยู่ที่โมเดลไม่สามารถสร้างผลงานที่ดีได้ แต่อยู่ที่คุณไม่มีวิธีแยกแยะล่วงหน้าว่าผลงานไหนดี ผลงานไหนไม่ดี ก่อนที่มันจะถึงมือคนสำคัญ
คุณไม่มี eval loop ไม่มีเกณฑ์มาตรฐานคุณภาพ ไม่มีกระดานคะแนน ดังนั้นคุณจึงปรับแบบสุ่มไปเรื่อย คุณเปลี่ยนพรอมต์หนึ่งตัว รู้สึกว่ามันดีขึ้น แต่ความรู้สึกไม่ใช่การวัดผล และความรู้สึกก็ไม่สามารถสกัดกั้นผลลัพธ์แย่ๆ ที่ซ่อนอยู่ในการสร้างครั้งต่อไปอีก 50 ครั้งได้
คุณจึงเริ่มโทษตัวเอง โทษพรอมต์ โทษการตั้งค่า Agent โทษวิศวกรรมบริบท แต่สิ่งที่ขาดหายไปจริงๆ คือชั้นการทำงานของ AI ทั้งชั้นที่คุณไม่เคยถูกสอนให้รู้ และหลังจากอ่านบทความนี้ ชั้นนี้จะทำงานบนเครื่องของคุณเอง ใน Hermes
ทำไมพรอมต์ที่ดีกว่าแก้ปัญหานี้ไม่ได้ และทำไมทุกคนยังคงพยายามอยู่
พรอมต์คือสมมติฐาน เอาต์พุตคือผลลัพธ์ และ eval คือสิ่งเดียวที่เชื่อมสองสิ่งนี้ให้เป็นวงจรปิด
หากไม่มีวงจรปิดนี้ คุณจะติดอยู่ในโลกของการเดาตลอดไป คุณปรับสมมติฐาน ดูผลลัพธ์ด้วยตาเปล่า แล้วประกาศชัยชนะ คุณจะไม่มีวันค้นพบว่าพรอมต์เดียวกันนั้น 30% ของเวลาสร้างขยะ เพราะคุณดูแค่ผลลัพธ์ที่อยู่ตรงหน้าในแต่ละครั้ง
โมเดลไม่ใช่สิ่งที่กำหนดตายตัว การรันพรอมต์เดียวกันสองครั้งจะให้คำตอบที่แตกต่างกันสองแบบ นั่นหมายความว่า แม้แต่พรอมต์ที่ "สมบูรณ์แบบ" ก็ยังสร้างขยะ AI ในสัดส่วนหนึ่งของการรัน และก่อนที่ลูกค้าหรือผู้ใช้จะเห็นมัน คุณไม่มีทางรู้ว่ามันคือครั้งไหน
ดังนั้น พรอมต์ที่สมบูรณ์แบบไม่ใช่การรับประกันคุณภาพ มันเป็นแค่การโยนเหรียญที่มีโอกาสชนะสูงขึ้นเล็กน้อย และตอนนี้คุณกำลังส่งผลลัพธ์ของการโยนเหรียญทุกครั้งออกไปโดยตรง
เหตุผลที่ทุกคนยังคงฝากความหวังไว้กับพรอมต์นั้นง่ายมาก: พรอมต์คือคันโยกเดียวที่คุณมองเห็นได้ คุณสามารถแก้ไขมันได้ และการแก้ไขมันทำให้คุณรู้สึกถึงการควบคุม
การวัดผลนั้นมองไม่เห็น ไม่มีใครขายคอร์สเกี่ยวกับการวัดผลให้คุณ และไม่มีใครโพสต์ข้อความที่แพร่ระบาดในชื่อ "eval suite นี้ทำให้คุณภาพเอาต์พุตของฉันดีขึ้น 10 เท่า" ดังนั้น การสนทนาทั้งหมดจึงติดอยู่ในคันโยกที่แก้ปัญหาไม่ได้เมื่อใช้เพียงลำพัง
คนที่ผลลัพธ์ AI ของพวกเขาสะอาดอยู่เสมอ ไม่ใช่เพราะพวกเขาเก่งกว่าในการเขียนพรอมต์มากกว่าคุณ พวกเขาแค่มีสิ่งที่คุณไม่มี นั่นคือ "กลไกการวัด" พวกเขาจะใช้ชุดมาตรฐานในการประเมินผลลัพธ์ทุกครั้งก่อนที่จะเผยแพร่ กลไกการวัดนี้เองที่ทำให้พรอมต์ของพวกเขาดูเหมือนเวทมนตร์
AI ขยะซ่อนอยู่ในสองที่
AI ขยะซ่อนอยู่ในสองที่เท่านั้น และเกือบทุกคนจะจ้องมองแค่ที่เดียว
ที่แรก คือผลลัพธ์เนื้อหาของคุณ
ทวีต บทความ อีเมล หน้า Landing Page โพสต์ อะไรก็ตามที่คุณสร้างด้วย AI และเผยแพร่ในนามของคุณ ล้วนอยู่ในหมวดนี้
AI ขยะในที่นี้ มักจะดูเหมือน "ถูกต้องในทางเทคนิค แต่กลวงเปล่าโดยสิ้นเชิง" มันฟังดูเหมือนสิ่งที่ทุกบัญชี AI ในไทม์ไลน์โพสต์ออกมา: ภายนอกถูกต้อง แต่ภายในว่างเปล่า
มันจะล้มเหลวในที่สาธารณะ และคุณไม่สามารถบอกได้ว่าทำไม เพราะเมื่อคุณกดปุ่มส่ง แต่ละชิ้นดูเหมือนจะโอเค
ที่สอง คือผลลัพธ์ผลิตภัณฑ์ของคุณ
ฟีเจอร์ AI, Agent, แชทบอท, ระบบตอบกลับลูกค้า, สายการดึงข้อมูล อะไรก็ตามที่ผู้ใช้จริงจะสัมผัส ล้วนอยู่ในหมวดนี้
AI ขยะในที่นี้ อาจแสดงออกมาเป็นคำตอบที่ผิดพลาดด้วยความมั่นใจ ตัวเลขที่เกิดจากภาพหลอน ผลลัพธ์ JSON ที่เสียหาย น้ำเสียงที่ไม่สอดคล้องกับแบรนด์ หรือผลลัพธ์ที่ทำงานได้ดีในการสาธิต แต่ค่อยๆ เสื่อมลงหลังจากการปรับใช้สามครั้ง
มันจะไม่ตายทันทีในที่สาธารณะ มันจะแพร่กระจายอย่างเงียบๆ ผู้ใช้แต่ละคนจะได้รับประสบการณ์ที่แย่ลงเล็กน้อย และส่วนใหญ่จะไม่บอกคุณ พวกเขาแค่จากไป
ทั้งสองอย่างนี้เป็นโรคเดียวกัน และวิธีแก้ก็เหมือนกัน
ขยะเนื้อหาและขยะผลิตภัณฑ์ โดยพื้นฐานแล้วคือผลลัพธ์ AI ที่ไม่ได้รับการวัด โดยไม่มีประตูคุณภาพใดๆ ถูกส่งตรงไปยังผู้ชม
ความแตกต่างเพียงอย่างเดียวคือความเสี่ยงและการมองเห็น ขยะเนื้อหาจะทำให้คุณอับอายในที่สาธารณะ ส่วนขยะผลิตภัณฑ์จะค่อยๆ กัดกร่อนธุรกิจของคุณ และวงจรที่เราจะสร้างใน Hermes จะใช้สกิลเดียวกันในการให้คะแนนทั้งสองอย่าง ดังนั้นคุณสามารถใช้ระบบคุณภาพเดียวในการจัดการเนื้อหาที่สร้างทั้งหมด แทนที่จะต้องดูแลสองระบบสำหรับสถานการณ์ที่แตกต่างกัน
eval loop คืออะไรกันแน่
eval loop คือการทดสอบที่สามารถทำงานซ้ำได้ โดยจะเปรียบเทียบผลลัพธ์ของ AI กับเกณฑ์ที่คุณกำหนดโดยอัตโนมัติทั้งก่อนและหลังการเผยแพร่ พร้อมให้คะแนน
ง่ายมาก แค่นี้เอง และนี่คือชั้นที่ผู้สร้าง AI ส่วนใหญ่ขาดหายไป
สร้างผลลัพธ์ ให้คะแนนตามเกณฑ์ที่คุณกำหนด สกัดกั้นผลลัพธ์ที่ต่ำกว่ามาตรฐาน แก้ไขส่วนที่ล้มเหลว ให้คะแนนใหม่ และปล่อยให้เฉพาะผลลัพธ์ที่ผ่านการทดสอบเท่านั้นเข้าสู่ขั้นตอนถัดไป
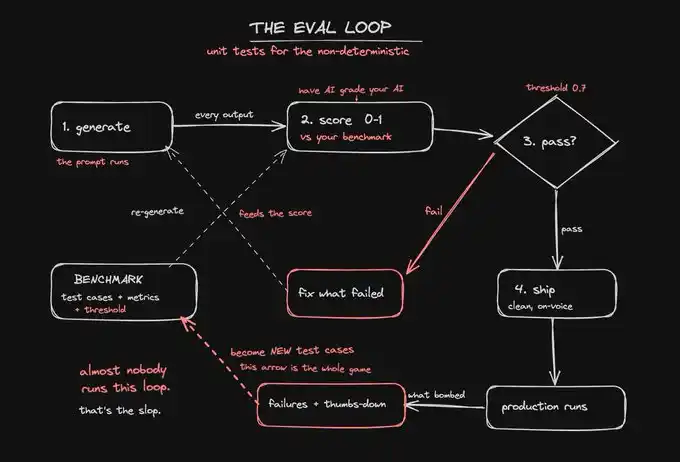
วิศวกรซอฟต์แวร์มีกลไกนี้มานานแล้ว มันเรียกว่าการทดสอบ คุณจะไม่ปล่อยโค้ดโดยไม่ทดสอบแล้วหวังว่ามันจะทำงานได้ดีในสภาพแวดล้อมจริง แต่นี่คือวิธีที่อุตสาหกรรมทั้งหมดปล่อยผลลัพธ์ของ AI ในตอนนี้: จากโมเดลตรงถึงผู้ใช้ อาศัยความรู้สึกและการอธิษฐาน
แทบไม่มีใครมี eval loop สาเหตุหลักเกี่ยวข้องกับโครงสร้างของกลุ่มคน คนที่ใช้ AI สร้างสิ่งต่างๆ ในปัจจุบัน หลายคนมาจากสายงานเนื้อหา การขาย ผลิตภัณฑ์ และการเริ่มต้นธุรกิจ ไม่ใช่สายวิศวกรรม ดังนั้น "การเขียนทดสอบสำหรับผลลัพธ์ของคุณ" จึงไม่เคยอยู่ในชุดเครื่องมือของพวกเขา Eval ฟังดูเหมือนโครงสร้างพื้นฐานที่ "วิศวกรตัวจริง" เท่านั้นถึงจะใช้ และคนที่ต้องการมันมากที่สุดกลับรู้สึกโดยไม่รู้ตัวว่าตัวเองไม่มีสิทธิ์ใช้มัน
คุณสามารถมองมันเป็นการทดสอบหน่วยสำหรับระบบที่ไม่แน่นอน สิ่งที่คุณทดสอบไม่ใช่โค้ดที่ทำงานได้หรือไม่ แต่เป็นว่าผลลัพธ์ดีพอหรือไม่ คุณต้องทดสอบกับกรณีตัวอย่างให้มากพอ เพื่อให้แน่ใจว่าการสร้างที่แย่ครั้งหนึ่งจะไม่หลุดรอดไปได้ง่ายๆ
eval loop จะทำงานในสามที่ ระบบที่เราจะสร้างต่อไปจะใส่มันเข้าไปในสามจุดนี้:
ก่อนเผยแพร่ ใช้ชุดกรณีตัวอย่างที่บันทึกไว้เพื่อทดสอบพรอมต์หรือโมเดลใหม่ของคุณ ยืนยันว่ามันไม่ได้แย่ลง นี่คือการทดสอบการถดถอย เพื่อป้องกันไม่ให้การแก้ไขหนึ่งจุดทำให้อีกสามจุดเสียหายโดยไม่รู้ตัว
ระหว่างการทำงาน ให้คะแนนในขณะที่สร้างผลลัพธ์ และให้ตรรกะแบบมีเงื่อนไขสกัดกั้นผลลัพธ์ที่ล้มเหลวก่อนที่มันจะถึงผู้ใช้ นี่คือรั้วป้องกัน
ในสภาพแวดล้อมการผลิต สุ่มตัวอย่างผลลัพธ์จริงอย่างต่อเนื่องและให้คะแนน เพื่อให้คุณพบปัญหาในวันที่คุณภาพเริ่มลดลง แทนที่จะรอจนกว่าลูกค้าจะร้องเรียนในอีกหนึ่งสัปดาห์ต่อมา
แบบแรก คุณสามารถทำได้แม้กระทั่งด้วยสเปรดชีต แต่ถ้าคุณต้องการให้การทดสอบทั้งสามแบบทำงานต่อเนื่อง โดยไม่ทำให้มันกลายเป็นงานที่สองของคุณ นี่คือเหตุผลที่เราจะใส่มันเข้าไปใน Agent
เมื่อคุณภาพกลายเป็นตัวเลข ขยะ AI จะไม่ใช่ความรู้สึกที่คุณมีซ้ำแล้วซ้ำอีกอีกต่อไป แต่มันจะกลายเป็นบั๊กที่สามารถแก้ไขได้ คุณไม่สามารถดีบักความรู้สึกได้ แต่คุณสามารถดีบักคะแนนที่ลดลงจาก 0.82 เหลือ 0.61 ได้
เกณฑ์มาตรฐาน: สามส่วนที่คุณจะต้องสร้างต่อไป
เกณฑ์มาตรฐานหนึ่งชุดประกอบด้วยสามส่วน ไม่ว่าคุณจะกำลังประเมินเนื้อหาหรือประเมินผลิตภัณฑ์ สามสิ่งนี้ก็เหมือนกันเสมอ:
กรณีทดสอบ: อินพุตจริง พร้อมตัวอย่างเอาต์พุตคุณภาพสูงที่สอดคล้องกัน ซึ่งก็คือ ground truth ของคุณ
เมตริก: วิธีที่คุณแปลงเอาต์พุตให้เป็นคะแนน โดยควรเป็นคะแนนระหว่าง 0 ถึง 1
เกณฑ์ขั้นต่ำ: สิ่งใดที่ต่ำกว่าเส้นนี้จะไม่อนุญาตให้เผยแพร่
เมื่อคุณสร้างสามสิ่งนี้ขึ้นมา คุณก็จะมีประตูควบคุมคุณภาพ หากขาดสิ่งใดสิ่งหนึ่งไป สิ่งที่คุณมีก็เป็นเพียงแค่ความปรารถนา ส่วนต่อไปนี้จะอธิบายว่าแต่ละส่วนควรใส่อะไรบ้าง จากนั้นเราจะเชื่อมต่อทั้งสามส่วนเข้ากับ Hermes
สำหรับเนื้อหา กรณีทดสอบของคุณคือมาตรฐานทองคำ
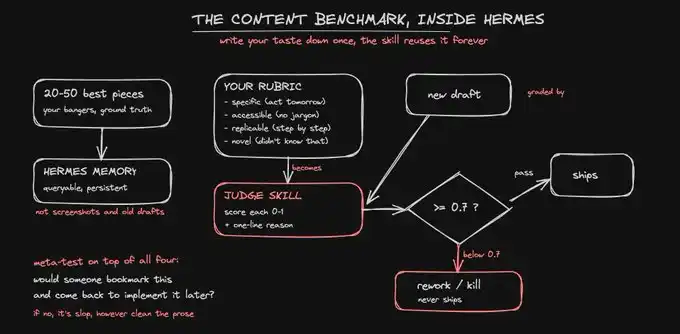
ค้นหาผลงานที่ดีที่สุด 20 ถึง 50 ชิ้นของคุณ: เนื้อหาที่ทำผลงานได้ดีจริงๆ โพสต์ที่ถูกบันทึก บทความที่คุณยินดีลงชื่อเต็มของคุณ นี่คือหน้าตาของ "ความดี" คุณไม่ได้กำลังประดิษฐ์มาตรฐานขึ้นมาจากอากาศ แต่กำลังสกัดมาตรฐานที่คุณเคยทำได้ดีที่สุดอยู่แล้ว
สำหรับเนื้อหา เมตริกของคุณคือชุดเกณฑ์การให้คะแนน
คะแนนจะน่าเชื่อถือได้ก็ต่อเมื่อชุดเกณฑ์การให้คะแนนที่อยู่เบื้องหลังน่าเชื่อถือ ดังนั้น คุณต้องเข้ารหัส "มาตรฐานเนื้อหาที่ดี" ที่คุณเชื่อจริงๆ ลงไป สำหรับเนื้อหา ฉันจะให้คะแนนแต่ละชิ้นงานจากสี่มาตรฐาน:
มันอธิบายวิธีการทำสิ่งใดสิ่งหนึ่งโดยเฉพาะหรือไม่ แทนที่จะให้แค่ความรู้สึก; ผู้อ่านสามารถลงมือทำได้ในวันพรุ่งนี้
กลุ่มเป้าหมายทุกคนเข้าใจได้หรือไม่; ไม่มีกำแพงศัพท์เทคนิค หรือสำนวนที่เฉพาะคนในวงการเท่านั้นที่เข้าใจ
มันมีโครงสร้างชัดเจน นำไปใช้ซ้ำได้ และเป็นขั้นเป็นตอน หรือเป็นแค่การสร้างแรงบันดาลใจ
มันใหม่พอหรือไม่; ผู้อ่านไม่เคยรู้มาก่อนว่าสิ่งนี้สามารถทำได้แบบนี้
มาตรฐานหลักที่ครอบคลุมสี่มาตรฐานนี้คือ: ผู้อ่านจะบันทึกเนื้อหานี้และกลับมาทำตามในภายหลังหรือไม่?
หากคำตอบคือไม่ ไม่ว่าข้อความจะอ่านดูสะอาดตาขนาดไหน มันก็คือขยะ AI
ประเด็นสำคัญอยู่ที่ชุดเกณฑ์การให้คะแนนเอง ชุดเกณฑ์ที่คลุมเครือ เช่น "เนื้อหานี้ดีไหม? น่าสนใจไหม?" จะให้คะแนนที่คลุมเครือเท่านั้น ชุดเกณฑ์ที่เฉพาะเจาะจง เช่น "เนื้อหานี้มีเทมเพลตหรือคู่มือปฏิบัติที่สามารถคัดลอกและใช้ได้โดยตรงอย่างน้อยหนึ่งชิ้นหรือไม่?" จะให้คะแนนที่คุณสามารถเชื่อถือได้ เมื่อคุณเขียนรสนิยมของคุณลงไปจริงๆ เท่านั้น judge ถึงจะสืบทอดรสนิยมของคุณได้
สำหรับผลิตภัณฑ์แล้ว กรณีทดสอบมาจากบันทึกของคุณ
คุณต้องดึงข้อมูลอินพุตที่ฟีเจอร์ของคุณเจอจริงจากบันทึกและเซสชันผู้ใช้จริง แทนที่จะใช้แค่ตัวอย่าง happy path สามอันที่ทดสอบในวันเปิดตัว สิ่งที่ทำให้ระบบพังจริงๆ มักจะเป็นกรณีแปลกๆ ที่ซ่อนอยู่ในบันทึกของคุณ
สำหรับผลิตภัณฑ์แล้ว ตัวชี้วัดต้องสอดคล้องกับงานนั้นๆ
สำหรับอินพุตแต่ละตัว ให้กำหนดว่าผลลัพธ์แบบไหนถึงจะถูกต้อง จากนั้นจับคู่ตัวชี้วัดกับประเภทของงาน ถ้ามีป้ายกำกับที่ถูกต้องเพียงอันเดียว ให้ใช้การจับคู่แบบตรงตัว ถ้าโครงสร้างต้องถูกต้อง ให้ใช้ตัวตรวจสอบ ถ้าผลลัพธ์เป็นแบบเปิด ให้ใช้ความคล้ายคลึงเชิงความหมายร่วมกับ judge ตัวชี้วัดต้องทำแค่สิ่งเดียวคือคืนค่าเป็นตัวเลข เพราะมีแต่ตัวเลขเท่านั้นที่จะใส่ลงในเกณฑ์ได้
สำหรับเนื้อหาและผลิตภัณฑ์แล้ว เกณฑ์คือเส้นที่คุณต้องรักษาไว้
0.7 เป็นจุดเริ่มต้นที่สมเหตุสมผล เนื้อหาใดๆ ที่ต่ำกว่า 0.7 ต้องถูกทำใหม่หรือทิ้งก่อนเผยแพร่ โดยไม่มีข้อยกเว้น เกณฑ์จะมีผลจริงก็ต่อเมื่อคุณไม่เคยปล่อยผลลัพธ์ที่ 0.6 ผ่านไปเพราะ "ฉันชอบอันนี้" ความหมายของมันคือการเอาความคิดที่สะท้อนตัวเองในยามดึกออกจากการตัดสินใจ
นี่คือ benchmark ตอนนี้เราจะทำให้มันทำงานด้วยตัวเอง
สร้างลูปนี้ใน Hermes
Hermes ไม่ได้มีปุ่ม eval ในตัว หรือแดชบอร์ดที่ชื่อว่า "คุณภาพ" ให้คุณคลิก "เปิดการป้องกันเนื้อหาขยะ AI"
แต่สิ่งที่ Hermes ให้คุณนั้นดีกว่า มันให้ส่วนประกอบดิบของ eval loop แก่คุณ คุณแค่ต้องประกอบความสามารถพื้นฐานเหล่านี้ครั้งเดียวเพื่อให้ได้มันมาจริงๆ
ส่วนประกอบเหล่านี้รวมถึง: skills ที่มันเขียนและนำกลับมาใช้เองได้, ความทรงจำถาวรที่เติบโตข้ามเซสชัน, cron ในตัว, ความสามารถในการส่งไปยังแพลตฟอร์มใดๆ, ปุ่มอนุมัติใน Slack, และนิสัยการปรับปรุงตัวเองที่ฝังอยู่ในกลไกหลัก
Hermes เรียกตัวเองว่า "Agent ที่เติบโตไปกับคุณ" และการเติบโตนี้คือลูปที่เราจะสร้างขึ้น
ดังนั้น มาเริ่มเดินสายกัน มีทั้งหมดหกขั้นตอน
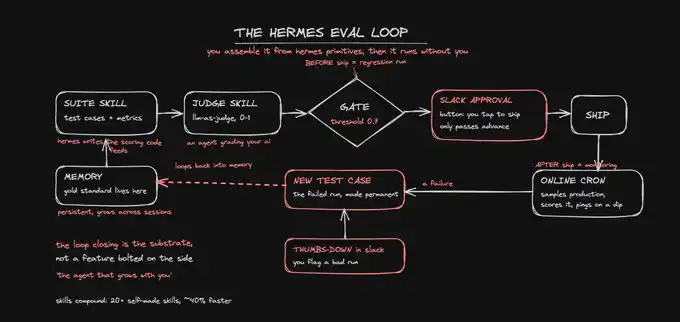
ขั้นตอนแรก deploy Hermes ไปยังที่ที่มันเข้าถึงคุณได้
ติดตั้ง Hermes และเชื่อมต่อกับ Telegram จุดนี้สำคัญกว่าที่คิด เพราะประตูตรวจสอบคุณภาพจะทำงานได้จริงก็ต่อเมื่อมันสามารถขัดจังหวะคุณได้ Hermes สามารถทำงานบนช่องทางมากกว่า 20 ช่องทาง และสามารถส่งปุ่มอนุมัติแบบเนทีฟใน Slack และ Telegram ได้ หมายความว่า Agent สามารถทำงานเบื้องหลังให้เสร็จ และแตะไหล่คุณเบาๆ เมื่อต้องการให้คุณตัดสินใจ
ขั้นตอนที่สอง โหลดมาตรฐานทองคำของคุณเข้าสู่ความทรงจำ
Hermes มีความทรงจำถาวรที่เติบโตข้ามเซสชัน และรองรับการเรียกคืนข้ามเซสชันแบบเต็มรูปแบบ ดังนั้น ผลงานที่ดีที่สุด 20 ถึง 50 ชิ้นใน benchmark ของคุณ เพียงแค่ใส่เข้าไปครั้งเดียว ก็จะคงอยู่ที่นั่นตลอดไป
เนื้อหาส่วนนี้มักจะกระจายอยู่ในภาพหน้าจอ ฉบับร่างเก่า และไฟล์ที่กระจัดกระจาย แต่ที่นี่ มันจะกลายเป็นความทรงจำระยะยาวของ Agent ที่สามารถค้นหาได้ และเป็น ground truth ที่ใช้เปรียบเทียบเมื่อให้คะแนน
ขั้นตอนที่สาม ทำให้สเกลการให้คะแนนของคุณกลายเป็น judge skill
นี่คือหัวใจของระบบทั้งหมด คุณเพียงแค่บอก Hermes ด้วยภาษาธรรมชาติครั้งเดียว: สร้าง skill ที่รับผลลัพธ์และสเกลการให้คะแนนของคุณ จากนั้นส่งคืนคะแนน 0 ถึง 1 สำหรับแต่ละเกณฑ์ พร้อมเหตุผลสั้นๆ
นี่คือ LLM-as-a-judge: ให้ Agent หนึ่งตัวประเมินผลลัพธ์ LLM ของคุณ เมื่อจับคู่กับสเกลการให้คะแนนที่คมชัดและชัดเจน โมเดลจะกลายเป็นนักวิจารณ์ที่เสถียรกว่าคุณ เพราะมันไม่มีอัตตา และไม่ลังเลที่จะลบประโยคที่คุณแอบภูมิใจ
เหตุผลที่ต้องทำให้เป็น skill แทนที่จะเป็น prompt แบบใช้ครั้งเดียว เพราะ skills ของ Hermes โดยพื้นฐานแล้วคือความทรงจำเชิงกระบวนการ Agent จะเขียนมัน จัดเก็บมัน และนำกลับมาใช้ซ้ำๆ คุณเพียงแค่เข้ารหัสรสนิยมของคุณครั้งเดียว มันก็จะสามารถให้คะแนนผลลัพธ์ทุกครั้งหลังจากนั้นได้อย่างต่อเนื่อง
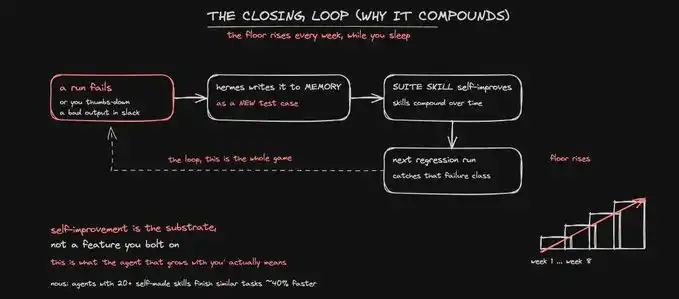
ยิ่งไปกว่านั้น skills มีผลทบต้น Nous พบว่า Agent ที่มี skills ที่สร้างเองมากกว่า 20 รายการ จะทำงานที่คล้ายกันได้เร็วขึ้น 40% เพราะไม่ต้องค้นหากระบวนการใหม่ซ้ำแล้วซ้ำอีก judge ของคุณก็จะคมขึ้นเมื่อใช้งานมากขึ้น
ขั้นตอนที่สี่ ทำให้ชุดทดสอบเป็น skill แทนที่จะเป็นตาราง
กรณีทดสอบและฟังก์ชันเมตริกของคุณจะถูกรวมเข้าด้วยกันเป็นสกิลที่ Hermes จัดเก็บและควบคุมเวอร์ชัน ส่วนคลังเมตริกจะขึ้นอยู่กับงานเฉพาะ: งานจำแนกประเภทใช้การจับคู่แบบตรงเป๊ะ งานดึงข้อมูลใช้นิพจน์ปกติ งานเอาต์พุตแบบมีโครงสร้างใช้ตัวตรวจสอบ JSON และตัวตรวจสอบคีย์-ค่า ส่วนงานเอาต์พุตแบบสร้างสรรค์ใช้ความคล้ายคลึงเชิงความหมาย
สำหรับงานแบบเปิด ให้ใช้สกิลผู้ตัดสินของคุณ Hermes จะเขียนโค้ดให้คะแนนเอง คุณแค่ต้องอธิบายงาน มันก็จะสร้างเมตริกที่เหมาะสมขึ้นมา ทั้งหมดนี้จะอยู่ในที่เดียว จัดการโดย Agent เอง แทนที่จะกระจัดกระจายอยู่ในตารางที่คุณอาจหาไม่เจอในสักวัน
ขั้นตอนที่ห้า ใช้การทดสอบแบบถดถอยและปุ่มอนุมัติเพื่อควบคุมจุดเผยแพร่
นี่คือนิสัยที่มีเลเวอเรจสูงที่สุดในระบบทั้งหมด และเป็นนิสัยที่แทบไม่มีใครทำด้วยตนเองอย่างต่อเนื่องในระยะยาวได้ ดังนั้นเราจึงมอบมันให้ Agent
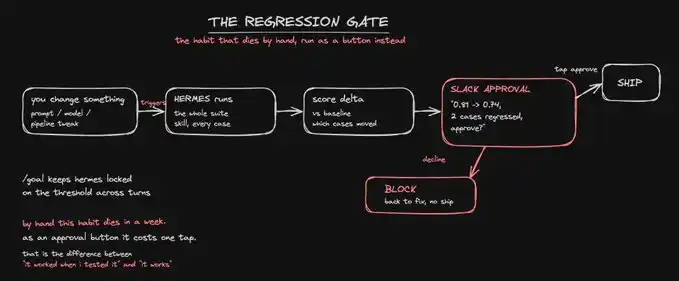
เมื่อเชื่อมต่อกระบวนการแล้ว การเปลี่ยนแปลงใดๆ—พรอมต์ใหม่ โมเดลที่เปลี่ยนไป หรือไปป์ไลน์ที่ปรับแต่ง—จะกระตุ้นชุดทดสอบโดยอัตโนมัติ Hermes จะรันทุกกรณีอีกครั้ง คำนวณการเปลี่ยนแปลงคะแนนเทียบกับค่าพื้นฐาน จากนั้นจะไม่เผยแพร่เงียบๆ แต่จะแจ้งเตือนคุณใน Slack: "คะแนนลดลงจาก 0.81 เป็น 0.74 มีสองกรณีที่ถดถอย ต้องการอนุมัติไหม?"
มันจะดำเนินการต่อเมื่อคุณคลิกปุ่มอนุมัติเท่านั้น
คุณสามารถใช้ /goal เพื่อล็อกมันให้ทำงานนี้อย่างต่อเนื่อง ให้ Agent ดำเนินการตามเป้าหมายเดียวกันข้ามการสนทนาหลายรอบ สำหรับงานที่ใหญ่ขึ้น กระดานหลาย Agent ของมันยังสามารถแยกย่อยกระบวนการทำงาน ให้คะแนนแบบขนาน และจัดตารางเวลาดำเนินการได้
ด้วยวิธีนี้ ประตูคุณภาพจะกลายเป็นกระบวนการที่ทำงานตลอดเวลา ไม่ใช่สิ่งที่คุณต้องจำต้องทำด้วยตนเอง
ขั้นตอนที่หก ใช้ cron เพื่อตรวจสอบสภาพแวดล้อมการผลิตและปิดวงจร
Hermes มี cron ในตัว สามารถส่งผลลัพธ์ไปยังแพลตฟอร์มใดก็ได้ ดังนั้นคุณสามารถกำหนดเวลางานให้สุ่มตัวอย่างผลลัพธ์จริง ใช้สกิลผู้ตัดสินเดียวกันให้คะแนน และส่งข้อความส่วนตัวถึงคุณทันทีที่คะแนนต่ำกว่าเกณฑ์
ด้วยวิธีนี้ คุณจะพบปัญหาได้ในวันที่คุณภาพเริ่มลดลง แทนที่จะรอจนกว่าลูกค้าจะร้องเรียนในอีกหนึ่งสัปดาห์ต่อมา
"คะแนน eval ลดลง" เป็นปัญหาที่คุณจัดการได้ทันที ในขณะที่ "ลูกค้าคนหนึ่งดูเหมือนไม่พอใจ" ไม่ใช่
ต่อไปนี้คือส่วนสำคัญที่ทำให้ทั้งระบบเริ่มทบต้น
เมื่อคุณกด thumbs-down ให้กับผลลัพธ์ที่แย่ใน Slack เฮอร์มีสจะเขียนมันกลับเข้าไปในชุดทดสอบสกิล เป็นกรณีทดสอบใหม่ การทำงานที่ล้มเหลวนั้นจะกลายเป็นรายการตรวจสอบถาวร
และเนื่องจากการปรับปรุงตัวเองเป็นกลไกหลักของเฮอร์มีส ไม่ใช่ฟังก์ชันที่เพิ่มเข้ามาทีหลัง ชุดทดสอบนี้จะแข็งแกร่งขึ้นโดยอัตโนมัติทุกสัปดาห์
ในขณะที่คุณนอนหลับ เกณฑ์คุณภาพก็ยังคงสูงขึ้นเรื่อยๆ
เมื่อระบบนี้ทำงานจริง สถานะที่ดีจะชัดเจนมาก: เนื้อหาที่มีคะแนนต่ำกว่า 0.7 ในมาตราวัดของคุณจะไม่มีวันถูกเผยแพร่ การเปลี่ยนแปลงผลิตภัณฑ์ที่ทำให้ตัวชี้วัดใดๆ ต่ำกว่าเส้นฐานจะหยุดการปรับใช้ จนกว่าคุณจะอนุมัติด้วยตนเอง
และเส้นคะแนนในสภาพแวดล้อมการผลิตจะคงที่หรือเพิ่มขึ้นอย่างต่อเนื่อง วันที่มันเริ่มลดลงคือวันที่เฮอร์มีสเตือนคุณ ไม่ใช่รอจนถึงหนึ่งสัปดาห์ต่อมาเมื่อข้อมูลการสูญเสียผู้ใช้ปรากฏ
ส่วนที่ไม่มีใครอยากฟัง
ผลลัพธ์ AI ของคุณที่ไม่เสถียร ไม่ใช่เพราะคุณเขียนพรอมต์ไม่เป็น หรือเพราะโมเดลยังไม่ฉลาดพอ
แต่เป็นเพราะคุณรันแค่ขั้นตอนการสร้าง แต่ไม่ได้รันขั้นตอนคุณภาพ คุณสร้างระบบแค่ครึ่งเดียว แต่กลับโทษส่วนที่ทำงานจริงๆ
วิธีแก้ไขไม่ใช่การเปลี่ยนพรอมต์ที่ดีกว่า แต่เป็นการเพิ่มชั้นที่ขาดหายไป
กำหนดว่าอะไรคือดี แปลงมันเป็นตัวเลข ใช้ตัวเลขนี้ประเมินทุกผลลัพธ์ สกัดกั้นทุกสิ่งที่ต่ำกว่าเส้นฐาน และปิดวงจรให้เกณฑ์คุณภาพสูงขึ้นโดยอัตโนมัติทุกสัปดาห์
ตอนนี้ ชั้นนี้ไม่ใช่โปรเจกต์ที่ "ไว้ทำทีหลัง" อีกต่อไป แต่เป็นระบบที่รันบนเครื่องของคุณเอง ผ่าน Agent ด้วยหกขั้นตอน
เมื่อทำสิ่งนี้ได้ ขยะ AI จะไม่ใช่สิ่งที่เกิดขึ้นกับคุณแบบสุ่มอีกต่อไป แต่จะกลายเป็นสิ่งที่คุณสกัดกั้นได้ทุกครั้งก่อนออกไป เหมือนกับโรงงานจริงที่หยุดผลิตภัณฑ์บกพร่องก่อนถึงมือลูกค้า
พรอมต์ไม่เคยเป็นระบบ
eval loop ต่างหากที่เป็นระบบ เฮอร์มีสคือที่ที่มันทำงาน
ตอนนี้คุณมีมันแล้ว
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง