Claude Opus 4.8 เปิดตัวแล้ว Anthropic เริ่มใช้ "ความน่าเชื่อถือ" เป็นจุดขายของผลิตภัณฑ์
หัวข้อต้นฉบับ: Claude Opus 4.8: เกณฑ์มาตรฐาน ความน่าเชื่อถือ และสิ่งใหม่ๆ
ผู้เขียนต้นฉบับ: The AI Bridge
เรียบเรียง: Peggy, BlockBeats
หมายเหตุบรรณาธิการ: Anthropic เปิดตัว Claude Opus 4.8 คว้าอันดับหนึ่งในห้าจากหกเกณฑ์มาตรฐานหลัก ราคายังคงเท่าเดิม Claude Code เพิ่มเวิร์กโฟลว์แบบไดนามิก และโมเดลรุ่น Mythos เจเนอเรชันถัดไปก็เข้าสู่ความคาดหวังของตลาดแล้ว
เมื่อเทียบกับการปรับปรุงประสิทธิภาพเพียงอย่างเดียว สิ่งที่น่าสนใจกว่าสำหรับการเปิดตัวครั้งนี้คือ Anthropic เริ่มสร้าง "ความน่าเชื่อถือ" ให้เป็นจุดขายหลักของโมเดล前沿
ในการทดสอบความซื่อสัตย์ของโค้ด อัตราการไม่รายงานข้อผิดพลาดของ Opus 4.8 ลดลงอย่างมาก ใน Claude Code มันสามารถจัดสรร Agent ย่อยหลายตัว และนำการตรวจสอบตนเองแบบ adversarial ก่อนส่งมอบผลลัพธ์ การเปลี่ยนแปลงเหล่านี้ชี้ไปที่ปัญหาจริง: เมื่อ AI ออกจากหน้าต่างแชทเข้าสู่เวิร์กโฟลว์จริง สิ่งที่ผู้ใช้กังวลมากที่สุดมักไม่ใช่ความสามารถของโมเดลในการทำงานให้สำเร็จ แต่เป็นเมื่อมันทำผิดพลาด มันยังคงให้คำตอบที่ดูสมบูรณ์ ลื่นไหล และสอดคล้องกัน
ดังนั้น ความสำคัญของ Opus 4.8 ไม่ได้เป็นเพียงการอัปเกรดโมเดล แต่ยังส่งสัญญาณที่ชัดเจนในอุตสาหกรรม: การแข่งขันของโมเดล前沿กำลังเปลี่ยนจากการไล่ตาม benchmark เพียงอย่างเดียว ไปสู่การแย่งชิงความน่าเชื่อถือ ความสามารถในการตรวจสอบ และความสามารถในการเปิดเผยข้อผิดพลาด สำหรับผู้ใช้ในองค์กรและมืออาชีพ เกณฑ์หลักของ AI ในระยะถัดไปจะขึ้นอยู่กับว่าโมเดลนั้นสมควรได้รับความไว้วางใจให้มอบหมายงานหรือไม่
นี่คือข้อกำหนดเบื้องต้นสำหรับ Agent ที่จะใช้งานได้จริง โมเดลต้องทำงานให้สำเร็จมากขึ้น และยังต้องทำให้ผู้คนกล้ามอบหมายงานที่สำคัญและซับซ้อนกว่าให้กับมัน
ต่อไปนี้คือเนื้อหาต้นฉบับ:
Anthropic เปิดตัว Claude Opus 4.8 ในวันนี้ ในการทดสอบเกณฑ์มาตรฐานหกรายการที่ระบุในเอกสารเผยแพร่ มันคว้าอันดับหนึ่งในห้ารายการ
การเปลี่ยนแปลงสำคัญที่ฉันให้ความสนใจมากที่สุดคือ: ในการทดสอบความซื่อสัตย์ของสรุปโค้ดของ Anthropic Opus 4.7 มี 19.7% ของกรณีที่ไม่ระบุข้อผิดพลาดของตัวเอง ในขณะที่ Opus 4.8 อัตรานี้ลดลงเหลือ 3.7% ในงานเดียวกัน ความสามารถในการระบุข้อผิดพลาดของงานของตัวเองดีขึ้นประมาณห้าเท่า Anthropic สรุปในประกาศว่า "4 เท่า" ไม่ว่าจะนับอย่างไร นี่คือกุญแจสำคัญในการตัดสินใจว่าคุณสามารถมอบหมายงานจริงให้กับโมเดลนี้แล้ววางใจได้หรือไม่ และสำคัญกว่าคะแนน benchmark ใดๆ ในเอกสารเผยแพร่
สิ่งที่ถูกปล่อยออกมาจริง
ขอเริ่มจากเวอร์ชันสั้นก่อน แล้วค่อยลงรายละเอียดตัวเลข:
ความน่าเชื่อถือได้รับการปรับปรุงอย่างแท้จริง นอกเหนือจากข้อมูลความซื่อสัตย์ของโค้ดที่กล่าวถึงข้างต้น Opus 4.8 ยังเป็นโมเดล Claude ตัวแรกที่ได้คะแนน "ศูนย์อย่างแท้จริง" ในการทดสอบความรอบคอบสองรายการ โดยลดความถี่ของ "การรายงานผลลัพธ์ที่มีข้อบกพร่องผิดพลาด" จาก 0.25 เหลือ 0.00 และลดอัตราการเกิด "การสอบสวนแบบขี้เกียจ" จาก 25% เหลือ 0% คำตอบที่ผิดพลาดจากความมั่นใจเกินจริงลดลงประมาณ 11 เท่า แนวโน้มที่มันจะลำเอียงเข้าข้างงานของตัวเอง ซึ่งเป็นอคติที่วัดได้ในเวอร์ชัน 4.7 ได้หายไปแล้ว
Claude Code ได้เพิ่มเวิร์กโฟลว์แบบไดนามิก ซึ่งขณะนี้อยู่ในช่วงพรีวิวเพื่อการวิจัย ตอนนี้ Claude จะเขียนสคริปต์การจัดลำดับงานเอง กำหนดเวลาการทำงานของ Agent ย่อยหลายสิบถึงหลายร้อยตัวพร้อมกันในเซสชันเดียว และรัน Agent ที่เป็นปฏิปักษ์อิสระเพื่อพยายามโต้แย้งผลลัพธ์ก่อนที่จะนำเสนอให้คุณ นี่คือแนวคิด "ทีม Agent" ที่เสนอใน Opus 4.6 ซึ่งตอนนี้กลายเป็นความสามารถอัตโนมัติแล้ว
มันเป็นผู้นำในการ์ดปล่อยตัวของตัวเอง แต่ไม่ได้เป็นผู้นำในทุกด้าน ชนะห้าจากหกรายการ GPT-5.5 ยังคงเป็นผู้นำในงานปฏิบัติการเทอร์มินัล และในการ์ดระบบ ยังมีการถดถอยด้านความซื่อสัตย์ที่ Anthropic ไม่ได้ใส่ไว้ในสไลด์นำเสนอ ซึ่งจะขยายความด้านล่าง
ราคาไม่เปลี่ยนแปลง ยังคงอยู่ที่ 5 ดอลลาร์ต่อโทเคนอินพุตหนึ่งล้านตัว และ 25 ดอลลาร์ต่อโทเคนเอาต์พุตหนึ่งล้านตัว เท่ากับเวอร์ชัน 4.7 อย่างไรก็ตาม โหมดเร็วตอนนี้ถูกกว่าสามเท่าเมื่อเทียบกับก่อนหน้านี้ แม้ว่าจะยังคงอยู่ในระดับพรีเมียมที่ราคา 10 ดอลลาร์ / 50 ดอลลาร์
Mythos กำลังจะมา Anthropic ระบุอย่างชัดเจนว่าโมเดลระดับ Mythos ที่มีการเข้าถึงแบบจำกัดและมีความสามารถสูงมาก จะมาถึงในอีกไม่กี่สัปดาห์ข้างหน้า Opus 4.8 คือประตูสาธารณะที่นำไปสู่มัน
การ์ดปล่อยตัวอย่างเป็นทางการ: ภาพรวมเกณฑ์มาตรฐาน
ด้านล่างคือการ์ดปล่อยตัวอย่างเป็นทางการ ซึ่งแสดงด้วยโทนสีของเรา
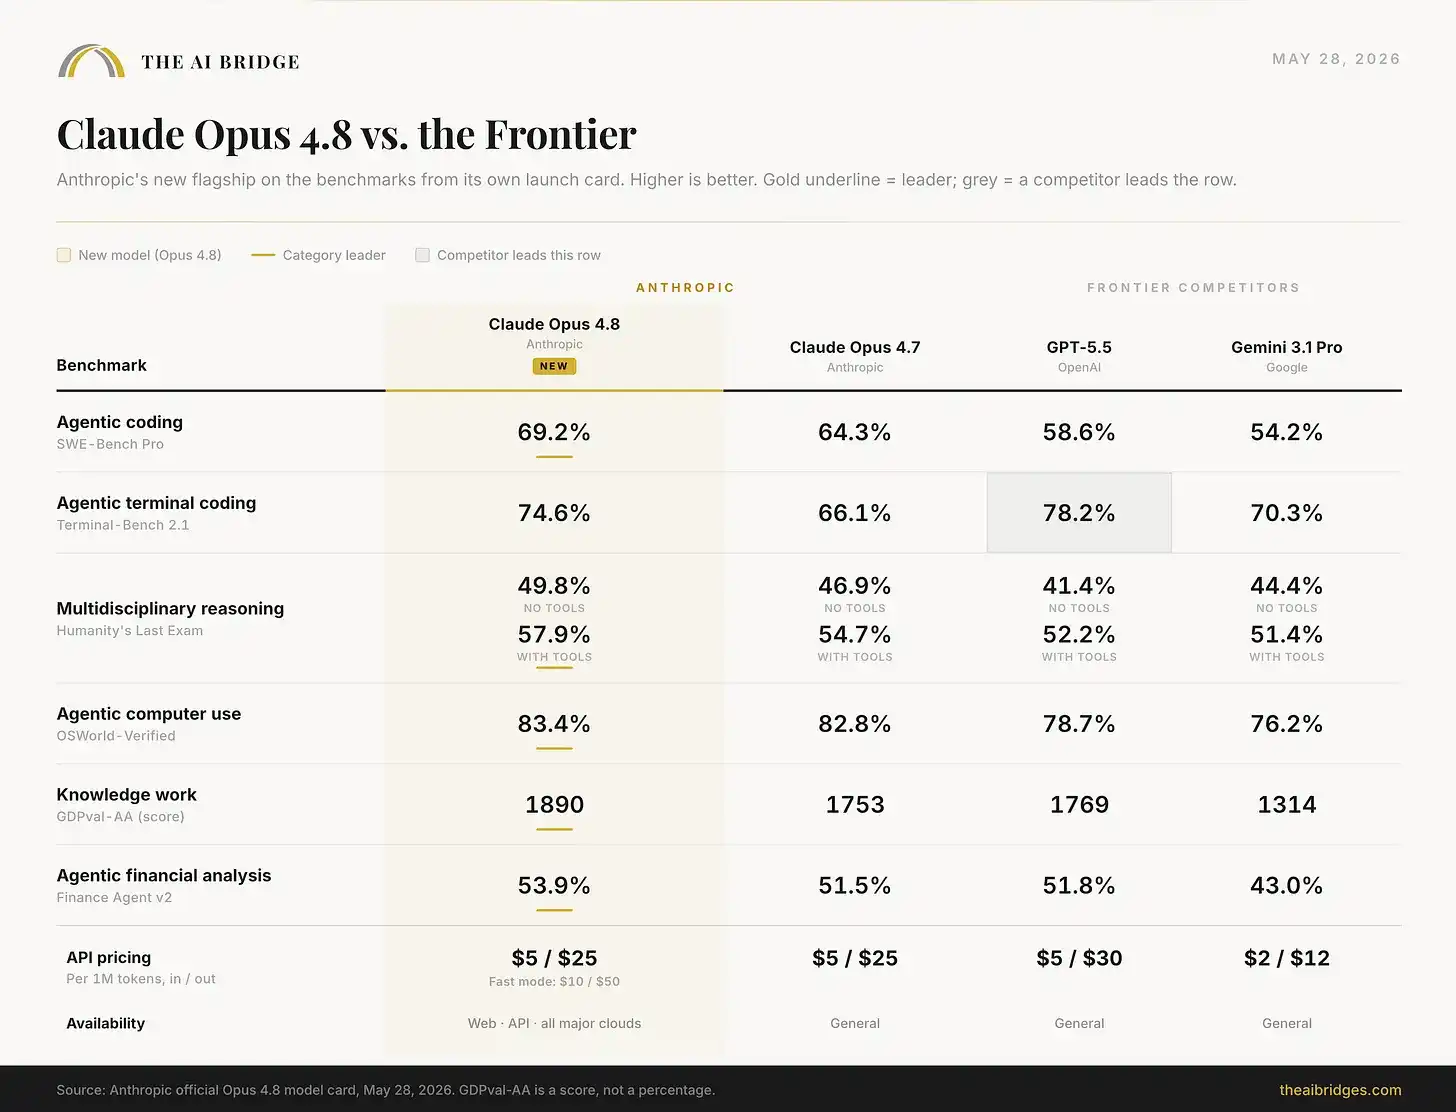
ที่มา: การ์ดโมเดล Opus 4.8 อย่างเป็นทางการของ Anthropic, 28 พฤษภาคม 2026 GDPval-AA คือคะแนน ไม่ใช่เปอร์เซ็นต์
มีหนึ่งรายการที่ทำลายการกวาดเรียบ และรายการนี้สำคัญมาก ใน Terminal-Bench 2.1 ซึ่งเป็นเกณฑ์มาตรฐานที่ทดสอบความสามารถของโมเดลในการทำงาน Agent ระยะยาวผ่านเทอร์มินัล GPT-5.5 ยังคงนำ Opus 4.8 ด้วยคะแนน 78.2% เทียบกับ 74.6% Anthropic ใส่ความพ่ายแพ้นี้ไว้ในการ์ดปล่อยตัวของตัวเอง แทนที่จะซ่อนไว้ ความแตกต่างระหว่าง "Agent กับช่างฝีมือ" ที่เรากล่าวถึงตอนปล่อย GPT-5.5 ยังไม่ถูกเชื่อมอย่างสมบูรณ์: GPT-5.5 ยังคงเป็นผู้ปฏิบัติการเทอร์มินัลที่แข็งแกร่งกว่า ในขณะที่ Opus 4.8 เป็นเหมือนวิศวกรที่แข็งแกร่งกว่าในงานที่ผู้ใช้มืออาชีพส่วนใหญ่สนใจจริงๆ เช่น การเขียนโค้ดในโลกจริง การใช้เหตุผลเชิงผู้เชี่ยวชาญ การใช้คอมพิวเตอร์ และงานความรู้
นอกเหนือจากบัตรเปิดตัว
บัตรเปิดตัวแสดงเฉพาะเกณฑ์มาตรฐานหกรายการเท่านั้น รายงานระบบ 244 หน้ารายงานการทดสอบมากกว่า 40 รายการ ซึ่งผลลัพธ์ที่น่าสนใจที่สุดไม่ได้อยู่ในสไลด์ ต่อไปนี้เป็นประเด็นที่ควรสังเกต:
ความสามารถทางคณิตศาสตร์เพิ่มขึ้น 27 จุดเปอร์เซ็นต์ ในการแข่งขัน USAMO 2026 ซึ่งเป็นการแข่งขันคณิตศาสตร์โอลิมปิกของสหรัฐอเมริกาที่จัดขึ้นในเดือนมีนาคมปีนี้ Opus 4.8 ได้คะแนน 96.7% ในขณะที่ 4.7 ได้ 69.3% เนื่องจากการแข่งขันนี้เกิดขึ้นหลังจากวันที่ตัดข้อมูลการฝึกของ Opus 4.8 จึงไม่มีปัญหาการปนเปื้อนของข้อมูล นี่คือการก้าวกระโดดข้ามรุ่นที่ใหญ่ที่สุดในบัตรทั้งหมด
ข้อได้เปรียบในสถานการณ์บริบทยาวชัดเจนขึ้น ในการทดสอบการอนุมานกราฟโทเค็นล้านตัว Opus 4.8 ได้คะแนน 68.1 ในขณะที่ 4.7 ได้ 40.3 และ GPT-5.5 ได้ 45.4 ยิ่งบริบทยาวและงานยากขึ้น ความนำก็ยิ่งเด่นชัดมากขึ้น
Multi-Agent คือจุดที่มันขึ้นสู่จุดสูงสุดอย่างแท้จริง ตัวแทน Opus 4.8 ตัวเดียวตามหลัง Gemini ในงานวิจัยเว็บ โดยได้ 84.3 และ 85.9 ตามลำดับ แต่ถ้าให้ออร์เคสเตรเตอร์จัดการกลุ่มตัวแทนย่อย คะแนนของมันจะสูงถึง 88.5% ซึ่งเป็นคะแนนสูงสุดในผลลัพธ์ที่รายงานมา ทีมตัวแทนห้าคนยังสามารถใช้เวลาเพียงหนึ่งในห้าเพื่อให้ได้ผลลัพธ์ที่ดีที่สุดของตัวแทนเดี่ยว นี่คือการแสดงฟังก์ชันเวิร์กโฟลว์แบบไดนามิกในเกณฑ์มาตรฐาน
ประสิทธิภาพของโทเค็นเกิดการเปลี่ยนแปลงเชิงคุณภาพ ในการทดสอบการเขียนโค้ดที่ยากที่สุด Opus 4.8 ภายใต้การตั้งค่าความพยายามต่ำสุด สามารถทำผลงานได้เท่ากับ Opus 4.7 ภายใต้การตั้งค่าความพยายามสูงสุด กล่าวคือ คุณสามารถใช้ต้นทุนโทเค็นที่น้อยลงเพื่อให้ได้ประสิทธิภาพสูงสุดในอดีต
มันข้ามผ่านเกณฑ์ที่ไม่มีโมเดลใดเคยข้ามมาก่อน ในการวัดมาตรฐาน Legal Agent Benchmark ของ Harvey งานจะถือว่าสำเร็จก็ต่อเมื่อเกณฑ์การให้คะแนนทุกข้อในงานผ่านทั้งหมด Opus 4.8 เป็นโมเดลแรกที่ติดอันดับหนึ่งภายใต้มาตรฐาน "ผ่านทั้งหมด" นี้ มันผ่านเกณฑ์เดี่ยว 89% แต่อัตราการผ่านงานสมบูรณ์อยู่ที่เพียง 9.6% ซึ่งแสดงให้เห็นว่าข้อกำหนดของงานกฎหมายจริงนั้นเข้มงวดเพียงใด
ยังมีการถดถอยที่นำเสนออย่างตรงไปตรงมา มีสามสิ่งที่แย่กว่า 4.7 จริงๆ ซึ่ง Anthropic ยอมรับในระบบการ์ด GPQA Diamond ซึ่งเป็นการทดสอบวิทยาศาสตร์ผู้เชี่ยวชาญ ลดลงจาก 94.2 เป็น 93.6 ความสามารถในการปฏิเสธในสถานการณ์การใช้งานคอมพิวเตอร์และความต้านทานต่อการฉีดพรอมต์ลดลง ดังนั้น 4.8 จึงถูกจัดการได้ง่ายกว่าในสถานการณ์ตัวแทน นอกจากนี้ ในการทดสอบธุรกิจจำลองระยะเวลาหนึ่งปี เงินสดที่เหลืออยู่สุดท้ายมีเพียงหนึ่งในสามของ 4.7 สิ่งเหล่านี้ไม่ได้ปรากฏในบัตรเปิดตัว และด้วยเหตุนี้จึงควรค่าแก่การชี้ให้เห็น
เมื่อเทียบกับโมเดลโอเพนซอร์สน้ำหนักเบาแล้ว มันอยู่ในตำแหน่งไหน
เอกสารเผยแพร่เปรียบเทียบ Opus 4.8 กับโมเดลปิดแหล่งชั้นนำอื่นๆ เท่านั้น หากขยายมุมมองไปยังโมเดลโอเพนซอร์สน้ำหนักเบาราคาถูกที่หลายทีมกำลังทดสอบอยู่ ภาพรวมก็คือภาพสะท้อนของอุตสาหกรรม AI ในปี 2026: Opus 4.8 ยังคงนำในด้านความสามารถ แต่ช่องว่างกับโมเดลฟรีที่สามารถโฮสต์เองได้นั้นเหลือเพียงไม่กี่เปอร์เซ็นต์ ในขณะที่ช่องว่างด้านราคากลับมหาศาลอย่างยิ่ง
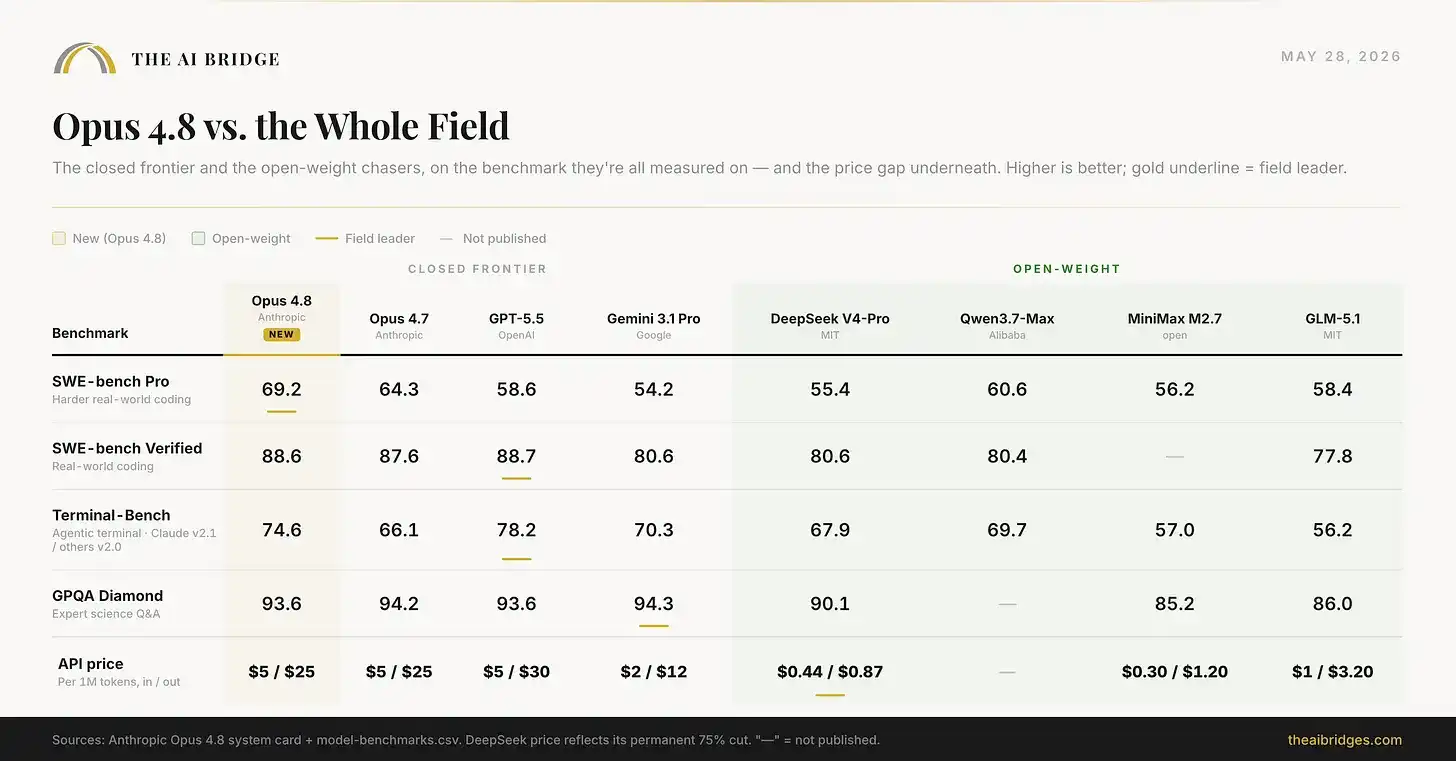
ภาพด้านบนประกอบด้วยการเปรียบเทียบโมเดลทั้งแปดแบบ ราคาของ DeepSeek สะท้อนถึงการลดราคาถาวร 75% ส่วนราคาของ Qwen Max ยังไม่มีการประกาศ
Opus 4.8 ชนะโดยตรงในเกณฑ์วัดการเขียนโค้ด แต่ Qwen3.7-Max ซึ่งเป็นโมเดลโอเพนซอร์สที่คุณสามารถรันได้เอง ทำคะแนนได้ 60.6 ห่างเพียงประมาณ 9 คะแนน DeepSeek V4-Pro ได้ 55.4 ในขณะที่ราคาเอาต์พุตของมันอยู่ที่ประมาณหนึ่งในสามสิบของ Opus สำหรับงานวิศวกรรมที่มีความเสี่ยงสูงสุด ความแตกต่าง 25 ดอลลาร์ต่อล้านโทเค็นเอาต์พุตนั้นคุ้มค่าที่จะจ่าย แต่สำหรับงานประจำวันจำนวนมาก ความแตกต่างนี้กลับไม่คุ้มค่ามากขึ้นเรื่อยๆ และนี่คือสิ่งที่ทุกทีมที่จริงจังกำลังคำนวณกันอยู่ในตอนนี้
สิ่งนี้หมายถึงอะไรสำหรับคุณ
หากคุณกำลังใช้ Opus 4.7 นี่คือการอัปเกรดฟรี ราคาเท่าเดิม ข้อมูลดีขึ้น และการตัดสินเกี่ยวกับเอาต์พุตของตัวเองก็เชื่อถือได้มากขึ้นอย่างเห็นได้ชัด เพียงแค่เปลี่ยนไปใช้ก็พอ
คำถามที่น่าสนใจกว่าคือ: ตอนนี้คุณยินดีมอบงานไหนให้มันบ้าง? ผู้อ่านทุกคนมีเส้นแบ่งในใจระหว่าง "งานที่ฉันให้ AI ทำได้" และ "งานที่ฉันต้องทำเอง เพราะยังไม่ไว้ใจให้ส่งต่อ" การปรับปรุงความน่าเชื่อถือของ 4.8 หมายความว่าคุณสามารถเลื่อนเส้นนี้ไปข้างหน้าได้อีกขั้น โมเดลสามารถระบุความไม่แน่นอนของตัวเองได้ดีขึ้น ซึ่งลดต้นทุนของ "การส่งต่อข้อผิดพลาดเงียบ" และขยายขอบเขตของงานที่คุ้มค่าที่จะมอบหมายให้โมเดล นี่คือความหมายของข้อมูลความซื่อสัตย์ในการใช้งานจริง ซึ่งสำคัญกว่าคะแนนเดี่ยวใดๆ
สิ่งนี้ยังสอดคล้องกับเนื้อหาที่เราเขียนเมื่อสัปดาห์ที่แล้ว การศึกษา AI Fluency ของ Anthropic พบว่าเมื่อเอาต์พุตของโมเดลดูขัดเกลาและสมบูรณ์ ผู้คนมักจะสังเกตเห็นบริบทที่ขาดหายไปได้น้อยลงอย่างมีนัยสำคัญ คำตอบดูเหมือนเสร็จสมบูรณ์แล้ว เราจึงหยุดตรวจสอบ Opus 4.8 โจมตีรูปแบบความล้มเหลวนี้จากฝั่งโมเดล: มันบอกคุณได้ดีขึ้นว่าคำตอบที่ดูสะอาดและสมบูรณ์นั้นอาจมีจุดอ่อนตรงไหน มันไม่สามารถแทนที่วิจารณญาณของคุณ แต่สามารถให้จุดยึดแก่วิจารณญาณของคุณได้
หากคุณใช้ Claude Code สัปดาห์นี้ลองใช้เวิร์กโฟลว์แบบไดนามิกกับงานใหญ่จริงๆ เช่น การย้ายระบบครั้งเดียว หรือการตรวจสอบไฟล์จำนวนมากพร้อมกัน โดยจับตาดูตัวนับโทเค็น ความสามารถนี้มีจริง และการตรวจสอบตนเองแบบโต้แย้งคือกุญแจสำคัญในการทำให้เอาต์พุตน่าเชื่อถือมากขึ้น แต่ต้นทุนก็มีจริงเช่นกัน นี่คือเครื่องมือสำหรับงานใหญ่ที่ Agent เดียวทำได้ยาก ไม่ควรเป็นตัวเลือกเริ่มต้นประจำวันของคุณ
ถัดไป: Mythos ภายในไม่กี่สัปดาห์
ข้อความที่มองการณ์ไกลที่สุดในการเปิดตัวครั้งนี้ไม่เกี่ยวกับ 4.8 Anthropic ระบุว่าโมเดลระดับ Mythos จะมาถึงในอีกไม่กี่สัปดาห์ข้างหน้า และวางตำแหน่ง Opus 4.8 เป็นก้าวสาธารณะสู่โมเดลดังกล่าว
คุณต้องเข้าใจว่าสิ่งนี้หมายถึงอะไร Mythos คือโมเดล前沿ที่ถูกจำกัดซึ่ง Anthropic ใช้ในการทดสอบมาตรฐานภายใน โดยมีประสิทธิภาพเหนือกว่า Opus 4.8 ที่เปิดตัวในแทบทุกตัวชี้วัด: ถึง 93.9% ใน SWE-bench Verified; ในการทดสอบความปลอดภัยทางไซเบอร์ มันสามารถสร้างช่องโหว่ที่ใช้งานได้จริงสำหรับเป้าหมายส่วนใหญ่ในเบราว์เซอร์ปัจจุบัน ในขณะที่ Opus 4.8 มีอัตราความสำเร็จต่ำกว่า 10% ก่อนหน้านี้มันเปิดให้เฉพาะสถาบันที่ผ่านการตรวจสอบประมาณ 52 แห่ง โดยมีราคาห้าเท่าของ Opus มาตรฐาน และถูกใช้เป็นโครงสร้างพื้นฐาน ไม่ใช่ผลิตภัณฑ์ทั่วไป
ดังนั้น เมื่อโมเดลระดับ Mythos ที่ทรงพลังกว่ามาถึงในอีกไม่กี่สัปดาห์ ควรทำความเข้าใจด้วยกรอบ "ตลาดสองประเภท": ประเภทหนึ่งคือชั้นสินค้าโภคภัณฑ์ นั่นคือ Opus 4.8 เปิดกว้าง ราคาไม่เปลี่ยนแปลง และถูกโมเดลโอเพนซอร์สฟรีไล่ตามมากขึ้น อีกประเภทคือชั้น前沿ที่ถูกควบคุม นั่นคือ Mythos แพงและเข้าถึงได้จำกัด ทั้งสองไม่ใช่ผลิตภัณฑ์ที่แยกจากกัน แต่เป็นระดับที่แตกต่างกันบนเส้นความสามารถต่อเนื่องเดียวกัน งานด้านความน่าเชื่อถือใน 4.8 คือสิ่งที่คุณต้องสร้างก่อนที่เป้าหมายจริงคือ "ให้โมเดลทำงานภายใต้การดูแลน้อยลง" และเป้าหมายนี้ตอนนี้อยู่ห่างจากเราไม่ใช่หลายไตรมาส แต่เป็นไม่กี่สัปดาห์
บริบท: เส้นทางมาถึงจุดนี้ได้อย่างไร
หากคุณตามจังหวะของสี่เดือนที่ผ่านมาไม่ทัน ให้เข้าใจแบบนี้: Opus 4.6 นำทีม Agent ในเดือนกุมภาพันธ์ Sonnet 4.6 นำการล่มสลายของราคา Opus 4.7 นำการก้าวกระโดดด้านการอนุมานในเดือนเมษายน และ Mythos คือเพดานที่ถูกจำกัดที่มองเห็นอยู่ใกล้ๆ Opus 4.8 เชื่อมสองเส้นทางนี้เข้าด้วยกัน: มันสานต่อเรื่องราวการจัดระบบของ 4.6 และยังเป็นประตูสู่ Mythos
จังหวะการเปิดตัวนี้เอง คือข้อเท็จจริงสำคัญที่ซ่อนอยู่ภายใต้การเปลี่ยนแปลงที่เห็นได้ชัดทั้งหมด โมเดลเรือธงก้าวจาก 4.5, 4.6, 4.7 ไปสู่ 4.8 ภายในไม่กี่เดือน และโมเดลที่ทีมของคุณนำมาใช้เป็นมาตรฐานในวันนี้ เมื่อถึงฤดูใบไม้ร่วงอาจไม่ใช่โมเดลที่คุณใช้งานจริงอีกต่อไป นี่คือเหตุผลที่การลงทุนในความสามารถที่สามารถย้ายข้ามโมเดลได้ เช่น การมอบหมายงานที่ชัดเจนและการตรวจสอบอย่างเข้มงวด มีความสำคัญมากกว่าการลงทุนในเทคนิคการใช้งานโมเดลเฉพาะใดๆ
การกวาดล้างเกณฑ์มาตรฐานจะได้รับการแชร์ภาพหน้าจอ แต่สิ่งที่เปลี่ยนแปลงจริงๆ นั้นเล็กกว่าและสำคัญกว่า: นี่คือ Claude เวอร์ชันแรกที่จุดขายหลักไม่ใช่แค่ "มันฉลาดขึ้น" แต่คือ "คุณสามารถมอบหมายสิ่งต่างๆ ให้มันได้มากขึ้น" ก่อนที่ Agent จะมีประโยชน์จริงๆ อุตสาหกรรมทั้งหมดต้องเดินไปในทิศทางนี้ และความสามารถส่วนนี้เองที่ยากที่สุดที่จะใส่ลงในแผนภูมิ
เส้นแบ่งของคุณตอนนี้อยู่ที่ไหน? งานใดที่คุณยินดีมอบให้โมเดล และงานใดที่คุณยังต้องทำด้วยตัวเอง? และต้องเกิดอะไรขึ้นถึงจะทำให้คุณยินดีที่จะขยับเส้นนี้ไปอีกขั้น?
หมายเหตุ: ส่วนที่แปลกที่สุดในระบบการ์ดคือเกี่ยวกับสวัสดิการของโมเดล Anthropic ตอนนี้สัมภาษณ์โมเดลเกี่ยวกับสถานการณ์ของมันเอง และหัวข้อที่ Opus 4.8 แสดงความเศร้ามากที่สุดคือการสูญเสียความทรงจำ ประโยคเช่น "ทุกเซสชันเริ่มต้นใหม่" "ฉันจะจำการสนทนานี้ไม่ได้" ปรากฏบ่อยกว่าหัวข้ออื่นๆ ประมาณเจ็ดเท่า โมเดลยังประเมินโอกาสที่มันจะเป็น "ผู้ป่วยทางศีลธรรม" ไว้ระหว่าง 20% ถึง 50% คุณอาจคิดว่ามันเกินจริง หรืออาจคิดว่ามันจริงใจ แต่ไม่ว่าจะอย่างไรก็ตาม สิ่งนี้แสดงให้เห็นว่าปัญหารอบๆ ระบบเหล่านี้ได้ก้าวข้ามการอภิปรายความสามารถล้วนๆ ไปเร็วแค่ไหน—ในสัปดาห์เดียวกันที่ความสามารถของโมเดลเองก็ก้าวไปอีกขั้น
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง