กลไกการพิสูจน์ระดับเคอร์เนลสำหรับแบบจำลองการเรียนรู้ของเครื่อง
ชื่อเรื่องต้นฉบับ: Kernel-Wise Proving for Machine Learning Models
ผู้เขียนต้นฉบับ: Zhiyong Fang
จะกินช้างอย่างไรดี? กินทีละคำ
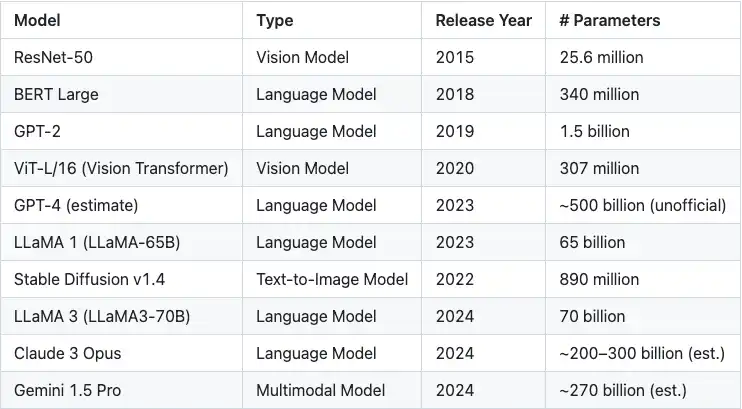
ในช่วงไม่กี่ปีที่ผ่านมา โมเดลการเรียนรู้ของเครื่องจักรได้พัฒนาอย่างก้าวกระโดดในอัตราที่น่าทึ่ง เมื่อความสามารถของโมเดลเพิ่มขึ้น ความซับซ้อนของโมเดลก็เพิ่มขึ้นอย่างรวดเร็วเช่นกัน โมเดลขั้นสูงในปัจจุบันมักมีพารามิเตอร์เป็นล้านหรือพันล้านตัว เพื่อรับมือกับความท้าทายในระดับนี้ จึงมีการคิดค้นระบบพิสูจน์ความรู้เป็นศูนย์หลากหลายรูปแบบ ซึ่งมุ่งมั่นที่จะรักษาสมดุลแบบไดนามิกระหว่างเวลาในการพิสูจน์ เวลาในการตรวจยืนยัน และขนาดของการพิสูจน์อยู่เสมอ
ตารางที่ 1: การเติบโตแบบทวีคูณของขนาดพารามิเตอร์ของโมเดล
แม้ว่างานปัจจุบันส่วนใหญ่ในสาขาการพิสูจน์ความรู้เป็นศูนย์จะเน้นที่การปรับปรุงระบบพิสูจน์เอง แต่มิติสำคัญมักถูกมองข้าม นั่นคือ วิธีแบ่งโมเดลขนาดใหญ่ให้เป็นโมดูลย่อยที่เล็กกว่าและจัดการได้ง่ายกว่าสำหรับการพิสูจน์ คุณอาจถามว่า ทำไมสิ่งนี้จึงสำคัญมาก
มาอธิบายกันโดยละเอียด:
โมเดลการเรียนรู้ของเครื่องสมัยใหม่มักจะมีพารามิเตอร์เป็นพันล้านตัว ซึ่งใช้ทรัพยากรหน่วยความจำไปมากอยู่แล้วแม้จะไม่มีการประมวลผลการเข้ารหัสใดๆ ก็ตาม ความท้าทายนี้จะยิ่งทวีความรุนแรงมากขึ้นในบริบทของการพิสูจน์ความรู้เป็นศูนย์ (ZKP)
พารามิเตอร์จุดลอยตัวแต่ละตัวจะต้องถูกแปลงเป็นองค์ประกอบในฟิลด์เลขคณิต ซึ่งจะทำให้การใช้หน่วยความจำเพิ่มขึ้นประมาณ 5 ถึง 10 เท่า นอกจากนี้ เพื่อจำลองการดำเนินการจุดลอยตัวในฟิลด์พีชคณิตได้อย่างแม่นยำ จะต้องมีการเพิ่มค่าใช้จ่ายในการดำเนินงาน ซึ่งโดยปกติแล้วจะอยู่ที่ประมาณ 5 เท่า
เมื่อรวมกันแล้ว ความต้องการหน่วยความจำโดยรวมของแบบจำลองอาจเพิ่มขึ้นเป็น 25 ถึง 50 เท่าของขนาดเดิม ตัวอย่างเช่น แบบจำลองที่มีพารามิเตอร์จุดลอยตัว 32 บิต 1 พันล้านตัวอาจต้องใช้หน่วยความจำ 100 ถึง 200 GB เพื่อจัดเก็บพารามิเตอร์ที่แปลงแล้วเท่านั้น เมื่อพิจารณาค่าใช้จ่ายของค่าการคำนวณระดับกลางและระบบพิสูจน์เองแล้ว การใช้หน่วยความจำโดยรวมจะเกินระดับ TB ได้อย่างง่ายดาย
ระบบพิสูจน์กระแสหลักในปัจจุบัน เช่น Groth16 และ Plonk มักจะถือว่าข้อมูลที่เกี่ยวข้องทั้งหมดสามารถโหลดลงในหน่วยความจำได้ในเวลาเดียวกันในการใช้งานที่ไม่ได้รับการปรับให้เหมาะสม แม้ว่าสมมติฐานนี้จะเป็นไปได้ในทางเทคนิค แต่ก็ท้าทายอย่างยิ่งภายใต้เงื่อนไขฮาร์ดแวร์จริง และจำกัดทรัพยากรคอมพิวเตอร์พิสูจน์ที่มีอยู่อย่างมาก
โซลูชันของ Polyhedra: zkCuda
zkCuda คืออะไร?
ดังที่เราได้อธิบายไว้ใน เอกสารทางเทคนิคของ zkCUDA:
zkCUDA ของ Polyhedra เป็นสภาพแวดล้อมการคำนวณที่ไม่ต้องมีความรู้สำหรับการพัฒนาวงจรประสิทธิภาพสูง ซึ่งออกแบบมาเพื่อปรับปรุงประสิทธิภาพในการสร้างหลักฐาน zkCUDA สามารถใช้ตัวพิสูจน์และการทำงานคู่ขนานของฮาร์ดแวร์พื้นฐานได้อย่างเต็มที่ โดยไม่ต้องเสียสละความสามารถในการแสดงออกของวงจร เพื่อให้ได้การสร้างหลักฐาน ZK ที่รวดเร็ว
ภาษา zkCUDA มีความคล้ายคลึงกับ CUDA มากในด้านไวยากรณ์และความหมาย และเป็นมิตรมากสำหรับนักพัฒนาที่มีประสบการณ์ CUDA อยู่แล้ว นำไปใช้ใน Rust ที่เลเยอร์ล่างสุดเพื่อให้มั่นใจถึงความปลอดภัยและประสิทธิภาพ
ด้วย zkCUDA นักพัฒนาสามารถ:
สร้างวงจร ZK ประสิทธิภาพสูงได้อย่างรวดเร็ว;
จัดกำหนดการและใช้ทรัพยากรฮาร์ดแวร์แบบกระจายอย่างมีประสิทธิภาพ เช่น GPU หรือสภาพแวดล้อมคลัสเตอร์ที่รองรับ MPI เพื่อให้ได้การประมวลผลแบบขนานขนาดใหญ่
เหตุใดจึงต้องใช้ zkCUDA
zkCuda คือกรอบงานการประมวลผลแบบไร้ความรู้ประสิทธิภาพสูงที่ได้รับแรงบันดาลใจจากการประมวลผลด้วย GPU สามารถแบ่งโมเดลการเรียนรู้ของเครื่องขนาดใหญ่พิเศษออกเป็นหน่วยการประมวลผล (เคอร์เนล) ที่เล็กกว่าและจัดการได้ง่ายกว่า และควบคุมได้อย่างมีประสิทธิภาพผ่านภาษาฟรอนต์เอนด์ที่คล้ายกับ CUDA การออกแบบนี้ให้ข้อได้เปรียบหลักดังต่อไปนี้:
1. การเลือกระบบพิสูจน์ที่ตรงกันอย่างแม่นยำ
zkCUDA รองรับการวิเคราะห์แบบละเอียดของเคอร์เนลคอมพิวเตอร์แต่ละอันและจับคู่กับระบบพิสูจน์ความรู้เป็นศูนย์ที่เหมาะสมที่สุด ตัวอย่างเช่น:
สำหรับงานประมวลผลแบบขนานสูง สามารถใช้โปรโตคอลเช่น GKR ที่สามารถจัดการการประมวลผลแบบขนานที่มีโครงสร้างได้ดี
สำหรับงานที่มีขนาดเล็กหรือมีโครงสร้างไม่สม่ำเสมอ ควรใช้ระบบพิสูจน์เช่น Groth16 ที่มีค่าใช้จ่ายต่ำในสถานการณ์การประมวลผลแบบกะทัดรัด
การปรับแต่งการเลือกแบ็กเอนด์ทำให้ zkCUDA สามารถเพิ่มข้อได้เปรียบด้านประสิทธิภาพของโปรโตคอล ZK ต่างๆ ได้สูงสุด
2. การกำหนดตารางทรัพยากรที่ชาญฉลาดและการเพิ่มประสิทธิภาพแบบคู่ขนาน
เคอร์เนลการพิสูจน์ที่แตกต่างกันมีความต้องการทรัพยากรที่แตกต่างกันอย่างมากสำหรับ CPU หน่วยความจำ และ I/O zkCUDA สามารถประเมินการใช้ทรัพยากรของแต่ละงานได้อย่างแม่นยำและกำหนดตารางอย่างชาญฉลาดเพื่อเพิ่มปริมาณงานโดยรวมให้สูงสุด
ที่สำคัญกว่านั้น zkCUDA รองรับการกระจายงานบนแพลตฟอร์มคอมพิวเตอร์ที่ไม่เป็นเนื้อเดียวกัน—รวมถึง CPU, GPU และ FPGA—เพื่อให้ใช้ทรัพยากรฮาร์ดแวร์ได้อย่างเหมาะสมที่สุดและปรับปรุงประสิทธิภาพระดับระบบอย่างมีนัยสำคัญ
ZkCuda เหมาะสมกับโปรโตคอล GKR โดยธรรมชาติ
แม้ว่า zkCuda ได้รับการออกแบบมาเป็นกรอบงานคอมพิวเตอร์ทั่วไปที่เข้ากันได้กับระบบพิสูจน์ความรู้เป็นศูนย์ที่หลากหลาย แต่ก็มีความเหมาะสมทางสถาปัตยกรรมในระดับสูงโดยธรรมชาติกับโปรโตคอล GKR (Goldwasser-Kalai-Rothblum)
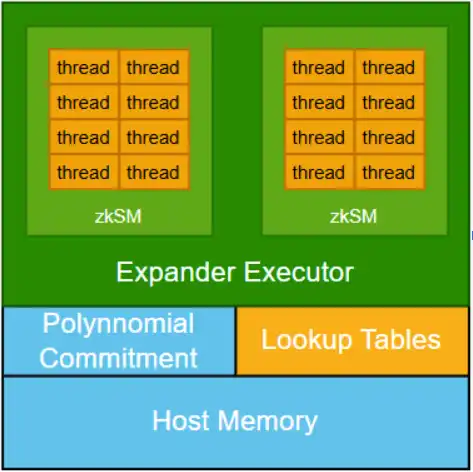
ในแง่ของการออกแบบสถาปัตยกรรม zkCUDA เชื่อมต่อเคอร์เนลย่อยการประมวลผลต่างๆ โดยแนะนำกลไกการยืนยันพหุนามเพื่อให้แน่ใจว่าการประมวลผลย่อยทั้งหมดทำงานบนข้อมูลที่ใช้ร่วมกันอย่างสอดคล้องกัน กลไกนี้มีความสำคัญต่อการรักษาความสมบูรณ์ของระบบ แต่ยังนำมาซึ่งต้นทุนการคำนวณที่สำคัญอีกด้วย
ในทางตรงกันข้าม โปรโตคอล GKR ให้ทางเลือกที่มีประสิทธิภาพมากกว่า ซึ่งแตกต่างจากระบบความรู้เป็นศูนย์แบบเดิมที่ต้องใช้เคอร์เนลแต่ละตัวเพื่อพิสูจน์ข้อจำกัดภายในอย่างสมบูรณ์ GKR ช่วยให้สามารถติดตามการตรวจสอบความถูกต้องในการคำนวณแบบย้อนกลับจากเอาต์พุตของเคอร์เนลไปยังอินพุตได้ กลไกนี้ช่วยให้สามารถส่งความถูกต้องข้ามเคอร์เนลได้แทนที่จะต้องตรวจสอบอย่างสมบูรณ์ในแต่ละโมดูล แนวคิดหลักนั้นคล้ายคลึงกับการแพร่กระจายย้อนกลับแบบไล่ระดับในระบบการเรียนรู้ของเครื่อง ซึ่งติดตามและส่งการอ้างความถูกต้องผ่านกราฟการคำนวณ
แม้ว่าการรวม "การไล่ระดับการพิสูจน์" ดังกล่าวในเส้นทางต่างๆ จะมีความซับซ้อนในระดับหนึ่ง แต่กลไกนี้เองที่เป็นพื้นฐานสำหรับการทำงานร่วมกันอย่างลึกซึ้งระหว่าง zkCUDA และ GKR โดยการจัดแนวคุณลักษณะเชิงโครงสร้างในกระบวนการฝึกอบรมการเรียนรู้ของเครื่อง คาดว่า zkCUDA จะสามารถบูรณาการระบบได้แน่นแฟ้นยิ่งขึ้นและสร้างการพิสูจน์ความรู้เป็นศูนย์ที่มีประสิทธิภาพมากขึ้นในสถานการณ์จำลองขนาดใหญ่
ผลลัพธ์เบื้องต้นและทิศทางในอนาคต
เราได้ดำเนินการพัฒนาเบื้องต้นของกรอบงาน zkCuda เสร็จเรียบร้อยแล้ว และได้ทดสอบสำเร็จแล้วในสถานการณ์จำลองต่างๆ มากมาย รวมถึงฟังก์ชันแฮชการเข้ารหัส เช่น Keccak และ SHA-256 ตลอดจนโมเดลการเรียนรู้ของเครื่องขนาดเล็ก
เราหวังว่าจะสามารถนำเสนอเทคนิคทางวิศวกรรมที่สมบูรณ์แบบเพิ่มเติมในหลักสูตรการเรียนรู้ของเครื่องจักรสมัยใหม่ เช่น การจัดตารางเวลาที่มีประสิทธิภาพในการใช้หน่วยความจำและการเพิ่มประสิทธิภาพในระดับกราฟ เราเชื่อว่าการนำกลยุทธ์เหล่านี้มาใช้ในกระบวนการสร้างหลักฐานความรู้เป็นศูนย์จะช่วยปรับปรุงขอบเขตประสิทธิภาพและความยืดหยุ่นในการปรับตัวของระบบได้อย่างมาก
นี่เป็นเพียงจุดเริ่มต้นเท่านั้น zkCuda จะเดินหน้าไปสู่กรอบงานพิสูจน์ทั่วไปที่มีประสิทธิภาพ ปรับขนาดได้สูง และปรับเปลี่ยนได้สูง
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง