OpenLoRA ของ OpenLedger: รูปแบบใหม่สำหรับโมเดล AI แบบกระจายอำนาจที่ให้บริการ
ในเมทริกซ์เทคโนโลยีเชิงนวัตกรรม OpenLoRA ถือเป็นความก้าวหน้าครั้งใหญ่ โดยกรอบการทำงานที่ให้บริการโมเดลนี้จะนิยามประสิทธิภาพ ความสามารถในการปรับขนาด และความคุ้มทุนของการปรับแต่งโมเดล AI ใหม่ แต่เพื่อจะเข้าใจความสำคัญของ OpenLoRA เราก็ต้องตรวจสอบข้อบกพร่องในระบบโครงสร้างพื้นฐาน AI ปัจจุบันเสียก่อน
จุดเจ็บปวดหลัก: AI แบบรวมศูนย์และคอขวดในการใช้เหตุผล
แม้ว่าแอปพลิเคชัน AI จะเร่งตัวขึ้นในอุตสาหกรรมต่างๆ แต่ส่วนใหญ่แล้วนวัตกรรมต่างๆ ยังคงถูกผูกขาดโดยการรวมศูนย์ โดยทั่วไปโมเดล AI ได้รับการฝึกอบรมและใช้งานโดยบริษัทยักษ์ใหญ่ด้านเทคโนโลยี โดยปิดการทำงานผ่าน API ส่วนตัว ชุดข้อมูลการฝึกอบรมของพวกเขาไม่โปร่งใสและกลไกการระบุค่าไม่สามารถติดตามได้
ที่สำคัญยิ่งกว่านั้น เนื่องจากการปรับแต่งโมเดล AI ได้รับความนิยมเพิ่มมากขึ้น โดยเฉพาะอย่างยิ่งสำหรับการใช้งานเฉพาะทางในแนวตั้ง จึงได้เกิดปัญหาคอขวดสำคัญขึ้น นั่นก็คือ การให้บริการโมเดล
ความท้าทายหลักของการใช้งานโมเดล:
• ต้นทุน GPU ที่สูง: โมเดลที่ปรับแต่งแต่ละโมเดลมักจะต้องใช้อินสแตนซ์อิสระ และต้นทุนการขยายจะเพิ่มขึ้นแบบทวีคูณ
• เกมระหว่างเวลาแฝงและปริมาณงาน: การทำงานพร้อมกันจำนวนมากมักนำไปสู่ความล่าช้าในการตอบสนองหรือความแม่นยำของโมเดลลดลง
• ข้อจำกัดของหน่วยความจำ: กรอบงานการใช้งานแบบเดิมจำเป็นต้องโหลดโมเดลหลายตัวไว้ล่วงหน้า และการใช้หน่วยความจำนั้นต่ำมาก
• บริการส่วนบุคคลที่เข้มงวด: การปรับใช้โมเดลเฉพาะผู้ใช้ในระดับใหญ่ต้องเผชิญกับอุปสรรค 2 ประการ ได้แก่ ความยากทางเทคนิคและความเป็นไปได้ทางเศรษฐกิจ
ตลาดต้องการโซลูชันบริการโมเดลที่สามารถรองรับการปรับแต่งในระดับใหญ่ ต้นทุนต่ำ ประสิทธิภาพสูง และการกระจายอำนาจแบบดั้งเดิมอย่างเร่งด่วน
OpenLoRA: การเปลี่ยนแปลงครั้งใหญ่ในโมเดลบริการ
OpenLoRA คือโซลูชันที่จัดทำโดย OpenLedger กรอบการทำงานที่ปรับขนาดได้และมีประสิทธิภาพสูงนี้สามารถรองรับโมเดล LoRA (ปรับตัวระดับต่ำ) ได้หลายพันโมเดลพร้อมกันบน GPU ตัวเดียว ซึ่งไม่เพียงช่วยลดต้นทุนการดำเนินงานได้อย่างมากแต่ยังเปิดโอกาสสำหรับแอปพลิเคชัน AI รุ่นใหม่ด้วย

คุณสมบัติที่ล้ำสมัยของ OpenLoRA:
• การโหลดอะแดปเตอร์แบบไดนามิก: ใช้กลไกการโหลดทันทีแทนการโหลดล่วงหน้าเต็มรูปแบบเพื่อปลดปล่อยหน่วยความจำ GPU
• การรวมโมเดลแบบเรียลไทม์: รองรับการรวมอะแดปเตอร์หลายตัวแบบรันไทม์เพื่อให้ได้การใช้เหตุผลแบบบูรณาการ
• การประมวลผลการวัดปริมาณแบบสตรีมมิ่ง: รองรับการสตรีมโทเค็นและการวัดปริมาณแบบ 4 บิตเพื่อให้ได้การใช้เหตุผลแบบเรียลไทม์ที่มีค่าหน่วงเวลาต่ำมาก
• ตัวบ่งชี้ประสิทธิภาพสูง:
ความเร็วในการสร้างโทเค็น: 2000+/วินาที
ความล่าช้า: 20-50ms
การใช้หน่วยความจำ: <12GB (กรอบงานดั้งเดิมต้องการ 40-50GB)
• เป็นมิตรต่อผู้พัฒนา: ด้วย API ที่เรียบง่าย อะแดปเตอร์สามารถโหลด รวม รัน และยกเลิกการโหลด ทำให้ปรับให้เข้ากับสถานการณ์ผลิตภัณฑ์ได้อย่างสมบูรณ์แบบ
การทดสอบประสิทธิภาพ: การวัดข้อดีของ OpenLoRA
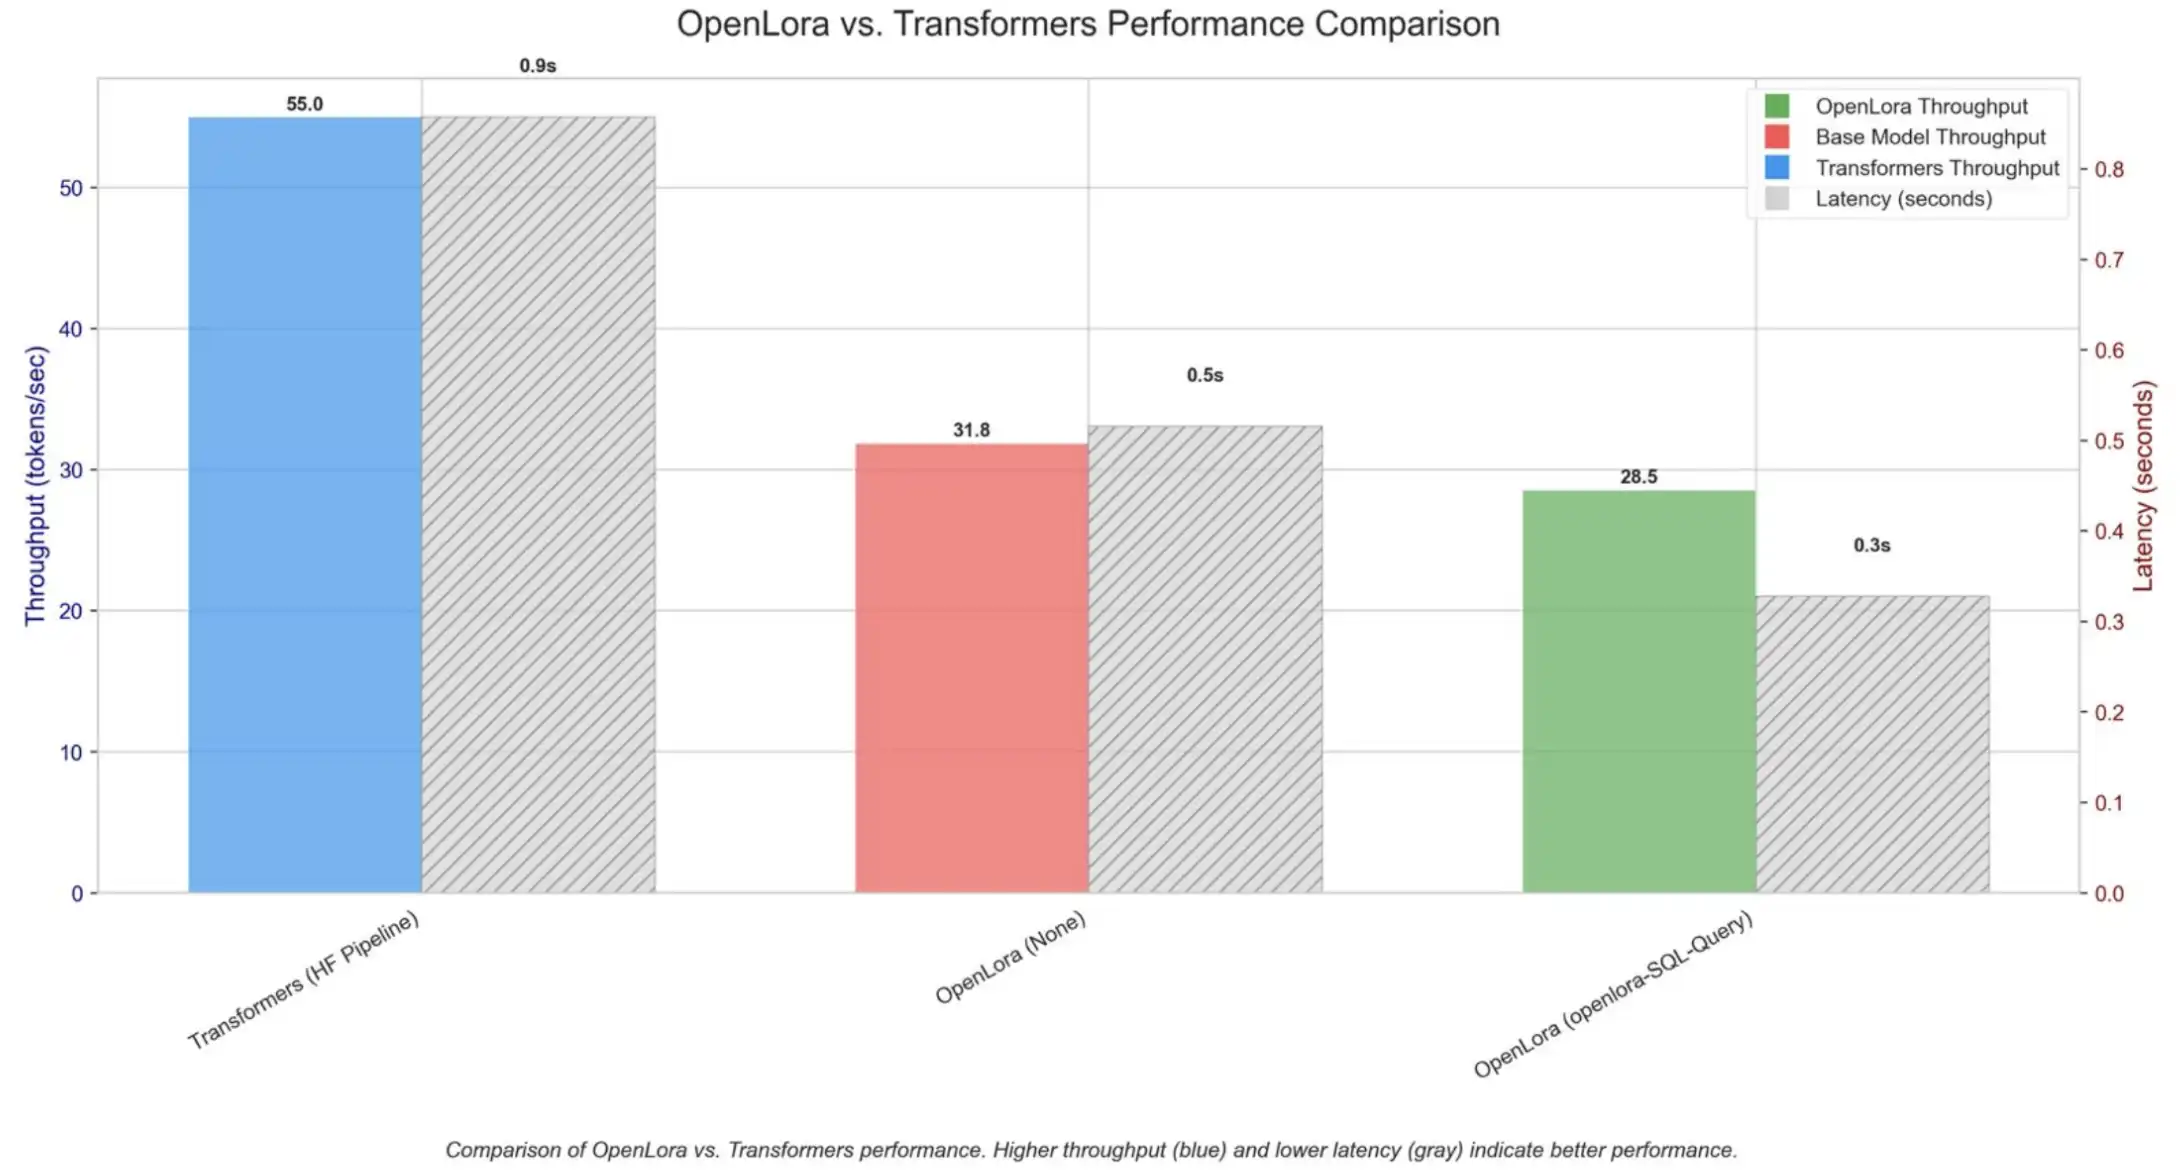
การทดสอบประสิทธิภาพล่าสุดยืนยันว่า OpenLoRA เหนือกว่ากรอบงานบริการแบบเดิมในทุกด้าน
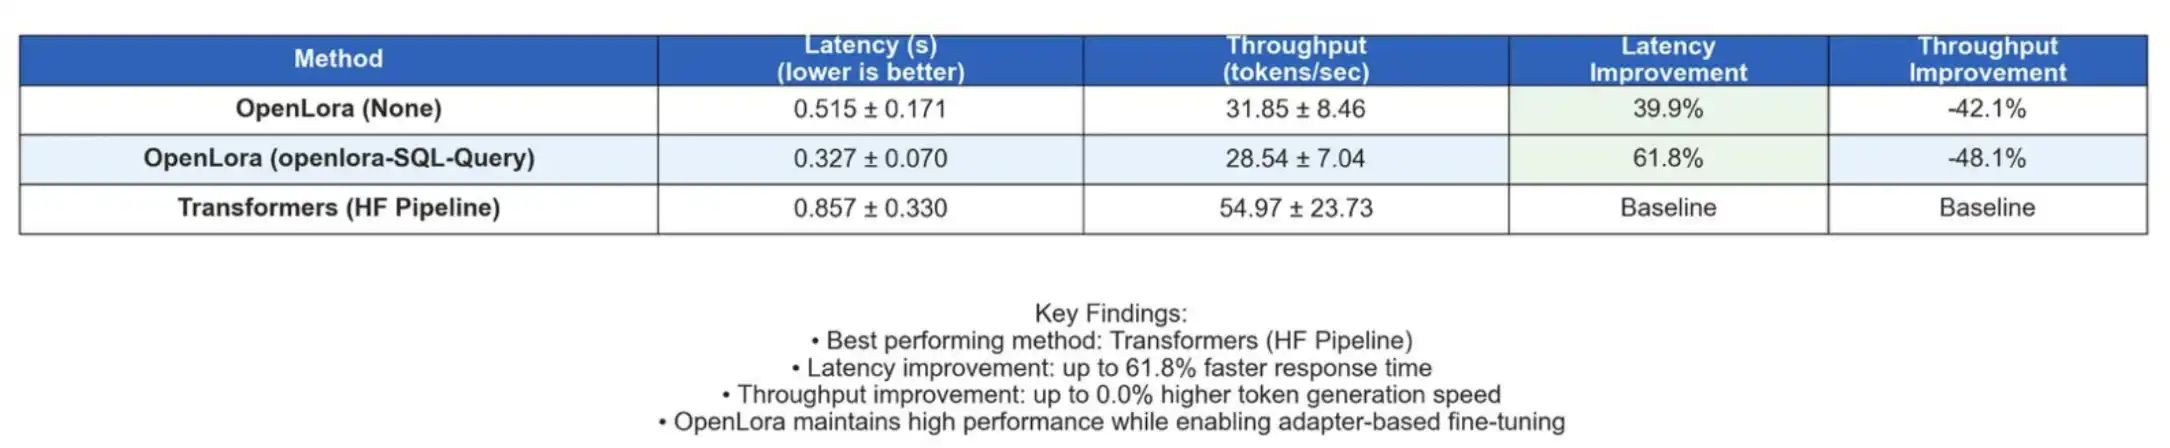
ในการทดสอบเชิงเปรียบเทียบ ความเร็วในการสร้างโทเค็นของ OpenLoRA นั้นสูงกว่าโซลูชันแบบเดิมถึง 4 เท่า และการใช้งานหน่วยความจำก็ลดลงอย่างมาก แม้ภายใต้โหลดพร้อมกันที่สูง ก็ยังสามารถรักษาความหน่วงเวลาที่ต่ำเป็นอย่างมากที่ 20 มิลลิวินาทีได้ ในขณะที่ต้องใช้หน่วยความจำวิดีโอน้อยกว่า 12GB เพื่อรองรับอะแดปเตอร์ LoRA หลายพันตัว ตัวบ่งชี้เหล่านี้ได้รับการตรวจยืนยันในสภาพแวดล้อมฮาร์ดแวร์ต่างๆ แสดงให้เห็นว่า OpenLoRA ยังคงเป็นผู้นำสถาปัตยกรรมดั้งเดิมในด้านปริมาณงานและประสิทธิภาพ การก้าวกระโดดในด้านประสิทธิภาพนี้ทำให้ OpenLoRA กลายเป็นโครงสร้างพื้นฐานที่ควรเลือกใช้เพื่อการใช้งาน AI แบบเรียลไทม์ที่ปรับขนาดได้ในสภาพแวดล้อมแบบกระจายอำนาจ
สำหรับนักพัฒนาที่ต้องการใช้งานผู้ช่วยส่วนบุคคล ตัวแทนหลายโดเมน หรือสร้างบริการ AI แบบเรียลไทม์ สถาปัตยกรรม OpenLoRA จะช่วยขจัดภาระทรัพยากร GPU ได้อย่างสมบูรณ์
สร้างขึ้นบนโครงสร้างพื้นฐานบล็อคเชน AI ดั้งเดิมของ OpenLedger
OpenLoRA ไม่ใช่บริการแบบสแตนด์อโลน แต่ได้รับการผสานรวมอย่างลึกซึ้งในเครือข่ายบล็อคเชน OpenLedger ที่ออกแบบมาโดยเฉพาะสำหรับแอปพลิเคชัน AI โครงสร้างพื้นฐานประกอบด้วย:
• ModelFactory: เครื่องมือปรับแต่งโมเดล LoRA/QLoRA บน GUI
• หลักฐานการระบุแหล่งที่มา: ปกป้องสิทธิ์ของข้อมูลและปรับแต่งผู้มีส่วนสนับสนุนผ่านการยืนยันสิทธิ์การเข้ารหัส
• เครือข่ายข้อมูล: เครือข่ายข้อมูลแบบกระจายอำนาจที่จัดหาข้อมูลการฝึกภาคสนามแนวตั้งคุณภาพสูง
เลเยอร์เหล่านี้ร่วมกันสร้างรากฐานสำคัญของ "AI ที่ชำระเงินได้" - ในแนวคิดใหม่นี้ โมเดลนี้ไม่เพียงแต่กระจายอำนาจและโปร่งใสเท่านั้น แต่ยังสามารถแจกจ่ายมูลค่าตามส่วนสนับสนุนของผู้ใช้ได้อีกด้วย OpenLoRA ขับเคลื่อนภารกิจนี้ต่อไปด้วยการแก้ไขอุปสรรคสุดท้ายของเทคโนโลยีสแต็ก: การใช้โมเดลขนาดใหญ่และต้นทุนต่ำสำหรับแอปพลิเคชันในโลกแห่งความเป็นจริง
ความคืบหน้าของเทสต์เน็ต
ในการเตรียมการสำหรับการเปิดตัวเมนเน็ต OpenLedger ได้เปิดตัวเทสต์เน็ตสาธารณะเพื่อสร้างระบบนิเวศแบบกระจายอำนาจที่ผู้คนสามารถมีส่วนร่วมได้อย่างอิสระ ผู้เข้าร่วมสามารถสะสมคะแนนได้จากวิธีต่อไปนี้:
• การรันโหนดเทสต์เน็ต
• การทำภารกิจต่างๆ ให้กับดาต้าเน็ต
• การมีส่วนสนับสนุนข้อมูลที่มีคุณภาพสูง
• การเชิญชวนผู้ใช้ใหม่
คะแนนเหล่านี้จะเชื่อมโยงกับกลไกการให้รางวัลแบบแบ่งระดับของ OpenLedger และผู้ที่มีส่วนสนับสนุนในช่วงแรกจะได้รับแรงจูงใจจากผู้ที่ริเริ่มก่อนเมื่อเมนเน็ตเปิดใช้งาน สิ่งที่น่าสังเกตยิ่งกว่าคือเกณฑ์การมีส่วนร่วมที่เรียบง่ายมาก:
• โหนดส่วนขยายมือถือ (Android) และเบราว์เซอร์สามารถใช้งานได้ภายใน 30 วินาที
• ไม่จำเป็นต้องมีความรู้ด้านเทคนิค และกลไกการมีส่วนร่วมได้รับการออกแบบมาให้ปรับขนาดได้
สิ่งที่น่าสังเกตก็คือประเทศจีนได้กลายเป็นหนึ่งในภูมิภาคที่มีส่วนร่วมอย่างแข็งขันที่สุด และสัดส่วนของปริมาณการรับส่งข้อมูลเครือข่ายทดสอบอยู่ในอันดับต้นๆ ของโลก จากจำนวนคำขอ 24.8 ล้านรายการที่แพลตฟอร์มบันทึกไว้ ประเทศจีนอยู่ในอันดับสูงสุดในด้านการมีส่วนร่วม
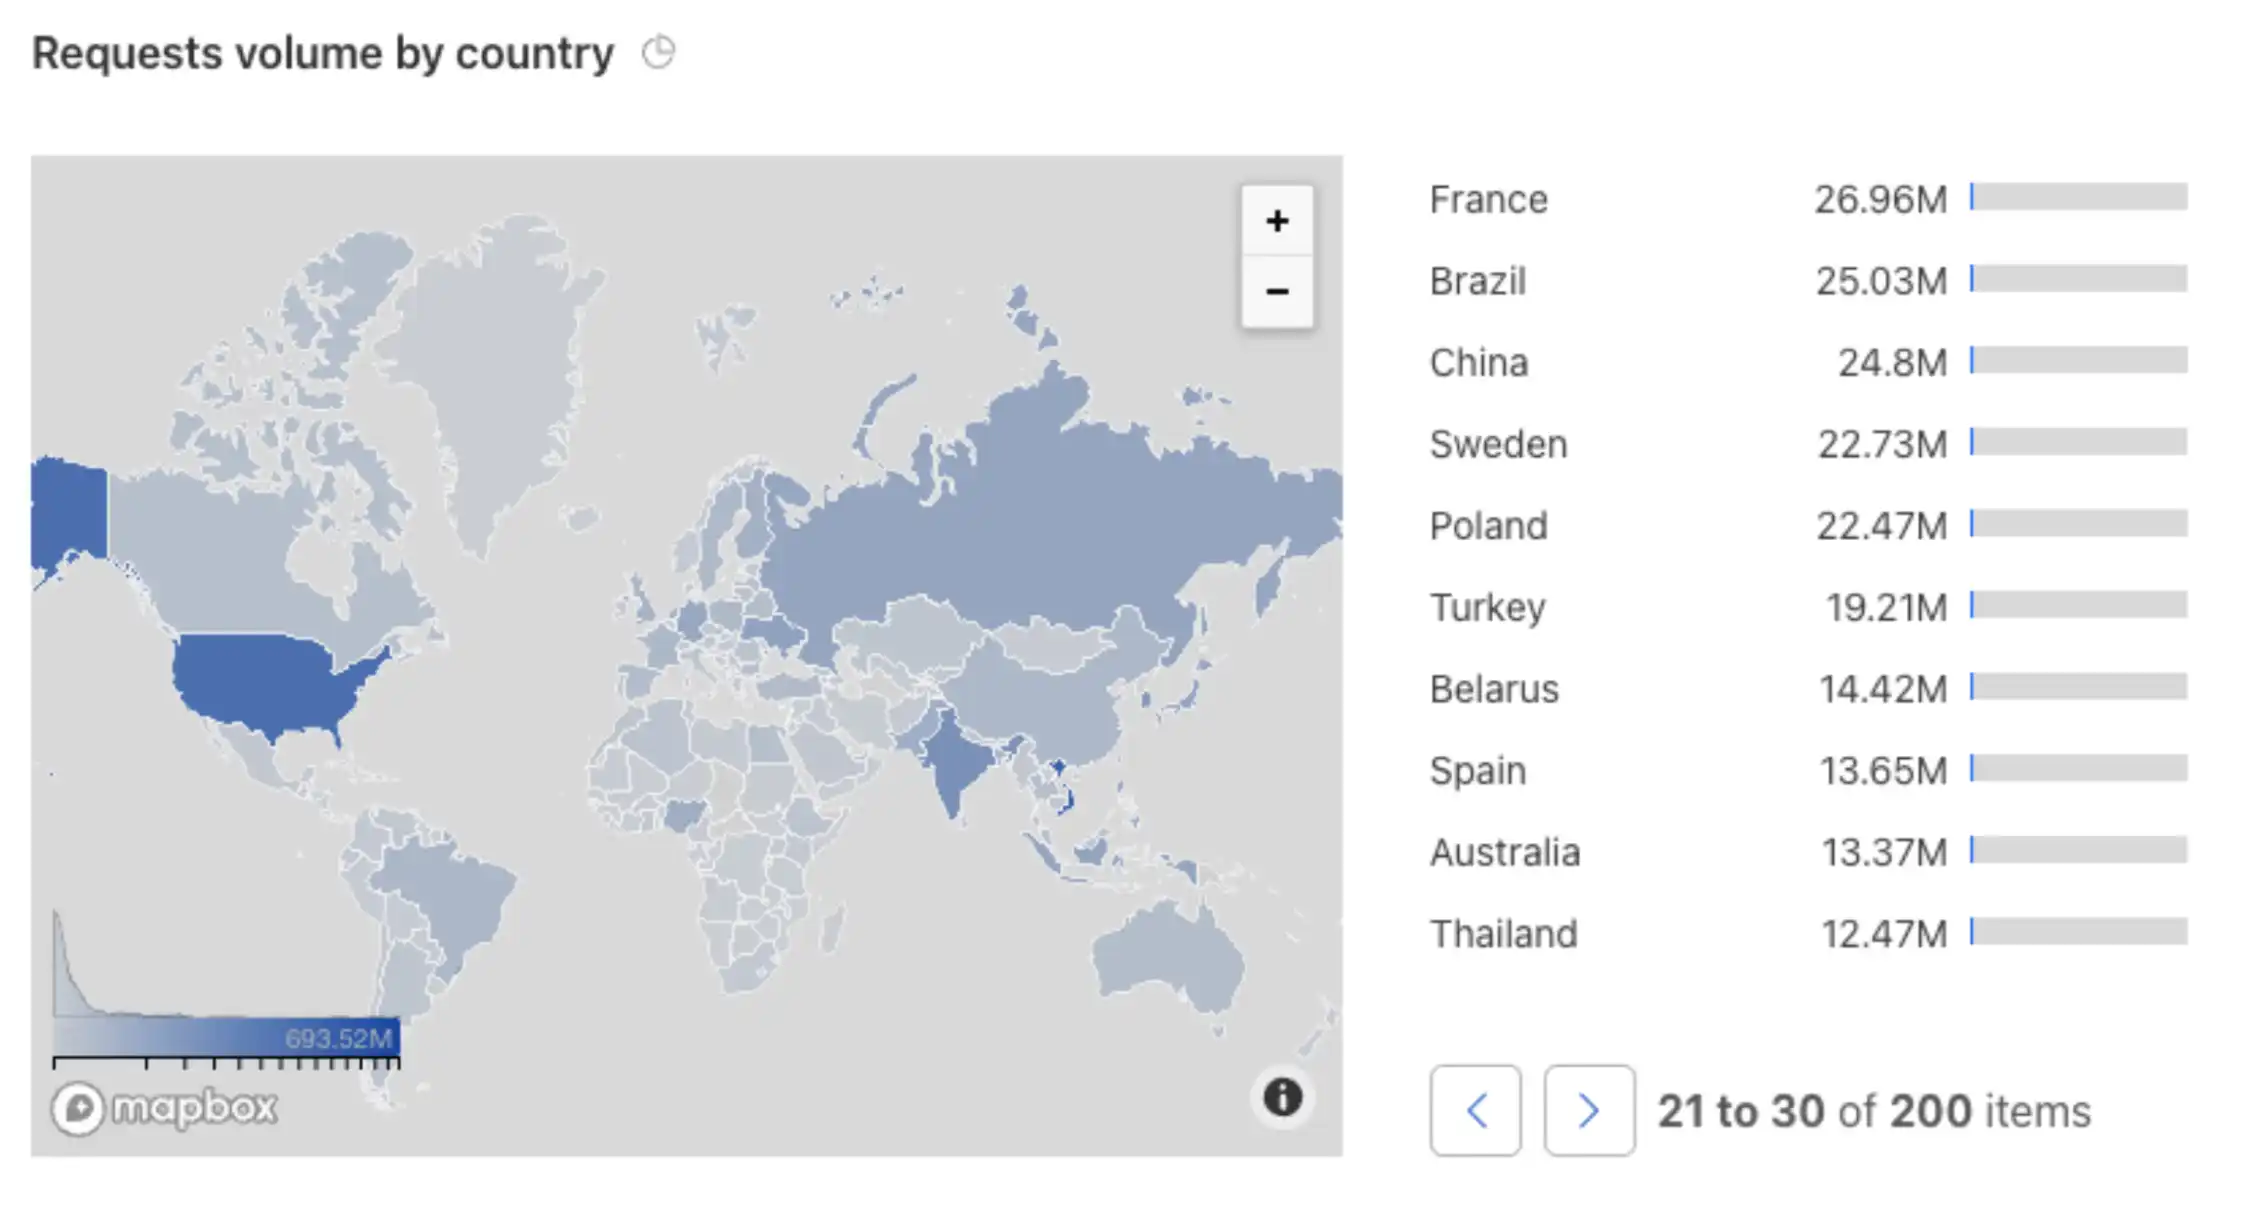
นี่เป็นการส่งสัญญาณที่ชัดเจน: นักพัฒนา นักวิจัย และผู้ปฏิบัติงานด้าน AI ชาวจีนกำลังสนับสนุนวิสัยทัศน์ของ OpenLedger และแสวงหาทางเลือกอื่นที่ประหยัดกว่า กระจายอำนาจมากกว่า และปรับขนาดได้สำหรับโครงสร้างพื้นฐานด้าน AI ดั้งเดิม
แนวโน้มในอนาคต
OpenLoRA ช่วยให้สามารถใช้งานแอปพลิเคชั่นต่างๆ ได้ในหลายสาขา:
• ที่ปรึกษาทางวิทยาศาสตร์มืออาชีพ
• ผู้ช่วยด้านกฎหมายในพื้นที่
• ผู้ช่วยนำร่องธุรกรรมที่อิงตามข้อมูล Web3
• การแปลการสื่อสารบนเครือข่ายแบบเรียลไทม์
ในอนาคต ยังจะรองรับอะแดปเตอร์ LoRA แบบไม่มีการสุ่มตัวอย่าง การปรับใช้ GPU หลายตัว และความสามารถในการใช้เหตุผลสำหรับอุปกรณ์ขอบและแม้แต่เทอร์มินัลมือถืออีกด้วย
เหตุใดจึงต้องใช้ OpenLoRA? ทำไมตอนนี้? AI จำเป็นต้องกระจายอำนาจ ซึ่งไม่เพียงแต่เกี่ยวข้องกับความบริสุทธิ์ของแนวคิดเท่านั้น แต่ยังรวมถึงความต้องการในการปรับขยาย ความน่าเชื่อถือ และนวัตกรรมในการปฏิบัติอีกด้วย OpenLoRA ช่วยขจัดปัญหาคอขวดทางเทคนิคสุดท้ายของ AI แบบกระจายอำนาจ - การให้บริการโมเดลขนาดใหญ่ และสร้างความก้าวหน้าอย่างก้าวกระโดดด้วยประสิทธิภาพเชิงปฏิวัติ นี่ไม่ใช่แค่เพียงนวัตกรรมเครื่องมือเท่านั้น แต่ยังเป็นการเรียกร้องให้มีส่วนร่วมในการกำหนดโครงสร้างพื้นฐาน AI รุ่นถัดไปอีกด้วย ด้วย ModelFactory และ Proof of Contribution ของ OpenLedger ตอนนี้ผู้พัฒนาสามารถปรับแต่ง นำไปใช้ และนำโมเดล AI ออกสู่ตลาดได้อย่างโปร่งใสและแม่นยำ และ
การถือกำเนิดของ OpenLoRA ในที่สุดก็ทำให้สิ่งนี้เป็นไปได้ในระดับขนาดใหญ่และตามความต้องการโดยไม่ต้องเสียค่าใช้จ่าย GPU ที่สูงลิ่ว
เข้าร่วมระบบนิเวศของ OpenLedger และติดตามบัญชี X ของเราเพื่อรับการพัฒนาล่าสุด การเปิดตัวเวอร์ชัน และข้อมูลระบบนิเวศของ AI แบบกระจายอำนาจ
บทความนี้ได้รับการสนับสนุนโดยผู้สนับสนุน และไม่แสดงถึงมุมมองของ BlockBeats
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia

 บทความที่เกี่ยวข้อง