จากที่เก็บข้อมูลได้สู่การชำระบัญชีได้: Bitroot ปรับโครงสร้างชั้นมูลค่าข้อมูล AI อย่างไร!
แหล่งที่มาบทความ: Bitroot
พื้นที่จัดเก็บไม่ใช่ศูนย์ต้นทุน แต่เป็นระบบกระจายมูลค่าของ Bitroot AI Stack
ทีมงานหลายทีมเพิ่งจะตระหนักหลังจากเปิดตัวไปกว่าครึ่งปีว่าชั้นพื้นที่จัดเก็บควรได้รับการเลือกอย่างรอบคอบมากกว่านี้ตั้งแต่แรก ข้อมูลไม่ได้สูญหาย บริการไม่ได้หยุดทำงาน แต่ปัญหากลับปรากฏในอีกรูปแบบ: ข้อมูลฝึกอบรมที่เก็บถาวรเริ่มดึงกลับมาได้ช้าลง เวลาแฝงท้ายของการค้นหาเวกเตอร์จุดร้อนกระตุกจากระดับมิลลิวินาทีเป็นวินาที และเมื่อต้องตรวจสอบเหตุการณ์ออนไลน์ครั้งหนึ่ง ก็ไม่มีใครบอกได้ว่าโมเดลนั้นใช้ข้อมูลฝึกอบรมเวอร์ชันไหนในตอนนั้น เมื่อถึงจุดนี้ สิ่งที่ต้องแก้ไขไม่ใช่การขยายพื้นที่อีกต่อไป แต่เป็นปัญหาที่ยากกว่าสามข้อ: ใครสามารถพิสูจน์ได้ว่าข้อมูลพร้อมใช้งานตลอดเวลา ใครรับผิดชอบเวอร์ชัน และใครเป็นผู้จ่ายค่าใช้จ่ายระยะยาว
การเข้าใจพื้นที่จัดเก็บว่าเป็นการย้ายไฟล์จากคลาวด์แบบรวมศูนย์ไปยังเครือข่ายนอกเชน อาจยังพอใช้ได้ในยุคข้อมูลเมตาดาต้าของ NFT แต่เมื่อธุรกิจขยายไปถึงคลังข้อมูลฝึกอบรม AI น้ำหนักโมเดล และดัชนีเวกเตอร์ แนวคิดนี้จะล้มเหลวอย่างรวดเร็ว
ทีมส่วนใหญ่ยังคงมองพื้นที่จัดเก็บเป็นต้นทุนด้าน后勤ที่ยิ่งประหยัดได้มากเท่าไหร่ก็ยิ่งดี ซึ่งนี่คือจุดที่ถูกประเมินต่ำที่สุดและเลือกผิดได้ง่ายที่สุด: ในบล็อกเชนสาธารณะสำหรับ AI มันคือชั้นกระจายมูลค่าที่กำหนดว่าใครเป็นผู้ควบคุมข้อมูลและใครได้รับผลตอบแทน บทความนี้ตอบเพียงคำถามเดียว: ในสถานการณ์ที่ AI ผสานกับบล็อกเชนสาธารณะ จะสร้างโซลูชันพื้นที่จัดเก็บแบบกระจายที่ตรวจสอบได้ จัดการได้ และยั่งยืนได้อย่างไร ต่อไปนี้จะแยกขีดความสามารถของสามกระบวนทัศน์หลักก่อน จากนั้นอธิบายความท้าทายพิเศษของข้อมูล AI และสุดท้ายลงลึกถึงสถาปัตยกรรมการใช้งานห้าชั้นและเกณฑ์การเปิดตัวแบบเป็นระยะ การตัดสินใจอ้างอิงจากเอกสารโปรโตคอลทางการเป็นหลัก และพยายามใช้ข้อมูลที่ตรวจสอบได้
ยกตัวอย่าง Bitroot ชั้นพื้นที่จัดเก็บมีตำแหน่งที่แม่นยำกว่าคือฐานกระจายมูลค่าของ AI Stack Bitroot ในด้านหนึ่งให้สภาพแวดล้อมการดำเนินการบนเชนประสิทธิภาพสูงผ่าน EVM แบบขนานและ Pipeline BFT ในอีกด้านหนึ่งเชื่อมต่อข้อมูล โมเดล พลังประมวลผล และแอปพลิเคชัน Agent เข้าด้วยกันเป็นเครือข่ายที่สามารถชำระบัญชีได้ผ่านการฝึกอบรมแบบกระจาย เครือข่ายการอนุมาน การดำเนินการที่เชื่อถือได้ และการจัดการสินทรัพย์ AI ในเครือข่ายนี้ พื้นที่จัดเก็บไม่ใช่โมดูลที่แยกออกมา แต่เป็นโครงสร้างพื้นฐานที่กำหนดว่าข้อมูลสามารถยืนยันสิทธิ์ได้หรือไม่ โมเดลสามารถทำซ้ำได้หรือไม่ พลังประมวลผลสามารถชำระบัญชีได้หรือไม่ และผู้มีส่วนร่วมสามารถรับผลตอบแทนอย่างต่อเนื่องได้หรือไม่
การอัปโหลดทั้งหมดบนเชนและการรวมศูนย์ทั้งหมด ในสถานการณ์ AI ต่างก็ใช้ไม่ได้อีกต่อไป
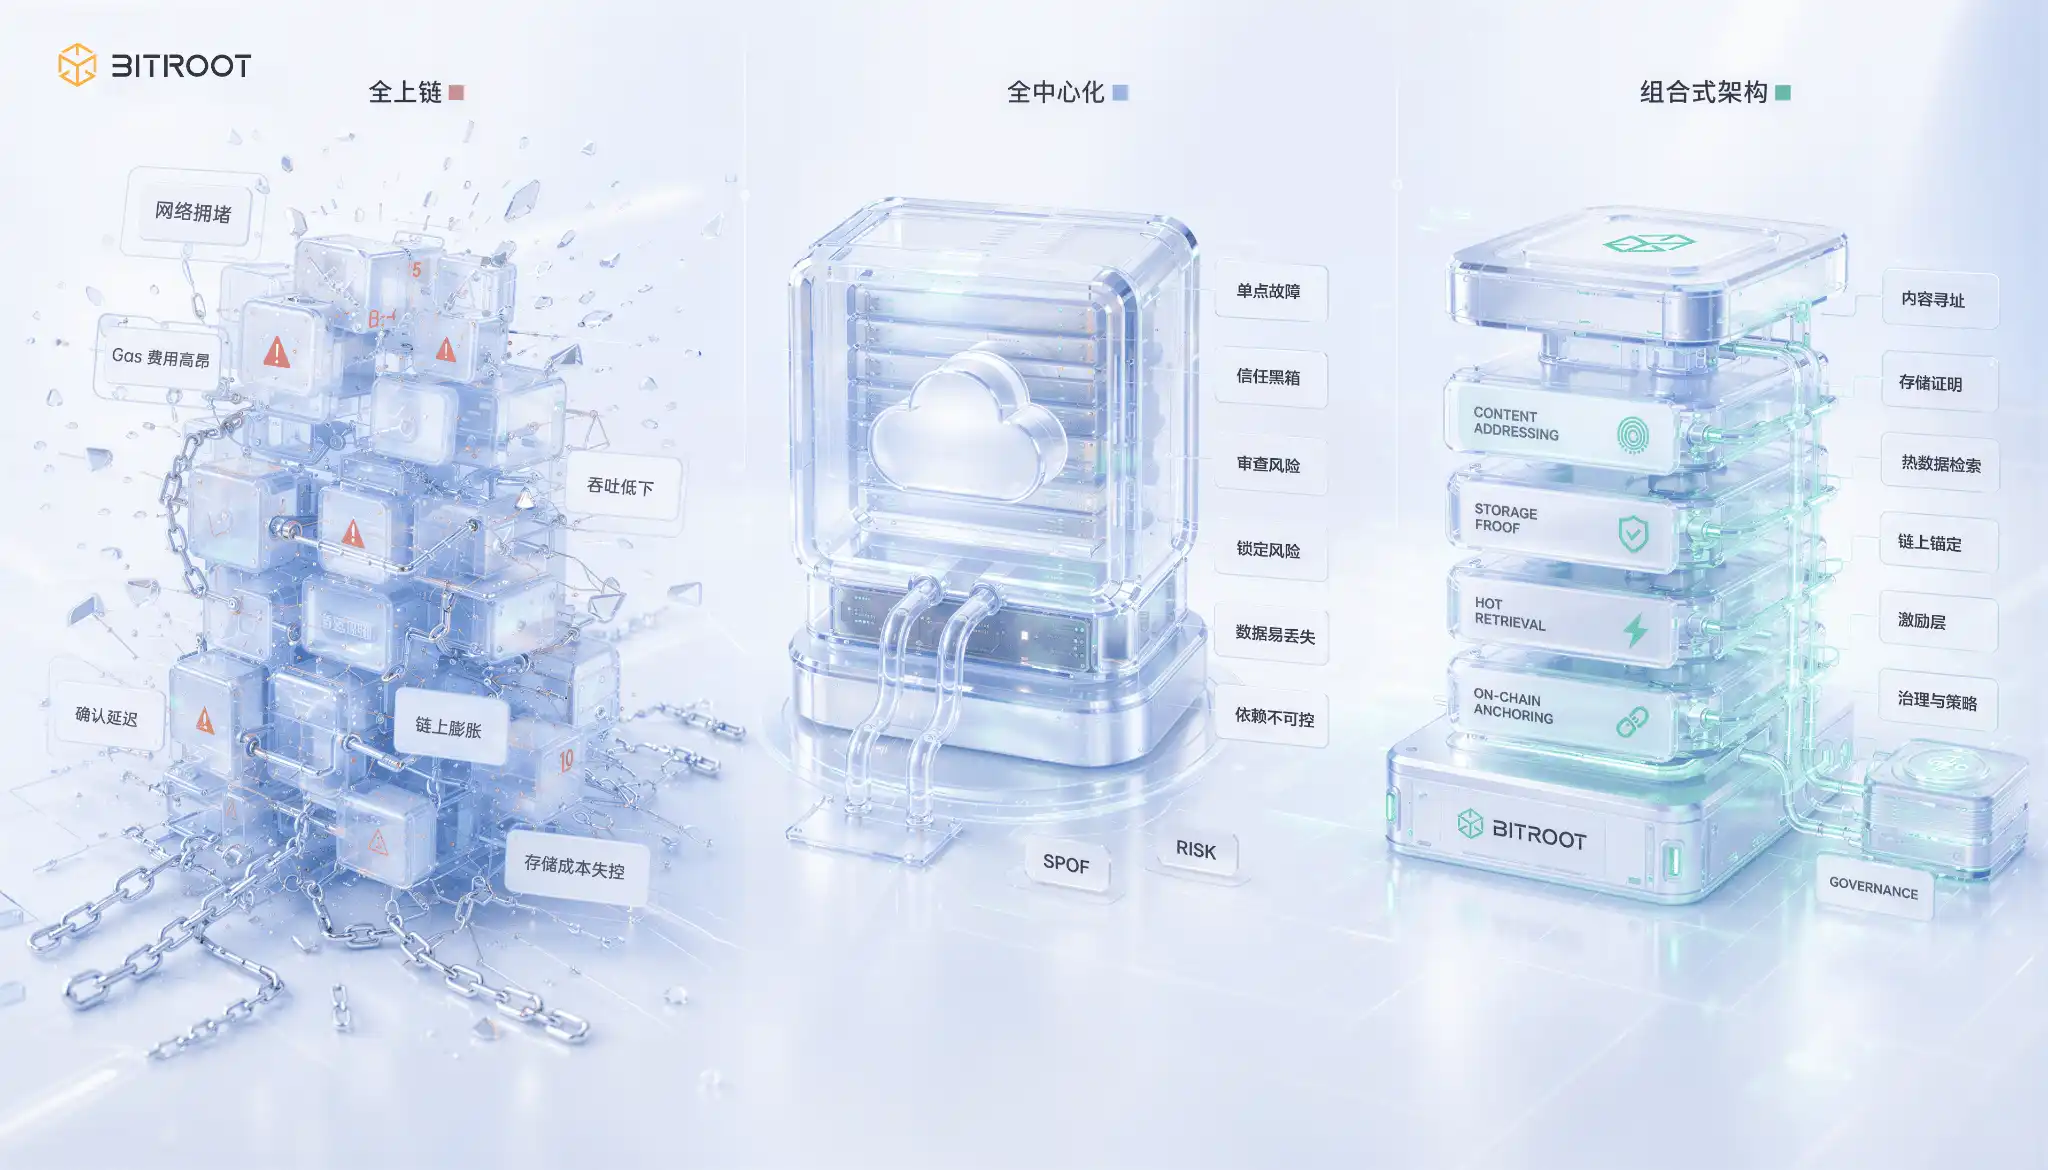
ในช่วงไม่กี่ปีที่ผ่านมา ปัญหาพื้นที่จัดเก็บมักถูกทำให้ง่ายขึ้นเป็นสองทางเลือก: อัปโหลดทั้งหมดบนเชนหรือรวมศูนย์ทั้งหมด ทั้งสองเส้นทางนี้ไม่ยั่งยืนในสถานการณ์ AI
ความกดดันจากการนำทุกอย่างขึ้นเชนนั้นชัดเจนมาก ข้อมูลฝึกอบรม น้ำหนักโมเดล บันทึกการอนุมาน และดัชนีเวกเตอร์ มักจะมีปริมาณสูงและอัปเดตบ่อยครั้ง แม้จะแบ่งเป็นชิ้นเล็กๆ ก่อนขึ้นเชน ก็ยังเจอทั้งข้อจำกัดด้านปริมาณธุรกรรมและเส้นโค้งต้นทุนพร้อมกัน การทำงานแบบรวมศูนย์ทั้งหมดนั้นเร็ว แต่ความสามารถในการตรวจสอบ การติดตามย้อนหลัง อธิปไตยของข้อมูล และพื้นฐานความเชื่อมั่นที่จำเป็นสำหรับการทำงานร่วมกันข้ามหน่วยงานนั้นเปราะบางมาก ทันทีที่เกี่ยวข้องกับการแบ่งรายได้และการยืนยันสิทธิ์หลายฝ่าย ก็จะไม่สามารถยืนหยัดได้
การเปลี่ยนแปลงที่สำคัญยิ่งกว่านั้นคือ AI ได้เปลี่ยนพื้นที่จัดเก็บจากรายการต้นทุนมาเป็นปัจจัยการผลิต ใครเป็นผู้จัดการเวอร์ชันข้อมูล จะเป็นตัวกำหนดว่าใครมีอำนาจในการริเริ่มการพัฒนาโมเดล การพิสูจน์ว่าข้อมูลสามารถใช้งานได้หรือไม่ ส่งผลโดยตรงต่อลำดับความสำคัญของการจัดสรรทรัพยากรการคำนวณและการชำระบัญชี และความสามารถในการทำให้ข้อมูลเป็นสินทรัพย์นั้น ส่งผลต่อความสามารถของทีมในการสร้างแรงจูงใจระยะยาวในระบบนิเวศ เมื่อถึงจุดนี้ ชั้นจัดเก็บข้อมูลไม่ได้เป็นเพียงระบบสนับสนุนอีกต่อไป แต่เป็นระบบกระจายมูลค่า
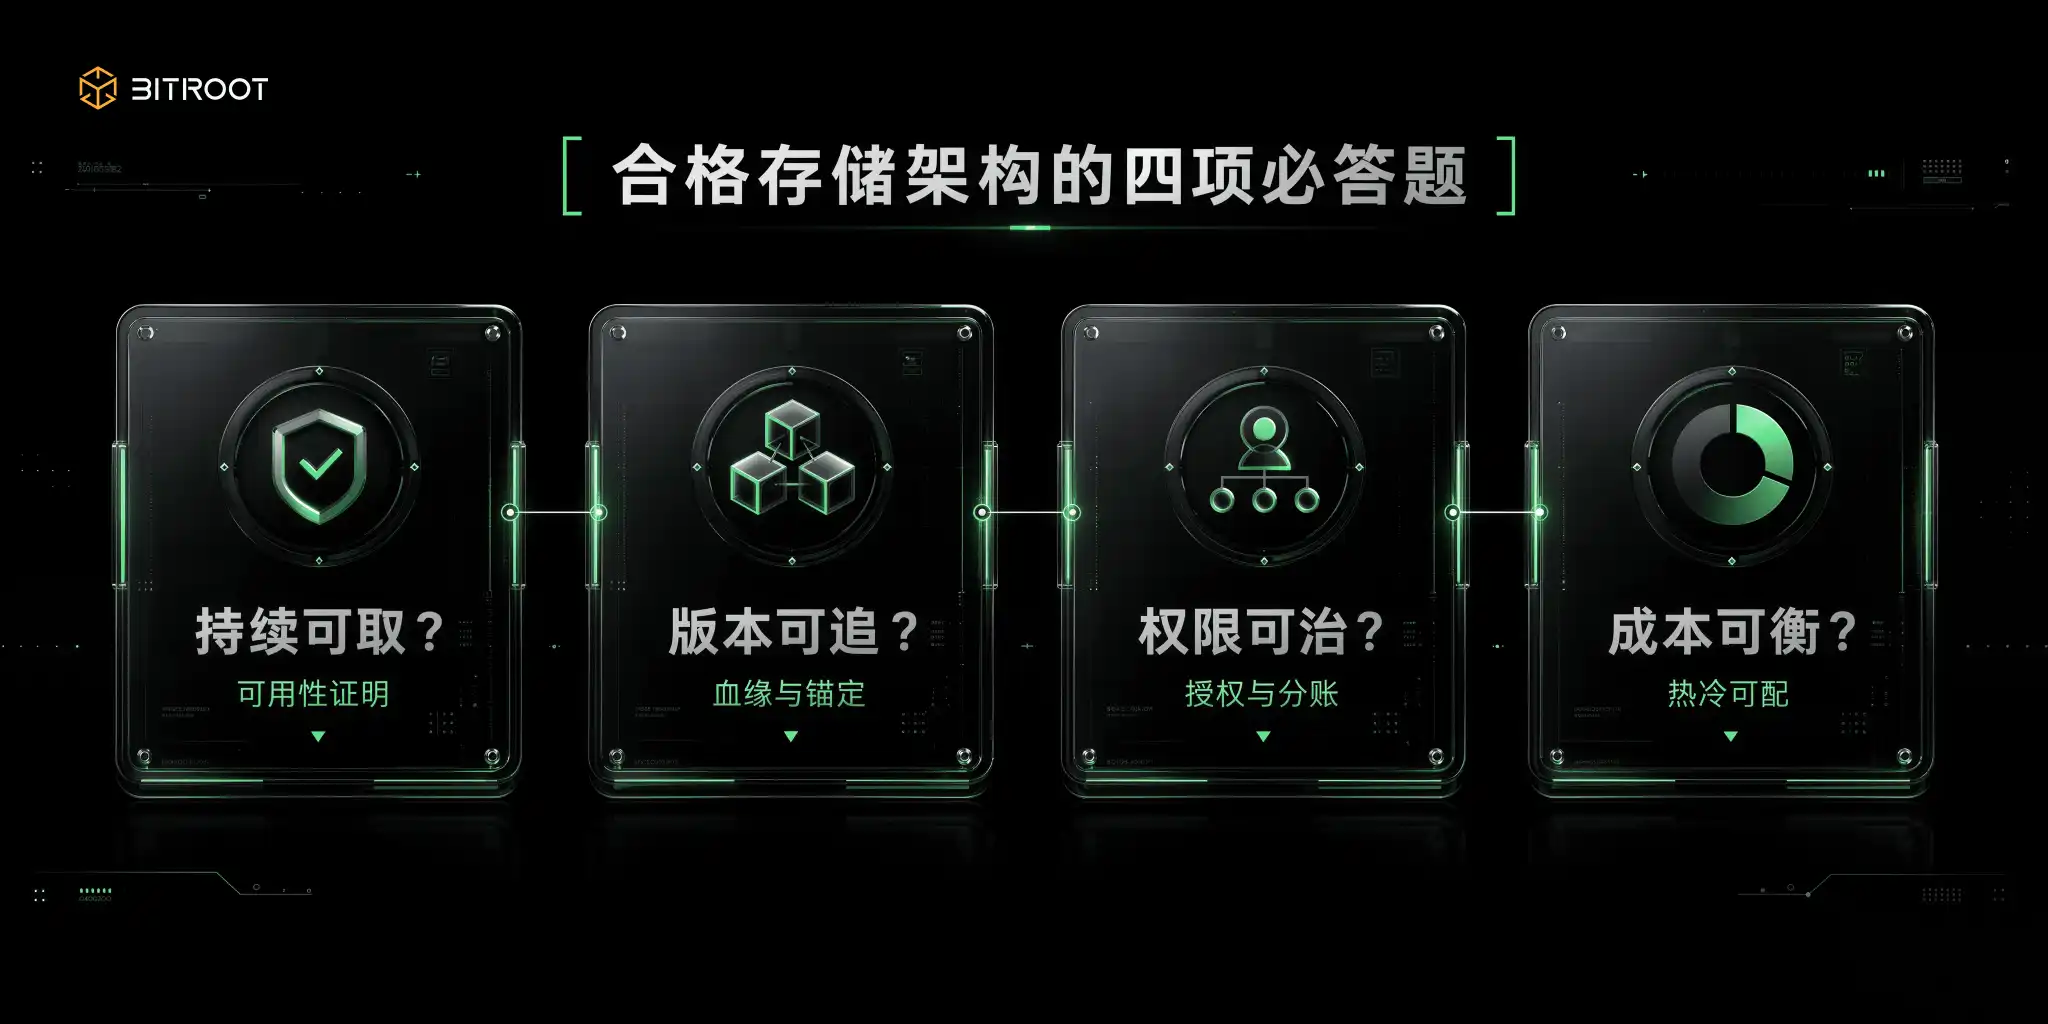
ดังนั้น สถาปัตยกรรมการจัดเก็บข้อมูลที่เหมาะสม ต้องตอบคำถามสี่ข้อพร้อมกัน: ข้อมูลมีอยู่จริงและสามารถเข้าถึงได้อย่างต่อเนื่องหรือไม่ ความสัมพันธ์ของเวอร์ชันระหว่างข้อมูลและโมเดลสามารถติดตามได้หรือไม่ สิทธิ์และผลตอบแทนสามารถจัดการได้หรือไม่ และระบบสามารถรักษาสมดุลระหว่างต้นทุนและประสิทธิภาพในระยะยาวได้หรือไม่
จุด切入ของ Bitroot: ทำให้ข้อมูล AI เปลี่ยนจาก "จัดเก็บได้" ไปสู่ "ชำระบัญชีได้"
นี่คือตำแหน่งที่ Bitroot จำเป็นต้องเข้ามาเติมเต็ม ในฐานะบล็อกเชนสาธารณะ Parallel EVM ประสิทธิภาพสูงที่มุ่งเน้นสถานการณ์ AI เรื่องราวการจัดเก็บข้อมูลของ Bitroot ไม่ควรหยุดอยู่ที่ "ข้อมูลถูกเก็บไว้ที่ไหน" แต่ต้องตอบว่า "ข้อมูลจะถูกพิสูจน์ ถูกเรียกใช้ และมีส่วนร่วมในการแบ่งรายได้อย่างไร" คลังข้อมูลฝึกอบรม น้ำหนักโมเดล ดัชนีเวกเตอร์ และบันทึกการอนุมาน สามารถเก็บไว้ในชั้นจัดเก็บแบบกระจายที่เหมาะกับวัตถุขนาดใหญ่กว่า แต่คำมั่นสัญญาแบบแฮช ความสัมพันธ์ของเวอร์ชัน นโยบายสิทธิ์ บันทึกการเรียกใช้ และเหตุการณ์ผลตอบแทนของพวกมัน จำเป็นต้องสร้างหลักฐานบนเชนที่เป็นหนึ่งเดียวบน Bitroot
จากมุมมองนี้ ปริมาณธุรกรรมสูงและความหน่วงต่ำของ Bitroot ไม่ได้ให้บริการแค่ธุรกรรม DeFi เท่านั้น แต่ให้บริการเหตุการณ์การจัดการที่ละเอียดและมีความถี่สูงกว่าใน AI Stack: การอัปเดตชุดข้อมูลต้องถูกยึดโยง เวอร์ชันโมเดลต้องถูกลงทะเบียน การเรียกใช้ AI Agent ต้องถูกชำระบัญชี ข้อพิพาทผลการค้นหาต้องถูกตัดสิน และความพร้อมใช้งานของโหนดจัดเก็บต้องถูกท้าทายและให้รางวัลอย่างต่อเนื่อง เฉพาะเมื่อเชนพื้นฐานสามารถรองรับเหตุการณ์เหล่านี้ได้ สินทรัพย์ข้อมูล AI จะไม่ถูกขังอยู่ในฐานข้อมูลแบบรวมศูนย์ และจะไม่กลายเป็นกล่องดำนอกเชนที่ไม่สามารถตรวจสอบได้
สามกระบวนทัศน์หลัก ไม่มีกระบวนทัศน์ใดที่สามารถเจาะทะลวงทุกสถานการณ์ได้เพียงลำพัง
การแข่งขันของพื้นที่จัดเก็บแบบกระจาย ไม่เคยเกี่ยวกับว่าใครล้ำหน้าที่สุด แต่เกี่ยวกับว่าใครเหมาะสมที่สุดกับโครงสร้างข้อมูลของคุณ
เครือข่ายการระบุตำแหน่งด้วยเนื้อหาตอบคำถามว่า "นี่คือข้อมูลนั้นหรือไม่" ไม่ใช่ "ใครรับประกันว่ามันออนไลน์อยู่" ตามเอกสารทางการของ IPFS นั้น CID คือตัวระบุที่อ้างอิงจากแฮชของเนื้อหา ไม่ได้พึ่งพาการระบุตำแหน่ง เนื้อหาเดียวกันภายใต้การตั้งค่าการเข้ารหัสเดียวกันจะสร้าง CID เดียวกัน หากเนื้อหาเปลี่ยนแปลงไปแม้เพียงหนึ่งไบต์ CID ก็จะเปลี่ยนตามไปด้วย คุณสมบัตินี้ทำให้มันเหมาะสมโดยธรรมชาติสำหรับการตรวจสอบความสมบูรณ์ การกำจัดข้อมูลซ้ำซ้อน และการอ้างอิงข้ามระบบ ซึ่งเป็นความสามารถพื้นฐานในการยืนยันสิทธิ์ของข้อมูล แต่การระบุตำแหน่งด้วยเนื้อหาไม่ได้หมายถึงความพร้อมใช้งานที่ยั่งยืนในเชิงเศรษฐกิจ CID ตอบคำถามเรื่องตัวตน ไม่ได้ตอบว่าใครจะรับประกันว่ามันจะออนไลน์อยู่ตลอดเวลา ทีมงานหลายทีมเจอหลุมพรางแรกตรงนี้เมื่อเริ่มใช้งาน: ในทางเทคนิคแล้วได้ CID มา แต่ในทางธุรกิจกลับไม่ได้รับคำมั่นสัญญาเรื่องความพร้อมใช้งาน
เครือข่ายตลาดพื้นที่จัดเก็บข้อมูลใช้กลไกทางเศรษฐกิจเพื่อซื้อความพร้อมใช้งานในมิติของเวลา ตามเอกสารของ Filecoin เครือข่ายสร้างกลไกของคำมั่นสัญญาในการจัดเก็บข้อมูลบวกกับการพิสูจน์อย่างต่อเนื่องผ่าน Proof-of-Replication และ Proof-of-Spacetime PoRep พิสูจน์ในขั้นตอนการบรรจุเริ่มต้นว่ามีสำเนาที่ไม่ซ้ำกันนี้ถูกจัดเก็บไว้จริง ส่วน PoSt พิสูจน์ซ้ำในรอบถัดไปว่ายังคงมีอยู่ วงจรการพิสูจน์ของ WindowPoSt มักจัดตามระยะเวลา 24 ชั่วโมง แล้วแบ่งย่อยเป็นหน้าต่างการพิสูจน์ 30 นาทีหลายช่วง หากผู้ให้บริการจัดเก็บไม่ส่งหลักฐานที่ถูกต้องภายในหน้าต่าง จะถูกเรียกค่าปรับจากหลักประกันและความสามารถในการจัดเก็บลดลง ในระบบนี้ ความพร้อมใช้งานคือตัวชี้วัดที่ต้องตรวจสอบอย่างต่อเนื่อง ไม่ใช่คำมั่นสัญญาครั้งเดียวหลังเซ็นสัญญา รูปแบบที่มีสัญญาและตรวจสอบได้นี้เหมาะสำหรับการจัดเก็บถาวรระยะกลางถึงยาว การสำรองข้อมูล และตลาดข้อมูล แต่มันเหมือนคลังสินค้าระยะยาวที่มีการพิสูจน์มากกว่า ไม่ใช่บริการออนไลน์ที่มีความหน่วงต่ำโดยธรรมชาติ หากนำคำค้นหาออนไลน์ความถี่สูงมาใช้โดยตรง ประสบการณ์จะถูกทำลายด้วยความหน่วงที่ปลายทาง
เครือข่ายการจัดเก็บแบบถาวรเดินไปอีกเส้นทางหนึ่ง ใช้การชำระเงินครั้งเดียวเพื่อแลกกับประวัติที่ไม่สามารถเปลี่ยนแปลงได้ ตามโปรโตคอล Arweave และเอกสาร Yellowpaper ส่วนหนึ่งของค่าธรรมเนียมการอัปโหลดจะเข้าสู่กองทุนบริจาคเพื่อการจัดเก็บ (endowment) เพื่อครอบคลุมแรงจูงใจในการจัดเก็บระยะยาว ทำให้ความยั่งยืนในระยะยาวถูกนำเข้ามาในโมเดลการคิดค่าบริการตั้งแต่ต้น แทนที่จะพึ่งพานิสัยการต่ออายุในภายหลัง เหมาะสำหรับการเก็บถาวรประวัติ เอกสารสำคัญ และสื่อที่มีลิขสิทธิ์ซึ่งต้องการบันทึกที่ไม่สามารถแก้ไขได้ จุดอ่อนก็ชัดเจนเช่นกัน: ความถาวรไม่ได้แปลว่ามีความพร้อมสูงและความหน่วงต่ำโดยอัตโนมัติ ในทางปฏิบัติยังต้องเพิ่มเลเยอร์แคช เกตเวย์ หรือเลเยอร์ดัชนีแบบใกล้ชิด เพื่อตอบสนองประสบการณ์แบบเรียลไทม์ของผู้ใช้
นอกจากสามรูปแบบพื้นฐานนี้ ในทางวิศวกรรมยังมีสองรูปแบบผสมที่พบบ่อยซึ่งควรพิจารณา รูปแบบแรกคือการผสมระหว่างเลเยอร์ความพร้อมใช้งานของข้อมูลกับการจัดเก็บแบบอ็อบเจกต์ ซึ่งการเผยแพร่ข้อมูลและการพิสูจน์ความพร้อมใช้งานเป็นมาตรฐานมากขึ้น แต่แลกมาด้วยความซับซ้อนในการทำงานร่วมกันข้ามเลเยอร์และต้นทุนการจัดการอินเทอร์เฟซที่สูง อีกรูปแบบคือการทำงานร่วมกันระหว่างคลาวด์หลายแห่งกับเอดจ์ ซึ่งให้ความหน่วงต่ำและการกู้คืนจากภัยพิบัติที่ดีกว่า แต่การจัดการต้นทุนและการจัดการความสอดคล้องกันนั้นยากที่จะควบคุม
ไม่ว่าจะเลือกแบบไหน โปรโตคอลเดียวที่กินทุกสถานการณ์นั้นเป็นไปไม่ได้ในทางวิศวกรรม วิธีที่มีประสิทธิภาพคือการรวมตามประเภทข้อมูล: แยกความคงทน ความหน่วงในการค้นคืน และการปฏิบัติตามข้อกำหนดออกจากกัน จับคู่กับเลเยอร์ความสามารถที่เหมาะสม จากนั้นใช้เลเยอร์การยึดเกาะบนเชนและการจัดการเพื่อจัดระเบียบแบบรวมศูนย์
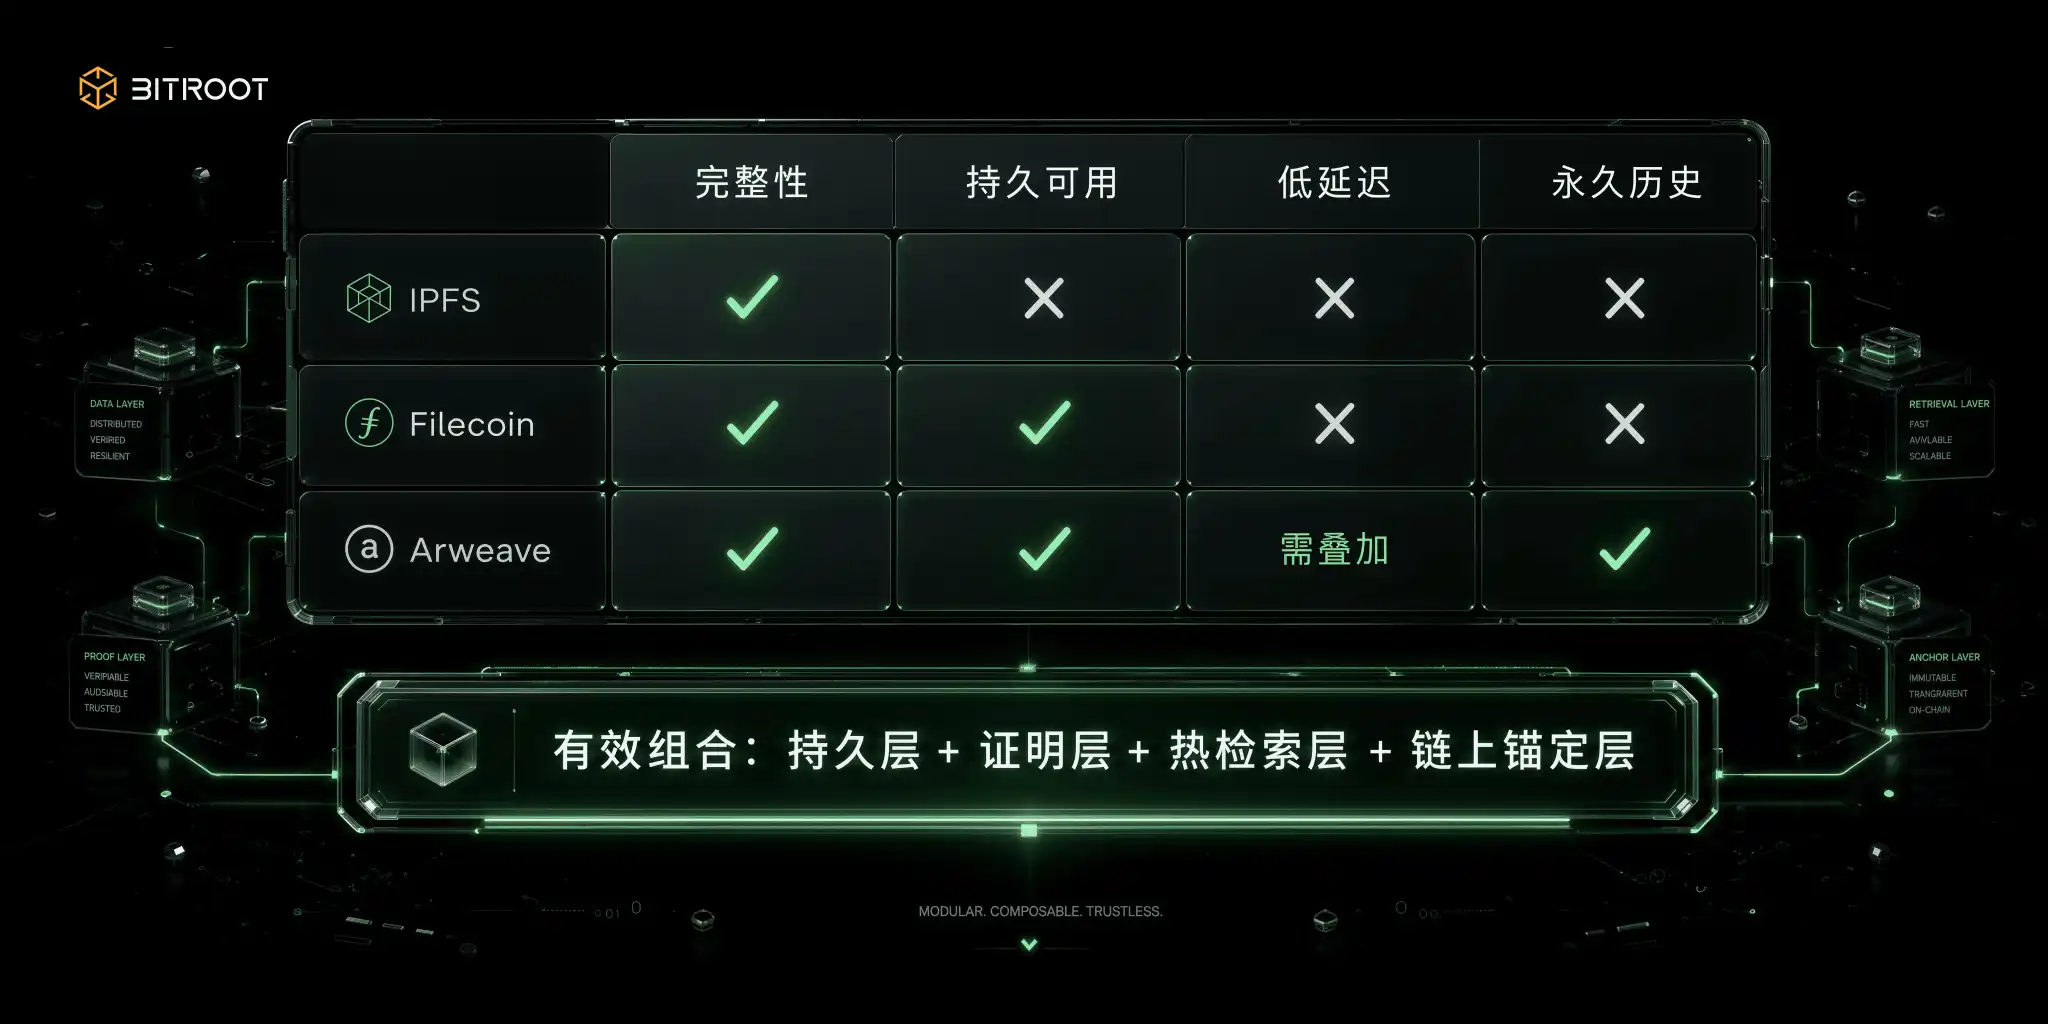
พื้นที่การเลือกของ Bitroot ควรถูกสร้างขึ้นบนตรรกะการผสมผสานนี้เช่นกัน: ไม่ใช่การนำ IPFS, Filecoin, Arweave หรือ Object Storage มาแทนที่กัน แต่เป็นการวางไว้ในชั้นความรับผิดชอบที่แตกต่างกัน การระบุตำแหน่งด้วยเนื้อหา (Content Addressing) ใช้สำหรับข้อมูลประจำตัวและความสมบูรณ์ของข้อมูล หลักฐานการจัดเก็บ (Storage Proof) ใช้สำหรับความพร้อมใช้งานในระยะยาว ชั้นถาวร (Permanent Layer) ใช้สำหรับประวัติศาสตร์และข้อมูลรับรองที่สำคัญ ชั้นการดึงข้อมูลแบบร้อน (Hot Retrieval Layer) ใช้สำหรับประสบการณ์แอปพลิเคชัน AI และชั้นบนของเชน Bitroot จะทำหน้าที่รวมศูนย์การยึดโยงเวอร์ชัน นโยบายสิทธิ์ การชำระบัญชีการเรียกใช้ และการจัดการข้อพิพาท กล่าวอีกนัยหนึ่ง Bitroot ไม่จำเป็นต้องเป็นคลังข้อมูลทางกายภาพของข้อมูลทั้งหมด แต่ต้องเป็นบัญชีแยกประเภทที่เชื่อถือได้ (Trusted Ledger) สำหรับกระแสคุณค่าของข้อมูล AI
ความยากของ AI Storage ไม่ได้อยู่ที่การจัดเก็บไฟล์ แต่อยู่ที่การจัดการห่วงโซ่การผลิต
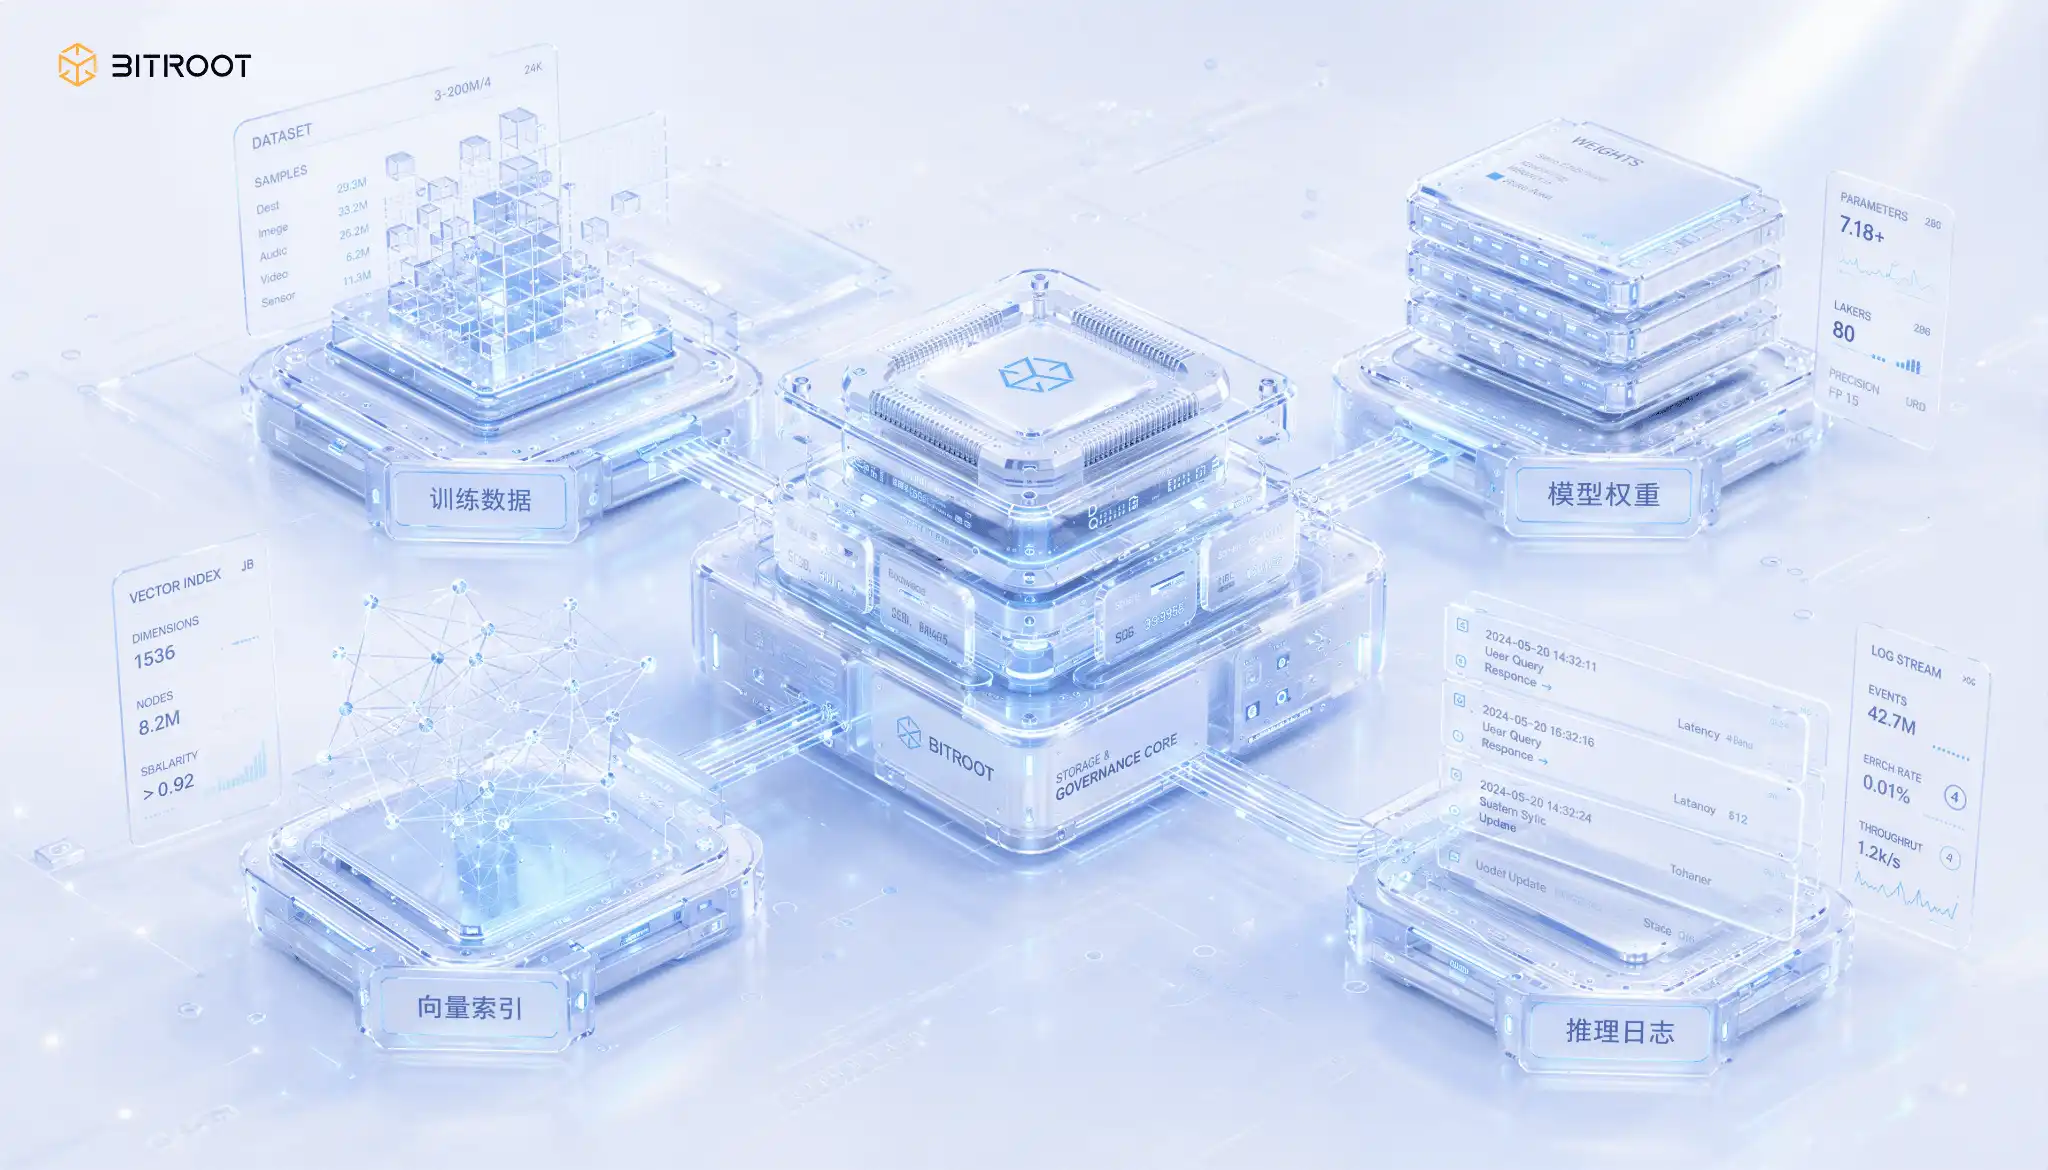
ในสถานการณ์ AI ออบเจกต์การจัดเก็บแบ่งออกเป็นอย่างน้อยสี่ประเภท: ข้อมูลฝึกอบรม (Training Data), น้ำหนักโมเดล (Model Weights), ดัชนีเวกเตอร์ (Vector Index), และบันทึกการอนุมาน (Inference Logs) วงจรชีวิต รูปแบบการเข้าถึง และความหนาแน่นของคุณค่าของทั้งสี่ประเภทนี้แตกต่างกันโดยสิ้นเชิง การจัดการด้วยนโยบายเดียวอาจช่วยประหยัดในระยะสั้น แต่ในระยะยาวจะนำไปสู่การสูญเสียการควบคุมการกำกับดูแลอย่างแน่นอน
ปัญหาของข้อมูลฝึกอบรมไม่ได้อยู่ที่ความจุ แต่อยู่ที่การเลื่อนไหลของเวอร์ชัน (Version Drift) หลายทีมมองว่าปัญหาข้อมูลฝึกอบรมเทียบเท่ากับค่าใช้จ่ายในการจัดเก็บระดับ TB แต่สิ่งที่ยุ่งยากกว่าจริงๆ คือการเลื่อนไหล: ทุกครั้งที่กฎการทำความสะอาด เกณฑ์การคัดเลือกตัวอย่าง หรือมาตรฐานการติดป้ายกำกับเปลี่ยนแปลง พฤติกรรมของโมเดลก็จะเปลี่ยนตามไปด้วย และหากไม่มีการผูกโยงระหว่างเวอร์ชันข้อมูลและเวอร์ชันโมเดล การประเมินแบบออฟไลน์ก็จะยากต่อการตรวจสอบซ้ำ ตามแนวทางปฏิบัติของ MLflow ในการติดตามโมเดลและข้อมูล การผูกโยงการรันการฝึกอบรมกับเวอร์ชันข้อมูลเป็นข้อกำหนดเบื้องต้นสำหรับการทดลองซ้ำได้ หลักการนี้ยังคงใช้ได้เมื่อนำไปใช้บนเชน: ข้อมูลดิบไม่จำเป็นต้องถูกนำขึ้นเชนทั้งหมด แต่คำมั่นสัญญาเกี่ยวกับเวอร์ชัน บทสรุปสำคัญ และลายนิ้วมือของแหล่งที่มาต้องถูกยึดโยงบนเชน ในทางวิศวกรรม อย่างน้อยต้องผูกโยงสามตัวระบุ: เวอร์ชันข้อมูล, การรันการฝึกอบรม, และเวอร์ชันโมเดล หากขาดไปหนึ่งตัว การย้อนรอยปัญหาจากระบบออนไลน์จะเปลี่ยนจากการตรวจสอบหลักฐานเป็นการเดาสาเหตุ
ปัญหาของน้ำหนักโมเดล มักไม่ใช่ว่าจะดาวน์โหลดได้หรือไม่ แต่เป็นว่าใครจะจัดการขอบเขตการเรียกใช้ เมื่อโมเดลเข้าสู่การผลิต โดยทั่วไปจะต้องผ่านหลายสถานะ: การทดสอบแบบค่อยเป็นค่อยไป (Gray Release), การใช้งานหลัก (Main), การย้อนกลับ (Rollback), และการปลดระวาง (Retirement) หากไม่มีระบบการลงทะเบียนและการอนุญาตที่ได้มาตรฐาน การเรียกใช้บนระบบออนไลน์ก็จะเป็นกล่องดำที่ไม่สามารถตรวจสอบได้ ศูนย์รวมโมเดล (Model Registry) ที่สมบูรณ์จะบันทึกทั้งสายเลือด (Lineage), นามแฝงเวอร์ชัน (Version Alias), ข้อจำกัดลายเซ็น (Signature Constraint), และป้ายกำกับการตรวจสอบ (Audit Tag) สำหรับระบบบนเชน เวอร์ชันโมเดลไม่ควรเป็นเพียงแฮชของไฟล์ แต่ต้องผูกโยงกับนโยบายสิทธิ์ การกระจายผลตอบแทน และขอบเขตความรับผิดชอบ
ความยากของดัชนีเวกเตอร์กระจุกตัวอยู่ในจุดเดียว: ความสอดคล้องหลังจากการแบ่งชั้นร้อนและเย็น (Hot-Cold Tiering) การดึงข้อมูลเวกเตอร์มีความขัดแย้งโดยธรรมชาติ: ความหน่วงต่ำและต้นทุนต่ำเป็นปฏิปักษ์ต่อกัน ชั้นร้อนต้องพึ่งพาหน่วยความจำหรือบริการดัชนีประสิทธิภาพสูงเพื่อรับประกันการตอบสนองแบบออนไลน์ ในขณะที่ชั้นเย็นต้องพึ่งพา Object Storage เพื่อควบคุมต้นทุนระยะยาว หากไม่มีข้อมูลเมตาที่เป็นหนึ่งเดียวและกลยุทธ์การซิงโครไนซ์ ทั้งสองชั้นจะแยกออกจากกันอย่างรวดเร็ว และในที่สุดจะนำไปสู่ปัญหาที่การค้นหาเดียวกันให้ผลลัพธ์ความหมายที่แตกต่างกันในโหนดต่างๆ ดังนั้นระบบเวกเตอร์ต้องรองรับสองสิ่ง: กระบวนการสร้างดัชนีต้องสามารถติดตามได้ และเวอร์ชันดัชนีของชั้นร้อนต้องสามารถตรวจสอบได้กับข้อมูลหลักของชั้นเย็น ซึ่งนี่คือสิ่งที่การดึงข้อมูลที่ตรวจสอบได้ (Verifiable Retrieval) ในภายหลังจะต้องแก้ไข
บันทึกการอนุมาน (Inference Logs) ทำให้ความเป็นส่วนตัว การตรวจสอบ และการปฏิบัติตามข้อกำหนด (Compliance) เกิดขึ้นพร้อมกันได้ยาก มันเป็นทั้งวัสดุสำหรับการตรวจสอบความปลอดภัยและแหล่งที่มาของความเสี่ยงด้านความเป็นส่วนตัว: การเก็บรักษาข้อมูลต้นฉบับทั้งหมดในรูปแบบข้อความธรรมดาทำให้เกิดความเสี่ยงด้านการปฏิบัติตามข้อกำหนด ในขณะที่การไม่เก็บรักษาเลยก็ทำให้สูญเสียความสามารถในการวิเคราะห์เหตุการณ์ย้อนหลัง วิธีที่可行คือการซ้อนทับสามชั้น: เนื้อหาถูกทำให้ไม่ระบุตัวตน (Desensitized) ก่อนจัดเก็บ, แฮช (Hash) ถูกผูกมัด (Commit) ไว้บนเชน (On-chain), และการเข้าถึงต้องได้รับอนุญาตผ่านการตรวจสอบ (Audit Authorization) โดยแยกชั้นการไม่สามารถแก้ไขได้ (Immutability) และการเข้าถึงที่สามารถเพิกถอนได้ (Revocable Access) ออกจากกัน
ใน AI Stack ของ Bitroot วัตถุทั้งสี่ประเภทนี้สามารถสอดคล้องกับการดำเนินการด้านการกำกับดูแล (Governance Actions) สี่แบบ: ข้อมูลฝึกอบรม (Training Data) ทำการยึดโยงเวอร์ชัน (Version Anchoring) และการลงทะเบียนแหล่งที่มา (Source Registration), น้ำหนักโมเดล (Model Weights) ทำการลงทะเบียนสินทรัพย์ (Asset Registration) และการเรียกใช้ที่ได้รับอนุญาต (Authorized Invocation), ดัชนีเวกเตอร์ (Vector Index) ทำการแบ่งชั้นร้อน-เย็น (Hot-Cold Tiering) และการพิสูจน์ความสอดคล้อง (Consistency Proofs), บันทึกการอนุมาน (Inference Logs) ทำการจัดเก็บที่ทำให้ไม่ระบุตัวตน (Desensitized Storage) และคำมั่นสัญญาในการตรวจสอบ (Audit Commitments) พวกมันไม่จำเป็นต้องถูกนำขึ้นเชน (On-chain) ในรูปแบบเดียวกัน แต่ทั้งหมดจำเป็นต้องสร้าง ID สินทรัพย์ (Asset ID), สายเลือดเวอร์ชัน (Version Lineage) และเหตุการณ์การเรียกใช้ (Invocation Events) ที่เป็นหนึ่งเดียวบน Bitroot ด้วยวิธีนี้เท่านั้น จึงจะสามารถสร้างวงจรธุรกิจที่นำกลับมาใช้ใหม่ได้ (Reusable Business Loop) ระหว่างสินทรัพย์ข้อมูล (Data Assets), สินทรัพย์โมเดล (Model Assets) และแอปพลิเคชัน Agent
ความสามารถในการตรวจสอบได้ (Verifiability) คือเส้นต่ำสุด (Baseline) การพิสูจน์ความพร้อมใช้งาน (Proof of Usability) ต่างหากที่เป็นจุดแบ่งแยก (Dividing Line)
คำมั่นสัญญาในการจัดเก็บ (Storage Commitments) ที่ปราศจากการพิสูจน์ความพร้อมใช้งาน (Proof of Usability) ในสภาพแวดล้อมการผลิต (Production Environment) นั้นแทบจะเท่ากับไม่มีคำมั่นสัญญาเลย การจัดเก็บแบบกระจายศูนย์ (Distributed Storage) เพื่อเข้าสู่การผลิต ต้องผ่านอย่างน้อยสามด่าน: ความสมบูรณ์ที่พิสูจน์ได้ (Provable Integrity), ความพร้อมใช้งานที่พิสูจน์ได้ (Provable Availability), และพฤติกรรมที่ตรวจสอบได้ (Auditable Behavior); เมื่อเข้าสู่สถานการณ์การค้นคืนของ AI (AI Retrieval Scenarios) จะต้องเพิ่มด่านที่ยากที่สุดอีกหนึ่งด่าน นั่นคือ การค้นคืนที่พิสูจน์ได้ (Provable Retrieval)
ความสมบูรณ์ที่พิสูจน์ได้ (Provable Integrity) อาศัยการระบุตำแหน่งตามเนื้อหา (Content Addressing) รวมกับคำมั่นสัญญาแบบ Merkle (Merkle Commitments) การระบุตำแหน่งตามเนื้อหาช่วยให้ลายนิ้วมือข้อมูล (Data Fingerprint) มีความเสถียร ส่วนคำมั่นสัญญาแบบ Merkle ช่วยให้สามารถตรวจสอบได้ในระดับท้องถิ่น (Locally Verifiable) ความสำคัญทางวิศวกรรมคือ คุณสามารถใช้การพิสูจน์ระดับชิ้นส่วน (Shard-level Proofs) เพื่อตรวจสอบชุดย่อยของออบเจ็กต์ โดยไม่ต้องอ่านข้อมูลทั้งหมดทุกครั้ง สำหรับน้ำหนักของโมเดลขนาดใหญ่ (Large Model Weights), คลังข้อมูลขนาดใหญ่ (Large Corpora) และข้อมูลมัลติมีเดีย (Multimedia Data) จุดนี้จะกำหนดต้นทุนการตรวจสอบ (Verification Cost) โดยตรง
ความพร้อมใช้งานที่พิสูจน์ได้ (Provable Availability) อาศัยกลไกการท้าทาย (Challenge Mechanism) และการตรวจสอบแบบสุ่ม (Sampling Verification) การปฏิบัติของ Filecoin ได้แสดงให้เห็นแล้วว่าความพร้อมใช้งานไม่ใช่ SLA แบบวาจา แต่เป็นการท้าทายตามรอบ (Periodic Challenges) บวกกับการพิสูจน์บนเชน (On-chain Proofs) เมื่อสรุปเป็นสถาปัตยกรรมทั่วไป (Generic Architecture) ก็คือสามองค์ประกอบ: การสุ่มตรวจสอบแบบพาสซีฟ (Passive Spot Checks), การตรวจสอบเชิงรุก (Active Patrols), และการลงโทษเมื่อล้มเหลว (Failure Penalties) โหนด (Nodes) ต้องตอบสนองต่อการท้าทายภายในหน้าต่างที่กำหนด มิฉะนั้นจะถูกหักคะแนนหรือลดน้ำหนัก แนวคิดเดียวกันนี้ไปได้ไกลกว่าในชั้นความพร้อมใช้งานของข้อมูล (Data Availability Layer) ตามการออกแบบการสุ่มตัวอย่างความพร้อมใช้งานของข้อมูล (Data Availability Sampling) ของ Celestia ข้อมูลถูกขยายจากเมทริกซ์ k×k เป็น 2k×2k โหนดเบา (Light Nodes) ผ่านการสุ่มตัวอย่างหลายรอบและการสะสมความน่าจะเป็น (Probability Accumulation) โดยไม่ต้องดาวน์โหลดข้อมูลทั้งก้อน ก็สามารถสร้างความมั่นใจในความพร้อมใช้งานด้วยความน่าจะเป็นสูง สิ่งนี้ให้แรงบันดาลใจที่สามารถถ่ายโอนได้สำหรับสถานการณ์ AI: เมื่อเผชิญกับออบเจ็กต์ขนาดใหญ่พิเศษ (Super-large Objects) และการเข้าถึงพร้อมกันสูง (High-concurrency Access) ไม่ใช่ทุกความพร้อมใช้งานที่ต้องตรวจสอบด้วยการดาวน์โหลดทั้งหมด การยืนยันทางสถิติ (Statistical Confirmation) นั้นสมจริงกว่าในระบบขนาดใหญ่
พฤติกรรมที่ตรวจสอบได้ (Auditable Behavior) อาศัยการยึดโยงบนเชน (On-chain Anchoring) บวกกับการทิ้งร่องรอยเหตุการณ์ (Event Tracing) สิ่งที่ระบบจัดเก็บจัดการได้ยากที่สุดคือพฤติกรรม: ใครอัปโหลดอะไร, ใครเปลี่ยนนโยบาย, ใครทำให้เกิดการย้ายข้อมูล, ใครเรียกใช้โมเดลที่ละเอียดอ่อน (Sensitive Model) เมื่อใด หากพฤติกรรมเหล่านี้ไม่ถูกรวบรวมเป็นกระแสเหตุการณ์ (Event Stream) ที่เป็นหนึ่งเดียว เมื่อเกิดข้อโต้แย้งก็จะกลับไปสู่สถานะที่ไม่มีหลักฐานเป็นลายลักษณ์อักษร (Word of Mouth) สิ่งที่ชั้นการกำกับดูแล (Governance Layer) ต้องทำไม่ใช่การนำรายละเอียดทั้งหมดขึ้นเชน แต่เมื่อเกิดข้อโต้แย้ง ให้มีชุดหลักฐานที่เล็กที่สุด แน่นอนที่สุด และตรวจสอบได้ (Minimal, Deterministic, and Verifiable Evidence Set) อยู่ในมือ
การตรวจสอบการค้นหาเป็นปัญหาที่มีเฉพาะในสถานการณ์ AI และยากที่สุด ปัญหามาจากช่องโหว่ที่มักถูกมองข้าม: การส่งคืนผลลัพธ์ไม่ได้หมายความว่าส่งคืนผลลัพธ์ที่ถูกต้อง โหนดค้นหาเวกเตอร์สามารถใช้ดัชนีที่หมดอายุ หรือแม้กระทั่งข้ามเพื่อนบ้านที่ใกล้ที่สุดจริงๆ แล้วส่งคืน top-k ที่ดูสมเหตุสมผลให้คุณ แต่คุณไม่สามารถแยกแยะได้จากค่าที่ส่งคืนเพียงอย่างเดียว ผลลัพธ์ของการค้นหาเชิงความหมายไม่มีการพิสูจน์ตัวเอง ข้อผิดพลาดจะไม่แจ้งเตือน แต่จะลดคุณภาพการเรียกคืนและประสิทธิภาพของโมเดลอย่างเงียบๆ เมื่อผลการค้นหาต้องใช้ในการชำระเงิน การอนุญาต หรือการตัดสินใจบนเชน ช่องโหว่นี้จะเปลี่ยนจากปัญหาคุณภาพเป็นปัญหาความไว้วางใจ
เมื่อแยกการตรวจสอบการค้นหาออก จะเห็นว่ามีการรับประกันสามระดับที่ยากขึ้นเรื่อยๆ ระดับแรกคือการตรวจสอบเนื้อหา พิสูจน์ว่าเวกเตอร์ที่ส่งคืนเป็นของเวอร์ชันดัชนีที่ได้รับการยืนยันแล้ว วิธีการคือสร้างโครงสร้างข้อมูลการรับรองสำหรับดัชนี ใช้ Merkle commitment เพื่อนำรากของดัชนีขึ้นเชน และแนบหลักฐานการรวมเมื่อส่งคืนผลลัพธ์ เพื่อให้แน่ใจว่าโหนดไม่ได้สร้างข้อมูลขึ้นมาเองหรือสับเปลี่ยนข้อมูล ระดับที่สองคือการตรวจสอบการดำเนินการ พิสูจน์ว่าการค้นหานี้ดำเนินการบนเวอร์ชันที่ได้รับการยืนยันจริง ไม่ใช่บนดัชนีที่ถูกแก้ไขเป็นการส่วนตัว ซึ่งต้องรวมกระบวนการค้นหาเข้าในขอบเขตของการคำนวณที่ตรวจสอบได้ ระดับที่สามยากที่สุดคือการตรวจสอบผลลัพธ์ พิสูจน์ว่า top-k ที่ส่งคืนเป็นเพื่อนบ้านที่ใกล้ที่สุดจริงภายใต้เมตริกที่กำหนด ไม่ใช่การละเว้นเพื่อนบ้านที่ใกล้กว่า ซึ่งโดยพื้นฐานแล้วต้องให้หลักฐานความถูกต้องสำหรับการค้นหาเพื่อนบ้านใกล้เคียงแบบประมาณ
การทำการตรวจสอบผลลัพธ์ที่เข้มงวดสำหรับการค้นหาเพื่อนบ้านใกล้เคียงแบบประมาณในมิติสูงในระดับการผลิต ยังคงเป็นหัวข้อ前沿 ถึงแม้วิธีการเข้ารหัสเช่น zero-knowledge proof จะก้าวหน้า แต่ค่าใช้จ่ายในการพิสูจน์การคำนวณเวกเตอร์มิติสูงยังห่างไกลจากการใช้งานออนไลน์ขนาดใหญ่ วิธีแก้ปัญหาทางวิศวกรรมที่ปฏิบัติได้คือการแบ่งชั้นป้องกันแทนที่จะทำทีเดียว: ขั้นแรก นำเวอร์ชันดัชนีและพารามิเตอร์การสร้างขึ้นเชนเพื่อให้สามารถตรวจสอบย้อนกลับได้ จากนั้น สุ่มคำนวณซ้ำสำหรับการค้นหา โดยสุ่มสัดส่วนของการค้นหาออนไลน์ไปยังสำเนาที่เชื่อถือได้เพื่อคำนวณใหม่และเปรียบเทียบผลลัพธ์ ใช้ความเชื่อมั่นทางสถิติแทนการพิสูจน์ทีละรายการ พร้อมกันนี้ ให้โหนดอิสระหลายโหนดค้นหาซ้ำซ้อนและหาฉันทามติจากผลลัพธ์ที่ส่งคืน เพื่อเพิ่มต้นทุนของการโกงจุดเดียว เมื่อการเปรียบเทียบหรือฉันทามติเกิดความขัดแย้งเท่านั้น จึงจะอัปเกรดเป็นการคำนวณซ้ำทั้งหมดและการตัดสินบนเชนสำหรับการค้นหาที่มีข้อโต้แย้ง เส้นทางนี้สอดคล้องกับแนวคิดที่ให้ความสำคัญกับการสุ่มตรวจสอบในหลักฐานความพร้อมใช้งาน: ในระบบขนาดใหญ่ การยืนยันทางสถิติและการอัปเกรดข้อโต้แย้งมักจะนำไปปฏิบัติได้มากกว่าการพิสูจน์ทีละรายการอย่างเข้มงวด
สำหรับ Bitroot การค้นหาที่ตรวจสอบได้ไม่ใช่ฟังก์ชันการจัดเก็บที่แยกเดี่ยว แต่เป็นส่วนหนึ่งของการดำเนินการที่เชื่อถือได้ของ AI Agent หาก Agent บนเชนต้องพึ่งพาฐานความรู้ภายนอก น้ำหนักโมเดล หรือดัชนีเวกเตอร์ในการตัดสินใจ ระบบควรตอบสามสิ่งได้เป็นอย่างน้อย: มันอ่านข้อมูลเวอร์ชันใด เรียกใช้โมเดลเวอร์ชันใด และผลลัพธ์ที่ส่งคืนมาจากเวอร์ชันดัชนีที่ลงทะเบียนหรือไม่ Bitroot สามารถบีบอัดหลักฐานเหล่านี้เป็นเหตุการณ์ที่ตรวจสอบได้บนเชน ทำให้พฤติกรรมของ Agent เปลี่ยนจาก "ดูฉลาด" เป็น "ตรวจสอบย้อนกลับ โต้แย้งได้ และชำระเงินได้"
ปัญหาที่แท้จริงของการเลือก: ไม่ใช่การเลือกโปรโตคอล แต่เป็นการจัดพอร์ตโฟลิโอ
การประเมินแผนงานหลายครั้งล้มเหลว เพราะตั้งคำถามผิด คำถามที่ถูกต้องไม่ใช่ "เราจะใช้โปรโตคอลนี้หรือไม่" แต่คือ "ชุดข้อมูลของเราคืออะไร ตัวชี้วัดเป้าหมายคืออะไร ข้อจำกัดคืออะไร" แนะนำให้ดำเนินการตามสี่ขั้นตอน
ขั้นแรก ทำการสำรวจสินทรัพย์ข้อมูล อย่างน้อยต้องแยกข้อมูลสถานะ ข้อมูลออบเจ็กต์ ข้อมูลการค้นหา และข้อมูลการตรวจสอบ ทำเทมเพลตการสำรวจเป็นฟิลด์คงที่ อย่างน้อยแปดรายการ: ประเภทข้อมูล ปริมาณเพิ่มรายวัน ค่าสูงสุดพร้อมกัน อัตราการอ่าน/เขียน รอบการเก็บรักษา ระดับการปฏิบัติตามข้อกำหนด เป้าหมายเวลาแฝง และขีดจำกัดต้นทุนต่อ TB เมื่อฟิลด์เป็นมาตรฐาน การสื่อสารข้ามทีมในการเลือกจะเร็วขึ้นมาก
จากนั้น กำหนดเป้าหมายระดับบริการ กำหนดค่า P95/P99 latency, RTO (เวลาในการกู้คืน), RPO (จุดกู้คืน), เป้าหมายความพร้อมใช้งาน และขีดจำกัดต้นทุนต่อ TB ให้ชัดเจน มิฉะนั้น การอภิปรายทั้งหมดที่ตามมาจะไม่มีมาตรวัด
ต่อมา สร้างแผนที่ความสามารถ จับคู่ความสามารถต่างๆ เช่น การจัดเก็บถาวร การพิสูจน์ความพร้อมใช้งานตามรอบเวลา การค้นหาความหน่วงต่ำ และการจัดการการเข้าถึง ไปยังเลเยอร์เทคโนโลยีที่แตกต่างกัน อย่าคาดหวังให้เลเยอร์เดียวครอบคลุมทุกอย่าง
สุดท้าย กำหนดเกณฑ์การย้ายข้อมูล ข้อมูลใดที่อนุญาตให้โฮสต์แบบรวมศูนย์ในช่วงเปลี่ยนผ่าน ตัวชี้วัดใดที่กระตุ้นให้เกิดการย้าย และเมื่อใดที่ต้องเปลี่ยนเป็นแบบกระจายศูนย์ให้เสร็จสมบูรณ์ วิธีปฏิบัติที่เป็นประโยชน์คือการตั้งค่าเกณฑ์คู่: หากต้นทุนต่อ TB เกินงบประมาณสองรอบสถิติติดต่อกัน หรือ P95 latency เกินเป้าหมายสองสัปดาห์ติดต่อกัน ให้เริ่มการประเมินการย้ายสถาปัตยกรรมโดยอัตโนมัติ หากไม่มีเกณฑ์ ก็ไม่มีการกำกับดูแล และช่วงเปลี่ยนผ่านจะกลายเป็นสถานะถาวร
แผนการดำเนินงาน: สถาปัตยกรรมห้าเลเยอร์ ปิดวงจรการจัดเก็บ การเข้าถึง และการจัดการ
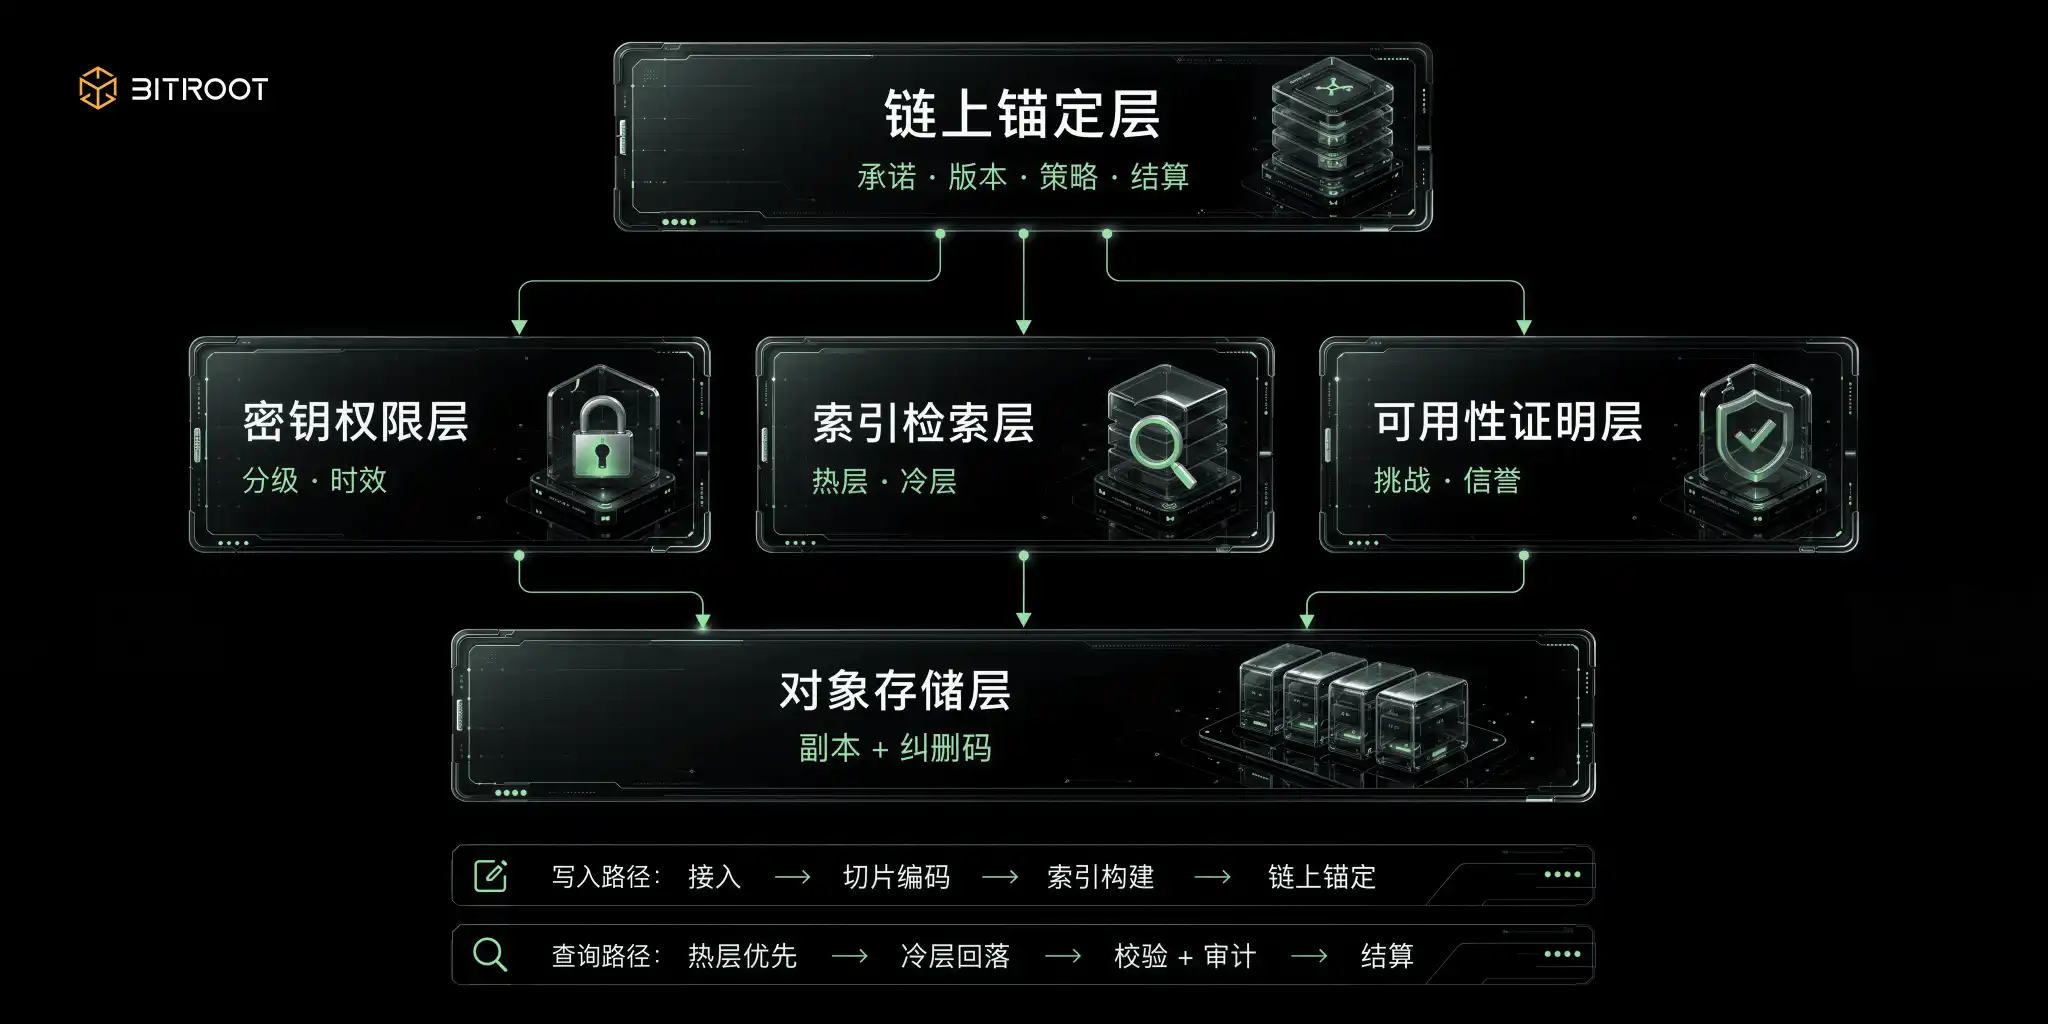
คุณค่าของสถาปัตยกรรมไม่ได้อยู่ที่จำนวนเลเยอร์ แต่อยู่ที่ความสามารถในการสร้างวงจรปิดที่ตรวจสอบได้ จากกรอบงานข้างต้น แผนงานจะรวมเป็นห้าเลเยอร์: เลเยอร์ยึดเหนี่ยวบนเชน, เลเยอร์จัดเก็บออบเจ็กต์, เลเยอร์ดัชนีค้นหา, เลเยอร์พิสูจน์ความพร้อมใช้งาน, และเลเยอร์สิทธิ์คีย์ เป้าหมายคือทำให้การตรวจสอบได้เป็นความสามารถเริ่มต้น ทำให้ประสิทธิภาพสูงเป็นความสามารถที่ปรับแต่งได้ และทำให้การกำกับดูแลเป็นกระบวนการที่ดำเนินการได้
ใน Bitroot ห้าเลเยอร์นี้สามารถเข้าใจเพิ่มเติมได้ว่าเป็นโมดูลการกำกับดูแลการจัดเก็บของ AI Stack: Parallel EVM ให้ความสามารถในการยึดเหนี่ยวและชำระบัญชีความถี่สูง, Pipeline BFT ให้ความแน่นอนของความหน่วงต่ำ, เครือข่ายจัดเก็บแบบกระจายศูนย์รองรับออบเจ็กต์ขนาดใหญ่และข้อมูลประวัติ, เลเยอร์ดัชนีค้นหาให้บริการ AI Agent และการเรียกใช้แอปพลิเคชัน, เลเยอร์พิสูจน์ความพร้อมใช้งานแปลงคุณภาพบริการของโหนดเป็นชื่อเสียงและรางวัล, และเลเยอร์สิทธิ์คีย์เชื่อมต่ออำนาจอธิปไตยของผู้ใช้ การปกป้องความเป็นส่วนตัว และการอนุญาตเชิงพาณิชย์ของโมเดล
เลเยอร์ยึดเหนี่ยวบนเชนจัดเก็บเฉพาะสถานะที่จำเป็นขั้นต่ำ: คำมั่นสัญญาของข้อมูล, ลายนิ้วมือเวอร์ชัน, สรุปนโยบายสิทธิ์, และเหตุการณ์การชำระบัญชี ออบเจ็กต์ขนาดใหญ่ไม่ถูกจัดเก็บไว้บนเชน สิ่งที่จัดเก็บไว้บนเชนคือหลักฐานว่าออบเจ็กต์นั้นมีอยู่และเวอร์ชันถูกต้อง ซึ่งช่วยรักษาความสามารถในการตรวจสอบบนเชน โดยไม่ให้ปริมาณงานถูกถ่วงด้วยไฟล์ขนาดใหญ่
ในบริบทของสถาปัตยกรรม Bitroot ชั้นการยึดโยงบนเชน (On-chain Anchoring Layer) ไม่ใช่แค่สถานที่สำหรับ "บันทึกแฮช" เท่านั้น แต่เป็นจุดเข้าสู่ระบบร่วมสำหรับการลงทะเบียนสินทรัพย์ AI การกำกับสิทธิ์ การกระจายผลตอบแทน และการตัดสินข้อพิพาท ชุดข้อมูล น้ำหนักโมเดล ดัชนีเวกเตอร์ และบันทึกการอนุมานสามารถจัดเก็บนอกเชนในรูปแบบที่เหมาะสมที่สุด แต่คำมั่นสัญญาของเวอร์ชัน สถานะการอนุญาต บันทึกการเรียกใช้ และการ归属ผลตอบแทนของข้อมูลเหล่านี้จำเป็นต้องเข้าสู่สถานะบนเชนของ Bitroot ด้วยวิธีนี้ การจัดเก็บนอกเชนจะรับผิดชอบในการรองรับปริมาณข้อมูล ในขณะที่ Bitroot จะรับผิดชอบในการรองรับความไว้วางใจ
ชั้นการจัดเก็บออบเจ็กต์ (Object Storage Layer) รองรับข้อมูลจริง โดยใช้กลยุทธ์แบบผสมระหว่าง Erasure Coding และการทำสำเนา: ออบเจ็กต์ที่มีมูลค่าสูงและเข้าถึงน้อยจะเน้นความทนทานต่อข้อผิดพลาด ส่วนออบเจ็กต์ที่มีมูลค่าปานกลางและเข้าถึงบ่อยจะเน้นประสิทธิภาพในการค้นคืน กลยุทธ์นี้ไม่ใช่การกำหนดค่าแบบคงที่ แต่จะปรับเปลี่ยนแบบไดนามิกตามความร้อนแรงของการเข้าถึงและระดับธุรกิจ
ชั้นการค้นคืนดัชนี (Index Retrieval Layer) รวมดัชนีเมทาดาทาและดัชนีเวกเตอร์เข้าไว้ในไดเรกทอรีเดียว โดยชั้นร้อน (Hot Layer) รองรับการค้นคืนแบบออนไลน์ และชั้นเย็น (Cold Layer) รองรับการเก็บถาวรและการสร้างใหม่ ทุกเวอร์ชันของดัชนีต้องลงทะเบียนเวอร์ชันของแหล่งข้อมูลและพารามิเตอร์การสร้าง มิฉะนั้นจะไม่สามารถติดตามความรับผิดชอบเมื่อเกิดการเบี่ยงเบนของดัชนี
ชั้นการพิสูจน์ความพร้อมใช้งาน (Availability Proof Layer) ทำให้พฤติกรรมของโหนดเป็นเชิงปริมาณ อัตราความสำเร็จในการตอบสนองต่อความท้าทาย เวลาแฝงในการตอบสนอง และอัตราความสำเร็จในการซ่อมแซม จะถูกนำเข้าสู่คะแนนความน่าเชื่อถือ ซึ่งจะเชื่อมโยงกับการกระจายรางวัล เพื่อหลีกเลี่ยงการให้รางวัลเฉพาะความจุโดยไม่สนใจความพร้อมใช้งาน
ชั้นการควบคุมคีย์และสิทธิ์ (Key Permission Layer) ควบคุมการเข้าถึงและการปฏิบัติตามข้อกำหนด ข้อมูลที่มีความละเอียดอ่อนสูงใช้คีย์แบบ分级และการอนุญาตแบบจำกัดเวลา บันทึกการอนุมานใช้การจัดเก็บแบบไม่ระบุตัวตนพร้อมการตรวจสอบย้อนหลัง การเรียกใช้โมเดลใช้ใบอนุญาตที่สามารถเพิกถอนได้ การดำเนินการเกี่ยวกับสิทธิ์เองก็ต้องมีร่องรอยเพื่อป้องกันการเบี่ยงเบนของการกำหนดค่า
ทั้งห้าชั้นนี้เป็นวงจรปิดในระดับการดำเนินการ ไม่ใช่สายการผลิตทางเดียว: เมื่อข้อมูลถูกนำเข้า จะถูกแบ่งส่วนและเข้ารหัสก่อนเข้าสู่ชั้นออบเจ็กต์ หลังจากเขียนข้อมูลแล้ว จะสร้างดัชนีและยึดโยงบนเชน การค้นหาแบบออนไลน์จะไปที่ชั้นร้อน หากไม่พบจะย้อนกลับไปที่ชั้นเย็น ในขณะที่ส่งคืนผลลัพธ์ จะมีการตรวจสอบความสมบูรณ์และสิทธิ์พร้อมกัน และการกระทำที่สำคัญจะเข้าสู่กระบวนการชำระบัญชีและการตรวจสอบ คุณค่าที่แท้จริงของห่วงโซ่นี้คือ โหนดใดก็ตาม ในเวลาใดก็ตาม สามารถตอบคำถามสี่ข้อได้: ข้อมูลมาจากไหน เวอร์ชันปัจจุบันคืออะไร ใครมีสิทธิ์เข้าถึง และระบบสามารถพิสูจน์ได้หรือไม่ว่าข้อมูลพร้อมใช้งาน
นี่คือเหตุผลสำคัญที่ Bitroot เหมาะสมที่จะรองรับการกำกับดูแลการจัดเก็บข้อมูล AI การเรียกใช้ AI Agent การเปลี่ยนเวอร์ชันโมเดล การเปลี่ยนแปลงการอนุญาตข้อมูล และข้อพิพาทเกี่ยวกับผลการค้นหา ล้วนไม่ใช่การดำเนินการเบื้องหลังที่มีความถี่ต่ำ แต่เป็นเหตุการณ์บนเชนที่เกิดขึ้นอย่างต่อเนื่องตามการเติบโตของแอปพลิเคชัน หากเชนพื้นฐานไม่สามารถให้เวลาแฝงในการยืนยันที่ต่ำเพียงพอและปริมาณงานที่สูงเพียงพอ การกำกับดูแลการจัดเก็บจะถูกบังคับให้กลับไปใช้ตารางนอกเชนและการตรวจสอบด้วยตนเอง การผสมผสานระหว่าง Parallel EVM และ Pipeline BFT ของ Bitroot มีคุณค่าไม่เพียงแค่ TPS ที่สูงขึ้น แต่ยังทำให้เหตุการณ์การกำกับดูแลที่มีความถี่สูงเหล่านี้สามารถถูกยึดโยง ชำระบัญชี และติดตามความรับผิดชอบได้แบบเรียลไทม์
ใครเป็นคนจ่าย: ให้ความสามารถในการใช้งานเป็นตัวกำหนดผลตอบแทน ไม่ใช่ความจุ
เพื่อให้การจัดเก็บข้อมูลทำงานได้ในระยะยาว แรงจูงใจต้องสอดคล้องกับความสามารถในการใช้งาน ไม่ใช่แค่การเพิ่มความจุ การให้รางวัลเฉพาะความจุเท่ากับการส่งเสริมให้โหนดเพิ่มฮาร์ดดิสก์และละเลยการบริการ Filecoin ได้ปรับแก้กลไกนี้แล้ว โดยนำแนวคิดของ "กำลังที่ปรับตามคุณภาพ" (quality-adjusted power) มาใช้ ซึ่งทำให้เซกเตอร์ (หน่วยวัดพื้นที่จัดเก็บที่เล็กที่สุด) ที่รับคำสั่งจัดเก็บข้อมูลจริง โดยเฉพาะคำสั่งที่ได้รับการตรวจสอบแล้ว ได้รับน้ำหนักที่สูงขึ้นในการคำนวณกำลัง ส่งผลให้รางวัลถูกโอนไปยังความจุที่ให้บริการจริง แทนที่จะเป็นความจุเปล่าที่ถูกบรรจุไว้เฉยๆ แนวคิดนี้คุ้มค่าที่ชั้นแรงจูงใจที่สร้างขึ้นเองจะนำไปปรับใช้
เมื่อนำไปใช้เป็นฟังก์ชันรางวัลที่สามารถดำเนินการได้ ต้องพิจารณาอย่างน้อยสี่มิติพร้อมกัน และกำหนดตรรกะน้ำหนักของแต่ละมิติอย่างชัดเจน ความจุเป็นตัวกำหนดส่วนแบ่งพื้นฐาน ซึ่งตอบว่าคุณสัญญาว่าจะมีพื้นที่เท่าใด อัตราการออนไลน์และเวลาแฝงในการตอบสนองเป็นตัวกำหนดค่าสัมประสิทธิ์คุณภาพการบริการ ซึ่งตอบว่าพื้นที่นี้สามารถเข้าถึงได้จริงเมื่อต้องการหรือไม่ โดยควรมีน้ำหนักสูง มิฉะนั้นความสามารถในการใช้งานจะกลายเป็นเพียงคำขวัญ อัตราความสำเร็จในการกู้คืนข้อมูลเป็นตัวกำหนดความน่าเชื่อถือในการกู้คืนจากภัยพิบัติ ซึ่งตอบว่าสำเนาข้อมูลสามารถสร้างใหม่ได้หรือไม่เมื่อโหนดหลุดออกไป ซึ่งเกี่ยวข้องโดยตรงกับการอยู่รอดของข้อมูลระยะยาว ความหนาแน่นของมูลค่าข้อมูลเป็นตัวกำหนดส่วนเพิ่มจากด้านอุปสงค์ โดยตั้งค่าตัวคูณที่แตกต่างกันสำหรับชุดข้อมูลที่มีมูลค่าสูงและโมเดลที่มีความต้องการสูง ทำให้ข้อมูลที่หายากและถูกเรียกใช้บ่อยได้รับผลตอบแทนที่สูงขึ้น รางวัลควรถูกมอบให้กับบริการที่พิสูจน์ได้ ไม่ใช่ความจุที่ถูกประกาศไว้
แค่มีแรงจูงใจเชิงบวกไม่เพียงพอ ด้านการควบคุม เช่น การวางหลักประกัน การลงโทษ และการอนุญาโตตุลาการ ต้องมาพร้อมกัน และต้องเป็นไปตามอสมการพื้นฐาน: ผลตอบแทนที่คาดหวังจากการโกงต้องต่ำกว่าต้นทุนที่คาดหวังจากการถูกริบ มิฉะนั้นกลไกการพิสูจน์ใดๆ ก็จะถูกหลีกเลี่ยงโดยเหตุผลทางเศรษฐกิจ การวางหลักประกันทำให้โหนดต้องลงทุนต้นทุนเพื่อรับประกันความสามารถในการใช้งาน โดยขนาดของหลักประกันควรเป็นสัดส่วนกับกำลังที่สัญญาไว้และมูลค่าข้อมูล ในการออกแบบของ Filecoin ผู้ให้บริการจัดเก็บต้องวางหลักประกันล่วงหน้าตามกำลังที่สัญญาไว้ เมื่อหลุดออกไปภายในกรอบเวลาการพิสูจน์ จะถูกเรียกเก็บค่าธรรมเนียมข้อบกพร่อง และหากเซกเตอร์ถูกทิ้งถาวร จะถูกเรียกเก็บค่าปรับที่หนักกว่า การลงโทษแบบเป็นขั้นตอนนี้มีความหมายในการแยกแยะระหว่างการหลุดออกชั่วคราวและการออกโดยเจตนาร้าย การอนุญาโตตุลาการใช้หลักฐานบนเชนเพื่อขับเคลื่อนการจัดการข้อพิพาท: เมื่อผู้ใช้ยืนยันว่าข้อมูลไม่สามารถใช้งานได้ และโหนดยืนยันว่าให้บริการตามปกติ บันทึกการท้าทาย หลักฐานการสุ่มตัวอย่าง และบันทึกเหตุการณ์จะกลายเป็นพื้นฐานการตัดสินที่เครื่องอ่านได้ ซึ่งบีบอัดข้อพิพาทที่ต้องใช้มนุษย์เข้าไปจัดการให้เป็นการตัดสินบนเชนที่ตรวจสอบได้เพียงครั้งเดียว
ในสถานการณ์ AI ยังต้องเพิ่มชั้นการกำกับดูแลที่ยากขึ้นอีก: การแบ่งผลตอบแทนระหว่างสามฝ่าย โมเดลที่ถูกเรียกใช้ซ้ำๆ เบื้องหลังมีข้อมูลจากผู้ให้ข้อมูล การฝึกอบรมจากผู้สร้างโมเดล และการโฮสต์จากโหนดจัดเก็บ ทั้งสามฝ่ายมีส่วนร่วมในมูลค่าการเรียกใช้ แต่การมีส่วนร่วมนั้นยากต่อการสังเกตโดยตรง วิธีที่可行คือการสร้างการระบุแหล่งที่มาของมูลค่าบนเหตุการณ์บนเชนที่วัดได้: การเรียกใช้จะถูกคิดค่าบริการตามครั้งและชำระเงินอัตโนมัติ ข้อมูลและโมเดลจะถูกผูกกับแต่ละการเรียกใช้ผ่านลายนิ้วมือเวอร์ชันและความสัมพันธ์ทางสายเลือด จากนั้นจะถูกแบ่งอัตโนมัติตามสัดส่วนการแบ่งที่ตั้งโปรแกรมไว้ล่วงหน้า เพื่อหลีกเลี่ยงการโต้แย้งภายหลัง ควบคู่ไปกับกลไกบัญชีดำและการริบ สำหรับพฤติกรรมเช่นการอัปโหลดข้อมูลที่เป็นอันตราย การละเมิดลิขสิทธิ์ และการขโมยโมเดล เมื่อถูกตัดสินโดยอนุญาโตตุลาการ จะยึดหลักประกันและระงับผลตอบแทนในอนาคต มิฉะนั้นจะเกิดผลลัพธ์ที่ขัดกับสัญชาตญาณ: ยิ่งการแปลงเป็นสินทรัพย์ประสบความสำเร็จมากเท่าไร ข้อพิพาทเกี่ยวกับการแบ่งและการระบุสิทธิ์ก็ยิ่งมากขึ้น ซึ่งท้ายที่สุดจะทำลายความเชื่อมั่นในระบบนิเวศเอง
การปฏิบัติตามข้อกำหนดไม่ใช่แพตช์ที่เพิ่มหลังระบบทำงาน แต่เป็นข้อจำกัดในขั้นตอนการออกแบบสถาปัตยกรรม: เส้นความปลอดภัยพื้นฐานคือการเข้ารหัสแบบ end-to-end การจัดการคีย์แบบหลายชั้นและการหมุนเวียนตามรอบเวลา ควบคู่กับการตรวจสอบแฮชและ Merkle Commitment เพื่อให้แน่ใจว่าการดาวน์โหลดสามารถตรวจสอบได้ จากนั้นใช้การจำลองหลายชุดและรหัสแก้ไขข้อผิดพลาดร่วมกันเพื่อรองรับการกู้คืนจากความล้มเหลว ด้านความเป็นส่วนตัว ให้ควบคุมการเข้าถึงตามระดับข้อมูลด้วยสิทธิ์ขั้นต่ำ รองรับการยกเลิกการอนุญาต การอนุญาตแบบครั้งเดียว และการอนุญาตตามระยะเวลา การเข้าถึงและการดำเนินการที่สำคัญทั้งหมดจะถูกบันทึกตลอดเส้นทางเพื่อให้ง่ายต่อการตรวจสอบย้อนหลัง การปฏิบัติตามข้อกำหนดเป็นส่วนที่มักถูกเลื่อนออกไปและมีต้นทุนสูงที่สุด: นโยบายการจัดเก็บข้อมูลในพื้นที่และการถ่ายโอนข้ามโดเมนต้องสามารถกำหนดค่าได้ คำขอการลบ การเข้าถึง และการตรวจสอบต้องมีอินเทอร์เฟซกระบวนการมาตรฐาน ปัญหาที่ยุ่งยากที่สุดคือความขัดแย้งโดยธรรมชาติระหว่างการไม่สามารถแก้ไขได้และการลบได้ วิธีแก้ไขที่เป็นไปได้คือการลบด้วยการเข้ารหัสและการทำให้ดัชนี失效: ทำลายคีย์เพื่อให้ข้อความที่เข้ารหัสไม่สามารถกู้คืนได้ ทำให้ดัชนี失效เพื่อให้ข้อมูลไม่สามารถค้นหาได้ ตอบสนองความต้องการในการลบในขณะที่ยังคงบันทึกบนเชน ตั้งแต่การทดลองไปจนถึงการผลิตมีสามขั้นตอน: ขั้นแรก สร้างวงจรปิดที่เชื่อถือได้ขั้นต่ำ ทำให้การจัดเก็บอ็อบเจกต์ การยึดบนเชน การตรวจสอบความสมบูรณ์ และการตรวจสอบพื้นฐานทำงานได้อย่างเสถียร การตรวจสอบรับรองดูที่ความพร้อมใช้งาน อัตราความสำเร็จในการอ่าน/เขียน ความสอดคล้องของเวอร์ชันระหว่างการยึดและอ็อบเจกต์ และการซ้อมกู้คืนจากความล้มเหลว จากนั้นทำการจัดการสินทรัพย์ AI และการจัดการดัชนี นำเข้าสินทรัพย์ชุดข้อมูลและโมเดล การจัดการเวอร์ชันสายเลือด การแบ่งชั้นดัชนีเวกเตอร์แบบร้อน/เย็น การเรียกใช้โมเดลที่ได้รับอนุญาต และการลงทะเบียนแหล่งที่มาของข้อมูลฝึกอบรม การตรวจสอบรับรองดูที่การฝึกอบรมสามารถตรวจสอบย้อนกลับได้ โมเดลสามารถย้อนกลับและตรวจสอบได้ เวลาแฝงของชั้นร้อนถึงเกณฑ์ และผลกระทบจากการสร้างดัชนีใหม่สามารถควบคุมได้ สุดท้าย ใช้การค้นหาที่ตรวจสอบได้และการจัดการอัตโนมัติ นำเข้าหลักฐานความท้าทาย การย้ายนโยบาย และระบบอัตโนมัติสำหรับรางวัลและบทลงโทษ การตรวจสอบรับรองดูที่ความครอบคลุมของหลักฐานความพร้อมใช้งาน เวลาแฝงในการจัดการความเสี่ยง ต้นทุนต่อหน่วยลดลง และการเปลี่ยนแปลงนโยบายสามารถตรวจสอบย้อนกลับและย้อนกลับได้ ระบบตัวชี้วัดเป็นระบบกลยุทธ์ ไม่ใช่รายงานการแสดงผล หากเขียนเฉพาะรายการทางเทคนิคโดยไม่มีผลลัพธ์ทางธุรกิจ โซลูชันการจัดเก็บจะกลายเป็นศูนย์ต้นทุนล้วนๆ แนะนำให้แบ่งเป็นสามชั้น: ตัวชี้วัดทางเทคนิคพื้นฐาน (ความพร้อมใช้งาน เวลาแฝง P95/P99 ปริมาณงาน RTO/RPO อัตราข้อผิดพลาด) ตอบว่าระบบแข็งแรงหรือไม่ ตัวชี้วัดเฉพาะ AI (อัตราการตรวจสอบย้อนกลับของข้อมูลฝึกอบรม อัตราการทำซ้ำของโมเดล ความครอบคลุมของการตรวจสอบการอนุมาน ความสอดคล้องของดัชนี) ตอบว่าคุณภาพของโมเดลสามารถจัดการได้หรือไม่ ตัวชี้วัดผลลัพธ์ทางธุรกิจ (การเติบโตของการจัดหาข้อมูล ต้นทุนการเรียกใช้ลดลง ความกระตือรือร้นของโหนด ขนาดการซื้อขายสินทรัพย์) ตอบว่าระบบสร้างคุณค่าหรือไม่ ต้องมีความสัมพันธ์การแมประหว่างสามชั้น การใช้งานที่แท้จริงของตัวชี้วัดคือเป็นอินพุตสำหรับการปรับกลยุทธ์ ไม่ใช่รายงานสำหรับการแสดงผล จุดล้มเหลวที่พบบ่อยที่สุดห้าจุดสามารถหลีกเลี่ยงได้ล่วงหน้า: ทำแค่การจัดเก็บโดยไม่มีการจัดการเวอร์ชัน การมีข้อมูลไม่ได้หมายความว่าพร้อมใช้งาน และความพร้อมใช้งานไม่ได้หมายความว่าสามารถทำซ้ำได้ ดูแค่ความจุโดยไม่ดูหลักฐานความพร้อมใช้งาน การให้รางวัลตามความจุจะกระตุ้นให้เน้นความจุและละเลยบริการ การแบ่งชั้นร้อน/เย็นทำแล้วแต่ไม่ได้ทำกลยุทธ์การซิงค์ การซิงค์เวอร์ชันดัชนีและการจัดการ失效ยังไม่สมบูรณ์ นโยบายการปฏิบัติตามข้อกำหนดถูกเลื่อนออกไป ยิ่งช้าในการตอบสนองต่อสิทธิ์ บันทึก การปกปิดข้อมูล และการลบ ต้นทุนก็ยิ่งสูง สถาปัตยกรรมชั่วคราวไม่มีกลไกการออก การเปลี่ยนจากศูนย์กลางไปสู่การกระจายศูนย์เป็นเส้นทางที่สมเหตุสมผล แต่การขาดเกณฑ์การย้ายจะทำให้สถานะชั่วคราวกลายเป็นถาวรและเบี่ยงเบนจากเจตนาเดิม
วงจรปิดที่สมบูรณ์ของ Bitroot: จากข้อมูล โมเดล สู่ AI Agent
ในระบบปิดนี้ Bitroot สามารถเปลี่ยนทุกการกระทำสำคัญของสินทรัพย์ AI ให้เป็นเหตุการณ์ที่สามารถชำระบัญชีได้: การลงทะเบียนชุดข้อมูล, การเผยแพร่เวอร์ชันโมเดล, การสร้างดัชนีเวกเตอร์ใหม่, การเรียกใช้ AI Agent, การบันทึกหลักฐานการอนุมาน, การอนุญาตและเพิกถอนสิทธิ์, การท้าทายข้อพิพาทและผลการตัดสิน บนเชนไม่จำเป็นต้องรับข้อมูลทั้งหมด แต่ต้องรับหลักฐานขั้นต่ำของการกระทำเหล่านี้เท่านั้น ด้วยวิธีนี้เท่านั้น ความสัมพันธ์ด้านมูลค่าระหว่างข้อมูล โมเดล พลังประมวลผล และแอปพลิเคชันจะไม่หยุดอยู่แค่คำมั่นสัญญาทางวาจา แต่จะเข้าสู่การแบ่งบัญชีที่ตั้งโปรแกรมได้และการกำกับดูแลที่ตรวจสอบได้
เมื่อนำกลไกนี้ไปใช้ในการดำเนินงานและการขยายระบบนิเวศของ Bitroot แรงจูงใจในการจัดเก็บข้อมูลไม่ควรถูกออกแบบให้เป็นเงินอุดหนุนฮาร์ดแวร์แยกต่างหาก แต่ควรเป็นส่วนหนึ่งของกระแสคุณค่าของ AI Stack: ผู้มีส่วนร่วมด้านข้อมูลได้รับผลตอบแทนเมื่อข้อมูลถูกนำไปฝึกหรือเรียกใช้ ผู้มีส่วนร่วมด้านโมเดลได้รับผลตอบแทนจากการให้บริการโมเดล โหนดจัดเก็บและค้นหาได้รับผลตอบแทนจากการให้บริการที่พร้อมใช้งานและมีความหน่วงต่ำอย่างต่อเนื่อง โหนดตรวจสอบและท้าทายได้รับรางวัลจากการตรวจพบความไม่พร้อมใช้งาน การเลื่อนของดัชนี หรือความผิดปกติของสิทธิ์ ด้วยวิธีนี้ ระบบเศรษฐกิจของ Bitroot จะให้รางวัลไม่ใช่แค่ "การอัปโหลด" แต่คือ "การพิสูจน์ได้ว่ามีประโยชน์อย่างต่อเนื่อง"
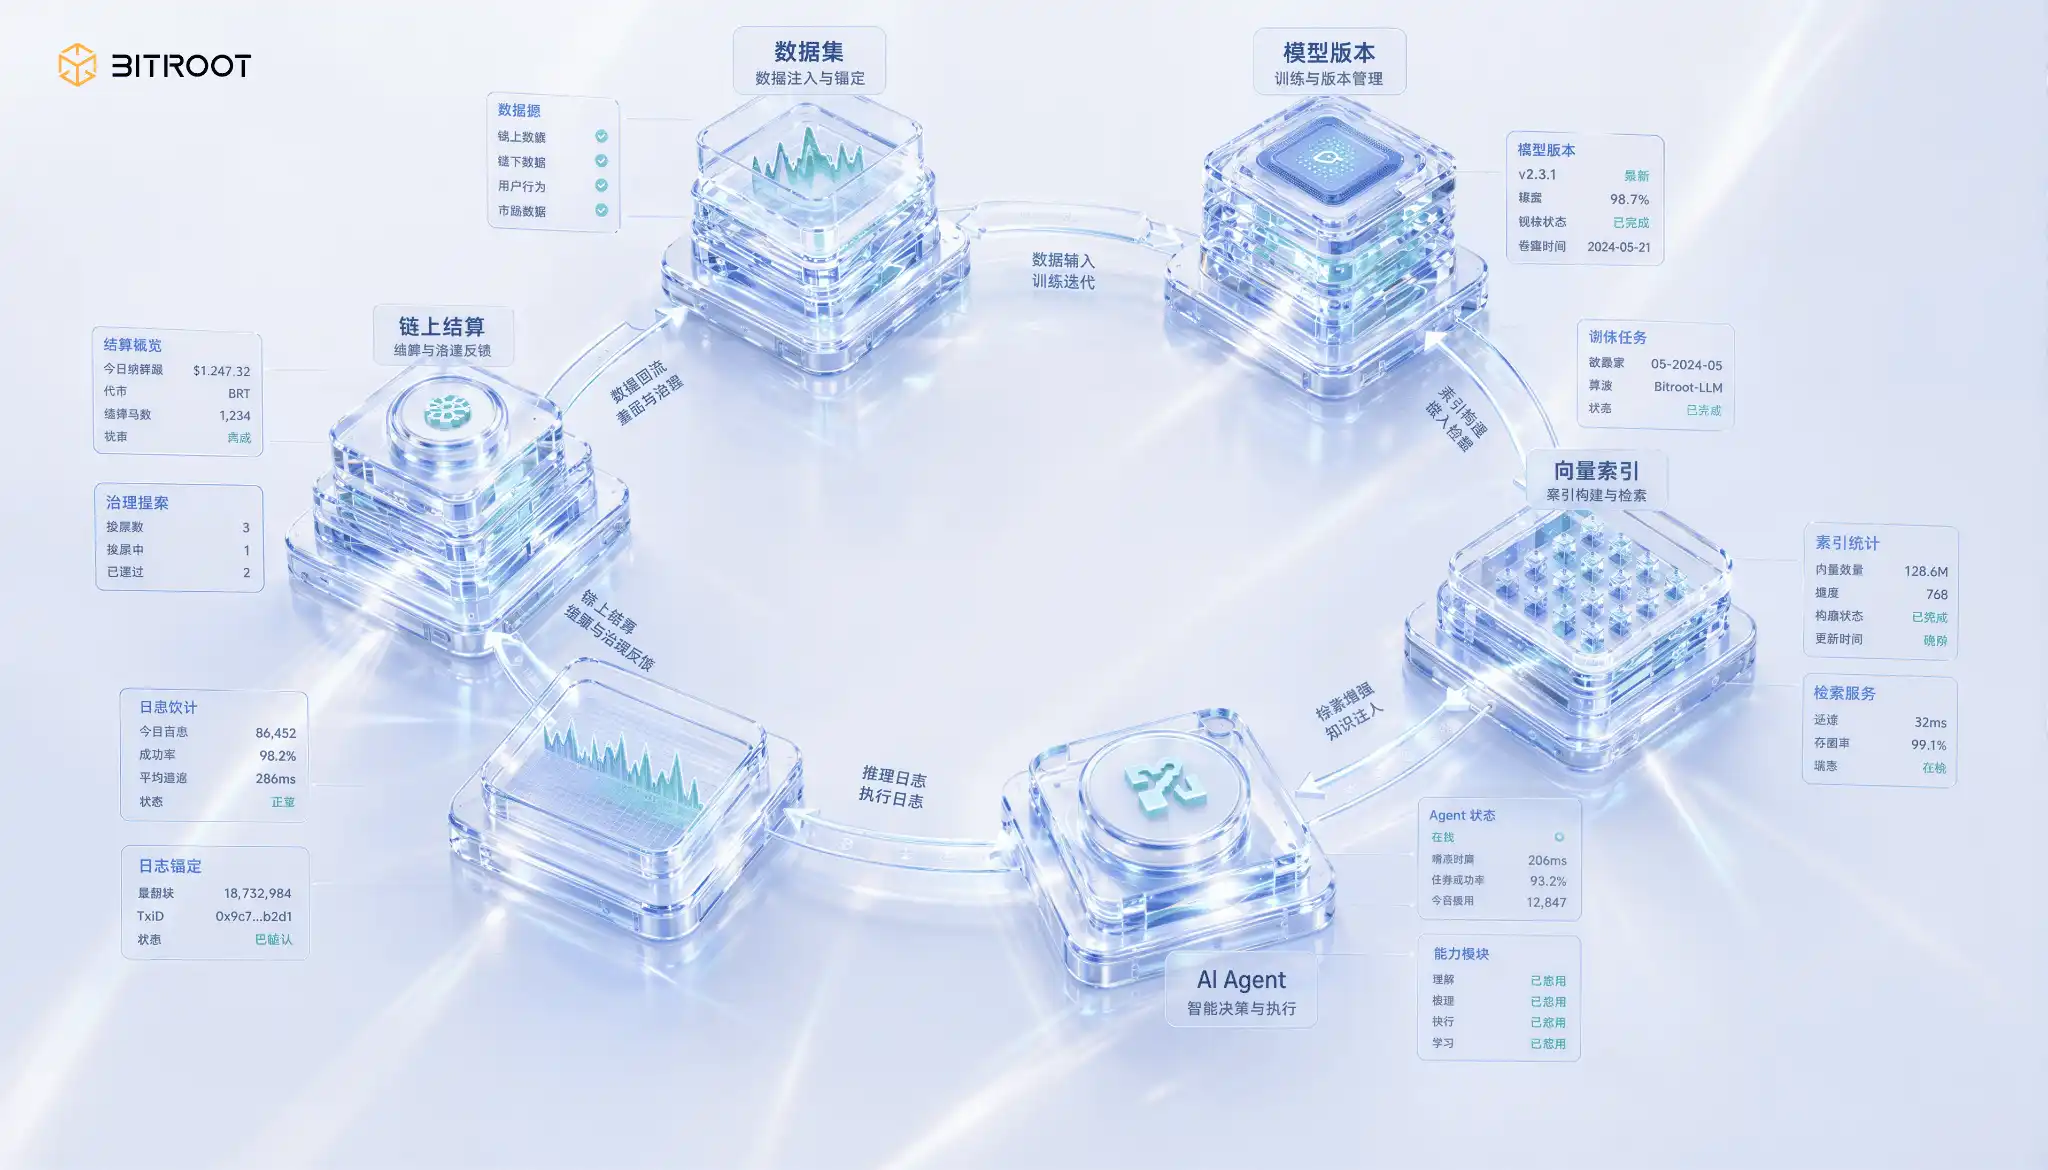
การจัดเก็บไม่ใช่ศูนย์ต้นทุน แต่เป็นระบบความไว้วางใจและการกระจายมูลค่า
สิ่งที่การจัดเก็บแบบกระจายศูนย์ต้องแก้ไขในยุค AI ไม่ใช่การแทนที่ผลิตภัณฑ์จัดเก็บออบเจกต์บางตัว หรือการแสวงหาแนวคิดการกระจายศูนย์ แต่เป็นสี่สิ่งที่ยากกว่า: หลักฐานความน่าเชื่อถือที่พร้อมใช้งานในระยะยาว ระเบียบการกำกับดูแลสำหรับการทำงานร่วมกันข้ามหน่วยงาน ห่วงโซ่ความรับผิดชอบของข้อมูลและโมเดล และแรงจูงใจทางเศรษฐกิจที่ยั่งยืน
สถาปัตยกรรมโปรโตคอลเดี่ยวชั้นเดียวไม่สามารถครอบคลุมเป้าหมายเหล่านี้ได้ เส้นทางที่สมจริงกว่าคือสถาปัตยกรรมแบบผสมผสาน: การระบุที่อยู่ตามเนื้อหาเพื่อรักษาความสมบูรณ์ หลักฐานการจัดเก็บเพื่อรับประกันความพร้อมใช้งานในมิติเวลา ชั้นถาวรเพื่อรักษาประวัติศาสตร์ที่สำคัญ ชั้นร้อนเพื่อรักษาประสบการณ์ออนไลน์ และการยึดบนเชนเพื่อรับประกันการกำกับดูแลและการชำระบัญชีที่พิสูจน์ได้ นี่ไม่ใช่การประนีประนอม แต่เป็นเหตุผลทางวิศวกรรม จุดเน้นของการนำไปใช้จริงไม่ได้อยู่ที่ฟังก์ชันที่ครบถ้วนที่สุด แต่อยู่ที่การปิดระบบให้สำเร็จก่อน โดยเริ่มจากการทำให้วงจรปิดที่เชื่อถือได้ขั้นต่ำทำงานได้ จากนั้นจึงเพิ่มการแปลงสินทรัพย์ AI การค้นหาที่ตรวจสอบได้ และการกำกับดูแลอัตโนมัติทีละชั้น
เมื่อบีบอัดวิธีการนี้เป็นการดำเนินการหนึ่งสัปดาห์ จริงๆ แล้วมีเพียงสามขั้นตอน: วันแรกทำตารางข้อมูลแปดฟิลด์ให้เสร็จ วันที่สามทดสอบวงจรปิดขั้นต่ำตั้งแต่การเชื่อมต่อ การจัดเก็บ การค้นหา ไปจนถึงการตรวจสอบในโดเมนธุรกิจจริงหนึ่งโดเมน วันที่เจ็ดจัดการประชุมทบทวนเกณฑ์การย้ายข้อมูลด้วยความหน่วง P95 และต้นทุนต่อหน่วย เมื่อทำสามขั้นตอนนี้สำเร็จ ทีมงานจะก้าวจากฉันทามติเชิงแนวคิดไปสู่ฉันทามติทางวิศวกรรม
ต้องยอมรับขอบเขตความเป็นจริงด้วย: ไม่ว่าจะใช้โปรโตคอลผสมแบบใด ก็มีการแลกเปลี่ยนระหว่างต้นทุน ความหน่วง และความคงทน ไม่มีคำตอบเดียวที่เหมาะสมที่สุดสำหรับทุกธุรกิจในเวลาเดียวกัน โซลูชันที่ยั่งยืนอย่างแท้จริงมาจากการปรับปรุงอย่างต่อเนื่องภายใต้ขอบเขตที่ชัดเจน ไม่ใช่การกำหนดค่าคงที่ในระยะยาวหลังจากการตัดสินใจครั้งเดียว
ในอนาคต สิ่งที่ทำให้โปรเจกต์หนึ่งต้องล้มหายตายจากไป มักไม่ใช่เพราะ TPS ไม่สูงพอ แต่เป็นเพราะห่วงโซ่ความรับผิดชอบของข้อมูลที่อธิบายไม่ได้ ในยุคของ AI Public Chain การจัดเก็บข้อมูลไม่ใช่แค่การนำข้อมูลเข้าไป แต่เป็นการทำให้ข้อมูลสามารถพิสูจน์ได้ในทุกช่วงเวลา
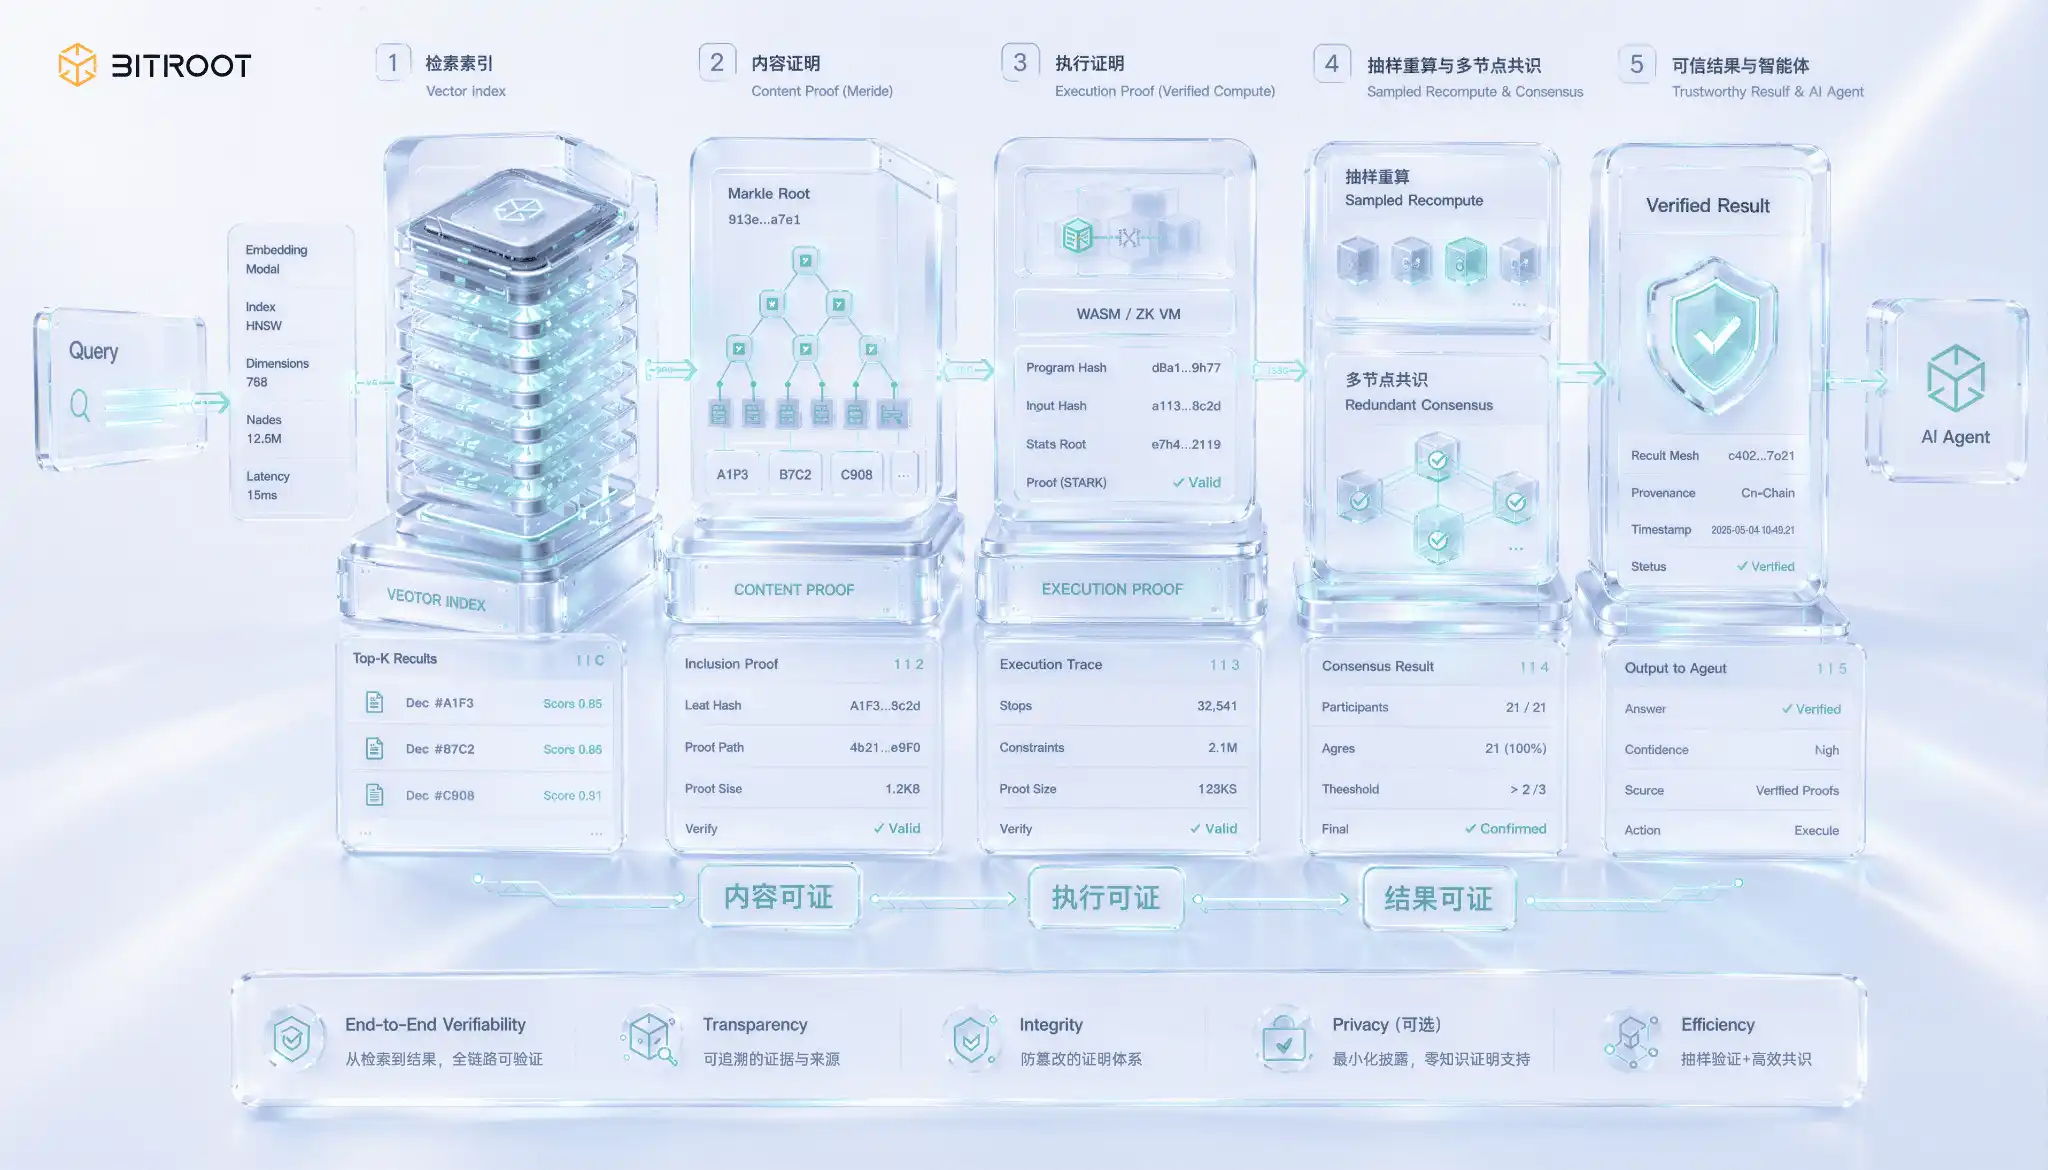
บทสรุป
การแข่งขันที่แท้จริงของ AI Public Chain ในท้ายที่สุดจะไม่หยุดอยู่แค่การเปรียบเทียบ TPS, Gas หรือเวลายืนยันธุรกรรม ประสิทธิภาพคือประตูทางเข้า แต่ไม่ใช่จุดสิ้นสุด เมื่อเข้าสู่ยุคของแอปพลิเคชัน AI ดั้งเดิม ระบบบนเชนจะต้องรองรับไม่เพียงแค่ธุรกรรม แต่ยังรวมถึงเวอร์ชันข้อมูล การเรียกใช้โมเดล การจัดสรรพลังคำนวณ บันทึกการอนุมาน พฤติกรรมของ Agent และการกระจายผลตอบแทนให้หลายฝ่าย
นี่คือสิ่งที่ Bitroot มองเห็นเกี่ยวกับเลเยอร์การจัดเก็บข้อมูล: การจัดเก็บข้อมูลไม่ใช่โมดูลเสริม แต่เป็นเลเยอร์ที่ใกล้เคียงกับแหล่งที่มาของมูลค่ามากที่สุดใน AI Stack ข้อมูลสามารถพิสูจน์ได้หรือไม่ โมเดลสามารถทำซ้ำได้หรือไม่ การเรียกใช้สามารถตรวจสอบได้หรือไม่ ผลตอบแทนสามารถกระจายอัตโนมัติได้หรือไม่ สิ่งเหล่านี้กำหนดว่าเครือข่าย AI แบบกระจายศูนย์จะมีศักยภาพในระยะยาวอย่างแท้จริงหรือไม่
สิ่งที่ Bitroot ต้องการสร้าง ไม่ใช่แค่เชนที่มุ่งเน้นการทำงานที่เร็วขึ้น แต่เป็นโครงสร้างพื้นฐานที่ทำให้สินทรัพย์ AI สามารถได้รับการยืนยัน ถูกเรียกใช้ ถูกชำระบัญชี และถูกจัดการ Parallel EVM และ Pipeline BFT แก้ปัญหาความสามารถในการรองรับเหตุการณ์บนเชนที่มีความถี่สูง ในขณะที่ระบบจัดเก็บข้อมูลแบบกระจายศูนย์และกลไกที่ตรวจสอบได้แก้ปัญหาพื้นฐานความเชื่อถือของข้อมูลและโมเดล AI ส่วนการแบ่งบัญชีที่ตั้งโปรแกรมได้และการกำกับดูแลบนเชน จะเปลี่ยนการมีส่วนร่วมให้เป็นแรงจูงใจทางเศรษฐกิจที่ยั่งยืน
เมื่อ AI Agent เริ่มดำเนินการแทนผู้ใช้ เมื่อโมเดลและข้อมูลกลายเป็นสินทรัพย์ที่สามารถซื้อขายได้ เมื่อพลังคำนวณ การจัดเก็บข้อมูล และบริการอนุมานเข้าสู่เครือข่ายมูลค่าเดียวกัน การจัดเก็บข้อมูลจะไม่ใช่แค่คำถามว่า "เก็บไฟล์ไว้ที่ไหน" อีกต่อไป
มันจะกลายเป็นฐานความเชื่อถือของ AI Public Chain และเป็นระบบกระจายมูลค่าของเครือข่ายอัจฉริยะรุ่นต่อไป
ในมุมมองของ Bitroot สิ่งที่สำคัญอย่างแท้จริงในอนาคตไม่ใช่ใครมีข้อมูลมากที่สุด แต่เป็นใครที่สามารถทำให้ข้อมูลสามารถพิสูจน์ได้ ถูกเรียกใช้ได้ และรับผิดชอบได้ในทุกช่วงเวลา และในที่สุดก็มีส่วนร่วมในการชำระบัญชีมูลค่า
เกี่ยวกับ Bitroot
Bitroot เป็นโปรเจกต์ Layer 1 Public Chain ที่มุ่งเน้นการทำงานแบบขนานและสถาปัตยกรรม AI ดั้งเดิม Bitroot ใช้เส้นทางเทคโนโลยีที่เข้ากันได้กับ EVM และผ่านกลไกการทำงานแบบขนาน การปรับปรุงฉันทามติ และการออกแบบอินเทอร์เฟซที่เกี่ยวข้องกับ AI เพื่อสำรวจการสร้างสภาพแวดล้อมการทำงานบนเชนที่มีประสิทธิภาพสูงและต้นทุนต่ำสำหรับ AI Agent, DeFi และแอปพลิเคชัน Web3
บทความนี้มาจากการส่งบทความ ไม่ได้แสดงถึงมุมมองของ BlcokBeats
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia