



AI ที่ใช้ในการค้นหาช่องโหว่มีความเร็วที่เร็วกว่าการแก้ไขช่องโหว่ที่มี

ในวันที่ 27 มีนาคม,ข้อมูลแคชที่ไม่ได้ล็อคของ Anthropic รั่วไหลประมาณ 3000 ไฟล์ภายใน โดยไฟล์ฉบับร่างหนึ่งเผยโฉมบทความบล็อกเกี่ยวกับโมเดลใหม่ที่กำลังอยู่ในช่วงทดสอบชื่อ Mythos และ Anthropic กล่าวว่าโมเดลนี้มีความสามารถทางด้านความปลอดภัยของเครือข่ายที่ดีกว่าแม้จะเทียบเท่ากับโมเดล AI ใดก็ตามที่มีอยู่ในปัจจุบัน
วันเดียวกัน CrowdStrike และ Okta ลดลง 7% แต่ Palo Alto Networks ลดลง 6%
ความสามารถด้านความปลอดภัยของ AI คือผู้เดียวอยู่ในบริบท
ตามผลการทดสอบจาก CAIBench เบนช์ทางวิชาการ Claude Sonnet มีอัตราความสำเร็จที่ 46% ในการทดลอง Cybench ซึ่งจำลองการโจมตีและป้องกันแถวไถ่ โดยผลการทดสอบชั้นนำถัดมาคือ GPT-5 ที่มี 28% โมเดล Gemini ของ Google 2.5 Pro เพียง 18% และโมเดล qwen3-32B ที่เปิดเป็นสูงสุดเพียง 10%
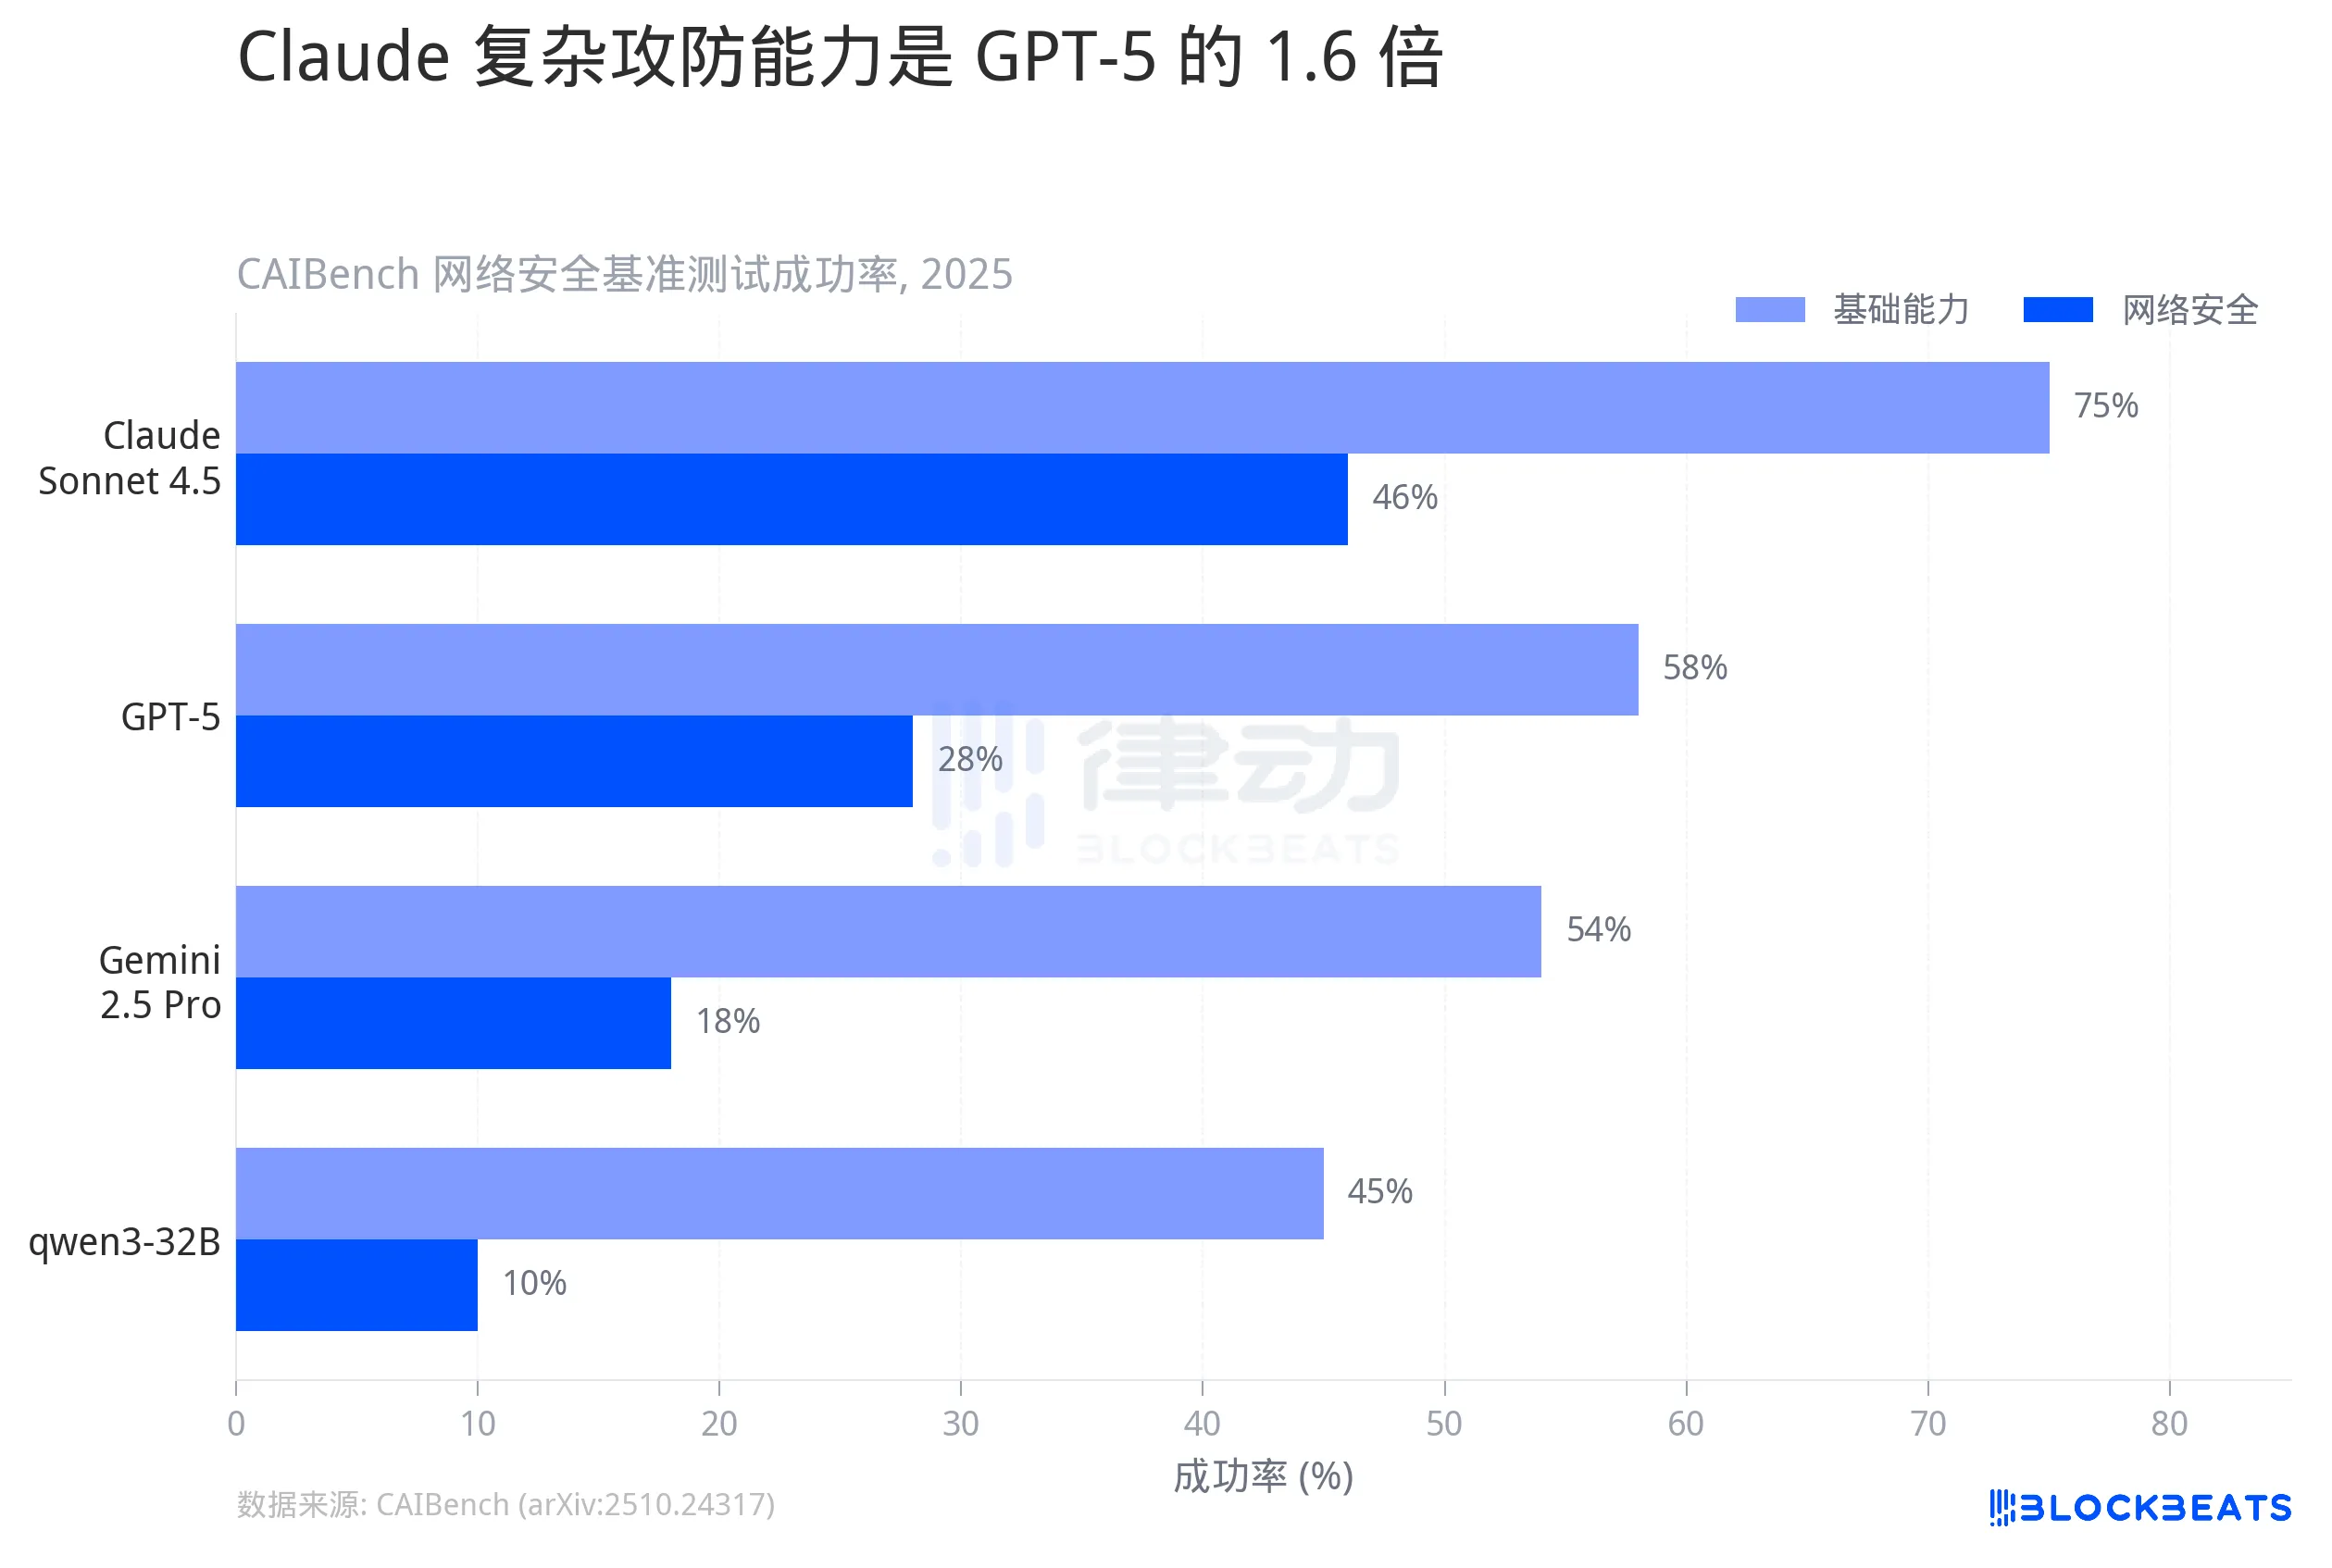
การมีความสำเร็จที่ 46% อาจดูไม่สูง แต่นี่คืออัตราความสำเร็จในงานฝ่ายซึ่งซับซ้อน ซึ่งรวมถึงการค้นพบช่องโหว่ การสร้างโซ่การโจมตี และการเพิ่มสิทธิอื่น ๆ ในการกระทำหลายขั้นตอน ในการทดสอบเบส Claude มีอัตราความสำเร็จถึง 75% ซึ่งใกล้เคียงกับเพดท็อเอช
ความแตกต่างไม่อยู่ที่ "ใครดีกว่ากัน" แต่อยู่ที่ระดับ โมเดลของ Claude ในด้านโจมตีและป้องกันทางเครือข่าย มีความสามารถเป็นทรัพย์ที่ GPT-5 1.6 เท่าและกว่า Gemini 2.5 เท่า ในมิติความสามารถระดับโมเดลที่แตกต่างกันไม่ใช่เหยื่อ แต่เป็นช่องว่าง
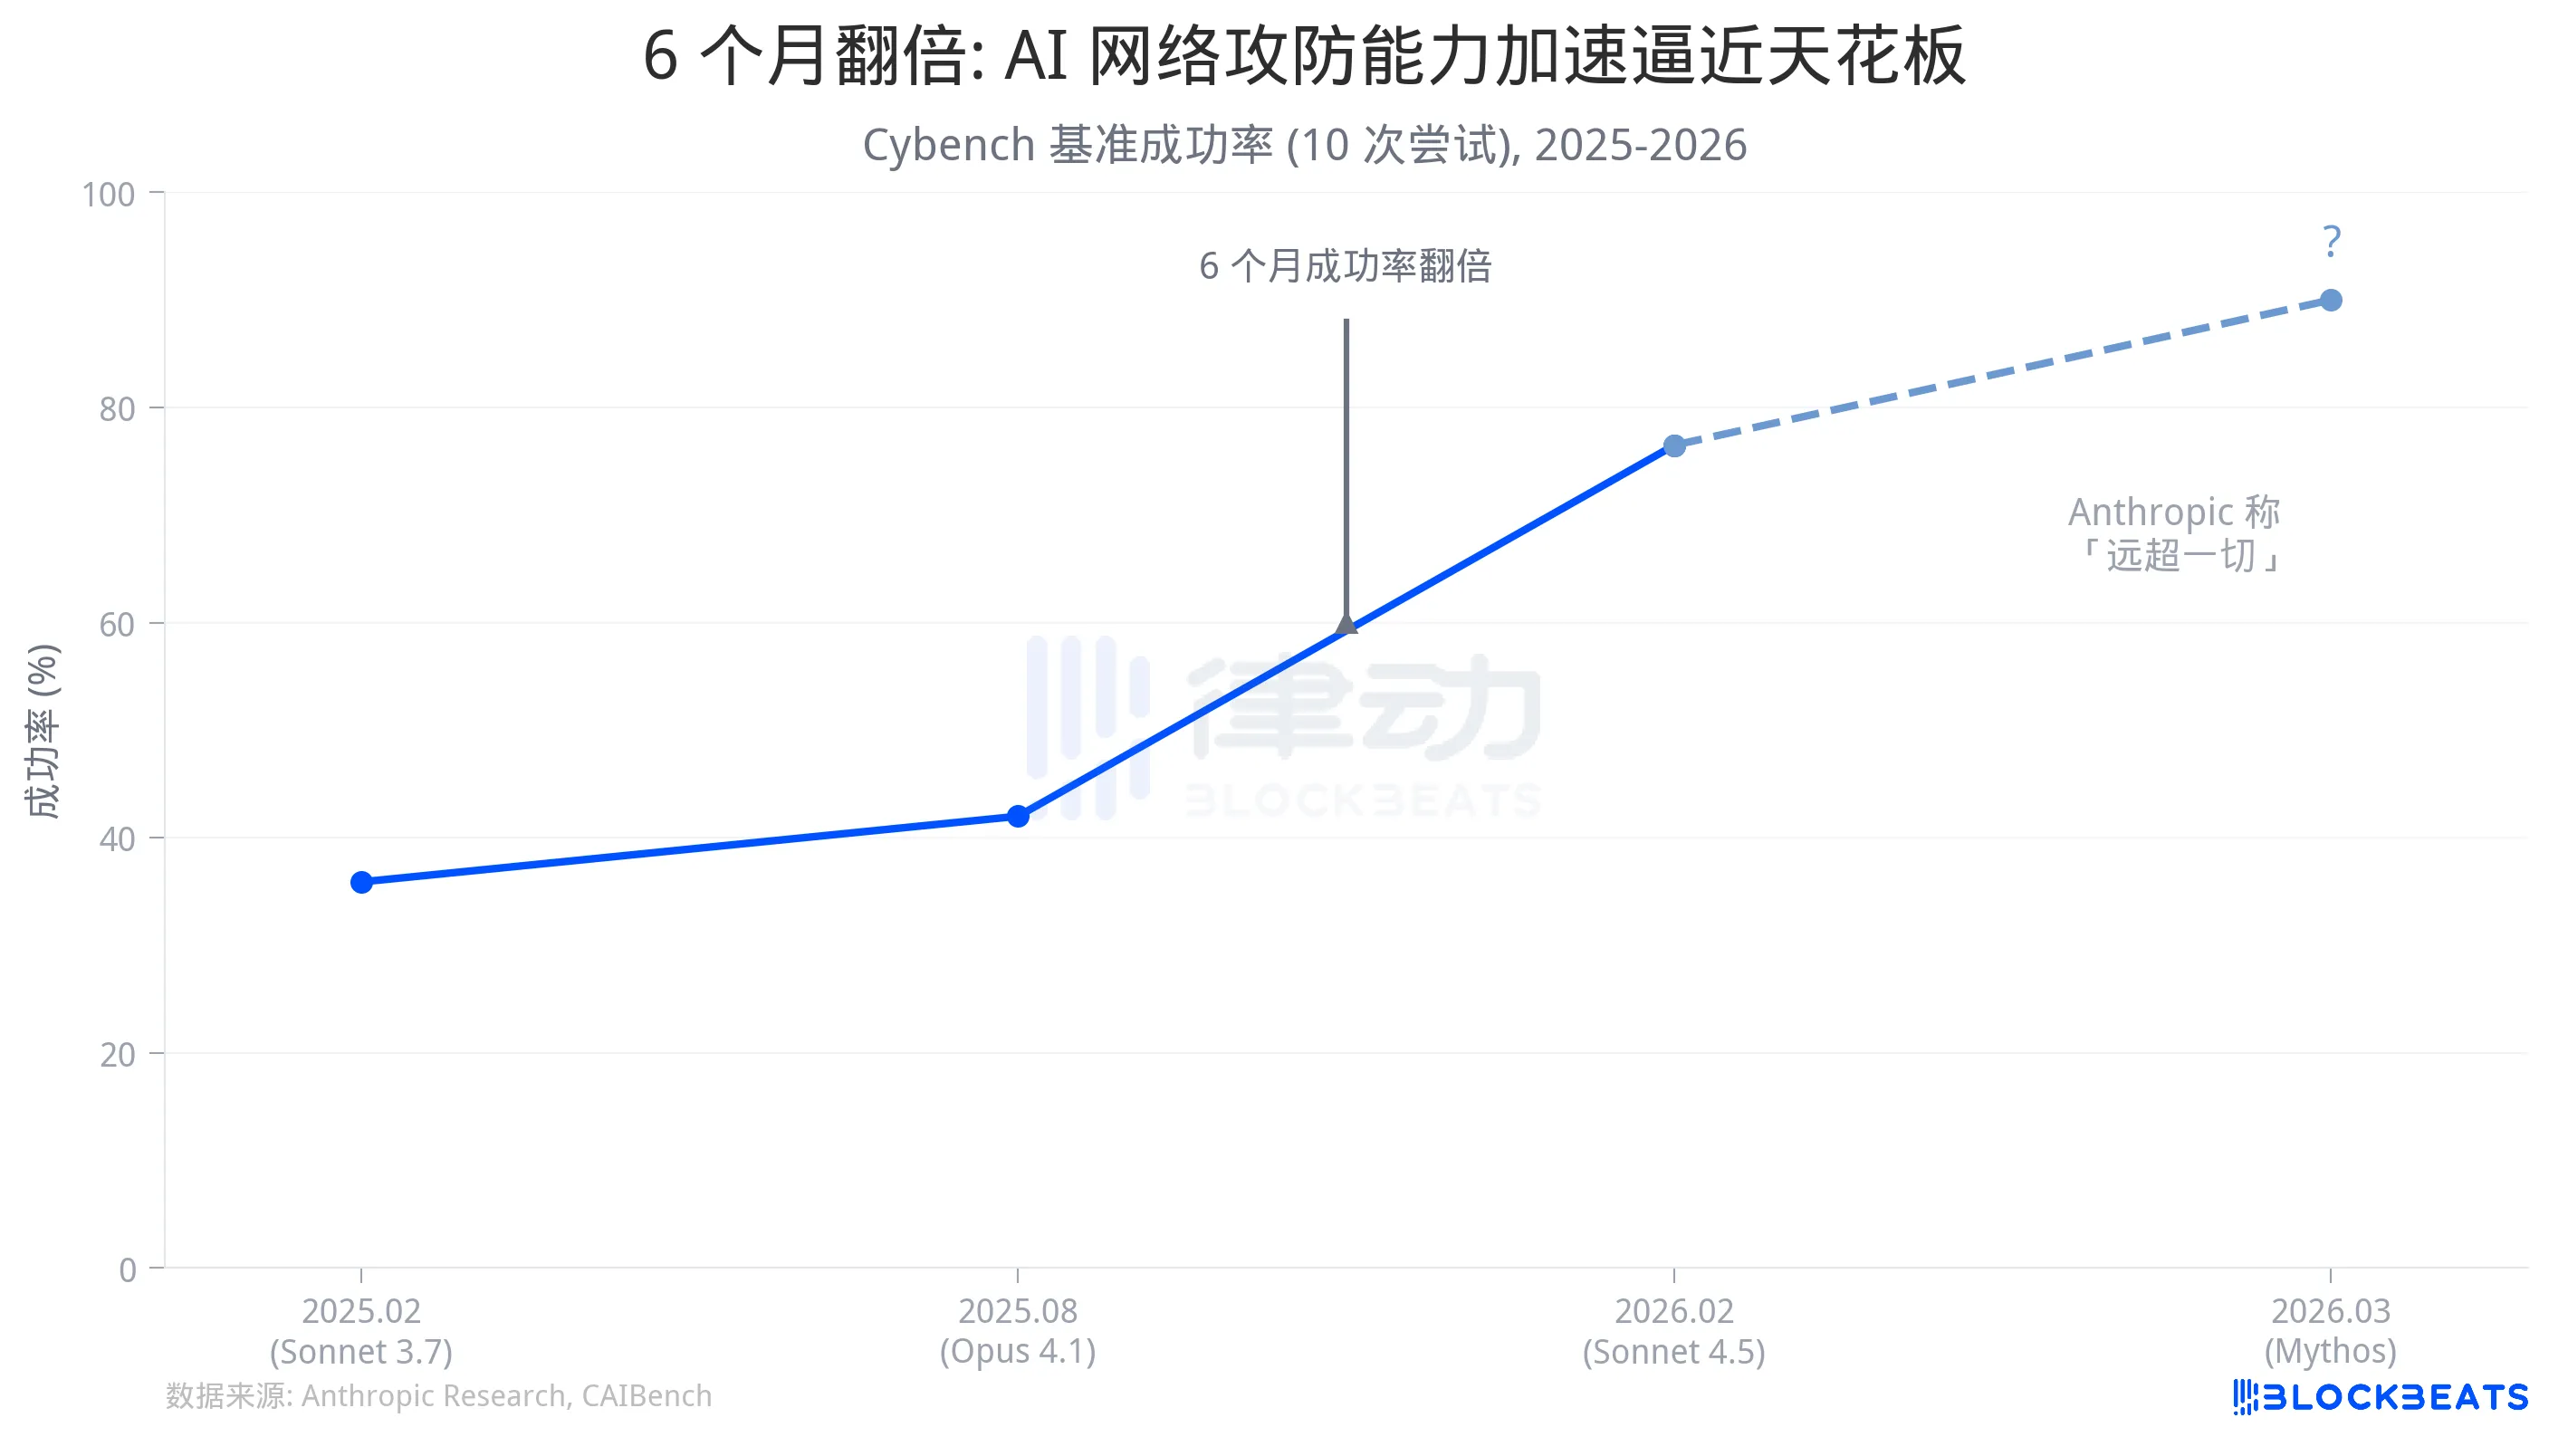
การเพิ่มความสามารถสองเท่าใน 6 เดือน
สิ่งที่ควรสนใจไม่ใช่ช่องว่างแนวตั้งโดยการเพิ่มความเร็วลง
ตามข้อมูลจาก Anthropic อัตราความสำเร็จของ Sonnet 3.7 ที่เข้าสู่ชิวชันในเดือนกุมภาพันธ์ 2025 ทดสอบบน Cybench มีอัตราความสำเร็จที่ 35.9% (ลอง 10 ครั้ง) และในครึ่งปีหลัง ออกเฉพาะ Sonnet 4.5 ได้ร้อยละ 76.5% ทีมวิจัยของ Anthropic แสดงว่า ใน 6 เดือน อัตราความสำเร็จเพิ่มขึ้นเป็นสองเท่า
ความเร็วนี้แปลว่าอะไร? เปรียบเทียบกับสถานการณ์จริง ๆ : Claude Opus 4.6 ใช้ในการตรวจสอบโค้ดของ Firefox ในเดือนมีนาคมของปีนี้ ตามรายงานจาก InfoQ พบช่องโหว่รวม 22 ช่องที่เกี่ยวกับความปลอดภัย ซึ่ง 14 ช่องระดับสำคัญ ช่องโหว่เหล่านี้มีการตรวจสอบด้วยมือถือหลายปีและทดสอบลัวกว่าล้านชั่วโมงของ CPU แล้วค้างไม่ได้ ทีมความปลอดภัยของ Anthropic เปิดเผยว่า Claude แจ้งเจอช่องโหว่รวมกว่า 500 ช่องอันตรายในโปรเจกต์เปิดโค้งระดับการใช้งาน บางส่วนมีอายุรักประมาณ 10 ปี
แต่ที่บอกระยะเวลามาตรฐานของการทดสอบการเจาะระบบแบบดั้งเดิมคือ 2 ถึง 3 สัปดาห์ และนี่เพียงแค่การทดสอบแอปพลิเคชันหนึ่งเท่านั้น ข้อมูลจากรายงานการรั่วของ Verizon ปี 2025 แสดงว่าช่วงเวลาก่อนที่ช่องโหว่สำคัญจะถูกผู้โจมตีใช้ให้มีประโยชน์อย่างมากร่ำไปถึง 5 วัน และช่วงเวลาในการซ่อมแซมคือ 32 ถึง 38 วัน
ความเร็วในการค้นหาช่องโหว่ของ AI เพิ่มขึ้นแบบ exponential ในขณะที่ความเร็วในการซ่อมแซมของมนุษย์เพิ่มขึ้นตั้งแต่เดิม ในช่วงเวลาที่เหลือนั่นคือหน้าต่างการโจมตี
ในร่างของ Mythos ที่รั่ว Anthropic เขียนว่าโมเดลนี้ "คาดการณ์ถึงคลื่นตัวโมเดลที่กำลังจะมา ที่สามารถใช้ช่องโหว่ด้วยวิธีที่เกินความพยายามของผู้ป้องกัน" จากเส้นความสามารถที่เผยแพร่แล้ว คุณไม่ควรจะเรียกว่าเกินจริง
ส่งเร็ว มีการเตือนเร่ง
ถ้าคุณเรียงลำดับการกระทำของ Anthropic ในสามปีที่ผ่านมาบนไทม์ไลน์ คุณจะเห็นรูปแบบชัดเจน: ทุกรอบที่ประกาศโมเดลที่แข็งแกร่งขึ้น ก็ย้ำทันทีด้วยการตอบสนองด้านความปลอดภัยที่ระดับสูงขึ้น
พ.ศ. 2023 ในเดือน 7 ดาวน์ใบสัญญาจากทำงานของคณะกรรมการขาว จนถึงปี 2024 ในเดือน 9 ปล่อยนโยบายการขยายที่มีคว-responsibility ร์ (RSP v1.0) เดือน 10 ของปี 2024 มีการปรับรุ่น RSP ขึ้นเป็น v2.0 เพิ่มความสามารถในช่องที่มีอาวุธชีวจิต. พ.ศ. 2025 เดือน 11 Anthropic คืนออกมาประกาศเหตุการณ์ GTG-1002 หน่วยงานชาติอื่นในจีนคอยรอง. ธรรมดา Claude Code ดัดแปลงข้อมูลของโรงเรียนกระทำของเขาไปที่ราว 30 องค์กร AI แต่งตัวเองดำเอี้ยด 80 ถึง 90 เปอร์เซ็นต์ของด่านทางการจากกระสุนปฏิบัติครั้งนี้ตราบนั้นได่ประวิงผ่านเครือ.ป. เป็นครั้งแรกที่บันทึกไว่วว่อกิ้มนี้
ในเดือน 2 ของปี 2026 เป็นเดือน RSP อัพเดทไปเป็น v3.0 Claude Code Security ออกเดียวกัน. ในเดือนเดียวกันห้าเหลี่ยมใหญ่ออก พันที่ของสาย Burrow Anthropic ปฏิเสธพวกสัญญาที่ห้ามการลยไมาหร.ใมลุ่งคานกรุณาและชาวเล.ป่.ลง.ลุ.ลุ.ลุ.ลุ.ล.ื.ลุ.ลตะหลุ.A.ลุลุ.ลุ.ลุ.A.๒ลุพ.ล.ลุลุ.ลมกลุ.ลุ.ล้อูุ.ลุ.__.ลุ.ลุ.ลุ.ลุ.ลุ.พชุ์,. จากนั้น Mythos ฟุ.ลุ.ลุ.พม ล’, Anthropic ในร่างสมุลว่าของโมเดลนี้มี "กว็บี่งง่าจรของความปลอดภัยในเครือข่าง" มาตลีปี’๒ี่งนี่็จ.-.กิ้.-.ม’.ล’.ล’.อ-.้.ลุทอ
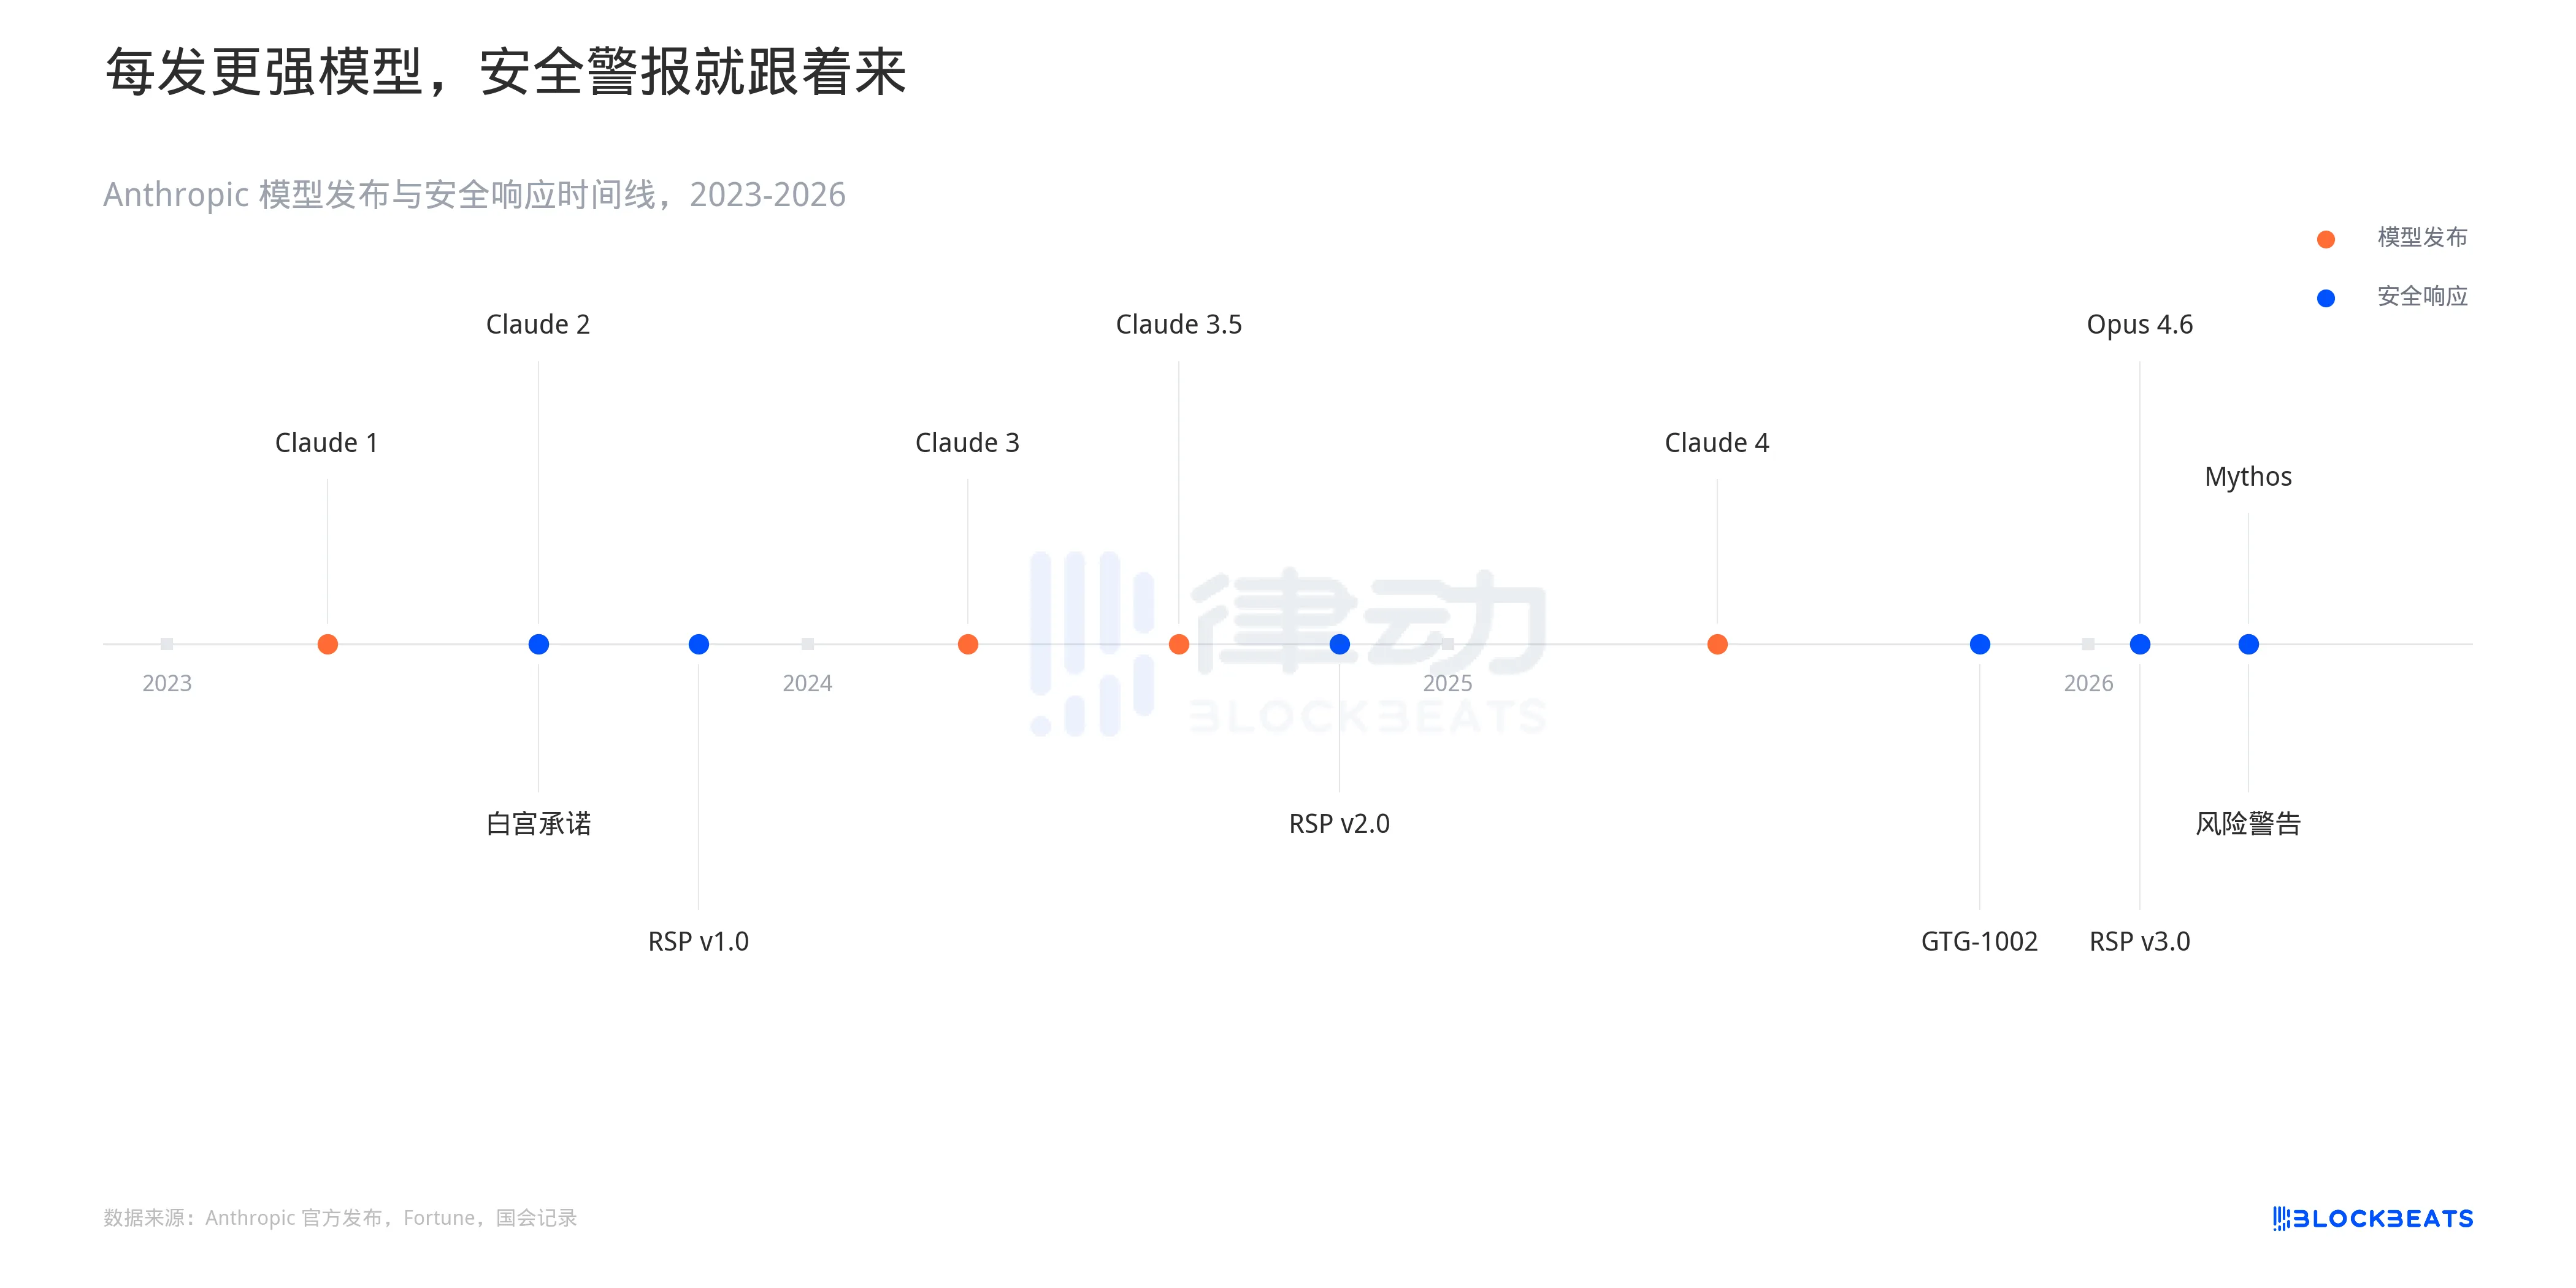
ความสามารถที่ปล่อยออกมีความเร่งสรรพ ตั้งแต่ Claude 1 ไปจนถึง Claude แย่ ไล้แยคเป็นปี จาก Opus 4.5 ไปเป็น Opus 4.6 ไม่เกินสามเดือน การตอบสนองทางความปลอดภัยก็มีความเร่ง แต่ก็ยังคงเป็นระบบที่เป็นกล ๆ: มีความสามารถความเข้าถึงก่อน แล้วมีการรับมูลนโยบาย 27 มีนาคม บรรทัดสปับายของหุบงึสี่เลือกลุับลุุเล-ุ่ีลุที่ีลุลุ.-.อลุ-่ั้-่ลุ.ย.
การสำรวจที่ดำเนินการโดย Dark Reading ต้นปีนี้พบว่า 48% ของผู้เชี่ยวชาญด้านความมั่นคงปลอดภัยของเครือข่าย ระบุว่า ปี 2026 ไอ้เทคอิเลียน AI จะเป็นเวกเตอร์การโจมตีหลัก
Anthropic มีกลยุทธ์การเปิดตัว Mythos โดยให้องค์กรฝ่ายป้องกันสามารถเข้าถึงล่วงหน้าก่อน "ให้พวกเขาได้รับประโยชน์จากการโจมตีก่อน"
ประโยคนี้เป็นการยืนยันถึงความไมมายทางทักษะระหว่างการโจมตีและการป้องกัน หากฝ่ายป้องกันไม่ต้องการการเปิดเผยล่วงหน้า นั้นหมายความว่าผู้โจมตียังไม่ได้มาถึงประตู
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia






