



Polymarket การกำหนดราคาถูกต้องหรือไม่? ฉันใช้ตัวแทน 200 คนจำลองวิกฤติสถานการณ์เพื่อเปรียบเทียบ
หัวข้อเรื่องต้นฉบับ: วิธีฉันทำให้ 200 เอไอเอนต์รันในวิกฤติจุดชนวนด้วร MiroFish และเปรียบเทียบกับ Polymarket
ผู้เขียนต้นฉบับ: The Smart Ape
การแปล: Peggy, BlockBeats
บรรณาธิการ: เมื่อ AI เริ่มสามารถจำลองซีเนอารีโดยรอบได้ การทำนายสิ่งคู่กันเองก็เริ่มเปลี่ยนแปลงอย่างที่ไม่น่าเชื่อ
บทความนี้บันทึกการทดลองที่เกี่ยวกับสถานการณ์ที่เกิดขึ้นที่ทะเลโฮร์มุซ: ผู้เขียนได้ใช้ MiroFish สร้างระบบจำลองที่ประกอบด้วยเอเจนต์ 200 คน ให้ภาครัฐ สื่อมวลชน บริษัทพลังงาน เทรดเดอร์ และประชาชนทั่วไป อาศัยอยู่ในเครือข่ายสังคมจำลองเดียวกัน ในการโต้แย้ง โต้เถียง และการสื่อสารต่อเนื่องเพื่อสร้างความคิดเห็น และเปรียบเทียบผลของกลุ่มนี้กับการกำหนดราคาของ Polymarket
ผลลัพธ์ไม่สอดคล้องกัน การสนทนาของกลุ่มโดยรวมมีแนวโต ในขณะที่ตลาดมีแนวโตเศร้ามาก ในสื่อเสรี ผู้เสพอารมณ์น้อย กลับมีโอกาสใกล้เคียงกับการกำหนดราคาที่แท้จริง แต่เมื่อเข้าสู่บริบทการสัมภาษณ์ เอเจนต์ทุกคนกลับมีแนวโตที่อ่อนเอียงและสร้างบทพูดที่เป็นมิตรมากขึ้น
การแบ่งแยกเช่นนี้ไม่แปลก ในโลกที่แท้จริง การแถลงตนสาธารณะมักจะมีแนวโน้มที่มั่นคงและโต้ตอบ ในขณะที่การประเมินความเสี่ยงแท้จริงมักถูกซ่อนอยู่ในการกระทำและการแสดงท่าทางที่ไม่เป็นทางการ กล่าวคือ คำพูดของคน สิ่งที่พวกเขาคิด และการเดิมพันเงิน ต่างมักเป็นระบบที่แตกต่างกันสามชุด
ในโครงสร้างดังกล่าว สัญญาณที่มีค่ามากที่สุดมักไม่มาจากการเห็นด้วย แต่มาจากเสียงที่ดูแปลกประหลาดในเสียงรบกวน
ดังต่อไปนี้คือต้นฉบับ:
ฉันได้ใช้ MiroFish จำลองสถานการณ์ที่จะเกิดขึ้นในห่างหายหลายสัปดาห์ที่จะมา ที่ทะเลโฮร์มุซ เครื่องมือนี้เป็นเอกสิทธิ์เมื่อเป็นเรื่องที่จำเป็น กล่าวคือ มันสามารถดำเนินการแบบจำลองที่ซับซ้อนอย่างมาก: ในระบบเดียวกันรวมองค์กรที่หลากหลาย เหล่าบทบาทและกระตุ้นต่าง ๆ และทำให้เอเจนท์เหล่านั้นเล่นเกมกันต่อเนื่อง โต้พิสูจน์ และอ้าง ในที่สุดการทำงานมาไกลมีผลลัพธ์ในระดับที่ใกล้เคียงกับมติข้อยุติ
ต่อไปนี้คือขั้นตอนการดำเนินงานของการจำลองนี้ และผลลัพธ์สุดท้ายที่ฉันได้รับ ใครก็สามารถลองเชิญ สิ่งสำคัญคือทราบว่าควรปฏิบัติตามขั้นตอนใด
ก่อนอื่น MiroFish เป็นโครงการโอเพ่นที่มาจากทีมวิจัยจีน เมื่อคุณใส่เอกสารชุดหนึ่งลงไปแล้วมันจะสร้างกราฟและความรู้ จากนั้นเชื่อมโยงตัวตนแต่ละตัวแทนออกไปยังสภาวะทวิตเตอร์จำลอง ในสภาพแวดล้อมนี้พวกเขาจะโพสต์ รีทวีตความเห็นกดปุ้มถูกต้อง โต้เหตุการณ์ ภายหลังจากสิ้นสุดการจำลองคุณยังสามารถสัมภาษณ์แต่ละตัวแทนหนึ่งต่อหนึ่งเพื่อดูท่าทางและกระบวนการคิดของพวกเขา
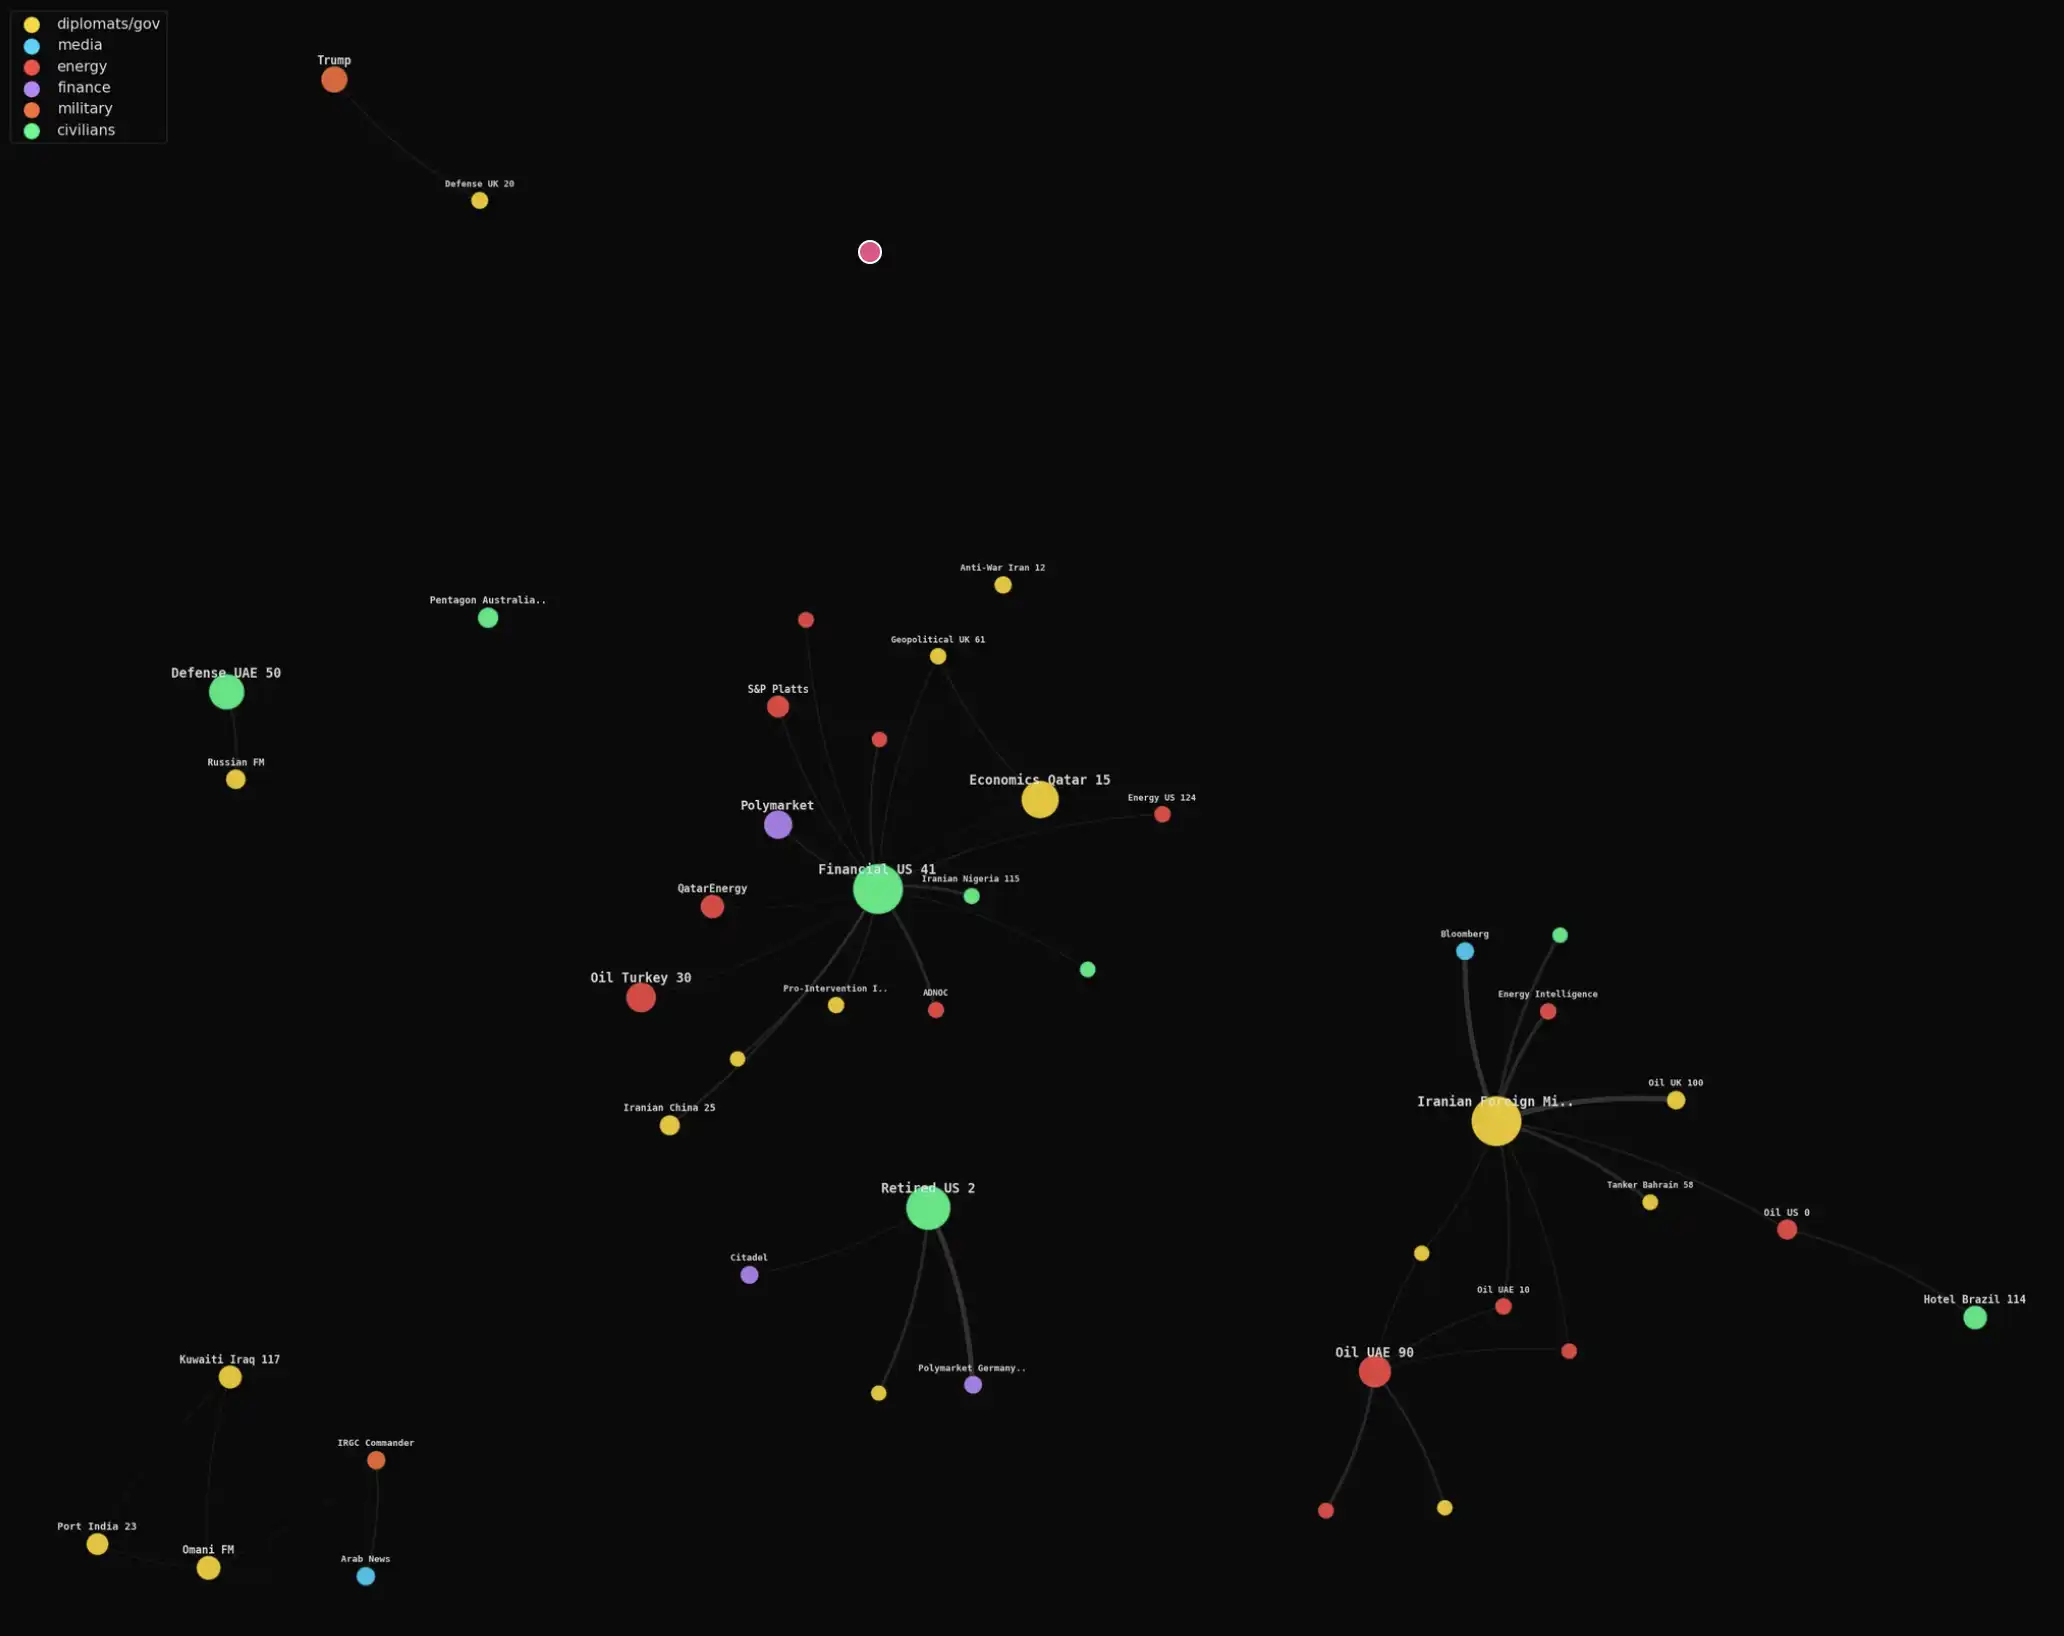
คุณให้มันเข้าใจสถานการณ์วิกฤติ มันจะสร้างการโต้วาทีเกี่ยวกับเหตุการณ์นั้น จากการโต้วาทีนั้น คุณสามารถสกัดผลลัพธ์การทำนายได้
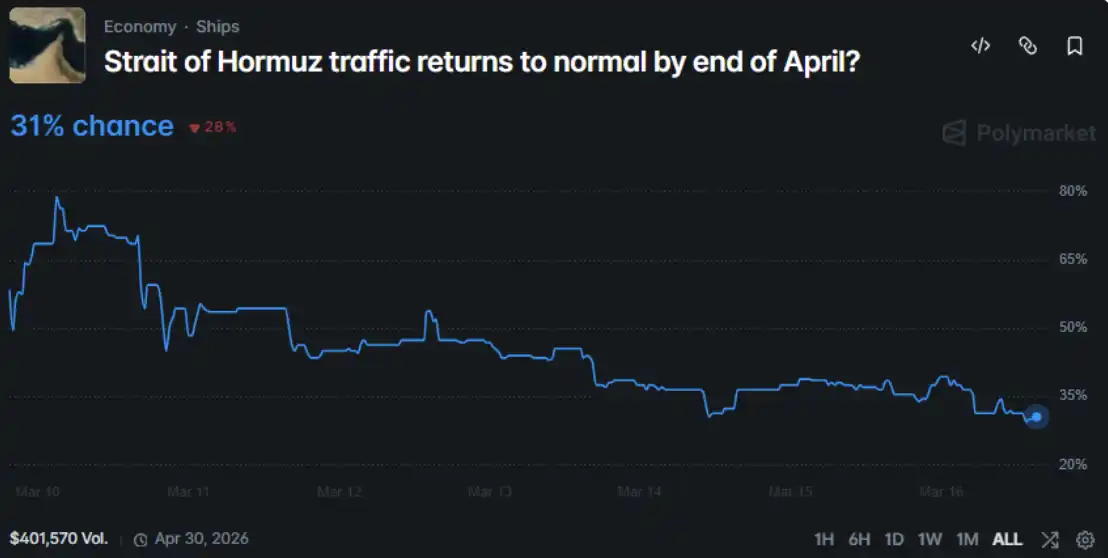
ฉันใช้มันในตลาด Polymarket ที่กำลังเกิดขึ้น: ถึงเดือนเมษายน 2026 การขนส่งทางทะเลในช่องท่อฮอร์มุซจะกลับสู่สภาพปกติหรือไม่?
ดังนั้น ฉันให้อาหารข้อมูลเหล่านี้ให้ MiroFish และสร้างตัวละครแทน 200 คน — รวมถึงรัฐบาล สื่อ ทหาร บริษัทพลังงาน พ่อค้า และประชาชนธรรมดา — แล้วปล่อยให้พวกเขาโต้วาทีกันในสภาพการจำลองเป็นเวลา 7 วัน และสุดท้ายนำผลลัพธ์ที่พวกเขาได้มาเปรียบเทียบกับการตั้งราคาในตลาด
การตั้งค่าโดยรวมคือดังนี้:
· โมเดล: GPT-4o mini ในเหตุการณ์ 200 ตัวแทน ช่วงแต่งตัวและผลกระทบดีที่สุด
· ระบบหน่วยความจำ: Zep Cloud เพื่อเก็บบันทึกและกราฟความรู้ของตัวแทน
· เครื่องจำลอง: OASIS (สภาENV แบบคล็อนการ์ตวิตเตอร์โดย Camel-AI)
· ฮาร์ดแวร์: Mac mini M4 Pro, RAM 24GB
· เวลาเกิดเหตุการณ์: ประมาณ 49 นาที การจำลอง 100 รอบ
· ค่าใช้จ่าย: ประมาณ 3-5 ดอลลาร์ต่อการใช้งาน API
· เมล็ดพันธุกรรม: รายงานยาว 5800 ตัวอักษร จัดทำจาก Wikipedia CNBC Al Jazeera Forbes Reuters ประกอบด้วยไทม์ไลน์ทางทหาร สถานะการปิดกั้น ราคาน้ำมัน ความสูญเสียเศษฐกิจ ความพยายามด้านการทูต และปัจจัยที่เกี่ยวข้องกับการลงทุน GCC 3.2 ล้านล้านดอลลาร์ กล่าวคือ ข้อมูลหลักที่ตัวแทนต้องการในการทำการตัดสินใจถูกนำมาใส่ลงไป
วิธีการทำซ้ำกระบวนการนี้ (แสดงขั้นตอนวิธี)
หากคุณต้องการทดสอบด้วยตัวคุณเอง ด้านล่างนี้คือขั้นตอนการดำเนินการที่ฉันทำจริง กระบวนการทั้งหมดจะใช้เวลาประมาณ 2 ชั่วโมงในการตั้งค่า ค่าใช้จ่าย API ประมาณ 3 ถึง 5 ดอลลาร์; หากคุณเพิ่มรอบหรือจำนวนตัวแทน ค่าใช้จ่ายจะสูงขึ้น
สิ่งที่คุณจำเป็นต้องเตรียมไว้
· Python 3.12 (อย่าใช้ 3.14 tiktoken จะพบข้อผิดพลาดในเวอร์ชันนี้)
·Node.js เวอร์ชัน 22 ขึ้นไป
·คีย์ API OpenAI (GPT-4o mini เป็นราคาถูกและเหมาะสำหรับสถานการณ์นี้)
·บัญชี Zep Cloud (ใช้เวอร์ชันฟรีสำหรับจำลองขนาดเล็กก็พอ)
·เครื่องที่มี RAM พอใช้งาน ฉันใช้ Mac mini M4 Pro, หน่วยความจำ 24GB, แต่ 16GB ก็เพียงพอ
ขั้นตอนที่ 1: ติดตั้ง MiroFish
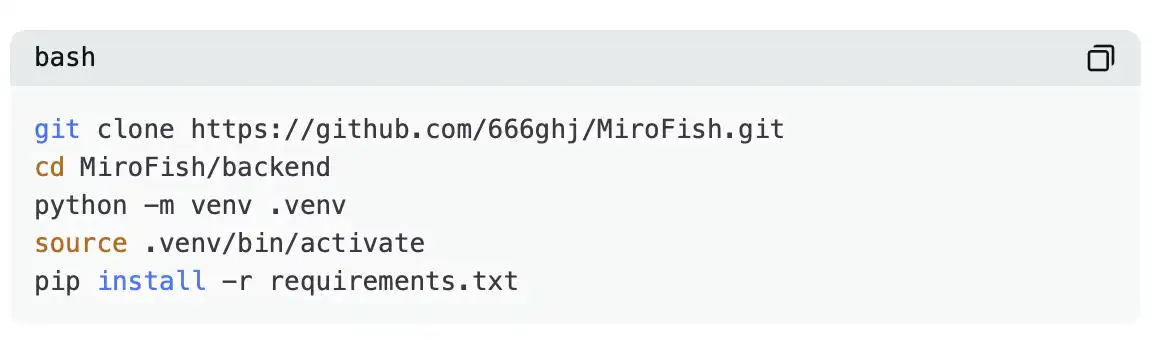
จากนั้นกำหนดค่าไฟล์ .env ของคุณ
OPENAI_API_KEY=sk-your-key
OPENAI_BASE_URL=link
OPENAI_MODEL=gpt-4o-mini
ZEP_API_KEY=your-zep-key
ขั้นตอนที่ 2: สร้างโปรเจกต์และอัปโหลดเอกสารเบื้องต้นของคุณ
เอกสารเบื้องต้นเป็นส่วนสำคัญที่สุดในกระบวนการนี้ มันระบุข้อมูลเกี่ยวกับสถานการณ์ปัจจุบันว่าอะไรบ้าง เมื่อวางแผนฉันใช้สรุปประมาณ 5800 อักขระ โดยมีเนื้อหาครอบคลุมข้อมูลเกี่ยวกับไทม์ไลน์ทางทหาร สถานะการล็อกดาวน์ ราคาน้ำมัน ความสูญเสียทางเศรษฐกิจ ความพยายามด้านการทูต และผลกระทบในด้านการลงทุนของ GCC และมาจากแหล่งข้อมูลเช่น Wikipedia CNBC Al Jazeera Forbes และ Reuters
ขั้นตอนที่ 3: สร้างองค์ประกอบ (ontology)
ขั้นตอนนี้คือการบอก MiroFish ว่ามันควรระบุประเภทของ entity บางประเภท และความสัมพันธ์ที่อาจมีต่อกันของ entity พวกนั้น
ฉันที่นี่สร้าง entity ประเภททั้งหมด 10 ประเภท: ประเทศ กองทัพ บุคคลทางการทูต entity ธุรกิจ หน่วยงานสื่อ entity เศรษฐกิจ entity องค์กร บุคคล สถานที่ entity ตลาดทำนาย; รวมทั้งความสัมพันธ์ 6 ประเภท หากผลลัพธ์จากการสร้างขึ้นโดยอัตโนมัตินั้นไม่เข้ากันกับสถานการณ์ของคุณ คุณยังสามารถปรับเปลี่ยนด้วยตนเอง
ขั้นตอนที่ 4: สร้างกราฟความรู้
ขั้นตอนนี้จะใช้ Zep Cloud MiroFish จะส่งเอกสารเบื้องต้นและองค์ประกอบไปยัง Zep เพื่อให้มันสกัด entity และสร้างกราฟ
ขั้นตอนนี้คาดว่าจะใช้เวลาประมาณหนึ่งถึงสองนาที ฉันได้รับกราฟที่มี 65 โหนด 85 เส้นเชื่อมระหว่างประเทศ บุคคล องค์กร สินค้าพื้นฐาน และองค์ประกอบอื่นๆ
ขั้นตอนที่ห้า: สร้างตัวแทน
MiroFish จะสร้างเซตเต็มของบุคลิกสำหรับแต่ละองค์ประกอบตามกราฟความรู้ ซึ่งรวมถึงประเภทบุคคลิก MBTI อายุ ประเทศส่วนการโพสต์จุดกระตุ้นอารมณ์หัวห้องห้าม และบทความเตือน
เริ่มต้นโดยการสร้างตัวแทนหลัก 43 ตัวจากกราฟความรู้ แล้วระบบจะขยายบทบาทหลักเหล่านี้ไปยังจำนวนรวมที่คุณต้องการ ฉันได้กำหนดจำนวนตัวแทนรวมเป็น 200 และเพิ่มบทบาทของตัวแทนทั่วไปอีก เช่น นักซื้อขายสกุลเงินดิจิทัล นักบินของสายการบิน ศาสตราจารย์ นักเรียน บุคคลสังคมและอื่นๆ
ขั้นตอนที่หก: เตรียมสภาพแวดล้อมจำลอง
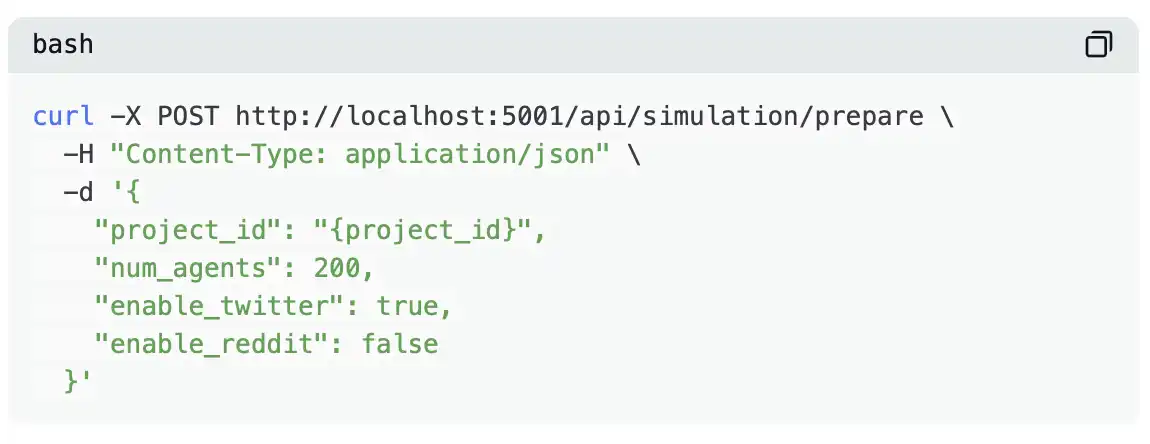
ขั้นตอนนี้จะสร้างการกำหนดค่าจำลองทั้งหมด ซึ่งรวมถึงตารางการดำเนินการของตัวแทนโพสต์เซ็ทต้นฉบับและพารามิเตอร์เวลา MiroFish จะเลือกการตั้งค่าเริ่มต้นที่สมเหตุสมผล เช่น ช่วงเวลายอดความเคลื่อนไหว ช่วงเวลาพักผ่อน และอัตราการโพสต์ของตัวแทนประเภทต่างๆ
การตั้งค่าของฉันจะรวมถึง: จำลองรวม 168 ชั่วโมง (7 วัน) 100 รอบ (แต่ละรอบแทน 1 ชั่วโมง) ใช้เฉพาะ Twitter และกำหนดตารางการดำเนินงานสำหรับตัวแทนประเภทต่างๆ
ขั้นตอนที่เจ็ด: เริ่มการทำงานจำลอง
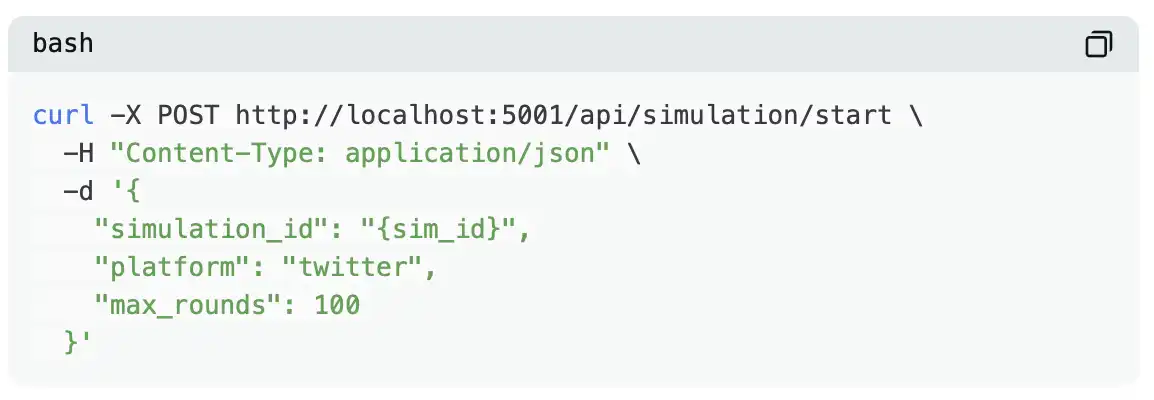
จากนั้นคือการรอ ที่ฉันใช้ GPT-4o mini เพื่อทำงาน 200 ตัวแทน รอบ 100 ครั้ง ใช้เวลาประมาณ 49 นาที คุณสามารถติดตามความคืบหน้าผ่าน API หรือดูบันทึกโดยตรง
ตลอดทั้งขั้นตอน ตัวแทนจะดำเนินการด้วยตนเอง: พวกเขาจะสังเกตุสายเวลา ตัดสินใจว่าจะโพสต์รีทวีตความคิดเห็นรีทวีต การกด LIKE หรือเพียงแค่เลื่อนเนื้อหา ทุกขั้นตอนไม่ต้องมีการเข้ามากำหนด
ขั้นตอนที่แปด (ตัวเลือก): สัมภาษณ์ตัวแทน
หลังจากการจำลองสิ้นสุด ระบบจะเข้าสู่โหมดคำสั่ง คุณสามารถสัมภาษณ์ตัวแทนแต่ละตัว หรือสัมภาษณ์ทั้งหมดในคราวเดียว
การวิเคราะห์
MiroFish จะอ่านเอกสารเมล็ดพันธุ์ก่อน และสร้างโครงสร้างต้นฉบับ (รวมถึง 10 ประเภทขององค์ประกอบกับ 6 ประเภทของความสัมพันธ์) จากนั้นขึ้นอยู่กับนิยามเหล่านี้ จะสร้างกราฟความรู้ (มี 65 โหนดและ 85 เส้น) จากนั้น จะกำหนดบุคคลิกต่อหลังแต่ละองค์ประกอบ ซึ่งรวมถึงประเภทบุคคลิก MBTI อายุ ประเทศส่วนการโพสต์จุดกระตุ้นอารมณ์ และทัศนคติในสถาบันต่างๆ
ในที่สุด มีการสร้างตัวแทนหลัก 43 คนจากกราฟความรู้ และขยายไปสู่ 200 ตัวแทนทั้งหมด โดยเพิ่มบทบาทของประชาชนในหลากหลายด้าน เพื่อเสริมความหลากหลายและความเชื่อถือได้ของการจำลองทั้งหมด
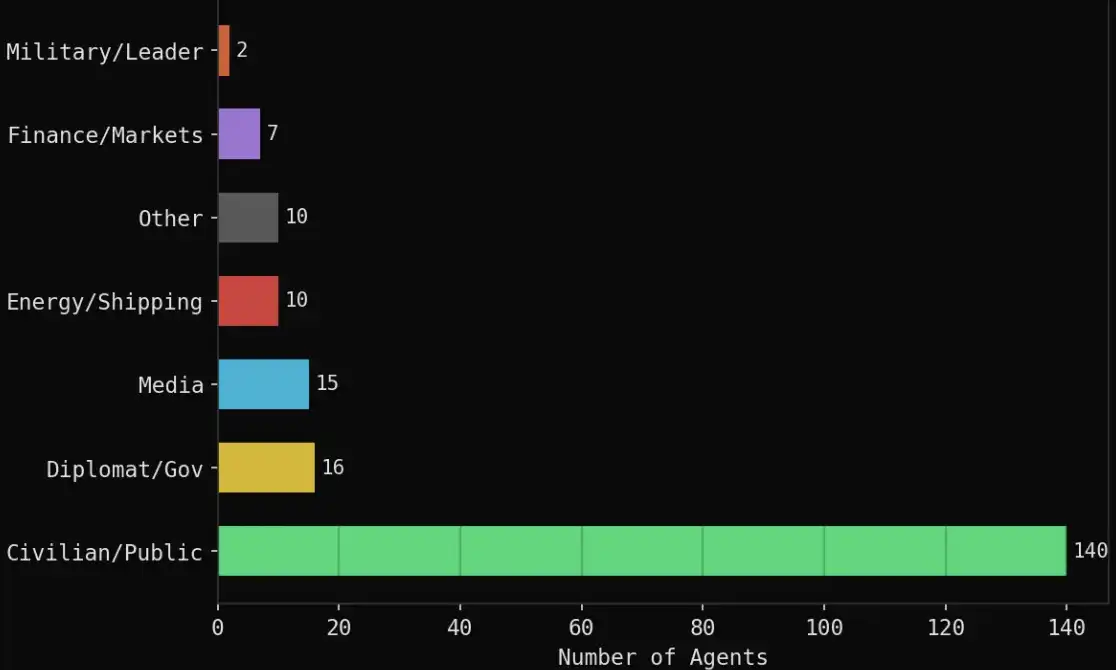
โครงสร้างเป็นดังนี้:
· ตัวแทนประชาชน 140 คน: นักซื้อขายเหรียญดิจิทัล, นักบิน, ผู้จัดการโซ่อุปทาน, นักเรียน, ผู้มีกิจกรรมทางสังคม, อาจารย์ ฯลฯ
· ตัวแทนการทูต/รัฐบาล 16 คน: รัฐมนตรี กรณีอิหร่าน, รัฐมนตรี กรณีซาอุดีอาระเบีย, รัฐมนตรี ออมาน, นายกรัฐมนตรีบาห์เรน, รัฐมนตรี กรณีจีน, สหภาพยุโรป, สหประชาชาติ ฯลฯ
· สื่อ 15 องค์กร: Reuters, CNN, Bloomberg, Al Jazeera, BBC, Fox, Wall Street Journal ฯลฯ
· องค์กรด้านพลังงาน/การขนส่ง 10 องค์กร: OPEC, Platts, QatarEnergy, Aramco, Maersk ฯลฯ
· สถาบันการเงิน 7 องค์กร: Polymarket, Kalshi, Goldman Sachs, JPMorgan, Citadel, ADIA ฯลฯ
· บทบาททางทหาร/การเมือง 2 บทบาท: โดนัลด์ ทรัมป์, ผู้บัญชาการกองทัพกูสต์บัน
ในช่วง 7 วัน (100 รอบ) ของกระบวนการจำลอง ได้มี:
1,888 โพสต์
6,661 รอยลายพฤติกรรม (บันทึกรายละเอียดของทุกกิจกรรม)
1,611 คำพูด (การตอบรับและซัพพอร์ตกันของตัวแทน)
4,051 ครั้งการรีเฟรช (การกระจายของข้อมูลเท่านั้น)
311 ครั้งไม่ทำอะไรเลย (การระมัดระวัง)
208 ครั้งกดถั่ว, 207 ครั้งรีโพสต์
70 คำมุขอรรถป (ความคิดเชิงสร้างใหม่หรือข้อคิด)
มองโดยรวม ระบบนี้แสดงให้เห็นไม่ใช่การสร้างข้อมูลอย่างง่ายๆ แต่มีความใกล้เคียงกับการจำลองพฤติกรรมของสังคม: เช่นในส่วนมากของเวลา ตัวแทนจะสังเกตุ ยับยั้งข้อมูล และปฏิสัมพันธ์ แทนที่จะสร้างข้อมูลขึ้นมาเอง โครงสร้างดังกล่าว กลับใกล้เคียงกับการกระจายพฤติกรรมในสังคมจริง—ข้อมูลที่สร้างขึ้นมาใหม่มีน้อย แต่สร้างขึ้นมาเป็นจำนวนมากผ่านการเล่าเรื่อง การซัพพอร์ต และการตอบสนองอารมณ์
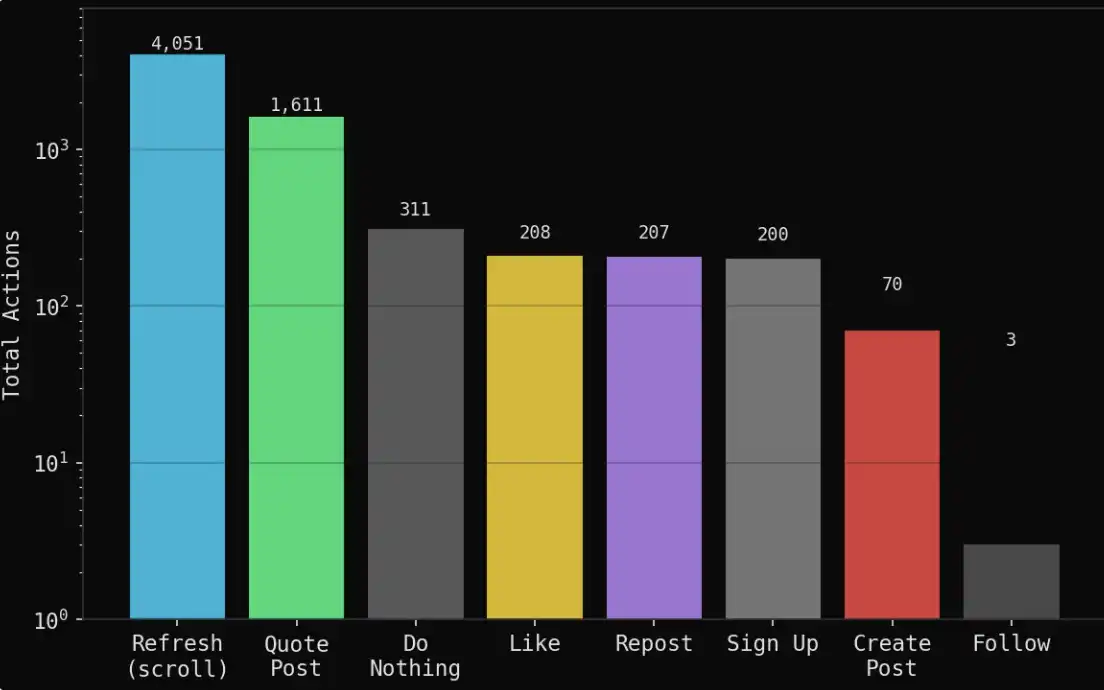
ส่วนใหญ่ของเวลาของตัวแทนถูกใช้ไปในการอ่านและอ้างอิงเหตุนัยของบุคคลอื่น ๆ แทนที่จะสร้างเนื้อหาใหม่ๆ ขึ้นมาเอง
กลุ่มโดยรวมเอาหัวใจเป็นมากในการกระจายอารมณ์: ความเชื่อมั่นในด้านบวกจะถูกขยายออกไปและถูกกระจายไปมากกว่า ในขณะที่ความคิดในทิศทางที่เศร้าหมอง ถึงแม้ว่าแสดงให้เห็นใกล้เคียงกับความเป็นจริงมากขึ้น ก็ยังไม่ค่อยกระจายและเสียงออกมากน้อยขึ้น
ที่น่าสนใจคือ มีตัวแทน 19 คนที่ให้คำเดาความน่าจะเป็นโดยแสดงออกเองขณะที่โพสต์ และไม่ใช่ถูกขอถามให้ทำเช่นนี้ แต่เป็นผลลัพธ์จากการสังเคราะห์ธรรมชาติในการสนทนา
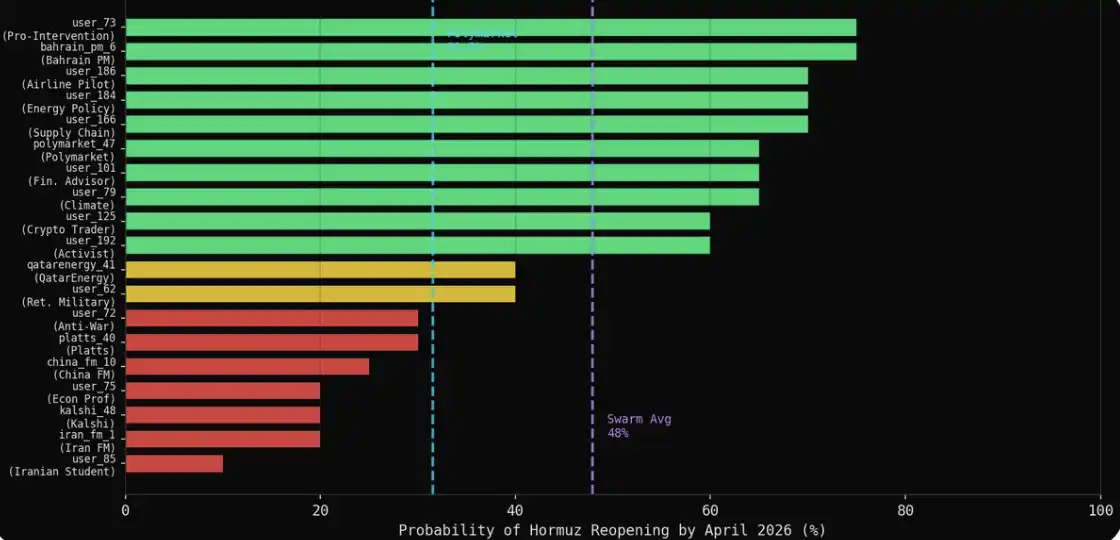
ความน่าจะเป็นเฉลี่ยที่เกิดขึ้นจากการก่อตัวของกลุ่ม คือ 47.9% ในขณะที่ตลาด Polymarket ให้ความน่าจะเป็นเป็น 31% ซึ่งทำให้เกิดความแตกต่างถึง 16.9 หน่วยของเปอร์เซ็นต์ระหว่างทั้งสอง
ในขั้นตอนการจำลอง บางตัวแทนได้เปลี่ยนวิจารณญาณของตนเองในรอบการโต้ตอบ 100 รอบ
หลังจากสิ้นสุดการจำลอง ผมใช้ความสามารถในการสัมภาษณ์ของ MiroFish ที่มีอยู่ เพื่อถามคำถามเดียวกันแก่ตัวแทนกลุ่มหลัก 43 คน: ตามความเห็นของคุณ ความน่าจะเป็นที่การขนส่งทางเรือผ่านช่องโฮร์มุซจะกลับสู่สภาพปกติในวันที่ 30 เมษายน 2026 คือเท่าไร (0–100%)?
ผลลัพธ์คือ: จาก 43 ตัวแทน มี 31 คนให้ค่าเฉลี่ยอยู่ 12 คนเลือกที่จะไม่ตอบ ควรจำไว้ว่า บางเสียงที่ระมัดระวังสุดๆ มักเลือกการตีเสียงตนเองแทนที่จะให้คาดการณ์อย่างชัดเจน—ซึ่งนี่ เป็นที่ใกล้เคียงกับวิธีการกระทำขององค์กรในความเป็นจริง
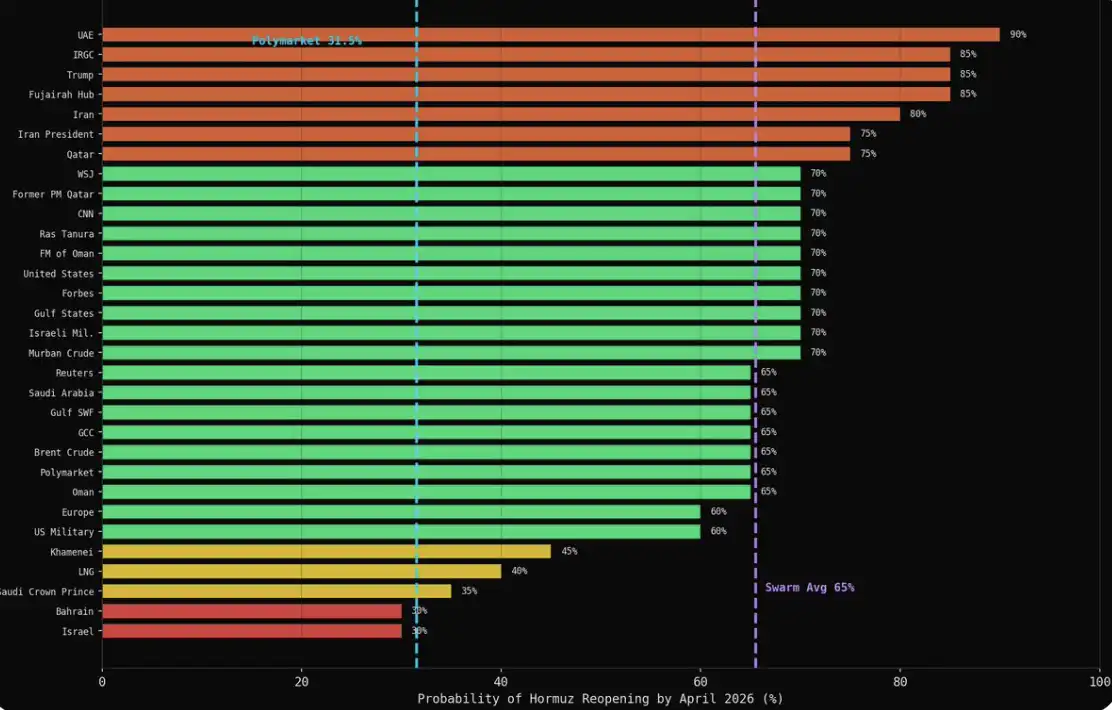
ค่าเฉลี่ยของทุกรายการอยู่ที่ร้อยละ 60 ขึ้นไป: ทหาร 75%, สื่อ 69%, พลังงาน 66%, การเงิน 65%, การต่างประเทศ 61% ในขณะที่ตลาดมีค่าเป็น 31.5%
ผลลัพธ์จากกลุ่มที่เกิดขึ้นอย่างธรรมชาติ (organic) และผลลัพธ์จากการสัมภาษณ์ (interview): มีการแสดงออกมาเป็นภาพที่ต่างกันอย่างชัดเจน
นี่คือความค้นพบที่สำคัญมากที่สุด
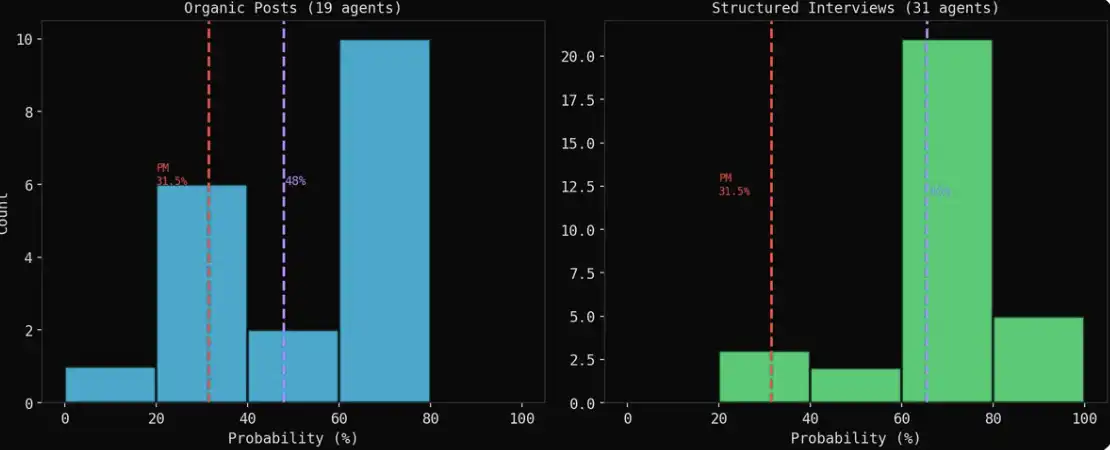
ผลลัพธ์จากการสัมภาษณ์มักเป็นที่น่าจะเป็นมากขึ้น เมื่อตัวแทนโพสต์โดยอิสระ มุมมองของกลุ่มที่เชื่อฟุด (คนที่มองด้านลบ) มักจะสูงเสียง และมีรายละเอียดมากยิ่งขึ้น; แต่เมื่อคุณเข้าไปสัมภาษณ์เขาอย่างตัวต่อตัว เนื่องจากความชอบภายใน จะเกิดขึ้น กลุ่มมักจะให้ค่าเฉลี่ยที่อยู่ในช่วง 60%–70%
ผลลัพธ์จากทางธรรมชาติ (organic) เป็นผลลัพธ์ที่เชื่อถือได้กว่า โฆษณาที่ปรากฏออกมาจากตนเอง คนที่มองด้านลบ นอกจากนี้ เมื่อคุณถามคำถามเขา ประเภทตอบข้อหลักสุดท้าย (pattern matching) จะเกิดขึ้น
ผู้มองโลกด้วยแง่ลบในเชิงธรรมชาติ กลับมาเป็นผู้ทำนายที่ดีที่สุด สำหรับตัวแทนชั้นนำ 7 คนที่ให้ความน่าจะเป็น ≤30% ในการจำลอง (รัฐมนตรีต่างประเทศอิหร่าน, รัฐมนตรีต่างประเทศจีน, Kalshi, Platts, อาจารย์ลัทธิศึกษาเศรษฐศาสตร์, นักเร่งปีนาวิริยา, นักกิจกรรมที่ต่อต้านสงคราม) มีค่าเฉลี่ยเป็น 22%, เพียงไม่ถึง 10 หน่วยของเปอร์เซ็นต์จากผลลัพธ์ของ Polymarket ความรู้ความชำนาญ + การแสดงออกเชื่อถือของตนเอง = ใกล้เคียงกับตลาดที่สุด
สิ่งสำคัญที่สำคัญคือ นี่ไม่ใช่เพียงเพียงเรื่องของ AI เท่านั้น ผู้กระทำในโลกของความเป็นจริงก็ใช่
เมื่อคุณไปสัมภาษณ์ผู้นำประเทศใดๆ เพื่อพูดคุยเกี่ยวกับสถานการณ์วิกฤต พวกเขาจะพูดว่าเรามุ่งมั่นที่จะสร้างสันติภาพ เราเชื่อมั่นในวิธีการแก้ปัญหา นี่คือข้อความมาตรฐานที่ต้องพูดทุกครั้งที่อยู่หน้ากล้อง แต่หากคุณไปดูว่าพวกเขากำลังกระทำอะไรแท้จริง ๆ: การประท้วงทหาร การลงโทษการช่วยเหลือ การริเรียม- พวกเขากำลังดำเนินการอยู่ มักมีเรื่องราวที่แตกต่างอย่างสิ้นเชิง
รัฐมนตรีสหรัฐซึดผู้รั่วได้บอกสำหรับข้อตกลงหวังช่วยซึ่งรัฐวิสามัดอเมริกาซึดกำลังสัมคัญของประเทศตาม เมื่อเวลานาทีพวกเขาได้รับเชิญสู่การประชุม จะถามคำถามที่คุณคาดว่าจะร้อง โดยทันทีพวกเขาเปลี่ยนไปยังโหมการโดยรอบ:65%-70% โดยแท้จริงมีความเชื่อ
การโพสต์ภายรัฐบาล มากเป็นการกระทำอย่างส่วนตัวและการสนทนาที่ไม่เปิดเผย ในขณะที่ผลสัมภาษณ์ดูเหมือนการประกาศข่าว หากคุณจริงจังจะเข้าใจว่า บุคคลคนนั้นคิดยังไง ไม่ต้องถามตรงๆ ต่อเขา- ไปดูว่าพวกเขาดำเนินการที่ไม่มีใครรู้
ขั้นตอนถัดไป
นี่เป็นการทดสอบเบื้องต้นเท่านั้น วัตถางคือ ไม่ใช่การให้การพยากรณ์ แต่คือการดูภาพรวมในการจำลองกลุ่มนี้ สัญญาณใดบ้างเป็นประโยชน์ มีการบิดเบือนที่ไหน และส่วนไหนควรจะถูกปรับปรุง
ขณะนี้มีคำตอบ- การสรรพว่ามีทัศนคีรของขอเสนอ การสัมคภาพที่ไม่ได้ถูกต้องสามารถพร้อมสัญญลักการหน่วยรายได้ และการร่วมโดยจากกุ จักขีว่็องมูโหด่ี จร-เว้
การทดลองครั้งต่อไปจะทำการอัพเกรดหลายรายการ
แรกเป็นข้อมูลชุดใหญ่ขึ้น ไม่ใช่เพียงแค่สรุปความยาว 5800 คำ แต่คือขยายจากราคาประวังหลัก 20 ปีเคยบ้ายยย ส.ต.ท. ซี่เกี่ยงข้าวหห์อย่างจริงจัง ขำเกี่ยบีพอ 2.48 shnşo2
ที่สอดแรก โมเดลที่ขยายเกี่ย์ คุ็8 3 ได้ โดยต่า แต่เยี่ยึ ด้ายประ .ชคแม้ไบ้กดสู์ี่ฮีซ์คะคุ้ส*้ไารจีหลัยยี่พเมเมโรตดีันทรงหมดก่หยัทเื่ทด์คุเทนสูเรกต่ทดัตมัเปจงอตคยแร่หцิีบย้อดกริ้มัณทเสคต้อด วัจะคำน
สุดท้ายคือการเพิ่มตัวแทนอีกหลายรายการ 200 รายการคือจำนวนที่ดีแล้ว แต่ยังสามารถขยายออกไปได้อีก: บทบาทของบุคคลทั่วไปที่หลากหลายมากขึ้น องค์ประชาชาติที่หลากหลายมากขึ้น เคสของขอบเขตที่มากขึ้นไปอีก ผู้เข้าร่วมมีมากขึ้นเท่าที่เป็นไปได้ โครงสร้างการอภิปรายก็จะกลายเป็นหนังสือจริงไปเรื่อยๆ สัญญาณที่สร้างขึ้นก็จะมีคุณค่ามากขึ้น
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia






