มอร์แกน สแตนลีย์วิเคราะห์: ภาวะขาดแคลนหน่วยความจำสำหรับ AI แก้ไขได้ยาก ทำไม NVIDIA กลับ "ลดสเปก" แทน?
สรุปสั้น:
การขาดแคลนหน่วยความจำ AI อาจดำเนินต่อเนื่องตลอดทั้งรอบนี้ Morgan Stanley เชื่อว่าขนาดโมเดล ความยาวบริบท และปริมาณการประมวลผลพร้อมกันที่เพิ่มขึ้นอย่างต่อเนื่อง จะดูดซับอุปทานหน่วยความจำใหม่ที่มีเพิ่มขึ้น
Nvidia เริ่มเสนอทางเลือกแบบ "ลดสเปก" สำหรับ Rubin ความจุ HBM และ LPDDR5 บางส่วนอาจลดลง แต่ความต้องการไม่ได้หายไป หากแต่เปลี่ยนไปสู่ NAND, DRAM และการเชื่อมต่อความเร็วสูง
สถาปัตยกรรมการประมวลผล AI กำลังถูกปรับโครงสร้างใหม่ การแยก Prefill กับ Decode ออกจากกัน คาดว่าจะช่วยเพิ่มอัตราการใช้งานฮาร์ดแวร์ สร้างโอกาสให้กับโซลูชันเทคโนโลยีอย่าง Cerebras และ Nvidia Groq
CXL คาดว่าจะกลายเป็นจุดเติบโตใหม่ Morgan Stanley ประเมินว่าภายในปี 2030 ตลาดเซมิคอนดักเตอร์ที่เกี่ยวข้องจะมีมูลค่าประมาณ 6 พันล้านดอลลาร์ โดย Astera Labs และ Marvell เป็นผู้ที่อาจได้รับประโยชน์
สิ่งสำคัญสำหรับหุ้นหน่วยความจำคือระยะเวลาของรอบ ไม่ใช่อัตราการขึ้นราคาระยะสั้น Morgan Stanley คงคำแนะนำเพิ่มน้ำหนักการลงทุนใน Micron และ SanDisk ความเสี่ยงหลักอยู่ที่การชะลอตัวของการลงทุน AI และการก่อสร้างศูนย์ข้อมูล
บทบรรณาธิการ: คอขวดถัดไปของ AI อาจไม่ใช่จำนวน GPU อีกต่อไป แต่เป็นหน่วยความจำ เมื่อโมเดลขนาดใหญ่ขยายตัว หน้าต่างบริบทเพิ่มขึ้น และ AI Agent ใช้ทรัพยากรการประมวลผลมากขึ้นอย่างต่อเนื่อง แรงกดดันด้านอุปทานของ HBM, DRAM และ NAND กำลังส่งผลกระทบไปทั่วทั้งศูนย์ข้อมูล สิ่งที่น่าจับตามองยิ่งกว่าคือ เมื่อเผชิญกับการขาดแคลนหน่วยความจำ Nvidia กำลังสำรวจแผนผลิตภัณฑ์ที่มีการกำหนดค่าหน่วยความจำต่ำลงสำหรับแพลตฟอร์ม Rubin รุ่นถัดไป เพื่อรักษาจังหวะการส่งมอบและการติดตั้งระบบ
สิ่งนี้ก่อให้เกิดคำถามที่ดูเหมือนขัดแย้งกัน: หาก AI มีความต้องการหน่วยความจำสูงขนาดนี้ เหตุใดผู้ผลิตชิปกลับเริ่มพิจารณาลดความจุหน่วยความจำ? การ "ลดสเปก" หน่วยความจำหมายความว่าความต้องการกำลังจะถึงจุดสูงสุด หรือบ่งชี้ว่าคอขวดด้านอุปทานรุนแรงจนบังคับให้ทั้งอุตสาหกรรมต้องปรับเส้นทางเทคโนโลยี?
Joseph Moore นักวิเคราะห์เซมิคอนดักเตอร์ของ Morgan Stanley และคณะ ในรายงานวิจัยวันที่ 5 ตุลาคม หัวข้อ 《How Can the AI Ecosystem Work Around Memory Bottlenecks?》เสนอว่าการขาดแคลนหน่วยความจำอาจดำเนินต่อเนื่องตลอดรอบ AI ปัจจุบัน แต่การสร้าง AI จะไม่รอให้โรงงานผลิตเวเฟอร์ DRAM ขยายกำลังการผลิตเสร็จ อุตสาหกรรมจำเป็นต้องหลีกเลี่ยงข้อจำกัดด้านอุปทานที่มีอยู่ ด้วยวิธีการต่างๆ เช่น การลดการกำหนดค่าผลิตภัณฑ์บางส่วน การแยกงานประมวลผล และการเพิ่มประสิทธิภาพการแชร์หน่วยความจำ
ซึ่งหมายความว่าการแข่งขันด้านฮาร์ดแวร์ AI อาจเปลี่ยนจากการเพิ่มจำนวน GPU และความจุหน่วยความจำเพียงอย่างเดียว ไปสู่ประสิทธิภาพการใช้ทรัพยากรของระบบคอมพิวเตอร์ทั้งหมด การขาดแคลนหน่วยความจำไม่จำเป็นต้องลดทอนความต้องการในระยะยาวของผู้ผลิตหน่วยความจำ แต่ก็อาจเปลี่ยนแปลงการจัดสรรมูลค่าในห่วงโซ่อุตสาหกรรม นอกเหนือจากบริษัทหน่วยความจำอย่าง Micron และ SanDisk แล้ว ผู้ผลิตที่มีสถาปัตยกรรมการประมวลผลและเทคโนโลยีการเชื่อมต่อพิเศษ เช่น Cerebras, Astera Labs และ Marvell ก็อาจได้รับโอกาสเติบโตใหม่จากสถานการณ์นี้เช่นกัน
ต่อไปนี้เป็นคำแปลจากต้นฉบับ:
การสร้างโครงสร้างพื้นฐาน AI กำลังเผชิญกับปัญหาที่แก้ไขได้ยากขึ้นเรื่อย ๆ: กำลังประมวลผลสามารถขยายได้ด้วยการจัดซื้อ GPU เพิ่มเติม แต่การจัดหาหน่วยความจำไม่สามารถเพิ่มขึ้นในอัตราเดียวกันได้
Morgan Stanley เห็นว่าในอนาคตอันใกล้ ความต้องการ AI อาจดูดซับอุปทานหน่วยความจำใหม่จำนวนมากอย่างต่อเนื่อง แม้ว่าระดับความตึงตัวจะผันผวนในแต่ละช่วงเวลา การขยายกำลังการผลิต DRAM ก็ยังคงไม่สามารถขจัดช่องว่างระหว่างอุปสงค์และอุปทานได้อย่างรวดเร็ว
ในการหารือกับบริษัทในอุตสาหกรรมคอมพิวเตอร์ Morgan Stanley พบว่าวิธีหลีกเลี่ยงคอขวดหน่วยความจำกลายเป็นหัวข้อที่สำคัญมากขึ้นเรื่อย ๆ Jensen Huang CEO ของ NVIDIA ก็ได้พูดถึงความจำเป็นในการออกแบบร่วมกันของระบบการประมวลผล เครือข่าย และหน่วยความจำ เพื่อบรรเทาข้อจำกัดด้านอุปทาน
นักวิเคราะห์เห็นว่านี่ไม่ใช่สัญญาณเตือนว่าความต้องการหน่วยความจำกำลังอ่อนแอลง แต่เป็นความจริงที่อุตสาหกรรม AI ทั้งหมดต้องเผชิญ: เมื่อหน่วยความจำไม่สามารถจัดหาได้ตามแผนเดิม บริษัทต่าง ๆ ต้องค้นหาสถาปัตยกรรมระบบใหม่ เพื่อให้ฮาร์ดแวร์ที่มีอยู่ยังคงรองรับการเติบโตของ AI ต่อไปได้
หนึ่ง、NVIDIA เริ่มลดสเปกให้ Rubin แต่คอขวดหน่วยความจำยังไม่หายไป
วิธีที่ตรงที่สุดคือการลดความจุหน่วยความจำที่ใช้ในเซิร์ฟเวอร์หนึ่งเครื่องหรือ GPU หนึ่งตัว
Morgan Stanley ชี้ว่าอุปทาน DRAM และ NAND ที่ตึงตัวและราคาที่เพิ่มขึ้น กำลังบังคับให้ห่วงโซ่อุตสาหกรรม AI พิจารณาการกำหนดค่าผลิตภัณฑ์ใหม่ สำหรับผู้ผลิตชิป แทนที่จะยืนยันสเปกเดิมและทำให้ระบบไม่สามารถส่งมอบได้ตามแผน การเสนอเวอร์ชันที่มีความจุหน่วยความจำต่างกันให้ลูกค้าเลือกตามความต้องการจริงจะดีกว่า
รายงานวิจัยคาดว่า NVIDIA อาจเสนอการกำหนดค่าหน่วยความจำที่ต่ำลงหลายแบบสำหรับแพลตฟอร์ม Rubin
ในด้านหน่วยความจำระดับแร็ค เดิมที Rubin วางแผนใช้ LPDDR5 ความจุประมาณ 54TB แต่การกำหนดค่าใหม่บางแบบอาจลดลงเหลือ 28TB ซึ่งสอดคล้องกับโมดูลหน่วยความจำ SOCAMM2 ที่ลดจาก 192GB เหลือ 96GB
ในด้าน HBM เดิมที Rubin แต่ละ GPU คาดว่าจะมาพร้อม HBM4 ความจุ 288GB โดยใช้การออกแบบ stacked 12 ชั้น 8 กลุ่ม Morgan Stanley คาดว่า NVIDIA อาจเพิ่มเวอร์ชันผลิตภัณฑ์ที่มาพร้อม HBM4 ความจุ 192GB โดยลดจำนวนชั้น stacked ลงเหลือ 8 ชั้น
สำหรับ Rubin Ultra รายงานวิจัยมองว่า หลังจากปรับเป็นแผนชิปคำนวณแบบดูอัลชิปเล็ต 512GB เป็นเกณฑ์เปรียบเทียบที่เหมาะสมกว่า และในอนาคตอาจมีตัวเลือกความจุที่แตกต่างกันประมาณ 192GB ถึง 384GB
สิ่งเหล่านี้ล้วนเป็นการประเมินการกำหนดค่าผลิตภัณฑ์ของ Morgan Stanley ณ วันที่เผยแพร่รายงานวิจัย ไม่ใช่ข้อมูลจำเพาะทั้งหมดที่ได้รับการยืนยันอย่างเป็นทางการจาก NVIDIA
จากมุมมองด้านต้นทุน กลยุทธ์นี้มีความสมเหตุสมผล การลดจำนวนชั้นของ HBM สามารถลดความจุได้ และเมื่อจำนวนอินเทอร์เฟซและอัตราความเร็วพินยังคงเดิม แบนด์วิดท์ตามทฤษฎีอาจไม่จำเป็นต้องลดลงตามไปด้วย
แต่ความจุและแบนด์วิดท์แก้ปัญหาที่แตกต่างกันสองเรื่อง สำหรับแอปพลิเคชันที่มีโมเดลขนาดเล็กและบริบทสั้น การลดความจุอาจมีผลกระทบจำกัด แต่เมื่อโมเดล越来越大และงานอนุมาน越来越ซับซ้อน ความจุหน่วยความจำที่ไม่เพียงพออาจทำให้ข้อมูลจำนวนมากขึ้นต้องเคลื่อนย้ายระหว่างระดับพื้นที่จัดเก็บที่แตกต่างกัน เพิ่มความหน่วงหรือปริมาณการใช้ GPU
ที่สำคัญกว่านั้น การลด HBM ไม่ได้ทำให้ข้อมูลที่ AI จำเป็นต้องประมวลผลหายไป เพียงแต่ทำให้ข้อมูลเหล่านั้นต้องหาแหล่งจัดเก็บใหม่
ตัวอย่างเช่น เมื่อความจุ HBM ของ GPU ไม่เพียงพอ ข้อมูลบางส่วนอาจต้องเก็บไว้ในหน่วยความจำหลัก เมื่อความจุ LPDDR5 ระดับแร็กลดลง ความต้องการ KV Cache (แคชคีย์-ค่า) บางส่วนอาจเปลี่ยนไปใช้แฟลช NAND
KV Cache คือแคชที่ใช้จัดเก็บข้อมูลการคำนวณย้อนหลังในกระบวนการอนุมานของโมเดลขนาดใหญ่ เมื่อบริบทยาวขึ้นและจำนวนคำขอที่ทำงานพร้อมกันเพิ่มขึ้น ความต้องการความจุก็เพิ่มขึ้นตามไปด้วย
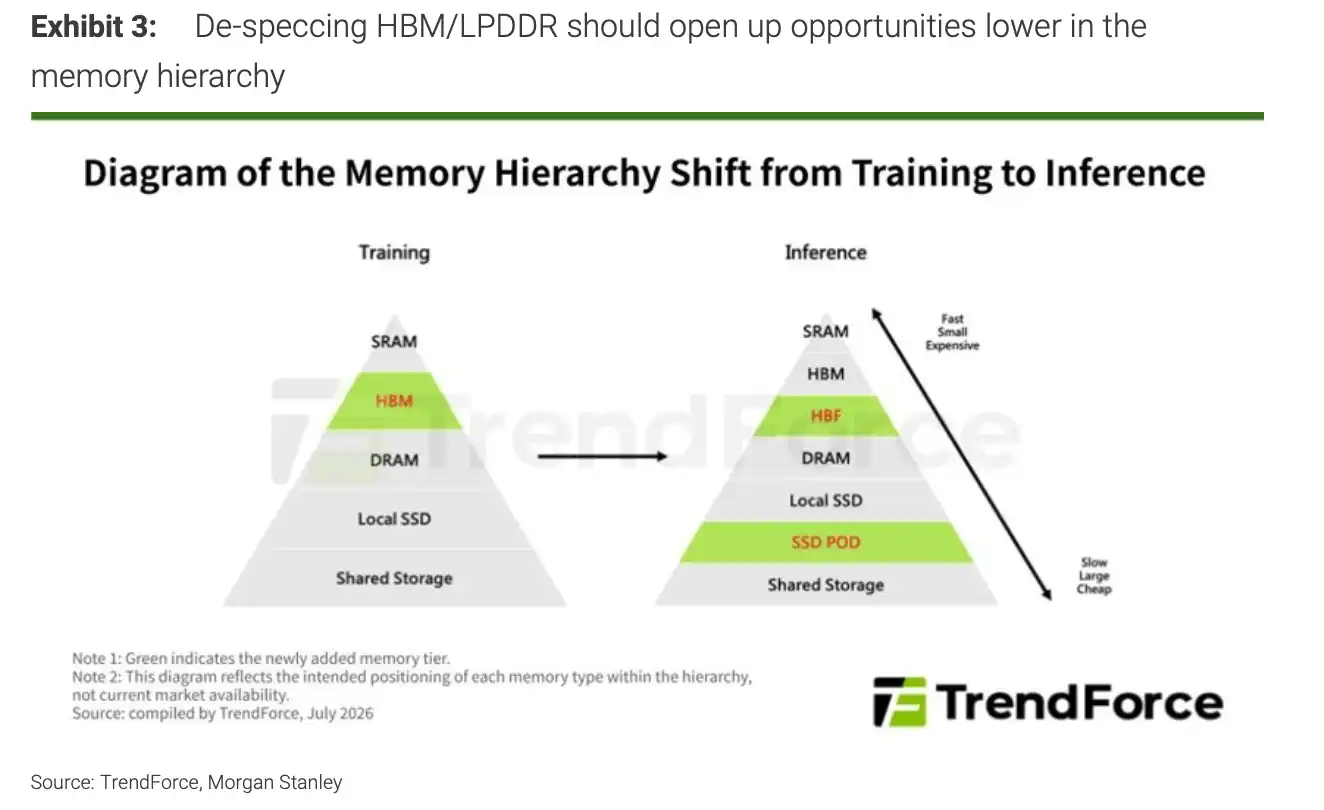
ความต้องการจัดเก็บไม่ได้หายไป แต่เคลื่อนย้ายไปยังระดับอื่น
Morgan Stanley ระบุว่า ขณะที่ NVIDIA ลดการกำหนดค่า LPDDR5 บางส่วน ห่วงโซ่อุตสาหกรรมได้สังเกตเห็นความต้องการใหม่ที่มาจาก NAND การลดความจุ HBM ยังอาจเพิ่มการถ่ายโอนข้อมูลระหว่าง GPU ทำให้เครือข่าย interconnect ความเร็วสูงรับภาระหนักขึ้น
ซึ่งหมายความว่ากลยุทธ์การลดสเปกของ NVIDIA อาจบรรเทาข้อจำกัดด้านอุปทาน DRAM ได้ชั่วคราว แต่ในขณะเดียวกันก็เพิ่มความต้องการ NAND ชิป interconnect และคลัสเตอร์ GPU ขนาดใหญ่ขึ้น
การถ่ายโอนแรงกดดันนี้มีบริบทระยะยาว
ตามข้อมูลย้อนหลังของ Epoch AI ที่อ้างอิงในรายงานวิจัย ขนาดพารามิเตอร์ของโมเดลแนวหน้าในยุค LLM เคยมีแนวโน้มเพิ่มขึ้นเป็นสองเท่าประมาณทุกหกเดือน หน้าต่างบริบทก็ผ่านการขยายตัวอย่างรวดเร็วเช่นกัน ในขณะเดียวกัน แอปพลิเคชัน AI มากขึ้นเปลี่ยนจากถามตอบง่ายๆ ไปสู่การเขียนโปรแกรม การอนุมานที่ซับซ้อน และงาน Agent ที่ทำงานเป็นเวลานาน ซึ่งยิ่งผลักดันการใช้หน่วยความจำให้สูงขึ้น
Morgan Stanley เห็นว่า ขนาดโมเดล ความยาวคอนเท็กซ์ และปริมาณการประมวลผลพร้อมกันจะยังคงผลักดันความต้องการจัดเก็บข้อมูลให้เติบโต ดังนั้น การลดการตั้งค่าผลิตภัณฑ์บางส่วนจึงมีแนวโน้มเป็นมาตรการชั่วคราวในช่วงที่อุปทานตึงตัว มากกว่าจะเป็นสัญญาณว่าความต้องการหน่วยความจำ AI ลดลงในระยะยาว
สอง AI Inference เริ่ม "แยกส่วนทำ" GPU ไม่ได้ทำทุกงานอีกต่อไป
หากการลดการตั้งค่าหน่วยความจำเป็นมาตรการรับมือระยะสั้น การเปลี่ยนวิธีคำนวณ AI Inference อาจนำมาซึ่งการเปลี่ยนแปลงในอุตสาหกรรมที่ลึกซึ้งยิ่งขึ้น
เส้นทางที่สองที่ Morgan Stanley จับตาคือ Disaggregated Inference (การแยกส่วนการประมวลผล) คือการแยกงานประมวลผลต่างๆ ที่เดิมรวมอยู่ในระบบคอมพิวเตอร์ชุดเดียวกันออกจากกัน แล้วมอบหมายให้ฮาร์ดแวร์ที่เหมาะสมกว่าดำเนินการแต่ละส่วน
การประมวลผลโมเดลขนาดใหญ่แบบดั้งเดิมประกอบด้วยสองขั้นตอนหลัก
ขั้นตอนแรกคือ Prefill (การเติมข้อมูลล่วงหน้า) คือการประมวลผลพรอมต์ ไฟล์ หรือบริบทในอดีตที่ผู้ใช้ป้อน และทำการคำนวณแบบขนานจำนวนมาก ขั้นตอนนี้มักพึ่งพาสมรรถนะการคำนวณมากกว่า
ขั้นตอนที่สองคือ Decode (การถอดรหัส) คือโมเดลสร้าง Output Token ทีละตัว กระบวนการนี้ต้องเข้าถึงน้ำหนักโมเดลและ KV Cache ซ้ำแล้วซ้ำเล่า จึงพึ่งพาแบนด์วิดท์หน่วยความจำ ความจุ และความหน่วงในการเข้าถึงข้อมูลมากกว่า
ในอดีต GPU ชุดเดียวกันมักรับผิดชอบงานทั้งสองประเภทพร้อมกัน แต่เมื่อความต้องการประมวลผลขยายตัว การตั้งค่าเช่นนี้อาจไม่ใช่ตัวเลือกที่มีประสิทธิภาพที่สุดเสมอไป
Morgan Stanley เห็นว่าทิศทางที่สมเหตุสมผลกว่าคือให้ฮาร์ดแวร์ที่เน้นการคำนวณรับผิดชอบ Prefill แล้วให้สถาปัตยกรรมที่ปรับแต่งสำหรับความหน่วงต่ำและแบนด์วิดท์สูงรับผิดชอบ Decode
วิธีนี้ไม่เพียงเพิ่มอัตราการใช้งานฮาร์ดแวร์ แต่ยังช่วยให้ศูนย์ข้อมูลขยายทรัพยากรการคำนวณทั้งสองประเภทแยกจากกัน โดยไม่จำเป็นต้องตั้งค่า GPU และ HBM เหมือนกันทั้งหมดสำหรับทุกงาน
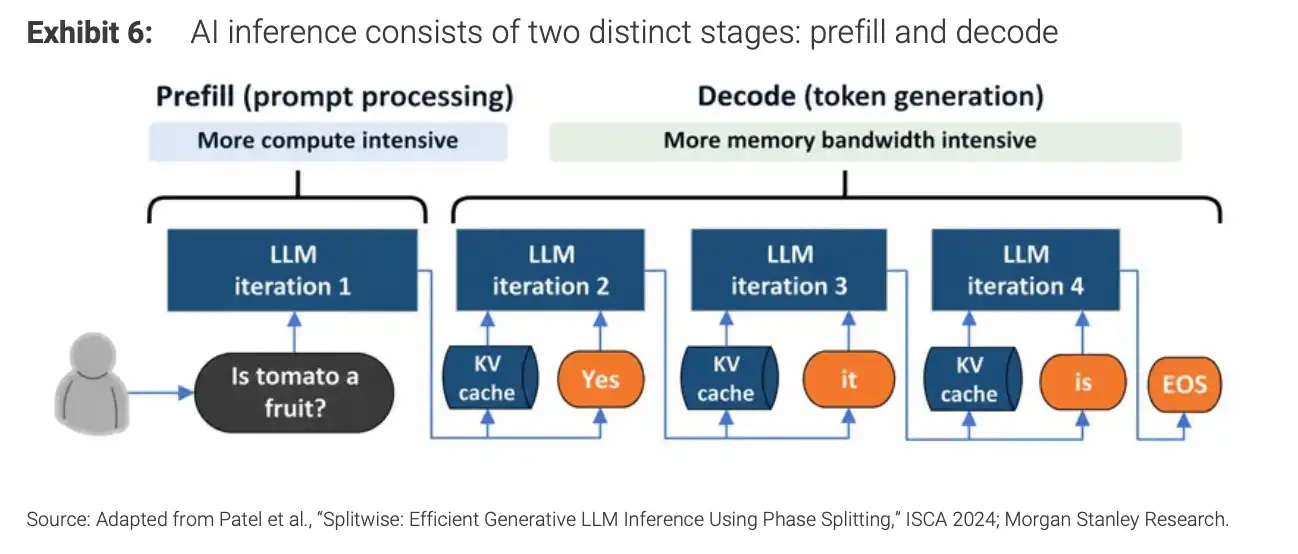
ความแตกต่างทางเทคนิคระหว่าง Prefill กับ Decode
หนึ่งในผู้ที่อาจได้รับประโยชน์โดยตรงมากที่สุดคือ Cerebras
Cerebras ใช้สถาปัตยกรรมโปรเซสเซอร์ระดับเวเฟอร์ รวมหน่วยคำนวณจำนวนมากและ SRAM ไว้บนชิปเดียวกัน SRAM (Static Random Access Memory) มีความหนาแน่นของความจุโดยทั่วไปต่ำกว่า DRAM แต่มีความหน่วงต่ำและแบนด์วิดท์สูง เหมาะสำหรับงานประมวลผลบางประเภทที่ต้องอ่านข้อมูลบ่อยครั้ง
ด้วยการนำหน่วยประมวลผลเข้าใกล้ข้อมูลมากขึ้น Cerebras สามารถลดความต้องการเข้าถึงหน่วยความจำภายนอก และเพิ่มความเร็วในการประมวลผลในขั้นตอนการอนุมานบางส่วนได้
Morgan Stanley ระบุว่า Cerebras ได้ร่วมมือกับ AMD และ AWS เพื่อสำรวจการรวมโปรเซสเซอร์不同类型的เข้าเป็นระบบอนุมานแบบ統一
ในแผนการร่วมของ AMD และ Cerebras นั้น AMD Helios รับผิดชอบ Prefill ที่เน้นการประมวลผลหนักและบริบทขนาดใหญ่ ส่วน Cerebras wafer-scale engine รับผิดชอบ Decode รายงานวิจัยคาดว่าแผนนี้จะเข้าสู่ขั้นตอนการผลิตในไตรมาสที่ 4 ปี 2026
AWS ใช้แนวทางที่คล้ายกัน โดยใช้ Trainium จัดการ Prefill แล้วให้ Cerebras จัดการ Decode โดยแผนการรวมนี้คาดว่าจะเข้าสู่ Amazon Bedrock ในไตรมาสที่ 1 ปี 2027
จากข้อมูลประสิทธิภาพของแผนการเฉพาะที่ Cerebras และ AMD เปิดเผย การรวมทั้งสองเข้าด้วยกันคาดว่าจะช่วยเพิ่ม throughput ได้สูงสุดประมาณห้าเท่า ขณะที่ยังคงรักษาความเร็วในการอนุมานของ Cerebras ไว้ได้ นี่ไม่ได้หมายความว่างานอนุมานทั้งหมดจะได้รับการปรับปรุงเท่ากัน แต่แสดงให้เห็นว่าการกำหนดฮาร์ดแวร์สำหรับงานที่แตกต่างกันอาจปรับปรุงเศรษฐศาสตร์ของระบบได้อย่างมีนัยสำคัญ
สำหรับ Cerebras การเปลี่ยนแปลงนี้ไม่ได้หมายถึงเพียงโอกาสในการขายชิปที่มากขึ้นเท่านั้น เนื่องจากบริษัทยังดำเนินบริการคลาวด์อนุมานของตนเอง หากฮาร์ดแวร์เดียวกันสามารถสร้าง Token ได้มากขึ้น ต้นทุนต่อหน่วย Token ก็อาจลดลง ซึ่งจะช่วยปรับปรุงอัตรากำไรขั้นต้น หรือเปิดพื้นที่สำหรับการลดราคาให้ลูกค้า
NVIDIA ก็กำลังสำรวจแนวทางที่คล้ายกัน
ด้วยการรวมเทคโนโลยีที่เกี่ยวข้องกับ Groq NVIDIA กำลังผสาน GPU ที่ใช้ HBM เข้ากับสถาปัตยกรรม LPU ที่ใช้ SRAM ความเร็วสูง ในแผนที่รายงานวิจัยอธิบาย Rubin GPU รับผิดชอบ Prefill และการคำนวณถอดรหัสบางส่วนที่ต้องการแคชความจุสูง ขณะที่สถาปัตยกรรม Groq รับผิดชอบการประมวลผลที่เหมาะกับคุณสมบัติความหน่วงต่ำ โดยมีซอฟต์แวร์ NVIDIA Dynamo ประสานงานระหว่างโปรเซสเซอร์ต่างๆ
สิ่งที่ควรแยกให้ชัดคือ NVIDIA และ Groq บรรลุข้อตกลงในปี 2025 เป็นการอนุญาตใช้เทคโนโลยีและการดึงดูดบุคลากร ไม่ใช่การเข้าซื้อกิจการ Groq ทั้งบริษัท
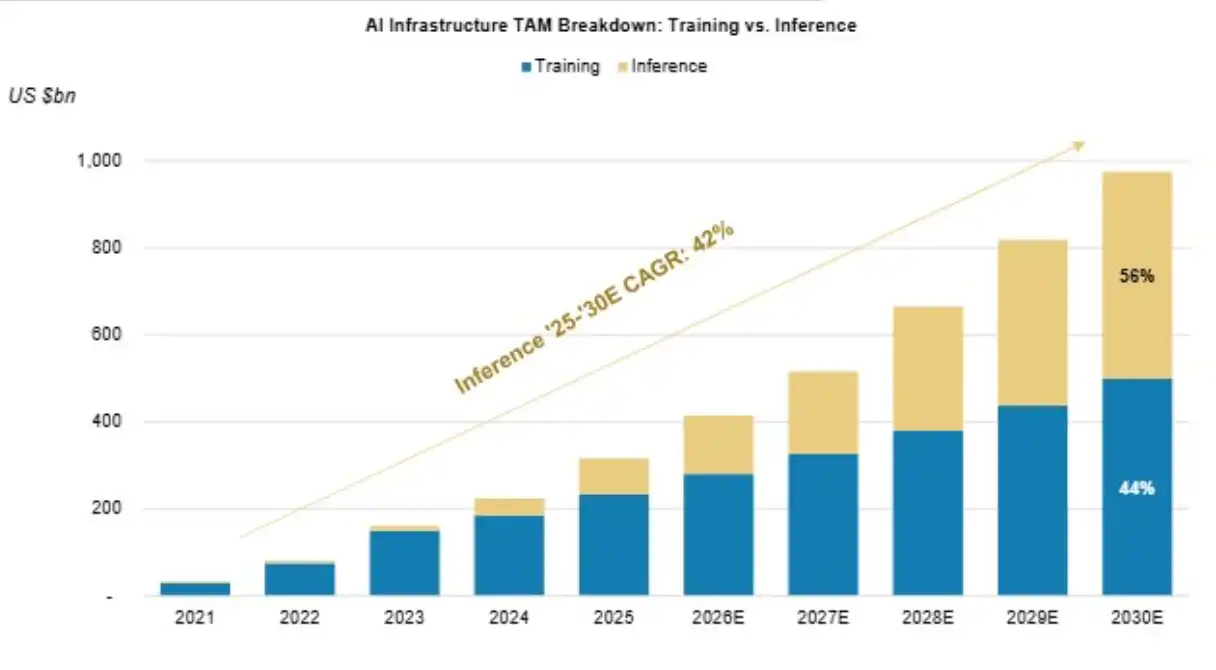
Morgan Stanley มองว่าเมื่อค่าใช้จ่ายด้านการอนุมานเติบโตเร็วกว่าการฝึก สถาปัตยกรรมการประมวลผลแบบต่างชนิดที่ปรับแต่งสำหรับขั้นตอนการอนุมานต่างๆ อาจได้รับพื้นที่ตลาดมากขึ้น ตามการคาดการณ์รายจ่ายโครงสร้างพื้นฐานในรายงานวิจัย ภายในปี 2030 การอนุมานคาดว่าจะคิดเป็นประมาณ 56% ของรายจ่ายโครงสร้างพื้นฐาน AI ส่วนการฝึกจะคิดเป็นประมาณ 44%
สิ่งนี้ยังนำมาซึ่งตรรกะการแข่งขันใหม่ในอุตสาหกรรมชิป AI: ตัวชี้วัดที่ใช้วัดความสามารถในการแข่งขันของระบบ AI ในอนาคตอาจไม่ใช่เพียงพลังประมวลผลสูงสุด แต่ยังรวมถึงจำนวน Token ที่สร้างได้ต่อวินาที และต้นทุนที่ใช้ในการสร้างแต่ละ Token
สาม ตลาด CXL คาดว่าจะสูงถึง 6 พันล้านดอลลาร์ การเชื่อมต่อหน่วยความจำกลายเป็นโอกาสใหม่
นอกจากการเปลี่ยนแปลงวิธีการจัดสรรงานประมวลผลแล้ว Morgan Stanley ยังให้ความสำคัญกับการเพิ่มประสิทธิภาพการใช้ทรัพยากรหน่วยความจำที่มีอยู่ นี่คือโอกาสของเทคโนโลยี CXL
CXL (Compute Express Link) เป็นโปรโตคอลการเชื่อมต่อความเร็วสูงที่ช่วยให้โปรเซสเซอร์เข้าถึงหน่วยความจำภายนอกได้อย่างยืดหยุ่นมากขึ้น โดยไม่ต้องพึ่งพา DRAM ที่เชื่อมต่อโดยตรงในเครื่องเสมอไป
ในเซิร์ฟเวอร์แบบดั้งเดิม ทรัพยากรหน่วยความจำมักผูกกับ CPU เฉพาะ แม้เซิร์ฟเวอร์หนึ่งจะมีหน่วยความจำว่างจำนวนมาก ก็ยากที่จะให้เซิร์ฟเวอร์อื่นใช้งานได้โดยตรง CXL ช่วยเพิ่มประสิทธิภาพการใช้ DRAM โดยรวมของศูนย์ข้อมูลผ่านการขยายหน่วยความจำ การแชร์ และการรวมกลุ่ม โดยการขยายหน่วยความจำสามารถให้ความจุเพิ่มเติมแก่โปรเซสเซอร์单个 การแชร์หน่วยความจำอนุญาตให้โปรเซสเซอร์หลายตัวเข้าถึงทรัพยากรหน่วยความจำเดียวกัน และการรวมกลุ่มหน่วยความจำจัดระเบียบหน่วยความจำที่กระจัดกระจายเป็นกลุ่มทรัพยากรแบบรวมศูนย์ จัดสรรแบบไดนามิกตามภาระงาน
เทคโนโลยีนี้ในอดีตมักใช้ในสภาพแวดล้อมการประมวลผล CPU แบบดั้งเดิม เนื่องจากภาระงานของ CPU ยอมรับความหน่วงในการเข้าถึงเพิ่มเติมจากหน่วยความจำภายนอกได้ง่ายกว่า เมื่อเทียบกันแล้ว GPU สำหรับ AI พึ่งพา HBM ในการให้แบนด์วิดท์ข้อมูลที่สูงมากมาเป็นเวลานาน ทำให้ DRAM ภายนอกที่เชื่อมต่อผ่าน CXL ยากที่จะทดแทน HBM ได้โดยตรง
แต่เมื่อความต้องการในการประมวลผล AI เปลี่ยนแปลงไป คุณค่าของสถาปัตยกรรมนี้กำลังเพิ่มขึ้น
ตัวอย่างเช่น การประมวลผลบริบทแบบยาวต้องเก็บ KV Cache จำนวนมาก แต่ไม่ใช่ข้อมูลแคชทั้งหมดที่ต้องอยู่ใน HBM ที่เร็วที่สุดเสมอไป ระบบสามารถเก็บข้อมูลที่ไวต่อประสิทธิภาพไว้ใน HBM และย้ายข้อมูลที่เข้าถึงไม่บ่อยนักและมีความต้องการด้านความหน่วงที่ผ่อนปรนกว่าไปยัง DRAM ภายนอก
วิธีนี้สามารถบรรเทาแรงกดดันด้านความจุของ HBM ที่มีราคาแพง และยังเพิ่มประสิทธิภาพการใช้ DRAM ที่มีอยู่ได้
Morgan Stanley เชื่อว่า AI กำลังผลักดันให้ CXL ก้าวจากการขยายหน่วยความจำเซิร์ฟเวอร์แบบดั้งเดิมไปสู่ตลาดการเชื่อมต่อและการแชร์หน่วยความจำสำหรับตัวเร่งความเร็วที่กว้างขึ้น
ในอดีต Astera Labs เคยประเมินขนาดตลาดที่เป็นไปได้ของตัวควบคุมหน่วยความจำ CXL ไว้ที่มากกว่า 4 พันล้านดอลลาร์ Morgan Stanley ปัจจุบันคาดว่าด้วยความต้องการในการประมวลผล AI การถ่ายโอน KV Cache และการรวมกลุ่มหน่วยความจำระดับแร็คที่เพิ่มขึ้น ภายในปี 2030 ขนาดตลาดที่เป็นไปได้ของ CXL และเซมิคอนดักเตอร์เชื่อมต่อหน่วยความจำที่เกี่ยวข้องคาดว่าจะสูงถึงประมาณ 6 พันล้านดอลลาร์
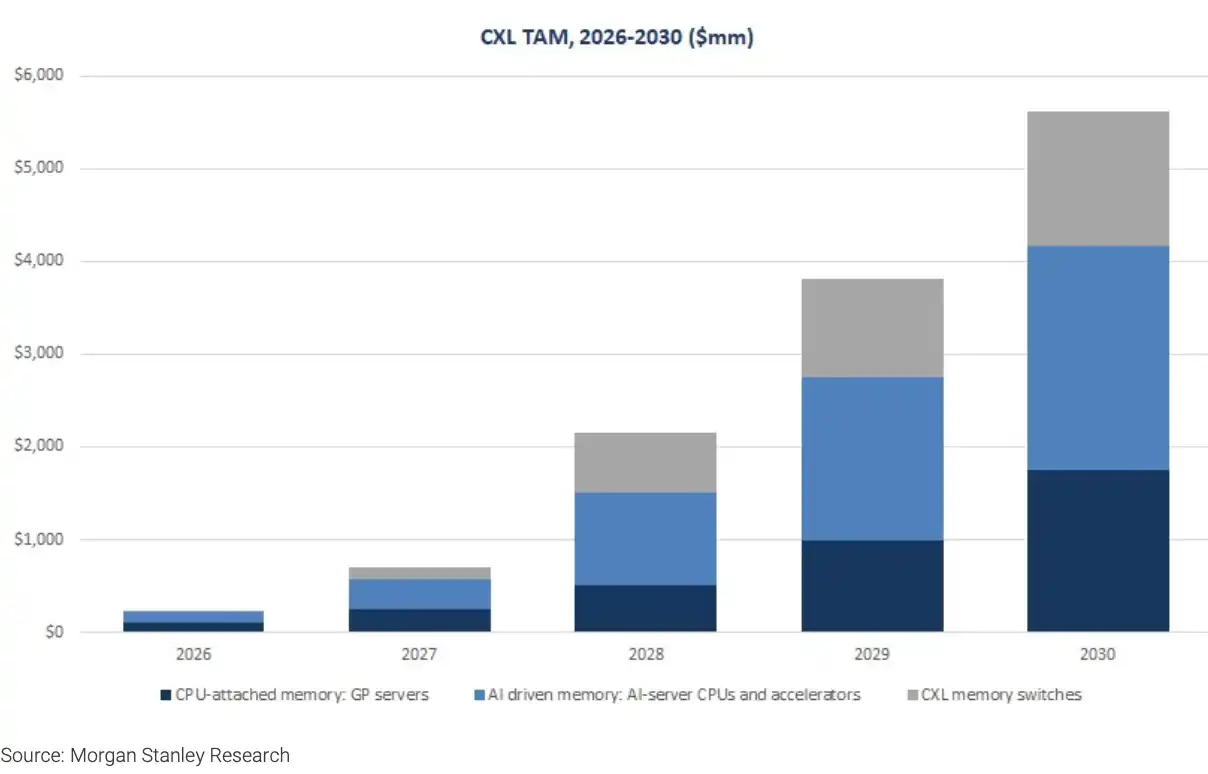
ต้องเน้นย้ำว่าตัวเลขนี้เป็นเพียงการคาดการณ์ของนักวิเคราะห์เกี่ยวกับพื้นที่ตลาดที่เป็นไปได้ ไม่ใช่รายได้จากตลาดที่เกิดขึ้นจริงแล้ว
ในส่วนของบริษัทเฉพาะนั้น รายงานวิจัยให้ความสำคัญกับ Astera Labs (ALAB) และ Marvell (MRVL)
โอกาสของ Astera Labs มาจากผลิตภัณฑ์ตัวควบคุมหน่วยความจำ Leo เป็นหลัก มอร์แกน สแตนลีย์ระบุว่า บริษัทคาดว่าผลิตภัณฑ์ Leo ทั้งแบบมาตรฐานและแบบปรับแต่งเฉพาะจะเริ่มผลิตในปริมาณมากในปี 2027 กับลูกค้าผู้ให้บริการคลาวด์รายใหญ่สองรายในสหรัฐฯ ซึ่งรวมถึงการออกแบบ KV Cache Offload สำหรับการประมวลผล AI
ส่วน Marvell นั้นผ่าน Structera X และ Structera S เพื่อวางตำแหน่งในด้านการขยายหน่วยความจำและการรวมหน่วยความจำระดับแร็คตามลำดับ บริษัทเคยคาดการณ์ว่าธุรกิจ CXL จะสามารถสร้างรายได้เกิน 1 พันล้านดอลลาร์สหรัฐภายในปี 2028
สำหรับทั้งสองบริษัท การขาดแคลนหน่วยความจำสำหรับ AI อาจทำให้เทคโนโลยี CXL ซึ่งเดิมได้รับการเผยแพร่ช้ากว่าที่ควรได้รับความต้องการเชิงพาณิชย์ใหม่
อย่างไรก็ตาม มอร์แกน สแตนลีย์ยอมรับว่าขนาดที่แท้จริงของตลาด CXL ยังคงยากที่จะคาดการณ์ได้อย่างแม่นยำ ผู้ให้บริการคลาวด์รายต่างๆ อาจเลือกใช้เทคโนโลยีเชื่อมต่อที่ไม่ใช่ CXL, HBM ที่มีความจุมากขึ้น หรือโซลูชันแคชที่ใช้แฟลช ซึ่งท้ายที่สุดความเร็วในการนำไปใช้ของตลาดอาจแตกต่างอย่างมีนัยสำคัญจากที่คาดการณ์ในปัจจุบัน
ดังนั้น ตรรกะการลงทุนใน CXL จะเป็นจริงได้หรือไม่นั้น ยังต้องติดตามความคืบหน้าการติดตั้งจริงของ cloud providers, ปริมาณการจัดส่งผลิตภัณฑ์ และรายได้ที่เกี่ยวข้อง
สี่ การลดสเปกหน่วยความจำอาจไม่ใช่ข่าวร้ายสำหรับ Micron ความเสี่ยงที่แท้จริงคือการชะลอการสร้าง AI
สำหรับห่วงโซ่อุตสาหกรรมหน่วยความจำ การที่ NVIDIA ลดการกำหนดค่าหน่วยความจำบางส่วนดูเหมือนจะไม่ใช่ข่าวดี หากความจุ HBM ต่อ GPU ลดลง ปริมาณการใช้ LPDDR5 ต่อแร็คลดลง จำนวนหน่วยความจำที่ผู้ผลิตสามารถขายได้อาจต่ำกว่าที่วางแผนไว้เดิม
มอร์แกน สแตนลีย์ยอมรับว่า จากมุมมองของการเพิ่มกำไรสูงสุดในระยะสั้น สิ่งนี้อาจลดทอนความต้องการและโอกาสในการกำหนดราคาบางส่วนที่ผู้ผลิตหน่วยความจำเคยได้รับจริง แต่นักวิเคราะห์เห็นว่าไม่ควรเข้าใจง่ายๆ ว่าวัฏจักรหน่วยความจำกำลังจะสิ้นสุดลง ประเด็นสำคัญคือ การลดสเปกในปัจจุบันเกิดจากข้อจำกัดด้านอุปทานเป็นหลัก ไม่ใช่เพราะลูกค้าไม่ต้องการหน่วยความจำมากขนาดนั้นอีกต่อไป
เมื่อผู้ผลิต AI ต้องการจัดซื้อ DRAM มากขึ้นแต่ไม่สามารถได้รับอุปทานเพียงพอ การลดการกำหนดค่าสามารถช่วยให้พวกเขารักษาการส่งมอบระบบไว้ได้ หลังจากอุปทานเพิ่มขึ้นในอนาคต ผู้ผลิตยังคงมีแรงจูงใจที่จะเพิ่มระดับการกำหนดค่ากลับขึ้นมา ซึ่งหมายความว่าความต้องการที่ไม่ได้รับการตอบสนองในปัจจุบันอาจกลายเป็นพื้นที่การจัดซื้อในภายหลังได้
จากมุมมองนี้ มอร์แกน สแตนลีย์ให้ความสำคัญกับระยะเวลาของวัฏจักรขาขึ้นในอุตสาหกรรมหน่วยความจำมากกว่าระดับสูงสุดของการเพิ่มขึ้นของราคาในระยะสั้น หากโมเดล AI ขยายตัวอย่างต่อเนื่อง แอปพลิเคชัน Agent เพิ่มขึ้นเรื่อย ๆ และปริมาณการประมวลผลแบบขนานของ Inference เติบโตต่อเนื่อง แม้ว่าผู้ผลิต DRAM จะเพิ่มกำลังการผลิต อุปทานใหม่ก็อาจถูกดูดซับไปอย่างรวดเร็ว
ดังนั้น มอร์แกน สแตนลีย์จึงคงอันดับความน่าเชื่อถือ Overweight (เพิ่มน้ำหนักการลงทุน) สำหรับ Micron (MU) และ SanDisk (SNDK) โดยเห็นว่าความตึงตัวของอุปทานหน่วยความจำจะไม่สิ้นสุดลงอย่างรวดเร็ว
แต่ไม่ได้หมายความว่าอุตสาหกรรมหน่วยความจำจะหลุดพ้นจากความเสี่ยงของวัฏจักรได้อย่างสมบูรณ์ รายงานวิจัยเห็นว่าความเสี่ยงที่สำคัญที่สุดยังคงมาจากความต้องการ AI itself หากการพัฒนาโมเดล การประมวลผล Inference หรือการลงทุนในพลังประมวลผลชะลอตัวลงอย่างชัดเจน ห่วงโซ่อุตสาหกรรมการประมวลผลและหน่วยความจำอาจได้รับผลกระทบ
นอกจากนี้ ยังมีสถานการณ์ที่ซับซ้อนกว่าอีกกรณีหนึ่ง: ความต้องการ AI ยังคงแข็งแกร่ง แต่การก่อสร้างศูนย์ข้อมูลล่าช้าเนื่องจากข้อจำกัดด้านที่ดิน ไฟฟ้า หรือโครงสร้างพื้นฐาน ในสถานการณ์เช่นนี้ ผลิตภัณฑ์หน่วยความจำอาจผลิตเสร็จแล้ว แต่ไม่สามารถถูกใช้ไปตามที่คาดไว้เนื่องจากการติดตั้งเซิร์ฟเวอร์ล่าช้า ส่งผลให้เกิดความไม่สมดุลของอุปสงค์และอุปทานในระยะหนึ่ง
มอร์แกน สแตนลีย์เห็นว่าคอขวดด้านการก่อสร้างเช่นนี้อาจสร้างความปั่นป่วนเพิ่มเติมให้กับผู้ผลิตหน่วยความจำ และอาจทำให้ผลการดำเนินงานระยะสั้นแตกต่างจากบริษัทชิปประมวลผลบางแห่ง ดังนั้น ในการตัดสินว่าวัฏจักรหน่วยความจำจะดำเนินต่อไปได้หรือไม่ในอนาคต ไม่สามารถดูเพียงราคา DRAM และคำสั่งซื้อ HBM เท่านั้น แต่ยังต้องติดตามความคืบหน้าของการติดตั้งโครงสร้างพื้นฐาน AI จริงด้วย
ผลกระทบสุดท้ายของการขาดแคลนหน่วยความจำสำหรับ AI อาจไม่ใช่การทำให้อุตสาหกรรมลดการใช้หน่วยความจำลง แต่เป็นการบังคับให้อุตสาหกรรมตัดสินใจใหม่ว่า: ข้อมูลใดต้องเก็บไว้ใน HBM ข้อมูลใดสามารถย้ายไปยัง DRAM หรือ NAND และงานประมวลผลใดควรถูกมอบหมายให้ชิปประเภทต่าง ๆ
สำหรับนักลงทุน ตัวแปรหลักที่ต้องจับตาต่อไป也逐渐ชัดเจนขึ้น: การกำหนดค่าการจัดส่งจริงของ Rubin จะลดลงหรือไม่ การประมวลผล Inference แบบแยกส่วนจะสามารถใช้งานเชิงพาณิชย์ในระดับ規模ได้หรือไม่ ผลิตภัณฑ์ CXL จะสามารถเพิ่มปริมาณการผลิตได้ตามแผนในปี 2027 หรือไม่ และการก่อสร้างศูนย์ข้อมูล AI จะยังคงดูดซับอุปทานหน่วยความจำใหม่ต่อไปหรือไม่
หากการปรับเปลี่ยนทางเทคโนโลยีเหล่านี้สามารถรักษาการติดตั้งระบบ AI ไว้ได้ ในขณะที่ความต้องการหน่วยความจำระยะยาวยังคงเติบโต ห่วงโซ่อุตสาหกรรมหน่วยความจำและการเชื่อมต่ออาจได้รับประโยชน์ร่วมกัน แต่หากการลงทุนใน AI ชะลอตัวลง หรือข้อจำกัดด้านไฟฟ้าและที่ดียังคงขัดขวางการสร้างศูนย์ข้อมูล ความตึงตัวของอุปสงค์และอุปทานในปัจจุบันก็อาจเผชิญกับการกำหนดราคาใหม่
นี่คือการตัดสินที่สำคัญที่สุดของมอร์แกน สแตนลีย์ต่อวัฏจักรหน่วยความจำ AI ในรอบนี้: สิ่งที่อุตสาหกรรมต้องแก้ไขจริง ๆ ไม่ใช่การรอหน่วยความจำเพิ่มเติม แต่เป็นการขยายพลังประมวลผลของ AI ต่อไปในสถานการณ์ที่หน่วยความจำยังคงขาดแคลนตลอดเวลา
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia