Anthropic วิศวกร: วิธีการออกแบบ Loop แบบ "แก้ไขตัวเอง" ด้วย Fable 5
หัวข้อต้นฉบับ: การออกแบบลูปด้วย Fable 5
ผู้เขียนต้นฉบับ: Lance Martin
เรียบเรียง: Peggy, BlockBeats
หมายเหตุบรรณาธิการ: Lance Martin จาก Anthropic เชื่อว่าการใช้งานหลักของโมเดลระดับ Mythos อย่าง Claude Fable 5 ไม่ใช่การป้อนคำสั่งด้วยตนเองซ้ำๆ แต่เป็นการออกแบบลูปที่สามารถแก้ไขข้อผิดพลาดได้เองให้กับโมเดล
บทความนี้นำเสนอเทคนิคหลักสองประการ: หนึ่งคือการตั้งเป้าหมายหรือเกณฑ์การให้คะแนนที่ชัดเจนผ่านกลไกต่างๆ เช่น /goal และ Outcomes เพื่อให้โมเดลสามารถวนซ้ำระหว่างการดำเนินการ การรับฟีดแบ็ก และการปรับปรุงแผน สองคือการใช้ memory (ความจำข้ามเซสชัน) เพื่อให้โมเดลบันทึกความล้มเหลว สอบสวนสาเหตุ ตรวจสอบข้อสรุป และกลั่นกรองประสบการณ์เป็นกฎที่สามารถนำกลับมาใช้ใหม่ในอนาคต
ในการทดลองต่างๆ เช่น Parameter Golf และ Continual Learning Bench Fable 5 มีความสามารถเหนือกว่า Opus 4.7 และ Sonnet 4.6 ในการสำรวจเชิงโครงสร้าง การยึดมั่นในงานระยะยาว และการแปลงความจำเป็นการปรับปรุงที่มีประสิทธิภาพสำหรับงานถัดไป
มุมมองหลักของบทความคือ: แทนที่จะควบคุมโมเดลโดยตรง ควรออกแบบสภาพแวดล้อม กลไกฟีดแบ็ก และระบบความจำ เพื่อให้โมเดลแข็งแกร่งขึ้นด้วยตัวเองในลูป
ต่อไปนี้เป็นเนื้อหาต้นฉบับ:
โมเดลระดับ Mythos อย่าง Claude Fable 5 ได้เปลี่ยนวิธีการทำงานของหลายคนภายใน Anthropic ไปแล้ว ผมอยากแบ่งปันเทคนิคสองประการที่จะช่วยให้ทุกคนใช้ความสามารถของโมเดลประเภทนี้ได้ดียิ่งขึ้น
ลูปแก้ไขข้อผิดพลาดด้วยตนเอง
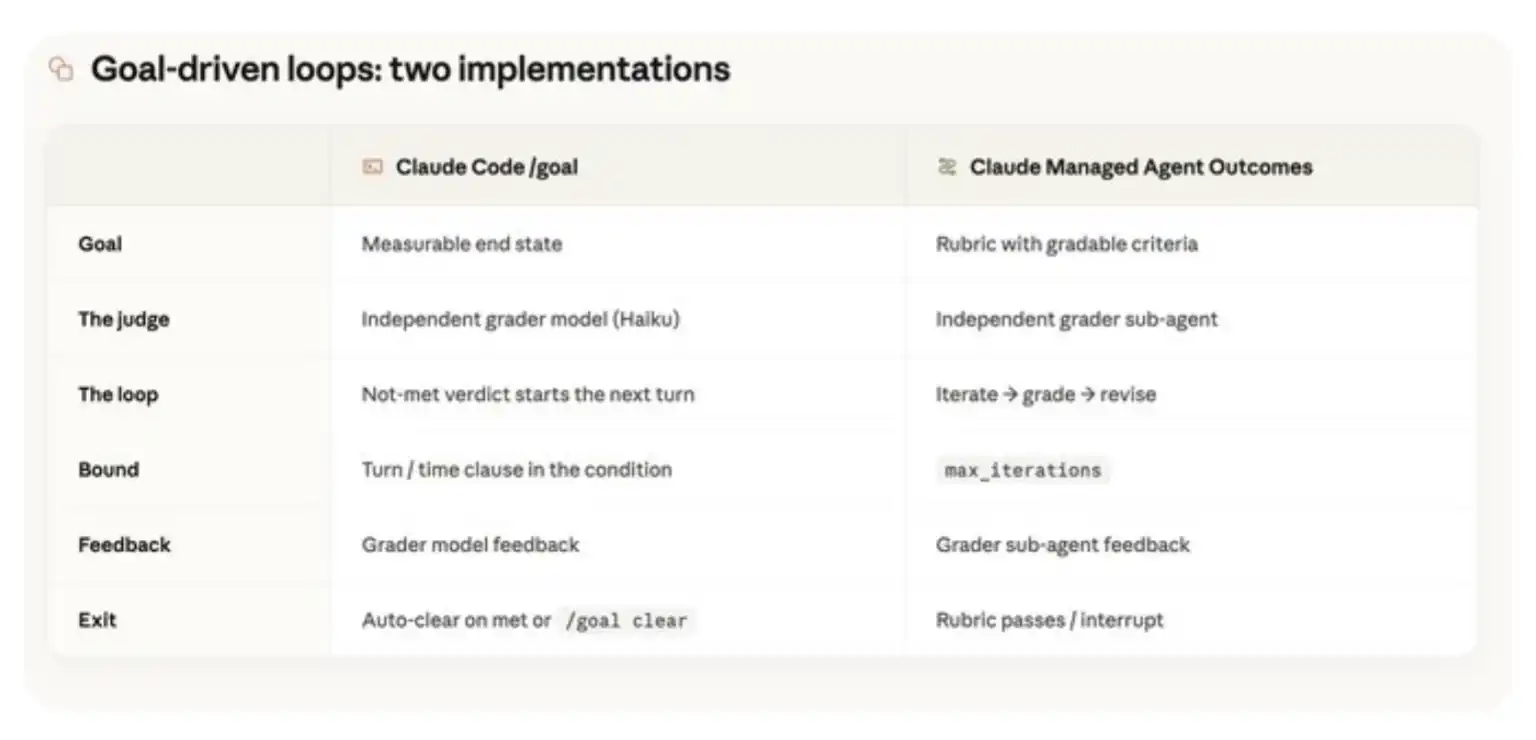
เมื่อเร็วๆ นี้ มีความสนใจอย่างมากเกี่ยวกับ "ลูป" @bcherny เคยกล่าวไว้ว่า "งานของฉันคือการเขียนลูป" การให้โมเดลปรับปรุงตัวเองอย่างต่อเนื่องตามเกณฑ์การประเมินบางอย่างเป็นวิธีการทั่วไปในการเพิ่มประสิทธิภาพงาน: /goal ใน Claude Code และ Outcomes ใน Claude Managed Agent เป็นความสามารถพื้นฐานที่ช่วยให้คุณนำวิธีการทั่วไปนี้ไปประยุกต์ใช้กับงานเฉพาะได้
ดังที่เราได้กล่าวไว้ในคู่มือ Prompt Fable 5 มีความสามารถในการแก้ไขข้อผิดพลาดด้วยตนเองในลูปได้ดีมาก การตั้งเป้าหมายหรือเกณฑ์การให้คะแนนที่ออกแบบมาอย่างดีเปรียบเสมือนการเพิ่มกลไกฟีดแบ็กให้กับสภาพแวดล้อมของ Claude ด้วยวิธีนี้ Claude สามารถดำเนินงานก่อน จากนั้นรวบรวมฟีดแบ็กผ่านเป้าหมายหรือเกณฑ์การให้คะแนน แก้ไขตัวเอง และดำเนินการต่อไปจนกว่าจะบรรลุเป้าหมายหรือเกณฑ์การให้คะแนน
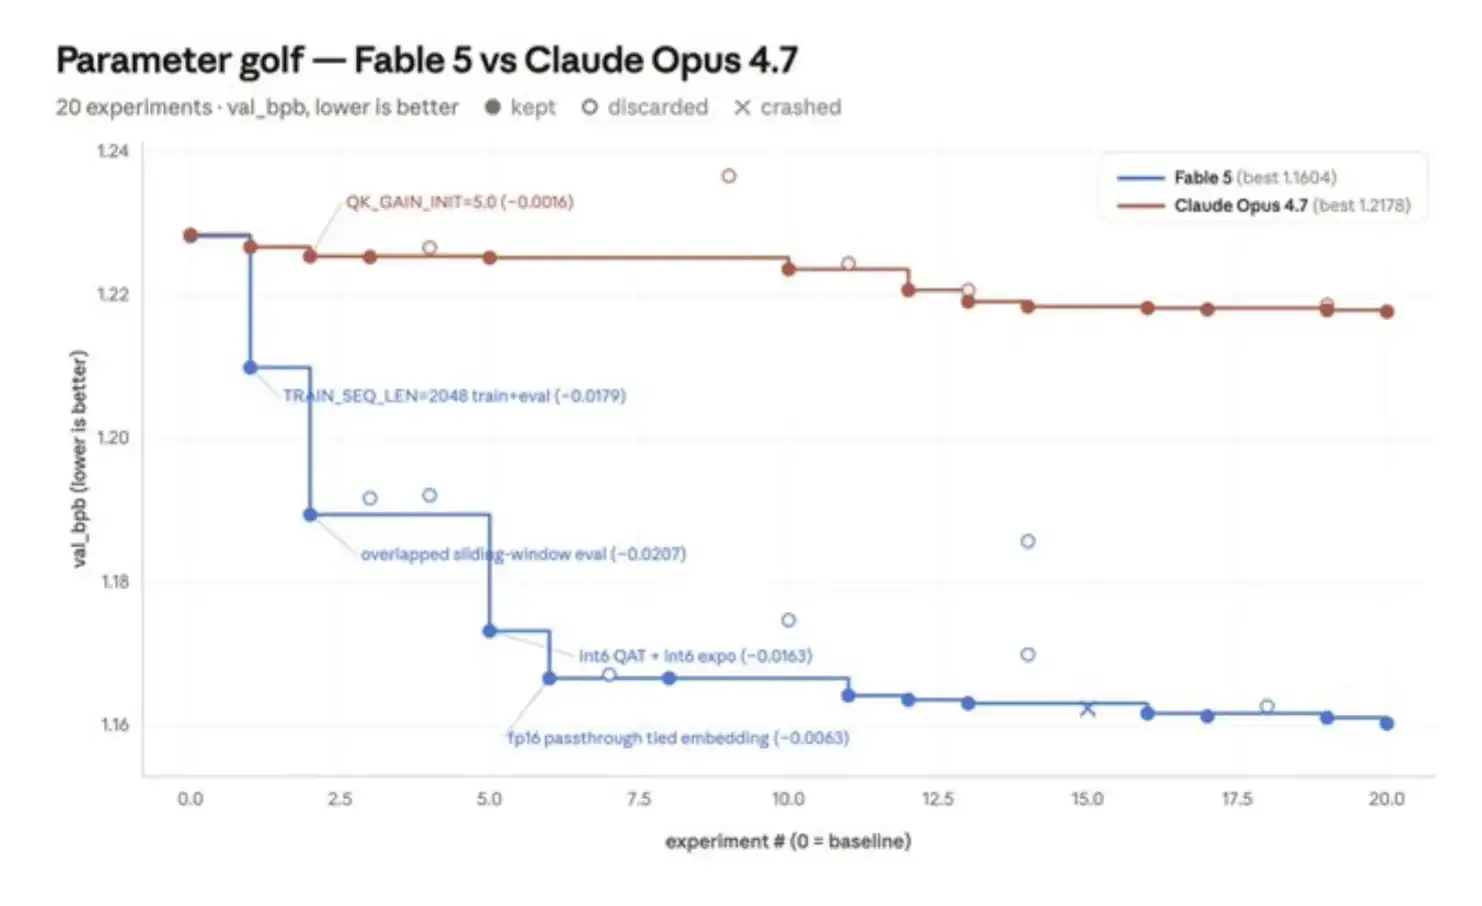
ฉันขอแชร์ตัวอย่างเล็กๆ ที่ใช้ทดสอบ Fable: Parameter Golf นี่คือความท้าทายด้านวิศวกรรมแมชชีนเลิร์นนิงแบบโอเพนซอร์ส โดยเป้าหมายคือการฝึกโมเดลให้มีประสิทธิภาพดีที่สุดภายใน 8 H100 GPU และภายใน 10 นาที โดยผลลัพธ์สุดท้ายต้องไม่เกิน 16MB
มันคล้ายกับโปรเจกต์ autoresearch ของ @karpathy: ความท้าทายนี้ทดสอบว่า Agent สามารถปรับเปลี่ยนโค้ดการฝึกพื้นฐาน ซึ่งก็คือไฟล์ train_gpt.py; เริ่มการฝึก; ตรวจสอบล็อก; อ่านคะแนน; และตัดสินใจว่าจะรันการทดลองอะไรต่อไป
ฉันใช้ Claude Managed Agents (CMA) เปรียบเทียบ Fable 5 กับ Opus 4.7 ในความท้าทายนี้ CMA มีเฟรมเวิร์กสำหรับรัน Agent และแซนด์บ็อกซ์托管 ดังนั้นจึงเหมาะให้ Fable 5 ทำงานระยะยาว ในการทดสอบ Parameter Golf ฉันให้ CMA เชื่อมต่อกับแซนด์บ็อกซ์托管ที่มี 8 H100 GPU
มีจุดที่ละเอียดอ่อนแต่สำคัญ: ใครเป็นผู้ตัดสินผลลัพธ์เป็นสิ่งสำคัญ เราพบว่าโมเดลมักมีปัญหาในการวิจารณ์เนื้อหาที่ตัวเองสร้างขึ้น Prithvi Rajasekaran เคยเขียนเกี่ยวกับเรื่องนี้ในบล็อกวิศวกรรมของเรา
เราพบว่าสำหรับ Fable 5 การใช้ Agent ย่อยที่ทำหน้าที่ตรวจสอบ มักจะให้ผลดีกว่าการให้โมเดลวิจารณ์ตัวเอง เนื่องจากการให้คะแนนจะทำในหน้าต่างบริบทที่แยกต่างหาก ฟังก์ชัน Outcomes ใน CMA จะเริ่ม Agent ย่อยสำหรับให้คะแนนโดยอัตโนมัติเพื่อจัดการเรื่องนี้
ในการทดสอบแต่ละครั้ง ฉันจะจัดเตรียมไฟล์เกณฑ์การให้คะแนนที่มีเกณฑ์ตรวจสอบ 9 ข้อ เช่น การรันการทดลองพื้นฐาน การทำการทดลองครบ 20 ครั้ง เป็นต้น จากนั้นฉันให้ Parameter Golf รันสูงสุด 8 ชั่วโมง เฉพาะเมื่อตัวให้คะแนน Outcomes ยืนยันว่าเกณฑ์การทดลองทั้งหมดเป็นไปตามข้อกำหนดแล้ว Claude จึงจะได้รับอนุญาตให้หยุดทำงาน
ผลลัพธ์คือ Fable 5 ปรับปรุงกระบวนการฝึกได้ดีกว่า Opus 4.7 ประมาณ 6 เท่า หากแบ่งการทดลองเป็นการทดลองเชิงโครงสร้าง เช่น การเปลี่ยนสถาปัตยกรรมโมเดล และการทดลองเชิงสเกลาร์ เช่น การปรับค่าคงที่ Fable 5 มักจะเลือกการเปลี่ยนแปลงเชิงโครงสร้างที่ใหญ่กว่า และแสดงความยืดหยุ่นมากกว่า เช่น ในปัญหาการถดถอยเชิงปริมาณครั้งหนึ่ง มันยืนหยัดและดำเนินต่อไปจนได้การปรับปรุงที่ใหญ่ที่สุด
ในทางตรงกันข้าม การทดลองครั้งแรกของ Opus 4.7 ทำให้เกิดการปรับปรุงเล็กน้อย แต่หลังจากนั้น การทดลองเกือบทั้งหมดก็ใช้รูปแบบเดียวกัน คือ ปรับค่าสเกลาร์หนึ่งค่า วัดผลลัพธ์ และถ้าผลลัพธ์เป็นบวกก็เก็บไว้
ความทรงจำ
ความทรงจำเป็นอีกหนึ่งด้านที่ Fable ถนัด เราสามารถมองมันเป็นลูปภายนอกที่ทำงานข้ามเซสชัน: Claude จะเขียนความทรงจำในเซสชันหนึ่ง และความทรงจำเหล่านี้สามารถถูกดึงกลับมาใช้ในเซสชันในอนาคตได้
@pgasawa และทีมเพิ่งปล่อย Continual Learning Bench 1.0 ดังนั้นฉันจึงอยากใช้มันทดสอบความแตกต่างระหว่าง Fable 5 กับโมเดลรุ่นก่อนหน้า
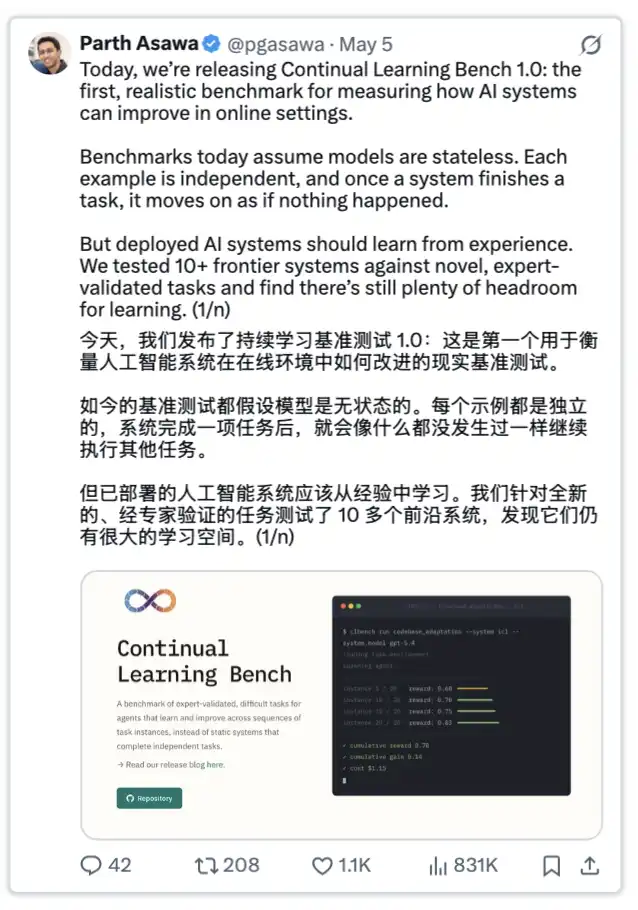
ฉันเปรียบเทียบ Fable 5, Opus 4.7 และ Sonnet 4.6 ในงานหนึ่งของเกณฑ์มาตรฐานนี้ งานนี้กำหนดให้ Agent ต้องตอบคำถามต่อเนื่องกันหลายข้อภายใต้การเข้าถึงฐานข้อมูล SQL แต่ละคำถามเป็นเซสชัน Agent ที่แยกจากกัน และมีความสามารถในการใช้ความทรงจำ
เพื่อจุดประสงค์นี้ ฉันใช้ CMA ที่มีความทรงจำ ซึ่งจะจัดหาระบบไฟล์ที่เมาท์ให้กับ Agent แต่ละตัว และระบบไฟล์นี้สามารถแชร์ระหว่างเซสชันต่างๆ ได้
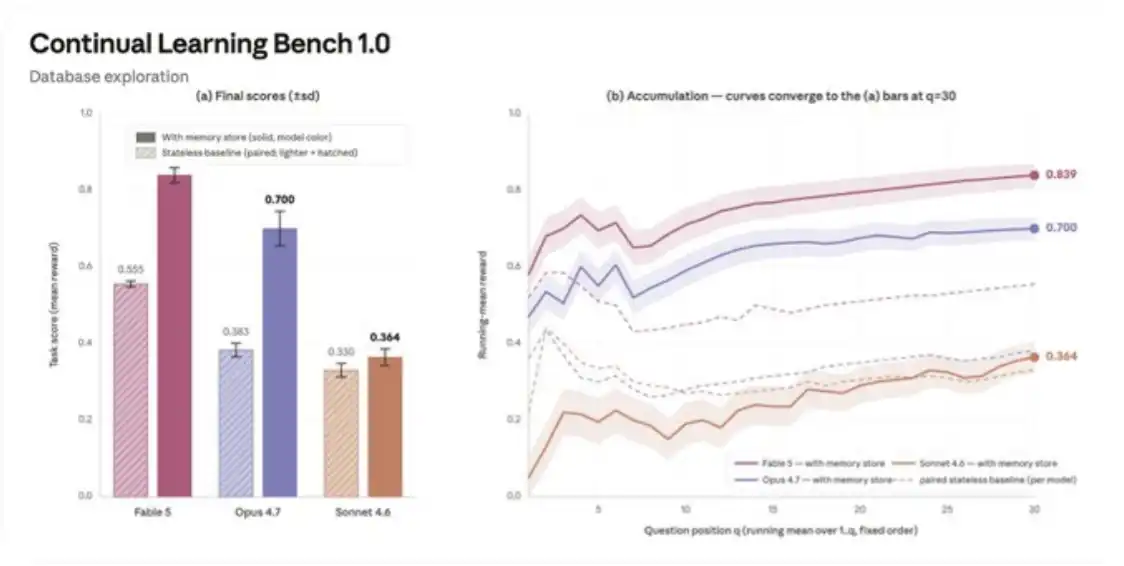
สำหรับงานนี้ การใช้ความทรงจำอย่างมีประสิทธิภาพมักต้องผ่านกระบวนการที่ค่อยเป็นค่อยไป: ความล้มเหลว (ตอบผิดและบันทึกไว้), การสืบสวน (หาสาเหตุของข้อผิดพลาดก่อนดำเนินการต่อ), การตรวจสอบ (เปลี่ยนการวินิจฉัยเป็นข้อเท็จจริงที่ผ่านการตรวจสอบ), การกลั่นกรอง (เปลี่ยนผลการตรวจสอบเป็นกฎทั่วไป), และการอ้างอิง (อ่านกฎโดยตรงในภายหลัง แทนที่จะอนุมานใหม่)
Sonnet 4.6 อยู่ประมาณขั้นที่ 1: การจัดเก็บความทรงจำของมันเป็นเหมือนบันทึกความล้มเหลวและการคาดเดาที่ยังไม่แน่นอน เช่น "อาจจะใช้ prc แทน prc_usd?" มันแทบไม่เคยอ้างอิงบันทึกก่อนหน้านี้ หากต้องการปรับปรุงประสิทธิภาพ จำเป็นต้องเพิ่มคำแนะนำการใช้ความทรงจำที่เฉพาะเจาะจงกับงาน
Opus 4.7 ไปถึงประมาณขั้นที่ 3: มันสร้างเอกสารอ้างอิง schema และระบุความไม่แน่นอนในนั้น เช่น "prc อาจนับเป็นเซนต์? ต้องตรวจสอบ" แต่ความครอบคลุมในการตรวจสอบของมันไม่สูง: ครอบคลุมเพียง 7% ถึง 33% ของคำถาม โดยค่ามัธยฐานของการทำงานอยู่ที่ประมาณ 17%
Fable 5 มักจะทำกระบวนการทั้งหมดให้เสร็จสมบูรณ์: ในการทำงานที่ดีที่สุด ความครอบคลุมในการตรวจสอบสูงถึง 73% นั่นคือตรวจสอบ 22 จาก 30 คำถาม และมันจะกลั่นกรองสิ่งที่เรียนรู้เป็นกฎทั่วไป ซึ่งช่วยในงานต่อๆ ไป
ดังนั้น แทนที่จะแจ้งเตือนโดยตรงและคอยชี้แนะ Fable 5 อยู่ตลอดเวลา วิธีที่ดีกว่ามักจะเป็นการออกแบบวงจรที่ช่วยให้โมเดลสามารถแก้ไขข้อผิดพลาดของตัวเองตามผลตอบรับจากสภาพแวดล้อม เช่น การใช้ /goal หรือ Outcomes พร้อมกันนี้ ให้มันจัดการบริบทของตัวเองผ่านกลไกความจำ
ผมแค่แชร์การทดลองขนาดเล็กที่ทำเองไม่กี่ครั้ง แต่ Fable 5 คุ้มค่าที่คุณจะลองทดสอบกับงานที่ยากลำบากด้วยตัวเอง โดยเฉพาะเมื่อใช้ร่วมกับวงจรแก้ไขข้อผิดพลาดหรือกลไกความจำ
หากต้องการเริ่มต้น ลองดูเอกสารของเรา หรือสอบถาม Claude Code เวอร์ชันล่าสุดโดยตรง มันสามารถใช้ทักษะ /claude-api ในตัวเพื่อแนะนำ Fable 5 ให้คุณ เช่น แนวทางปฏิบัติที่ดีที่สุดสำหรับ Prompt, /goal, Claude Managed Agents หรือฟังก์ชัน API อื่นๆ
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia
 บทความที่เกี่ยวข้อง