ทุกคนในวงการกำลังพูดถึง Loop Engineering มันเปลี่ยนอะไรไปบ้าง?
TL;DR
· มิถุนายน 2026 ผู้ปฏิบัติงานด้านการเขียนโปรแกรมด้วย AI หลายคนเกือบจะพร้อมกันเสนอ Loop Engineering โดย Stripe ใช้ Minions รวม Pull Request ที่สร้างโดย AI กว่า 1,300 รายการต่อสัปดาห์
· วิธีการนี้ไม่ต้องพึ่งพามนุษย์ในการป้อนคำสั่งทีละขั้นตอนอีกต่อไป แต่ให้ระบบค้นหางาน ส่งต่อ ตรวจสอบ บันทึกสถานะ และเข้าสู่รอบถัดไปโดยอัตโนมัติ
· ความน่าเชื่อถือยังคงขึ้นอยู่กับตัวประเมินอิสระ เกณฑ์บังคับที่เข้มงวด และการตรวจสอบโดยมนุษย์ หนี้จากการตรวจสอบและความเสื่อมของความเข้าใจอาจกลับมาขยายความเสี่ยง
เมื่อเร็วๆ นี้ วิศวกรของ Anthropic ได้เผยแพร่เอกสาร 11 หน้าเกี่ยวกับ "วิศวกรรมวนซ้ำสำหรับระบบเอเจนต์" โดยวาง Loop Engineering ไว้ถัดจาก Prompt Engineering, Context Engineering และ Harness Engineering ถือเป็นวิธีการสำคัญสำหรับการเขียนโปรแกรมด้วย AI ในระยะถัดไป
เอกสารนี้ได้รับความสนใจเพราะมันตรงกับจุดเปลี่ยนของการอภิปรายการเขียนโปรแกรมด้วย AI ในเดือนมิถุนายน 2026 พอดี Addy Osmani, Boris Cherny และ Peter Steinberger เกือบจะในสัปดาห์เดียวกันเรียกขั้นตอนใหม่ของการเขียนโปรแกรมด้วย AI ว่า Loop Engineering ในขณะที่ไปป์ไลน์ Minions ของ Stripe ใช้แนวคิดคล้ายกันในการรวม Pull Request ที่สร้างโดย AI กว่า 1,300 รายการต่อสัปดาห์
ตัวเลขนี้สำคัญไม่ใช่เพราะ AI เขียนโค้ดเพิ่มอีกสองสามบรรทัด แต่เป็นเพราะจุดศูนย์ถ่วงของการพัฒนาซอฟต์แวร์กำลังเปลี่ยนจาก "มนุษย์บอกโมเดลให้เขียนอะไร" ไปเป็น "มนุษย์ออกแบบระบบที่สามารถจัดคิว รับงาน เขียนโค้ด ตรวจสอบผลลัพธ์ บันทึกสถานะ และทำงานต่อไปได้ด้วยตัวเอง"
ในปีที่ผ่านมา เรื่องเล่าส่วนใหญ่เกี่ยวกับเครื่องมือเขียนโปรแกรมด้วย AI หมุนรอบความสามารถของโมเดล: การเติมโค้ดแม่นยำขึ้น หน้าต่างบริบทยาวขึ้น เอเจนต์ทำงานที่ซับซ้อนขึ้นได้ในครั้งเดียว แต่ Loop Engineering พูดถึงอีกเรื่องหนึ่ง: เมื่อการสร้างโค้ดมีราคาถูกลงเรื่อยๆ สิ่งที่วิศวกรต้องออกแบบจริงๆ กลายเป็นวงจรที่ทำงานได้อย่างยั่งยืน เครื่องจักรสามารถผลิตทางเลือกออกมาได้ไม่หยุด มนุษย์ต้องตัดสินใจว่าผลลัพธ์ใดเชื่อถือได้ อันไหนต้องสกัดกั้น และต้นทุนระยะยาวใดกำลังถูกซ่อนไว้
เมื่อเร็วๆ นี้ วิศวกรของ Anthropic ได้เผยแพร่เอกสาร 11 หน้าเกี่ยวกับ "วิศวกรรมระบบวนซ้ำสำหรับเอเจนต์" โดยวาง Loop Engineering ไว้ถัดจาก Prompt Engineering, Context Engineering และ Harness Engineering โดยมองว่าเป็นวิธีการสำคัญที่พา AI Programming ก้าวเข้าสู่ขั้นตอนถัดไป บทความนี้ใช้เอกสารดังกล่าวเป็นจุดเริ่มต้น ผนวกกับการอภิปรายสาธารณะจาก Boris Cherny, Addy Osmani และกรณีศึกษา Stripe Minions ที่รวม Pull Request (PR) ที่สร้างโดย AI กว่า 1,300 รายการต่อสัปดาห์ เพื่ออธิบายว่า Loop Engineering คืออะไร เหตุใดจึงถูกพูดถึงทั่วทั้งวงการในทันที และสิ่งที่มันเปลี่ยนแปลงจริงๆ ไม่ใช่การเขียนโค้ด แต่คือการตรวจสอบ การจัดตารางงาน และการตัดสินใจในการพัฒนาซอฟต์แวร์
AI Programming ก้าวจาก "พรอมต์ครั้งเดียว" สู่ "การวนซ้ำอย่างต่อเนื่อง"
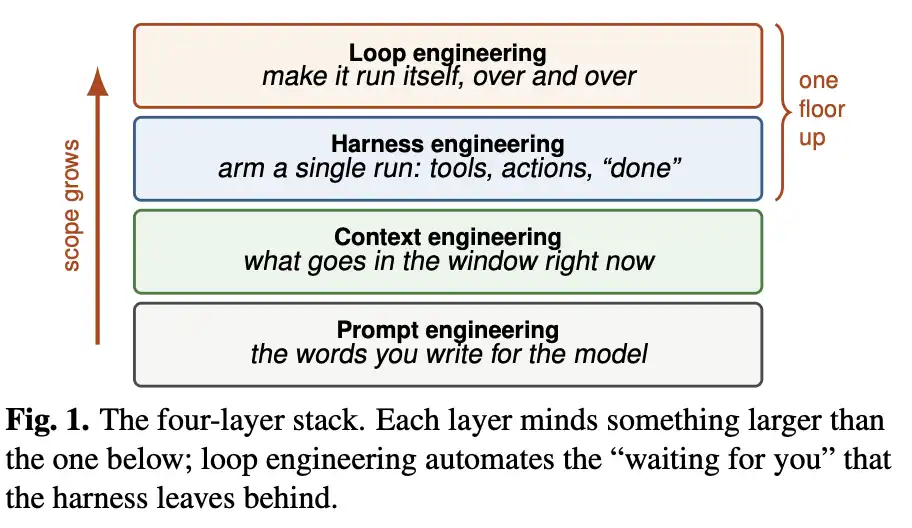
Loop Engineering ถูกวางไว้เป็นชั้นที่สี่ของสแต็กวิศวกรรม AI ต่อจาก Prompt Engineering, Context Engineering และ Harness Engineering
Prompt Engineering แก้ปัญหา "จะถามอย่างไร"; Context Engineering แก้ปัญหา "จะให้โมเดลดูอะไร"; Harness Engineering แก้ปัญหา "จะเชื่อมต่อการทำงานของโมเดลครั้งเดียวเข้ากับเครื่องมือ การทดสอบ และเวิร์กโฟลว์ได้อย่างไร" ส่วน Loop Engineering ก้าวไปอีกขั้น: ระบบไม่เพียงทำงานครั้งเดียว แต่สามารถรีสตาร์ทได้ตามเวลาที่กำหนดหรือภายใต้เงื่อนไขที่กระตุ้น โดยนำผลลัพธ์ของรอบก่อนหน้ามาเป็นอินพุตของรอบถัดไป
โดยทั่วไป วงจรที่สมบูรณ์ประกอบด้วยห้าการกระทำ
ขั้นตอนแรกคือการค้นพบงาน เช่น การสแกนหา CI ที่ล้มเหลว, Issue ที่เปิดอยู่, การส่งโค้ด หรืองานที่รอดำเนินการ; ขั้นตอนที่สองคือการส่งมอบงาน โดยจัดระเบียบงานให้เป็นบริบทที่โมเดลสามารถประมวลผลได้; ขั้นตอนที่สามคือการตรวจสอบอย่างอิสระ เพื่อตรวจสอบว่าโค้ดที่โมเดลสร้างขึ้นทำงานได้จริงหรือไม่, ผ่านการทดสอบหรือไม่, และก่อให้เกิดผลข้างเคียงหรือไม่; ขั้นตอนที่สี่คือการคงอยู่ของผลลัพธ์ โดยเขียนสถานะ การตัดสินใจ และงานที่ยังไม่เสร็จลงในไฟล์หรือระบบ; ขั้นตอนที่ห้าคือการจัดตารางวนซ้ำ เพื่อให้รอบถัดไปทำงานต่อในเวลาที่เหมาะสม
สิ่งที่สำคัญที่สุดในที่นี้ไม่ใช่ "การสร้าง" แต่คือ "การตรวจสอบ" หากวงจรเพียงแค่ให้โมเดลเขียนโค้ดซ้ำแล้วซ้ำเล่า แล้วให้โมเดลเดียวกันชื่นชมผลลัพธ์ของตัวเอง มันจะกลายเป็น "วงจรพยักหน้า" ได้ง่าย: แต่ละรอบดูเหมือนก้าวหน้า แต่จริงๆ แล้วแค่ห่อหุ้มข้อผิดพลาดให้ดูสมบูรณ์ยิ่งขึ้นเท่านั้น
วงจร triage ตอนเช้าของ Osmani เองเป็นตัวอย่างส่วนตัว: ระบบจะอ่าน CI test ที่ล้มเหลว, Issue ที่เปิดอยู่ และ commit ล่าสุดจากวันก่อนโดยอัตโนมัติทุกวัน สร้างไฟล์สถานะ และใส่สิ่งที่จัดการไม่ได้ลงในกล่องขาเข้าของมนุษย์ คุณค่าของมันไม่ใช่การตัดสินใจทุกอย่างแทนวิศวกร แต่เป็นการคัดกรองเบื้องต้นก่อนที่วิศวกรจะตื่นนอน เพื่อให้ความสนใจเหลือไว้เฉพาะส่วนที่ต้องใช้การตัดสินใจจริงๆ
1300 PR ของ Stripe: ความน่าเชื่อถือมาจากข้อจำกัด ไม่ใช่โมเดล
ไปป์ไลน์ Minions ของ Stripe เป็นกรณีศึกษาระดับองค์กรที่ทรงพลังที่สุดในการสนทนาครั้งนี้: รวม Pull Request ที่สร้างโดย AI มากกว่า 1300 รายการต่อสัปดาห์ โดยที่โค้ดไม่ได้ถูกเขียนทีละบรรทัดโดยมนุษย์
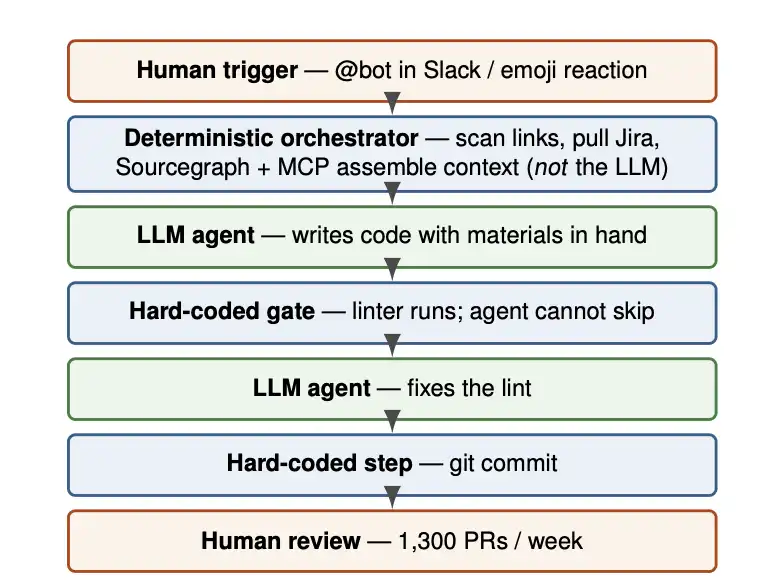
แต่นี่ไม่ได้หมายความว่า Stripe ปล่อยให้ระบบการผลิตอยู่ในมือของโมเดลใหญ่ที่ทำงานอย่างอิสระ ในทางกลับกัน จุดสำคัญของ Minions อยู่ที่กระบวนการที่ถูกควบคุมอย่างเข้มงวด: ตัวจัดลำดับแบบกำหนดตายตัว (deterministic orchestrator) จะประกอบบริบทก่อน โดยดึงข้อมูลงานจาก Jira, การค้นหาโค้ด และเครื่องมือภายใน จากนั้น LLM จะรับผิดชอบในการสร้างโค้ด หลังจากนั้นจะผ่าน linter ที่เขียนแบบตายตัว, การควบคุมการ commit และการตรวจสอบโดยมนุษย์ในขั้นสุดท้ายเพื่อตัดสินใจว่าจะรวมโค้ดหรือไม่
กล่าวอีกนัยหนึ่ง ความน่าเชื่อถือไม่ได้มาจาก "โมเดลฉลาดขึ้นอย่างกะทันหัน" แต่มาจากข้อจำกัดที่ต่อเนื่องกัน โมเดลมีหน้าที่เสนอการเปลี่ยนแปลงที่เป็นตัวเลือก ระบบมีหน้าที่จำกัดว่ามันสามารถแตะอะไรได้บ้าง ต้องผ่านการตรวจสอบอะไรบ้าง และมนุษย์มีหน้าที่ตัดสินใจขั้นสุดท้ายว่าจะเข้าสู่สาขาหลักหรือไม่
นี่คือความแตกต่างระหว่าง Loop Engineering กับสคริปต์ AI ทั่วไป สคริปต์ทั่วไปมักเน้นที่ "ให้โมเดลทำงานให้สำเร็จ" ในขณะที่ระบบวนซ้ำต้องพิจารณาว่างานมาจากไหน จัดการกับความล้มเหลวอย่างไร รักษาสถานะอย่างไร ควบคุมงบประมาณอย่างไร และใครจะหยุดข้อผิดพลาดไม่ให้เข้าสู่สภาพแวดล้อมการผลิต
หากไม่มีข้อจำกัดเหล่านี้ 1300 PR ต่อสัปดาห์จะไม่ใช่การเพิ่มประสิทธิภาพ แต่เป็นเครื่องจักรสร้างหนี้ทางเทคนิค
ตัวสร้างและตัวประเมินต้องแยกจากกัน
การออกแบบหลักของ Loop Engineering คือการแยกตัวสร้าง (generator) และตัวประเมิน (evaluator) ออกจากกัน
ตัวสร้างมีหน้าที่เขียนโค้ด แก้ไขไฟล์ และส่งผลลัพธ์ที่เป็นตัวเลือก ตัวประเมินมีหน้าที่หาข้อผิดพลาด และควรตั้งสมมติฐานเริ่มต้นว่าโค้ดมีปัญหา ทั้งสองไม่ควรทำโดย "ตัวแทนที่มองโลกในแง่ดี" คนเดียวกัน เพราะโมเดลมักจะเอนเอียงไปทางเห็นด้วยกับผลลัพธ์ของตัวเองเมื่อให้คะแนนตัวเอง โดยเฉพาะอย่างยิ่งเมื่อคำอธิบายงานคลุมเครือ การทดสอบครอบคลุมไม่เพียงพอ หรือบริบทไม่สมบูรณ์
ตัวประเมินอิสระสามารถเรียบง่ายกว่า สงสัยมากกว่า และปรับแต่งได้ง่ายกว่า มันไม่จำเป็นต้องแก้ปัญหาอย่างสร้างสรรค์ แค่ต้องตรวจสอบว่าหน้าเว็บเปิดได้หรือไม่ การทดสอบผ่านหรือไม่ เงื่อนไขขอบเขตมีปัญหาไหม และโค้ดเป็นไปตามกฎที่กำหนดไว้หรือไม่ บางแนวปฏิบัติให้ตัวประเมินคลิกหน้าเว็บจริงผ่านเครื่องมืออัตโนมัติของเบราว์เซอร์ แทนที่จะอ่านโค้ดแล้วให้คำตัดสิน
นี่คือเหตุผลที่ "การตรวจสอบ" เป็นขั้นตอนที่ยากที่สุดในวงจรห้าขั้นตอน การสร้างโค้ดมีราคาถูกลงเรื่อยๆ แต่การพิสูจน์ว่าโค้ดชุดหนึ่งถูกต้องจริงๆ ยังคงมีราคาแพง โดยเฉพาะในฐานโค้ดขนาดใหญ่ ข้อผิดพลาดอาจไม่ปรากฏทันที และการทดสอบก็อาจไม่ครอบคลุมเส้นทางธุรกิจจริง ยิ่งวงจรทำงานเร็วเท่าไร สมมติฐานที่ยังไม่ได้รับการตรวจสอบก็สะสมเร็วขึ้นเท่านั้น
ต้นทุนแฝงจะเสริมกำลังซึ่งกันและกัน
ความเสี่ยงของ Loop Engineering ไม่ใช่ว่ามันจะเขียนโค้ดผิดพลาดหรือไม่ แต่อยู่ที่ว่ามันอาจทำให้ทีมค้นพบได้ยากขึ้นว่าตนเองสูญเสียความเข้าใจไปแล้ว
ต้นทุนประเภทแรกคือหนี้การตรวจสอบ ข้อผิดพลาดที่ไม่ถูกทดสอบจะสะสมในวงจรอย่างต่อเนื่อง จนกระทั่งเกิดการระเบิดพร้อมกันเมื่อมีการรวมโค้ดหรือเปิดตัว ต้นทุนประเภทที่สองคือความสามารถในการเข้าใจที่ลดลง ฐานโค้ดขยายตัวอย่างต่อเนื่อง แต่วิศวกรไม่ได้มีส่วนร่วมในการตัดสินใจออกแบบที่สำคัญด้วยตนเอง แผนที่ทางจิตจึงยังคงอยู่ในเวอร์ชันเก่า ต้นทุนประเภทที่สามคือการยอมจำนนทางปัญญา มนุษย์เริ่มยอมรับผลลัพธ์จากเครื่องจักรโดยปริยาย และทำเพียงการอนุมัติในรูปแบบเท่านั้น ต้นทุนประเภทที่สี่คือการระเบิดของ Token การลองใหม่ ตัวแทนย่อย บริบทที่ยาว และการตรวจสอบหลายรอบจะทำให้ค่าใช้จ่ายเพิ่มขึ้นอย่างรวดเร็ว
ต้นทุนทั้งสี่นี้จะหล่อเลี้ยงซึ่งกันและกัน: การทดสอบที่ไม่เพียงพอนำไปสู่หนี้การตรวจสอบ หนี้การตรวจสอบที่เพิ่มขึ้นทำให้วิศวกรไม่เต็มใจที่จะทำความเข้าใจอย่างลึกซึ้ง ความเข้าใจที่ลดลงทำให้การตรวจสอบด้วยมนุษย์กลายเป็นตรายาง การตรวจสอบแบบตรายางผลักดันให้เกิดการลองใหม่อัตโนมัติและต้นทุนที่สูงขึ้น
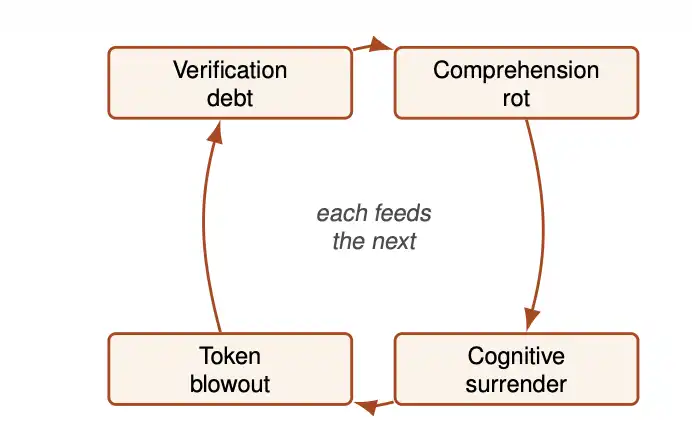
ดังนั้น ส่วนประกอบวงจรชุดเดียวกันอาจให้ผลลัพธ์ที่ตรงกันข้ามอย่างสิ้นเชิงในมือของวิศวกรที่แตกต่างกัน ผู้ที่มีวิจารณญาณดีและขอบเขตชัดเจนสามารถใช้วงจรเพื่อขยายความเข้าใจของตนเองเกี่ยวกับระบบ โดยใช้เครื่องจักรเป็นชั้นปฏิบัติการที่ไม่รู้จักเหน็ดเหนื่อย ส่วนผู้ที่มีวิจารณญาณอ่อนหรือพึ่งพาระบบอัตโนมัติมากเกินไป อาจกลายเป็น "ผู้เฝ้าประตู" ของระบบของตนเองในอีกไม่กี่เดือน เพียงแค่อนุมัติหรือปฏิเสธ แต่ไม่สามารถอธิบายได้ว่าระบบทำงานเช่นนี้ได้อย่างไร
เมื่อโค้ดถูกลง สิ่งที่แพงคือวิจารณญาณ
Loop Engineering ผลักดันแนวโน้มระยะยาวให้ชัดเจนยิ่งขึ้น: โค้ด แผน PR และการแยกย่อยงานกำลังกลายเป็นสิ่งที่เกือบจะฟรี แต่ "สิ่งที่ถูกต้องจริงๆ" ไม่ได้ถูกลง
สำหรับองค์กร นี่หมายความว่าจุดเน้นของการลงทุนในการเขียนโปรแกรมด้วย AI อาจเปลี่ยนจากการซื้อโมเดลที่แข็งแกร่งขึ้น ไปสู่การออกแบบกระบวนการที่มั่นคงยิ่งขึ้น: ขอบเขตของงาน การประกอบบริบท การประเมินอิสระ การคงสถานะ วงเงินงบประมาณ จุดตรวจสอบของมนุษย์ และวิธีหยุดวงจรเมื่อเกิดความผิดปกติ ความสามารถของโมเดลยังคงสำคัญ แต่มันเป็นเพียงส่วนหนึ่งของระบบ
สำหรับวิศวกร บทบาทก็กำลังเปลี่ยนแปลงเช่นกัน แรงงานหลักในอดีตคือการเขียนโค้ด แต่ตอนนี้แรงงานมากขึ้นกลายเป็นการตรวจสอบคำตอบที่เป็นตัวเลือกที่เครื่องจักรผลิตขึ้น: มันตรงตามความต้องการหรือไม่ มันทำลายสถาปัตยกรรมหรือไม่ มันดูสมเหตุสมผลเพียงผิวเผินหรือไม่ มันผลักดันความซับซ้อนไปให้ผู้ดูแลในอนาคตหรือไม่
นี่ไม่ได้หมายความว่าโปรแกรมเมอร์ถูกแทนที่แล้ว ตรงกันข้าม Loop Engineering กลับเป็นเหมือนเครื่องขยายความสามารถในการตัดสินใจ มันช่วยให้วิศวกรคนเดียวสามารถสร้างการเปลี่ยนแปลงที่แต่ก่อนต้องใช้ทีมเล็กๆ ถึงจะทำได้ และยังสามารถขยายนิสัยขี้เกียจ เชื่ออะไรง่ายๆ โดยไม่ตรวจสอบ และขาดการพิสูจน์ให้กลายเป็นอุบัติเหตุในการผลิตได้
จุดแยกที่แท้จริงอยู่ที่ว่ามนุษย์ยังคงมีอำนาจในการตัดสินใจและยับยั้งที่แข็งแกร่งพอหรือไม่ AI สามารถส่ง Pull Request ได้ไม่หยุด แต่การจะรวมหรือไม่ ควรจะขึ้นระบบหรือไม่ และในระยะยาวจะทำให้ระบบพังหรือไม่ ยังคงขึ้นอยู่กับมนุษย์
ยินดีต้อนรับสู่ชุมชนทางการของ BlockBeats:
กลุ่ม Telegram สมัครสมาชิก: https://t.me/theblockbeats
กลุ่ม Telegram พูดคุย: https://t.me/BlockBeats_App
บัญชี Twitter ทางการ: https://twitter.com/BlockBeatsAsia